10/09

Thứ Năm · 10 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnAction Map Policy: Bước ngoặt mới trong học điều khiển robot từ hồi quy sang phân loại điểm ảnh

Nghiên cứu đề xuất phương pháp Action Map Policy, áp dụng cơ chế Cross-Entropy từ mô hình ngôn ngữ lớn vào điều khiển robot, giúp giải quyết bài toán không gian hành động đa chiều phức tạp thông qua phân loại thay vì hồi quy truyền thống.


Vì sao đáng đọc: Chủ đề mang tính đột phá, kết nối thành công Scaling Law của LLM vào lĩnh vực robot học, có tiềm năng thay đổi cách huấn luyện tác nhân vật lý hiện nay.

DAIR.AI@dair_ai
NgànhĐiểm AI 44/100

Google dùng Đồ thị Quy trình (Procedural Graph) để tối ưu hóa khả năng lập luận cho AI Agent

Recommended paper from Google if you want to learn how to improve long-horizon agents with procedura…

DịchGoogle giới thiệu Procedural Graph giúp AI Agent hệ thống hóa kiến thức thành các chuỗi hành động logic. Hệ thống tự động tinh chỉnh cấu trúc đồ thị thông qua LLM bằng cách học hỏi từ các thất bại, giúp AI tự sửa lỗi và cải thiện hiệu suất vượt xa các thiết lập thủ công.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 38/100

NOAH: Mô hình AI đa phương thức dự báo toàn diện lộ trình điều trị bệnh nhân

NOAH là mô hình Transformer thế hệ mới có khả năng xử lý đồng thời hình ảnh y tế, dữ liệu thời gian và hồ sơ bệnh án để dự báo chính xác lộ trình điều trị của bệnh nhân dựa trên dữ liệu từ hàng trăm nghìn ca lâm sàng.

AK@_akhaliq
NgànhĐiểm AI 24/100

NeoHorse-1: Bước tiến mới trong huấn luyện hậu kỳ cho tác nhân AI với khả năng tự cải tiến đệ quy

NeoHorse-1 Towards Recursive Self-Improvement via Agentic Post-Training with Routing Harness paper…

DịchNeoHorse-1 giới thiệu khung làm việc dựa trên định tuyến (routing framework), cho phép các tác nhân AI thực hiện quá trình tự cải tiến đệ quy sau huấn luyện, giúp tối ưu hóa hiệu suất một cách tự động.

09/09

Thứ Tư · 6 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

OpenWAM: Bước tiến mở và mô-đun hóa trong huấn luyện trước mô hình Thế giới - Hành động

OpenWAM giới thiệu một nền tảng nghiên cứu mở giúp tách biệt các thành phần trong mô hình Thế giới - Hành động (WAM), cho phép thử nghiệm có kiểm soát để hiểu rõ cách thức tri thức từ video chuyển hóa thành tín hiệu điều khiển cho robot.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 37/100

Đột phá mới trong huấn luyện AI: Phương pháp OPRD giúp mô hình học sinh vượt mặt thầy giáo yếu

Phương pháp On-Policy Reverse Distillation (OPRD) cho phép mô hình AI học từ giáo viên yếu nhưng vẫn đạt hiệu suất vượt trội, nhờ cơ chế lọc và khuếch đại các cập nhật tối ưu từ trình xác thực.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

CosmoH2G: Bước tiến mới trong việc chuyển đổi thao tác tay người sang robot với các chuyển động không gian phức tạp

CosmoH2G giới thiệu bộ dữ liệu quy mô lớn gồm 6.189 tập thao tác, giúp robot học cách thực hiện các chuyển động không gian phức tạp như xoay hoặc lật vật thể từ dữ liệu tay người, vượt xa các phương pháp phẳng truyền thống.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 40/100

NeoHorse-1: Đột phá tự cải tiến cho AI Agent thông qua khung định tuyến thông minh

NeoHorse-1 là mô hình AI Agent thế hệ mới, sử dụng cơ chế định tuyến thông minh để tự động chuyển hóa tương tác người dùng thành dữ liệu huấn luyện, tạo ra vòng lặp khép kín giúp mô hình tự đánh giá và nâng cấp hiệu suất liên tục.

08/09

Thứ Ba · 5 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnMô hình nền tảng nhân quả: Bước tiến mới trong suy luận nhân quả bằng AI

Mô hình nền tảng nhân quả (CFM) cho phép ước tính các tác động nhân quả trên dữ liệu mới thông qua học trong ngữ cảnh mà không cần huấn luyện lại, thay thế quy trình xây dựng mô hình thủ công truyền thống.


Vì sao đáng đọc: Đây là hướng nghiên cứu đột phá, kết hợp suy luận nhân quả với sức mạnh của mô hình nền tảng, giúp tối ưu hóa quy trình phân tích dữ liệu phức tạp.
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnEMNLP 2026: Dự đoán càng giống thật, AI Agent càng dễ sai? Giải pháp từ 'Nhất quán hành vi'

Nghiên cứu chỉ ra rằng việc ép mô hình thế giới mô phỏng giống hệt thực tế có thể gây tác dụng ngược. Thay đổi mục tiêu huấn luyện từ 'nhất quán trạng thái' sang 'nhất quán hành vi' giúp giảm đáng kể tỷ lệ sai sót khi đánh giá AI Agent trong môi trường giả lập.


Vì sao đáng đọc: Bài viết mang tính đột phá về phương pháp luận trong huấn luyện AI Agent, thách thức tư duy truyền thống về mô hình thế giới, rất có giá trị cho cộng đồng nghiên cứu.

07/09

Thứ Hai · 3 tin
WeChat: Xiaohongshu Tech (dots.llm)
NgànhĐiểm AI 45/100

Giải quyết bất đồng tốc độ hội tụ trong huấn luyện đa giáo viên: Tiểu Hồng Thư giới thiệu D3-MOPD

Tiểu Hồng Thư (AllSpark) đề xuất phương pháp D3-MOPD nhằm khắc phục sự chênh lệch tốc độ hội tụ khi sử dụng nhiều mô hình giáo viên trong huấn luyện, giúp tối ưu hóa hiệu suất học tập cho mô hình.

06/09

Chủ Nhật · 2 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnStarVLA ra mắt VLAct: Chỉ với 16 GPU, vượt mặt NVIDIA GR00T N1.6 với dữ liệu ít hơn 80%

Nhóm nghiên cứu StarVLA giới thiệu VLAct, mô hình nền tảng VLM tối ưu hóa khả năng học từ dữ liệu robot, đạt hiệu suất vượt trội trên RoboDojo và RoboCasa dù chỉ dùng 16 GPU và 20% lượng dữ liệu so với các đối thủ.


Vì sao đáng đọc: Đột phá về hiệu quả huấn luyện (data efficiency) trong lĩnh vực robot VLA, giải quyết bài toán chi phí dữ liệu cao, có mã nguồn mở và kết quả thực nghiệm ấn tượng.

05/09

Thứ Bảy · 2 tin
QbitAI
Mô hìnhĐiểm AI 88/100

Tinh chọnMô hình thế giới 'nghỉ hưu' sau khi huấn luyện: Bí quyết giúp robot làm việc hiệu quả hơn

Một phương pháp huấn luyện đột phá cho phép robot vận hành linh hoạt và thông minh hơn bằng cách tối ưu hóa cách thức mô hình thế giới được áp dụng.


Vì sao đáng đọc: Chủ đề về robot và mô hình thế giới đang là xu hướng nóng, cách tiếp cận 'ngược đời' này mang tính gợi mở cao cho cộng đồng nghiên cứu AI.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnRoboTok: Công cụ khai thác dữ liệu từ Internet để huấn luyện robot thao tác khéo léo

RoboTok là hệ thống đột phá giúp trích xuất các video thao tác của con người từ Internet để huấn luyện robot, giải quyết bài toán thiếu hụt dữ liệu thực tế thông qua không gian chuyển động 3D linh hoạt.


Vì sao đáng đọc: Giải quyết trực tiếp nút thắt lớn nhất trong robot học là dữ liệu. Phương pháp tìm kiếm dựa trên chuyển động 3D rất sáng tạo và có tính ứng dụng thực tiễn cao.

04/09

Thứ Sáu · 6 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 43/100

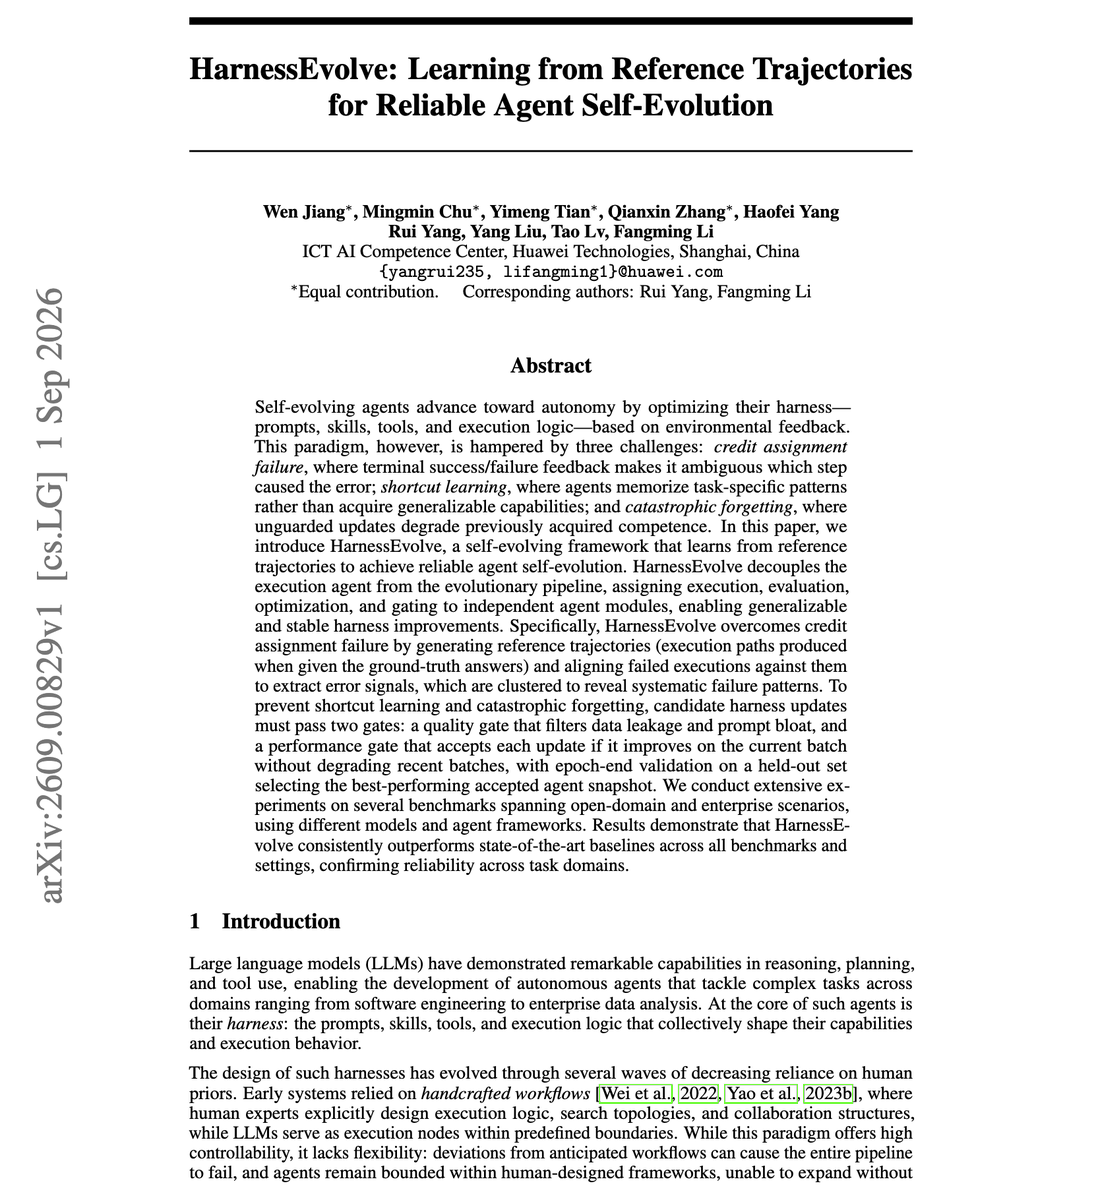
HarnessEvolve: Tối ưu hóa khả năng tự tiến hóa của AI Agent thông qua quỹ đạo tham chiếu

Self-improving agents have a basic problem: when a long run fails, they often do not know which step…

DịchNghiên cứu mới từ Huawei và các đối tác giới thiệu HarnessEvolve, phương pháp giúp AI Agent tự sửa lỗi bằng cách phân tích quỹ đạo thực thi, từ đó tinh chỉnh prompt, kỹ năng và logic vận hành để đạt hiệu suất ổn định hơn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Tái tư duy về chưng cất mô hình On-Policy: Chỉ cần một mẫu dữ liệu là đủ?

Nghiên cứu khám phá vai trò của dữ liệu trong chưng cất mô hình (OPD), chứng minh rằng chỉ với một truy vấn duy nhất, mô hình có thể cải thiện hiệu suất liên tục qua hàng trăm bước và đạt được phần lớn lợi ích so với việc dùng toàn bộ tập dữ liệu.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 37/100

CORE: Phương pháp chưng cất mô hình đa phương thức giúp tối ưu hóa khả năng suy luận kết hợp cho mô hình nhúng

Nghiên cứu giới thiệu CORE, kỹ thuật sử dụng mô hình đa phương thức làm bộ sắp xếp lại (reranker) để chưng cất khả năng suy luận kết hợp vào các mô hình nhúng thông qua mục tiêu Rank-KL và danh sách ứng viên tổng hợp.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Nghiên cứu thực nghiệm về khởi tạo hệ thống gợi ý hội thoại không cần dữ liệu mẫu

Nghiên cứu đề xuất phương pháp tạo dữ liệu hội thoại tổng hợp từ đánh giá sản phẩm và tương tác người dùng để huấn luyện hệ thống gợi ý mà không cần dữ liệu hội thoại thực tế, giúp tối ưu hóa hiệu suất trong các lĩnh vực mới.

03/09

Thứ Năm · 6 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 46/100

LLAMIA: Phương pháp mới giúp LLM phối hợp hiệu quả với các tác nhân phi ngôn ngữ

Nghiên cứu giới thiệu LLAMIA-Bench với 6 nhiệm vụ cờ vua, đồng thời đề xuất kỹ thuật nội tại hóa trạng thái tiềm ẩn, cho phép LLM tích hợp trực tiếp biểu diễn của các tác nhân chuyên biệt vào luồng token.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

KBMR: Bước tiến mới trong truy vấn hình ảnh dựa trên tri thức nhờ mô hình ngôn ngữ đa phương thức

KBMR giải quyết hạn chế của các mô hình CLIP truyền thống bằng cách sử dụng MLLM để ánh xạ hình ảnh vào không gian ngữ nghĩa, giúp nhận diện thực thể chính xác hơn trong các tác vụ VQA đòi hỏi kiến thức chuyên sâu.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MULTI3IR: Bộ tiêu chuẩn mới đánh giá khả năng truy xuất thông tin đa chiều và đa phương thức

Multi^3IR là bộ tiêu chuẩn đánh giá khả năng truy xuất thông tin cho các truy vấn mở, đa góc nhìn trên nhiều lĩnh vực. Nghiên cứu cũng giới thiệu SPIN, phương pháp tối ưu hóa giúp giảm độ lệch đơn chiều và cải thiện độ chính xác cho các mô hình truy xuất hiện nay.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 40/100

HarnessEvolve: Tối ưu hóa khả năng tự tiến hóa của AI thông qua quỹ đạo tham chiếu

Nice paper with great insights on improving self-evolving agents. Self-evolving agents fail in thre…

DịchNghiên cứu từ DAIR.AI chỉ ra ba điểm yếu chí mạng trong quá trình tự tiến hóa của AI: lỗi quy kết phản hồi, học vẹt theo nhiệm vụ và mất khả năng cũ. HarnessEvolve đề xuất sử dụng quỹ đạo tham chiếu để giúp AI tự cải thiện một cách bền vững và đáng tin cậy hơn.

Thêm 1 nguồn khác đưa tinX: Rohan Paul (@rohanpaul_ai)

02/09

Thứ Tư · 6 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Thích nghi không cần Gradient: Phương pháp CASTER tối ưu hóa mô hình AI mà không cần cập nhật tham số

CASTER là phương pháp thích nghi thời gian thực (TTA) không cần gradient, giúp điều chỉnh phân phối dữ liệu mà không cần cập nhật trọng số mô hình. Giải pháp này đặc biệt hiệu quả cho các thiết bị hạn chế bộ nhớ hoặc các mô hình bị khóa tham số.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnZimaBlue: Bước tiến mới trong huấn luyện mô hình hành động robot từ video quy mô lớn

ZimaBlue là khung huấn luyện đột phá giúp robot học cách điều khiển thông qua việc quan sát video thực tế thay vì chỉ dựa vào dữ liệu hành động đắt đỏ, giúp tăng khả năng thích nghi trong môi trường đa dạng.


Vì sao đáng đọc: Giải quyết bài toán hóc búa về dữ liệu trong robot học. Phương pháp tận dụng video egocentric để huấn luyện mô hình hành động có tính ứng dụng thực tiễn rất cao.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

Nghiên cứu cơ chế phối hợp giữa hiểu và tạo trong mô hình đa phương thức nguyên bản

Nghiên cứu chỉ ra rằng việc tách biệt nhiệm vụ giúp tránh sự suy giảm hiệu năng khi mô hình đa phương thức vừa hiểu vừa tạo ảnh, đồng thời khẳng định mô hình end-to-end vượt trội hơn so với các hệ thống phân tách truyền thống.

AK@_akhaliq
Nghiên cứuĐiểm AI 21/100

Nghiên cứu mới đặt dấu hỏi về cơ chế chưng cất On-Policy và đề xuất phương pháp OPSA không cần giám sát

Does On-Policy Distillation Really Distill? From Noisy Teacher to Self-Improvement paper: https: /…

DịchNghiên cứu này phân tích bản chất thực sự của quá trình chưng cất On-Policy và giới thiệu OPSA, một phương pháp mới giúp tối ưu hóa mà không cần dữ liệu giám sát.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (41 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “học máy” — Trang 3 | AIHOT.vn