26/09

Thứ Bảy · 1 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 31/100

RGBD20K: Bộ dữ liệu chuẩn quy mô lớn cho phân đoạn ngữ nghĩa RGB-D

RGBD20K cung cấp 20.000 cặp ảnh RGB-D với 160 lớp chi tiết, vượt xa các bộ dữ liệu cũ như NYUv2 hay SUN RGB-D. Nghiên cứu cũng giới thiệu phương pháp SPF giúp đạt hiệu suất SOTA trong phân đoạn ngữ nghĩa.

25/09

Thứ Sáu · 1 tin
AK@_akhaliq
Nghiên cứuĐiểm AI 20/100

Cùng sự kiệnNghiên cứu về khả năng khuếch tán của các biến tiềm ẩn chiều cao

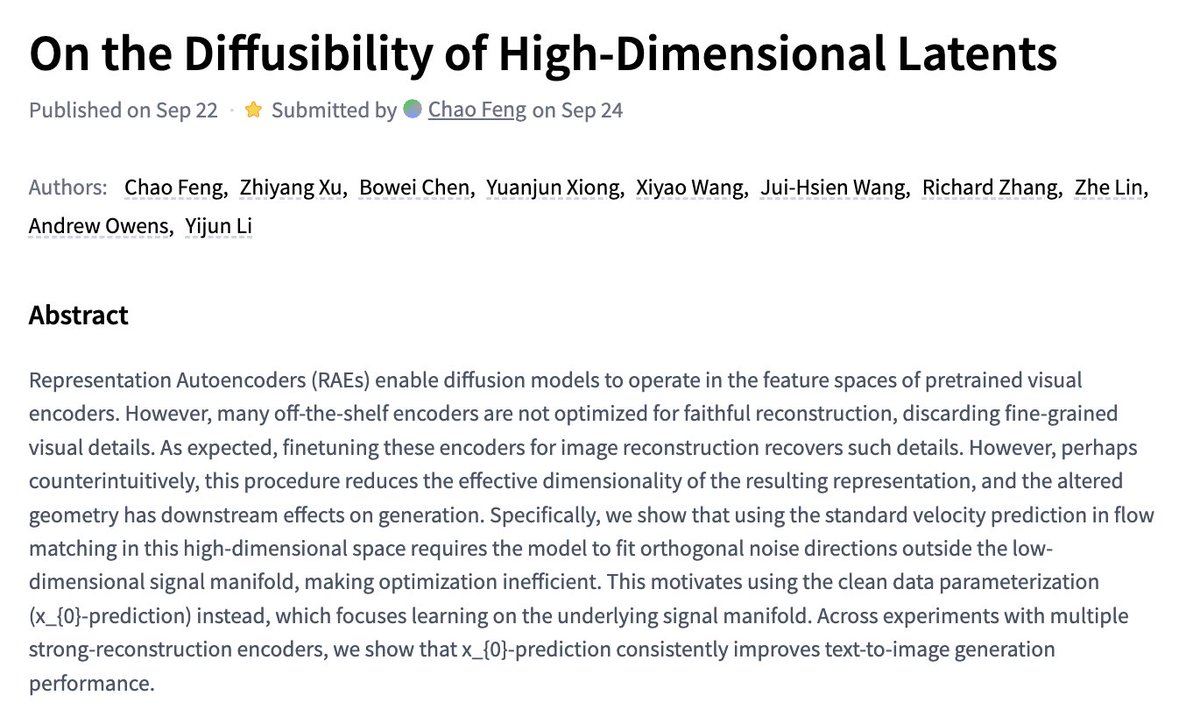
On the Diffusibility of High-Dimensional Latents paper: https://huggingface.co/papers/2609.28473

DịchBài báo khoa học này đi sâu phân tích cơ chế và tính khả thi của việc áp dụng mô hình khuếch tán (diffusion) trên các không gian biến tiềm ẩn có số chiều lớn, mở ra hướng đi mới cho việc tối ưu hóa kiến trúc mô hình tạo sinh.

Cùng sự kiện, bài đại diện «Tối ưu hóa khả năng khuếch tán trong không gian tiềm ẩn cao chiều với x0-prediction»

24/09

Thứ Năm · 2 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 45/100

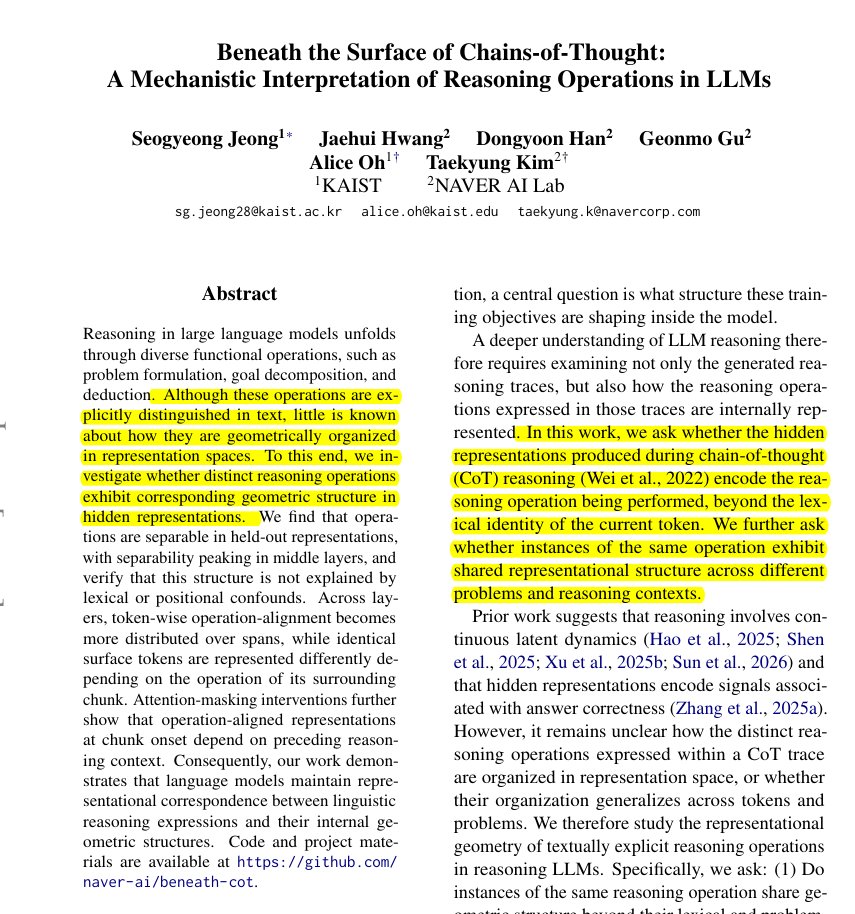
Nghiên cứu mới: LLM sở hữu cấu trúc tư duy nội tại tách biệt với văn bản đầu ra

The paper finds that LLM reasoning has an internal structure beyond the words being generated, openi…

DịchNghiên cứu chỉ ra rằng LLM vận hành các quy trình suy luận riêng biệt như tính toán hay suy diễn bên trong cấu trúc nội tại, ngay cả khi kết quả đầu ra bị sai. Điều này chứng minh mô hình có khả năng biểu diễn ý định tư duy độc lập với ngôn ngữ được tạo ra.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MemoryAthena: Tối ưu hóa bộ nhớ AI thông qua định tuyến thích ứng giữa dữ liệu truy xuất và tạo mới

MemoryAthena giới thiệu phương pháp kết hợp truy xuất bộ nhớ truyền thống với khả năng tự tạo nội dung, sử dụng bộ định tuyến thông minh để quyết định khi nào nên dùng dữ liệu gốc và khi nào cần bổ sung thông tin mới, giúp tăng độ chính xác cho mô hình.

23/09

Thứ Tư · 1 tin

22/09

Thứ Ba · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnTAPe+ML: Kiến trúc thị giác máy tính siêu gọn nhẹ cho đa tác vụ

TAPe+ML v3 là hệ thống thị giác máy tính đột phá với chưa đầy 100.000 tham số, sử dụng lý thuyết nhận thức chủ động để xử lý hiệu quả các tác vụ phân loại, phát hiện vật thể và phân đoạn ảnh với độ chính xác ấn tượng.


Vì sao đáng đọc: Đột phá về hiệu suất khi đạt kết quả cao với số lượng tham số cực nhỏ, mở ra tiềm năng ứng dụng AI trên các thiết bị biên hạn chế tài nguyên.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

Complex KDA: Tối ưu hóa khả năng biểu đạt của kiến trúc Kimi Delta Attention

Nghiên cứu giới thiệu Complex KDA (CKDA), kỹ thuật kết hợp biến đổi delta-rule với cơ chế cổng kênh để đạt được khả năng xoay 2D mà không cần tăng thứ hạng cập nhật, giúp nâng cao hiệu suất mô hình RNN.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 48/100

Tư duy như mô hình thế giới, hành động như VLA: Chưng cất tri thức vật lý vào robot nhỏ gọn

Phương pháp mới giúp chưng cất tri thức từ mô hình thế giới vào chính sách VLA, cho phép robot hiểu bối cảnh vật lý mà không cần tải mô hình giáo viên nặng nề khi huấn luyện.

21/09

Thứ Hai · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

IntBMoE: Tối ưu hóa kiến trúc Mixture-of-Experts thông qua cơ chế điều phối khối

IntBMoE giải quyết bài toán đánh đổi giữa hiệu năng, chi phí tính toán và bộ nhớ trong mô hình MoE bằng cách kết hợp kỹ thuật trộn chuyên gia dày đặc với cơ chế thực thi khối thưa thớt, cho phép kiểm soát độc lập các thông số này.

20/09

Chủ Nhật · 1 tin

18/09

Thứ Sáu · 3 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnTPAMI 2026: PolaFormer++ nâng tầm cơ chế chú ý tuyến tính với tính toán phân cực và độ nhọn cấp kênh

PolaFormer++ cải tiến cơ chế chú ý tuyến tính bằng cách tối ưu hóa ánh xạ đặc trưng thông qua tính toán phân cực và độ nhọn cấp kênh, giúp đạt hiệu suất vượt trội trên nhiều tác vụ thị giác máy tính.


Vì sao đáng đọc: Nghiên cứu được đăng trên tạp chí uy tín TPAMI, giải quyết bài toán cốt lõi về hiệu suất của Transformer, có mã nguồn mở và tính ứng dụng cao trong xử lý dữ liệu lớn.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 36/100

FAMOS: Mô hình dự đoán khớp nối vật thể 3D từ dữ liệu quan sát thưa thớt

FAMOS là mô hình Transformer tiên phong giúp dự đoán phân đoạn bộ phận và tham số khớp nối của vật thể 3D từ các đám mây điểm rời rạc, hỗ trợ linh hoạt ngay cả với dữ liệu đầu vào từ một góc nhìn duy nhất.

17/09

Thứ Năm · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

VC-Attention: Tối ưu hóa Attention cho mô hình Diffusion với kỹ thuật làm mịn giá trị và ép kiểu Softmax

VC-Attention là giải pháp không cần huấn luyện giúp tăng tốc và duy trì độ chính xác cho các mô hình Diffusion bằng cách xử lý nhiễu giá trị (value outliers) và tối ưu hóa hàm Softmax, giải quyết nút thắt chi phí tính toán trong các chuỗi video dài.

16/09

Thứ Tư · 2 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 37/100

PhysStream: Đột phá tạo video vật lý với khả năng ghi nhớ cảnh và kiểm soát chuyển động chi tiết

PhysStream là mô hình tạo video tự hồi quy sử dụng bộ nhớ cảnh có cấu trúc và tín hiệu vận tốc để kiểm soát chuyển động chính xác, vượt trội hơn các mô hình hiện tại về độ chính xác quỹ đạo và sự ưa thích của người dùng.

15/09

Thứ Ba · 2 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 48/100

Thay thế lan truyền ngược: Sakana AI giới thiệu phương pháp huấn luyện mạng thần kinh mới PC-ALM

Sakana AI ra mắt PC-ALM, phương pháp sử dụng động lực học cục bộ thay thế lan truyền ngược để huấn luyện mạng MLP 1000 lớp, đạt hiệu suất tương đương với các kỹ thuật truyền thống.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 46/100

Omni-Streaming Thinking: Giải pháp ngăn chặn AI đa phương thức đưa ra kết luận vội vàng

Omni-Streaming Thinking (OST) giúp mô hình AI phân tách dữ liệu thành bằng chứng và dự đoán, cho phép kiểm chứng thông tin theo thời gian thực để tránh sai sót khi xử lý dữ liệu đa phương thức.

14/09

Thứ Hai · 4 tin
AK@_akhaliq
NgànhĐiểm AI 22/100

SAS: Tối ưu hóa end-to-end cho việc xếp hạng ngữ cảnh trong cơ chế Sparse Attention

SAS Simple Attention Sparsification via End-to-End Optimization of Context Ranking paper: https://...

DịchNghiên cứu giới thiệu SAS, một phương pháp mới giúp tối ưu hóa hiệu quả tính toán của cơ chế chú ý (attention) thông qua việc xếp hạng ngữ cảnh end-to-end, giúp mô hình xử lý dữ liệu nhanh và tinh gọn hơn.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SAS: Tối ưu hóa trực tiếp việc chọn lọc ngữ cảnh để tinh giản cơ chế Attention trong Transformer

SAS là phương pháp mới giúp tinh giản cơ chế Attention bằng cách tối ưu hóa trực tiếp việc chọn lọc token quan trọng, thay vì chỉ bắt chước phân phối trọng số của mô hình gốc, giúp sử dụng hiệu quả hơn ngân sách tính toán hạn chế.

MarkTechPost
NgànhĐiểm AI 33/100

Đại học Princeton giới thiệu Recurrent Looped Transformer (RLT): Đột phá kiến trúc với cơ chế truyền trạng thái liên tục

Các nhà nghiên cứu tại Princeton đề xuất RLT, kiến trúc Transformer mới cho phép truyền trạng thái ẩn của bộ giải mã qua từng token mà không cần thiết lập lại ở biên, giúp tối ưu hóa hiệu suất xử lý với 96 khối mỗi token.

13/09

Chủ Nhật · 1 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 33/100

Khung toán học cho mạch Transformer (2021): Nền tảng của khả năng diễn giải AI

Nghiên cứu kinh điển này thiết lập khung toán học để phân tích cơ chế bên trong của Transformer, giúp giải mã cách các đầu chú ý (attention heads) và luồng dư (residual streams) vận hành. Đây là tài liệu nền tảng quan trọng cho lĩnh vực nghiên cứu khả năng diễn giải mô hình AI.

12/09

Thứ Bảy · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Giải mã Image Tokenizer: Ngôn ngữ thị giác trong các mô hình đa phương thức hợp nhất

Nghiên cứu này đề xuất phương pháp đánh giá mới cho Image Tokenizer thông qua việc theo dõi tổn thất (loss) trong quá trình huấn luyện đa phương thức, giúp hiểu rõ cách các token thị giác và văn bản tương tác để tối ưu hóa hiệu suất mô hình.

11/09

Thứ Sáu · 5 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 48/100

FreeFlow: Transformer phân cấp đột phá, thiết lập kỷ lục mới cho bài toán ước tính luồng quang học

Nhóm nghiên cứu từ ĐH Quốc gia Moscow giới thiệu FreeFlow, kiến trúc Transformer tinh gọn không cần các thành phần chuyên dụng như warping hay volume tương quan, đạt hiệu suất dẫn đầu trên các bộ dữ liệu Sintel, KITTI-2015 và Spring.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 34/100

UniH3: Khung phục hồi ảnh y tế toàn năng giải quyết sự đồng nhất và khác biệt dữ liệu

Nhóm nghiên cứu từ Beihang và Tsinghua giới thiệu UniH3, khung làm việc đột phá giúp tối ưu hóa phục hồi ảnh y tế bằng cách cân bằng các đặc trưng đồng nhất và dị biệt. Mô hình đạt hiệu suất SOTA trên các bộ dữ liệu lớn và đã được mã nguồn mở.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 39/100

X-AuT: Tối ưu hóa bộ mã hóa âm thanh cho mô hình ngôn ngữ lớn thông qua nén và chưng cất

X-AuT sử dụng kỹ thuật cắt tỉa dần dần và chưng cất đa quy mô để nén bộ mã hóa âm thanh của LLM, giúp giảm số lớp Transformer mà vẫn cải thiện độ chính xác trên các bài kiểm tra tiếng Anh và tiếng Trung.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

NCP-ArchPreview: Bước tiến mới của mô hình ngôn ngữ thông qua dự đoán khái niệm (Next Concept Prediction)

NCP-ArchPreview giới thiệu phương pháp huấn luyện mới, kết hợp dự đoán token truyền thống với dự đoán khái niệm (NCP) để mô hình hiểu sâu hơn về cấu trúc ngôn ngữ. Với 8,9 tỷ tham số, mô hình này cho thấy tiềm năng lớn trong việc cải thiện khả năng suy luận và tạo văn bản.

10/09

Thứ Năm · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

OracleZoom: Đột phá siêu phân giải hình ảnh đệ quy với cơ chế tự chưng cất và ràng buộc tham chiếu

OracleZoom giải quyết thách thức thiếu dữ liệu gốc ở các cấp độ phóng đại cực lớn bằng cách sử dụng cơ chế tự chưng cất và ràng buộc tham chiếu, giúp mô hình duy trì độ chính xác khi thực hiện siêu phân giải đệ quy.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 43/100

Tại sao xử lý video vẫn quá đắt đỏ? Tổng quan về cơ chế tối ưu hiệu năng suy luận cho Video LLM

Bài tổng quan hệ thống hóa các phương pháp tối ưu hóa suy luận cho Video LLM qua bốn giai đoạn: lấy mẫu khung hình, mã hóa đa phương thức, nén token và xử lý LLM, đồng thời chỉ ra những khoảng trống trong tiêu chuẩn đánh giá hiệu năng hiện nay.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnAction Map Policy: Bước ngoặt mới trong học điều khiển robot từ hồi quy sang phân loại điểm ảnh

Nghiên cứu đề xuất phương pháp Action Map Policy, áp dụng cơ chế Cross-Entropy từ mô hình ngôn ngữ lớn vào điều khiển robot, giúp giải quyết bài toán không gian hành động đa chiều phức tạp thông qua phân loại thay vì hồi quy truyền thống.


Vì sao đáng đọc: Chủ đề mang tính đột phá, kết nối thành công Scaling Law của LLM vào lĩnh vực robot học, có tiềm năng thay đổi cách huấn luyện tác nhân vật lý hiện nay.

09/09

Thứ Tư · 8 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ReactVAU: Khung làm việc tách biệt nhanh-chậm giúp phát hiện bất thường trong video trực tuyến

ReactVAU giải quyết bài toán giám sát thời gian thực bằng cách kết hợp mô-đun phát hiện nhanh để lọc dữ liệu và mô-đun suy luận chuyên sâu chỉ kích hoạt khi có sự kiện nghi vấn, giúp tối ưu hóa hiệu suất mà vẫn đảm bảo tính chính xác.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 36/100

CoVeR: Phương pháp cắt tỉa token dựa trên độ phủ cho suy luận 3D đa góc nhìn trên VLM

CoVeR là bộ chọn token thị giác không cần huấn luyện, giúp tối ưu hóa suy luận 3D đa góc nhìn bằng cách loại bỏ token dư thừa. Chỉ với 8% lượng token, mô hình vẫn duy trì 93,5% hiệu suất, vượt qua các phương pháp hiện có tới 3,9 điểm phần trăm.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (60 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Deep Learning” | AIHOT.vn