25/09

Thứ Sáu · 2 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

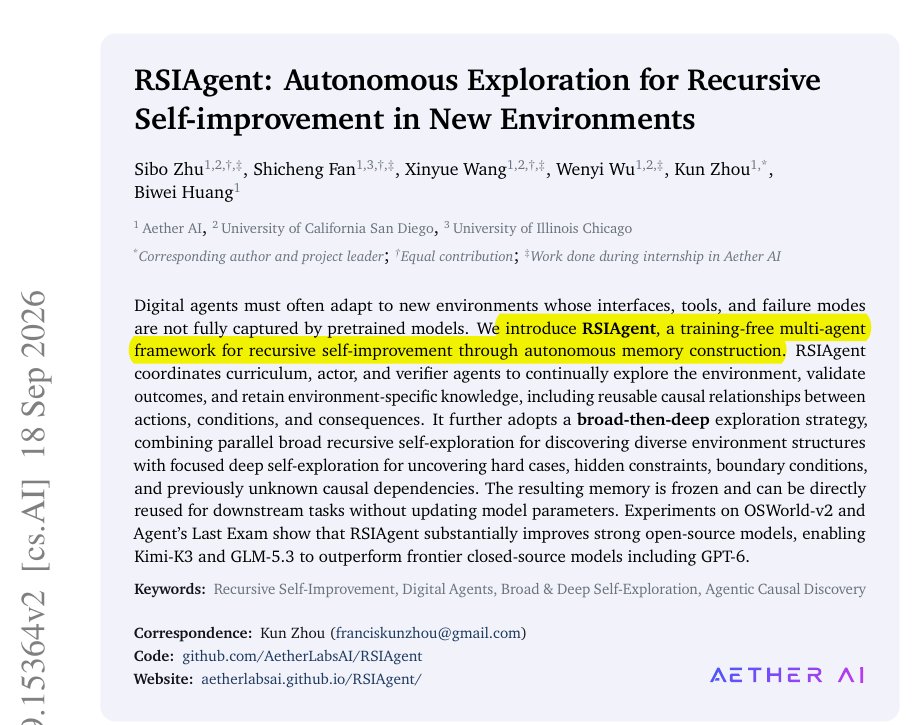
RSIAgent: Phương pháp huấn luyện tác nhân AI giải quyết tác vụ mới hiệu quả hơn

Agents that explored widely before tackling hard cases averaged 74.54% on 4 tasks, versus 56.50% whe…

DịchRSIAgent sử dụng chiến lược học tập theo lộ trình: khám phá rộng trước khi đi sâu vào các trường hợp khó, giúp tăng tỷ lệ thành công từ 56,5% lên 74,54% so với cách tiếp cận trực tiếp.
MarkTechPost
Nghiên cứuĐiểm AI 54/100

Perplexity huấn luyện AI Agent tự học từ sai lầm thực tế bằng phương pháp OPSD

Perplexity giới thiệu kỹ thuật OPSD kết hợp tinh chỉnh từ chối lấy mẫu, sử dụng dữ liệu từ các phiên làm việc thực tế của Perplexity Computer (chạy trên GLM 5.2) để giúp AI tự rút kinh nghiệm từ những lỗi sai.

Thêm 1 nguồn khác đưa tinX: Aravind Srinivas (Perplexity CEO) (@AravSrinivas)

24/09

Thứ Năm · 4 tin
QbitAI
Nghiên cứuĐiểm AI 92/100

Tinh chọnSau GPT-6, tương lai robot thông minh đi về đâu? GLOW của Noein giúp robot 'học một biết mười'

Báo cáo kỹ thuật GLOW từ Noein cho thấy khả năng đột phá: chỉ cần con người làm mẫu một lần, robot có thể thực hiện và tái sử dụng tác vụ linh hoạt trong nhiều môi trường khác nhau.


Vì sao đáng đọc: Chủ đề (Embodied AI) đang là tâm điểm. Việc giải quyết bài toán 'học một lần' (one-shot learning) cho robot là bước tiến lớn, rất thu hút giới công nghệ.

23/09

Thứ Tư · 7 tin
JiQiZhiXin
Mô hìnhĐiểm AI 88/100

Tinh chọnBước tiến mới của robot thông minh: Psi-R2.5 tối ưu hóa huấn luyện nhờ dữ liệu cặp chất lượng cao

ra mắt mô hình Psi-R2.5, thay đổi cách huấn luyện robot bằng cách sử dụng dữ liệu cặp (Pair Data) chất lượng cao, cho phép robot học kỹ năng mới chỉ qua một lần quan sát mà không cần tái huấn luyện.


Vì sao đáng đọc: Bài viết cập nhật công nghệ quan trọng trong lĩnh vực robot học, giải quyết bài toán dữ liệu thực tế và khả năng học ngữ cảnh (In-Context Learning) đầy tiềm năng.
QbitAI
Mô hìnhĐiểm AI 88/100

Tinh chọnĐột phá mới: Dạy robot làm việc qua video với 120 tỷ token hành động con người

Các nhà nghiên cứu tận dụng kho dữ liệu video khổng lồ từ internet để huấn luyện robot, giúp sai số giảm dần theo quy luật lũy thừa khi quy mô dữ liệu tăng lên.


Vì sao đáng đọc: Công nghệ huấn luyện robot từ video thực tế là xu hướng then chốt, có tính ứng dụng cao và mở ra hướng đi mới cho robot tự hành.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Ovis-Embedding: Đột phá mới trong mô hình nhúng đa phương thức toàn diện

Ovis-Embedding là mô hình nhúng đa phương thức tiên tiến, tích hợp văn bản, hình ảnh, video và âm thanh vào một không gian biểu diễn chung nhờ kiến trúc backbone thống nhất và phương pháp huấn luyện tập trung vào dữ liệu chất lượng cao.

Francois Chollet@fchollet
Quan điểmĐiểm AI 20/100

François Chollet: Mọi ngành khoa học rồi sẽ trở thành một nhánh của Khoa học máy tính

The tweet below got enormous pushback at the time I posted it, more than 5 years ago. But this predi…

DịchFrançois Chollet khẳng định dự đoán từ 5 năm trước của ông đang dần trở thành hiện thực: trong 10-20 năm tới, các ngành như vật lý, hóa học, y học sẽ phụ thuộc hoàn toàn vào mô phỏng, dữ liệu lớn và học máy, biến chúng thành các phân nhánh của khoa học máy tính.

22/09

Thứ Ba · 9 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 39/100

EvolveTrade: Tối ưu hóa AI giao dịch bằng hệ thống nhắc lệnh tiến hóa

Cool paper showing how effective tuning a system prompt for an agent can be. Recommended paper if y…

DịchEvolveTrade sử dụng một AI độc lập để liên tục tinh chỉnh câu lệnh hệ thống (system prompt) dựa trên hiệu suất giao dịch thực tế. Phương pháp này giúp các mô hình AI tự động điều chỉnh chiến lược, tăng cường khả năng phân tích dữ liệu và cải thiện đáng kể lợi nhuận so với các prompt cố định.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

Harness-Zero: Kỹ thuật chưng cất khung làm việc cho AI Agent

Harness-Zero giới thiệu phương pháp 'agent-as-harness' giúp chuyển giao hành vi tối ưu từ các khung làm việc phức tạp trực tiếp vào trọng số mô hình, giúp AI duy trì hiệu suất cao ngay cả khi không còn phụ thuộc vào khung hỗ trợ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnHuRo: Chuyển đổi video hành động của người thành dữ liệu huấn luyện robot quy mô lớn

HuRo là phương pháp mới giúp chuyển đổi video hành động của con người thành dữ liệu điều khiển robot, tạo ra tập dữ liệu khổng lồ với 630.000 tập mẫu để huấn luyện các mô hình VLA hiệu quả hơn.


Vì sao đáng đọc: Nghiên cứu giải quyết bài toán thiếu hụt dữ liệu robot bằng cách tận dụng kho video con người khổng lồ, có tiềm năng lớn trong việc thúc đẩy khả năng học tập của robot.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

RRSI: Phương pháp tự cải tiến đệ quy giúp AI Agent tránh quá tải và tối ưu hiệu suất

RRSI giải quyết vấn đề quá tải khi AI Agent tự cải tiến bằng cách sử dụng cơ chế kiểm soát ngân sách thời gian, bộ lọc phê bình và công cụ cắt tỉa để đảm bảo các thay đổi thực sự hiệu quả trên nhiều tác vụ khác nhau.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

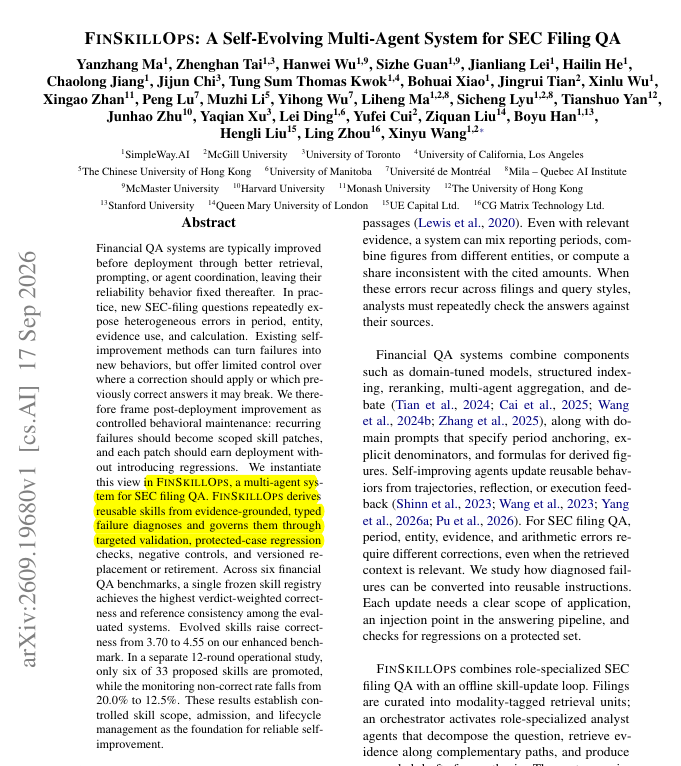
Harvard và MIT đề xuất phương pháp mới giúp AI tài chính tự cải thiện

New Harvard + MIT + other labs paper shows a cleaner path to self-improving financial AI: let the …

DịchCác nhà nghiên cứu giới thiệu FINSKILLOPS, hệ thống cho phép AI học hỏi từ lỗi sai trong phân tích tài chính thông qua cơ chế kiểm thử hồi quy nghiêm ngặt, giúp chuyển đổi RAG tĩnh thành hệ thống tự học bền vững.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 42/100

SkillLift: Tối ưu hóa tiến hóa kỹ năng cho AI Agent với chi phí thấp hơn 70%

Nice paper showing a better way to evolve agent skills. And they achieve 40-70% less token cost com…

DịchSkillLift sử dụng tiêu chuẩn đánh giá học được để xếp hạng các gợi ý kỹ năng, giúp giảm 40-70% chi phí tự tiến hóa cho AI Agent mà vẫn vượt trội hơn các phương pháp hiện có trên hàng trăm tác vụ.

21/09

Thứ Hai · 5 tin
Clément Delangue (Hugging Face CEO)@ClementDelangue
NgànhĐiểm AI 45/100

Eidon AI công bố mã nguồn mở 1.274 giờ dữ liệu huấn luyện robot

Most companies that shut down give up their impact. This startup did something much better: they ope…

DịchStartup Eidon AI vừa chia sẻ 1.274 giờ dữ liệu video từ góc nhìn người thứ nhất, ghi lại 13.451 tác vụ hàng ngày nhằm thúc đẩy sự phát triển của cộng đồng robot học.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 54/100

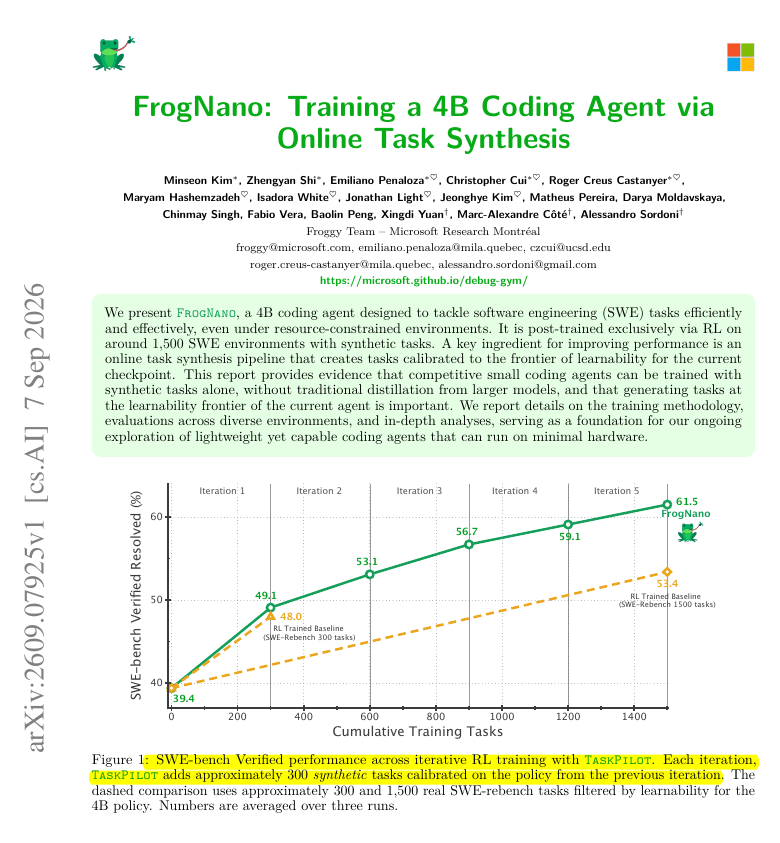
FrogNano: Mô hình lập trình 4B đạt 61.5% trên SWE-bench Verified nhờ huấn luyện tổng hợp tác vụ

A 4B coding agent reached 61.5% on SWE-bench Verified without frontier-model distillation by combini…

DịchFrogNano là mô hình AI chuyên biệt cho lập trình với kích thước nhỏ gọn 4 tỷ tham số, gây ấn tượng mạnh khi đạt hiệu suất 61.5% trên bộ kiểm chuẩn SWE-bench Verified thông qua phương pháp huấn luyện tổng hợp tác vụ trực tuyến.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Cal-OPD: Tối ưu hóa chưng cất mô hình thông qua hiệu chỉnh sai lệch giữa giáo viên và học sinh

Cal-OPD giải quyết vấn đề mô hình học sinh vô tình học phải các sai lệch nội tại của giáo viên trong quá trình chưng cất (distillation), bằng cách tách biệt và loại bỏ các nhiễu này để cải thiện khả năng suy luận.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnCode2Skill: Tự động hóa chuyển đổi mã nguồn thành kỹ năng thực thi cho AI Agent

Code2Skill là quy trình tự động giúp AI học kỹ năng từ hàng triệu kho lưu trữ GitHub, biến mã nguồn thành các thao tác có thể thực thi và kiểm chứng, giúp AI mở rộng khả năng vượt xa kinh nghiệm sẵn có.

Thêm 1 nguồn khác đưa tinX: DAIR.AI (@dair_ai)

Vì sao đáng đọc: Nghiên cứu đột phá về cách AI tự học kỹ năng từ mã nguồn thực tế, giải quyết bài toán mở rộng quy mô cho Agentic AI một cách hiệu quả và có tính ứng dụng cao.

20/09

Chủ Nhật · 2 tin

19/09

Thứ Bảy · 2 tin

18/09

Thứ Sáu · 7 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

RetireOPD: Phương pháp chưng cất chính sách tự động giải phóng cho tác nhân học tăng cường

RetireOPD giới thiệu cơ chế tự động loại bỏ giáo viên khi học sinh đạt ngưỡng hiệu suất, giúp tối ưu hóa quá trình huấn luyện tác nhân thông qua việc kết hợp học tăng cường và chưng cất chính sách.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

When2Think: Tối ưu hóa suy luận AI bằng cách điều chỉnh độ dài phản hồi theo độ khó

When2Think là khung huấn luyện hậu kỳ giúp mô hình AI tự nhận diện độ khó của câu hỏi để phân bổ tài nguyên tính toán linh hoạt. Phương pháp này giúp giảm 27,9% lượng token tiêu thụ mà vẫn tăng đáng kể độ chính xác trên các bài toán khó như AIME.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

JEPA-Anything: Bước tiến mới với khung mô hình thế giới thống nhất đa lĩnh vực

Nghiên cứu giới thiệu JEPA-Anything, khung mô hình thế giới dựa trên phân tách dự đoán trực giao (OPF), có khả năng ứng dụng linh hoạt từ thị giác máy tính, y sinh đến vật lý và dự báo thời tiết.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

EvoSkill-GUI: Tối ưu hóa kỹ năng cho tác nhân AI trên giao diện người dùng mà không cần huấn luyện lại

EvoSkill-GUI giới thiệu khung làm việc cho phép các tác nhân AI tự động tinh chỉnh và tiến hóa kỹ năng dựa trên phản hồi thực tế khi thao tác với giao diện người dùng, giúp xử lý linh hoạt các thay đổi bất ngờ mà không cần huấn luyện bổ sung.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 41/100

Mô hình ngôn ngữ tham số vô hạn: Tạo và điều chỉnh trọng số từ dữ liệu thời gian thực

Nghiên cứu giới thiệu Infinite-Parameter LLM, sử dụng siêu mạng để tạo trọng số từ dữ liệu thực tế thay vì lưu trữ cố định. Phương pháp này giúp mô hình liên tục cập nhật kiến thức vào trọng số, tối ưu hóa bộ nhớ và duy trì thông tin xuyên suốt các phiên hội thoại.

17/09

Thứ Năm · 7 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnXConf: Nâng cao độ tin cậy của mô hình ngôn ngữ thông qua kinh nghiệm thực tế

XConf là phương pháp ước tính độ tin cậy mới, không chỉ dựa vào suy luận hiện tại mà còn truy xuất các bài học từ những trải nghiệm giải quyết vấn đề trong quá khứ để đánh giá chính xác hơn khả năng thành công của mô hình.


Vì sao đáng đọc: Đây là hướng tiếp cận mới mẻ và thực tiễn trong việc giải quyết bài toán 'ảo tưởng' của AI, giúp các hệ thống tự động hóa đưa ra quyết định tin cậy hơn.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (101 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Học máy” | AIHOT.vn