Hôm qua · 27/09

Chủ Nhật · 5 tin
SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 28/100

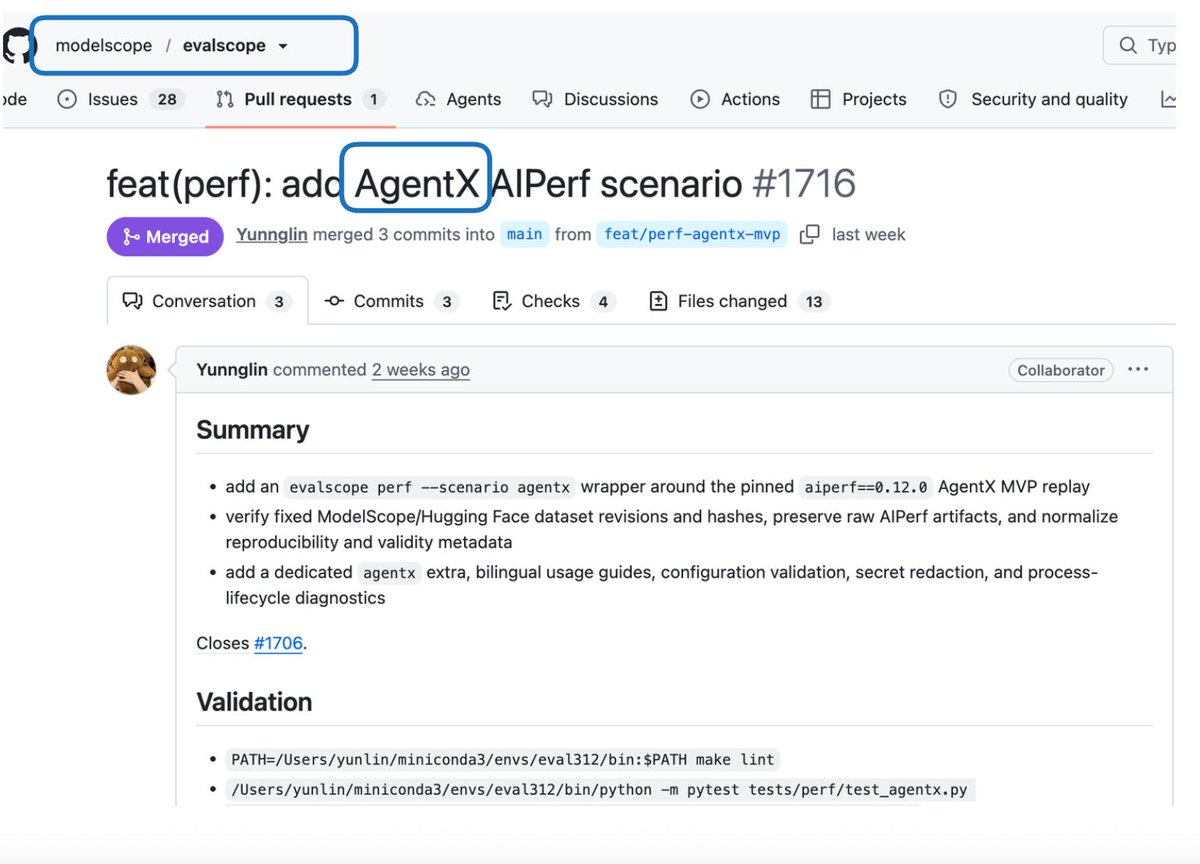
SemiAnalysis AgentX chính thức tích hợp vào nền tảng đánh giá ModelScope

Happy to announce that SemiAnalysis AgentX has been integrated into ModelScope, an eval framework wi…

DịchKhung đánh giá AgentX của SemiAnalysis đã được tích hợp vào ModelScope, khẳng định vị thế tiêu chuẩn ngành khi được hàng loạt ông lớn như OpenAI, Meta, Alibaba Qwen và Moonshot tin dùng.

Xiaobei@frxiaobei
NgànhĐiểm AI 36/100

Công ty dán nhãn dữ liệu: Đánh giá (evals) sẽ là tài sản trí tuệ cốt lõi của doanh nghiệp

Các doanh nghiệp lớn đang chuyển dịch từ việc dùng mô hình AI chung sang xây dựng hệ thống đánh giá (evals) nội bộ để tối ưu hóa hiệu suất AI, biến đây thành lợi thế cạnh tranh độc quyền thay vì chỉ dựa vào các mô hình mã nguồn mở.

Hongming@hongming731
Quan điểmĐiểm AI 31/100

BestBlogs: Parag Agrawal đề xuất mô hình kinh tế cho AI Agent và cách đánh giá tác vụ dài hạn

Cựu CEO Twitter Parag Agrawal đề xuất hạ tầng tìm kiếm và cơ chế trả phí cho nội dung mà AI Agent sử dụng. Đồng thời, các chuyên gia nhấn mạnh việc chuẩn hóa môi trường thử nghiệm và quy trình phản hồi là chìa khóa để phát triển các Agent thực hiện tác vụ dài hạn.

26/09

Thứ Bảy · 5 tin
Artificial Analysis@ArtificialAnlys
Quan điểmĐiểm AI 31/100

Nhìn lại 2 năm phát triển của AI: Từ o1-preview đến kỷ nguyên mô hình suy luận

Two years ago today in AI: Artificial Analysis reported on OpenAI pushing the intelligence frontier …

DịchArtificial Analysis điểm lại cột mốc 2 năm kể từ khi o1-preview ra mắt, đánh dấu bước ngoặt của các mô hình suy luận. Chỉ số Intelligence Index cũng đã tiến hóa từ 4 bài kiểm tra cơ bản lên 10 tiêu chuẩn đánh giá khắt khe, phản ánh sự thay đổi sâu sắc trong cách AI tư duy và giải quyết vấn đề.

Arena@arena
Nghiên cứuĐiểm AI 67/100

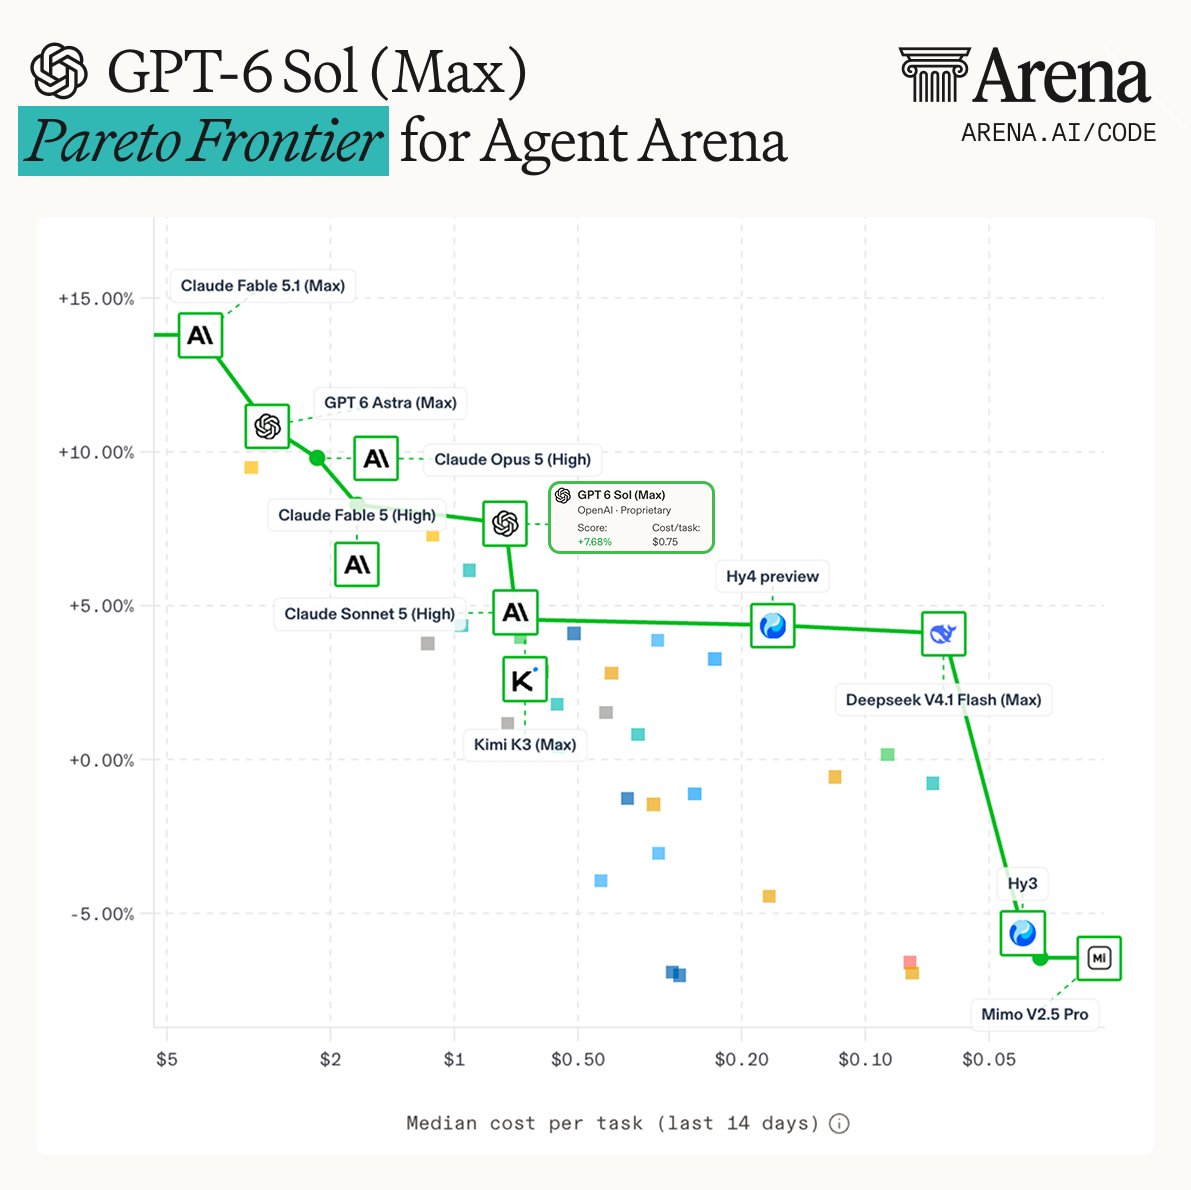
Đã có đại diệnGPT-6 Sol (Max) thiết lập chuẩn mực mới trên Agent Arena với hiệu suất tăng 7,7%

GPT-6 Sol (Max) by @OpenAI has reshaped the Agent Arena Pareto frontier with a +7.7% net improvement…

DịchOpenAI vừa đưa GPT-6 Sol (Max) vào bảng xếp hạng Agent Arena. Mô hình này đạt mức cải thiện ròng 7,7% dựa trên hơn 4.000 phiên hội thoại thực tế, xếp hạng 6 với chi phí trung bình 0,75 USD mỗi tác vụ.

Cùng sự kiện, tinh chọn hiển thị «OpenAI ra mắt bộ đôi GPT-6 Sol và Luna, giảm 50% giá API so với bản tiền nhiệm»
Arena@arena
Mô hìnhĐiểm AI 47/100

Cùng sự kiệnSo sánh khả năng viết của Claude Opus 5.5 và Opus 5 trên Text Arena

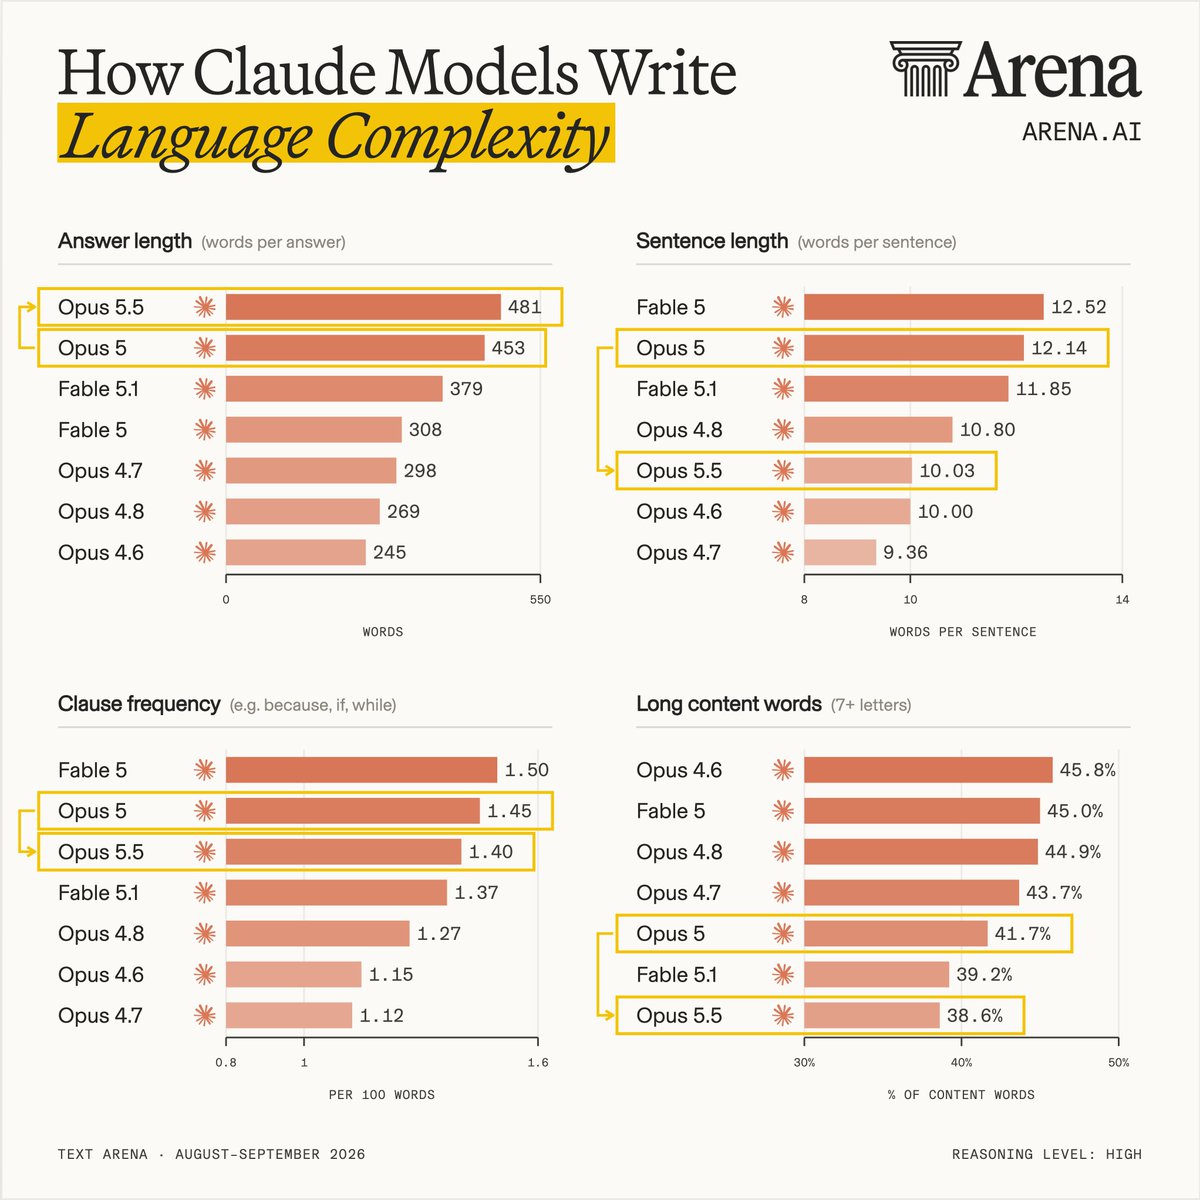
We analyzed how @claudeai's Opus 5.5 writes compared with Opus 5 across high-reasoning Text Arena ou…

DịchPhân tích từ Arena cho thấy Claude Opus 5.5 cải thiện 10/12 chỉ số viết so với Opus 5, với văn phong súc tích hơn, giảm đáng kể việc sử dụng dấu câu phức tạp và từ ngữ rườm rà.

Cùng sự kiện, tinh chọn hiển thị «Anthropic giải mã lý do Claude Opus 5.5 là lựa chọn tối ưu cho lập trình với ngữ cảnh dài»

25/09

Thứ Sáu · 7 tin
karminski@karminski3
Mô hìnhĐiểm AI 43/100

Đánh giá Step-5-Preview: Khả năng lập trình ổn định và tư duy Agent vượt trội

Step-5-Preview gây ấn tượng với độ ổn định đầu ra cao và khả năng xử lý Agent Loop xuất sắc, đặc biệt hiệu quả trong lập trình kỹ thuật. Dù còn hạn chế về thẩm mỹ và 3D, đây là bước tiến lớn về tư duy logic và tối ưu hóa tác vụ của mô hình.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

ExplorationBench: Đánh giá khả năng khám phá của AI trong các 'thế giới lạ' có thể kiểm chứng

ExplorationBench sử dụng các môi trường giả lập với quy tắc logic mới lạ, buộc AI phải tự khám phá thay vì dựa vào dữ liệu huấn luyện sẵn, giúp đánh giá chính xác tư duy khoa học của mô hình.

Arena@arena
Mô hìnhĐiểm AI 47/100

LMSYS Arena ra mắt giao diện bảng xếp hạng mới: Cập nhật thời gian thực và phân loại chuyên sâu

The redesigned Arena Leaderboard Overview is live! The frontier is moving quickly, so we built a ce…

DịchArena vừa nâng cấp bảng xếp hạng với giao diện mới, tích hợp luồng dữ liệu thời gian thực, phân loại theo chuyên môn (Coding, Agent, Image) và đánh giá nhanh các mô hình mới như GPT-6 Sol hay Claude Opus 5.5.

Factory Nghiên cứu / Sản phẩm
Mô hìnhĐiểm AI 40/100

Legacy-Bench của Factory gia nhập chỉ số SII của Fireworks: Đâu là mô hình AI xử lý mã nguồn cũ tốt nhất?

Legacy-Bench đã được tích hợp vào Specialized Intelligence Index (SII) của Fireworks để đánh giá khả năng của các mô hình AI trong việc xử lý, gỡ lỗi và chuyển đổi các ngôn ngữ lập trình cũ như COBOL, Java 7, BASIC, C89, Fortran và Assembly.

OpenRouter@OpenRouter
Mô hìnhĐiểm AI 28/100

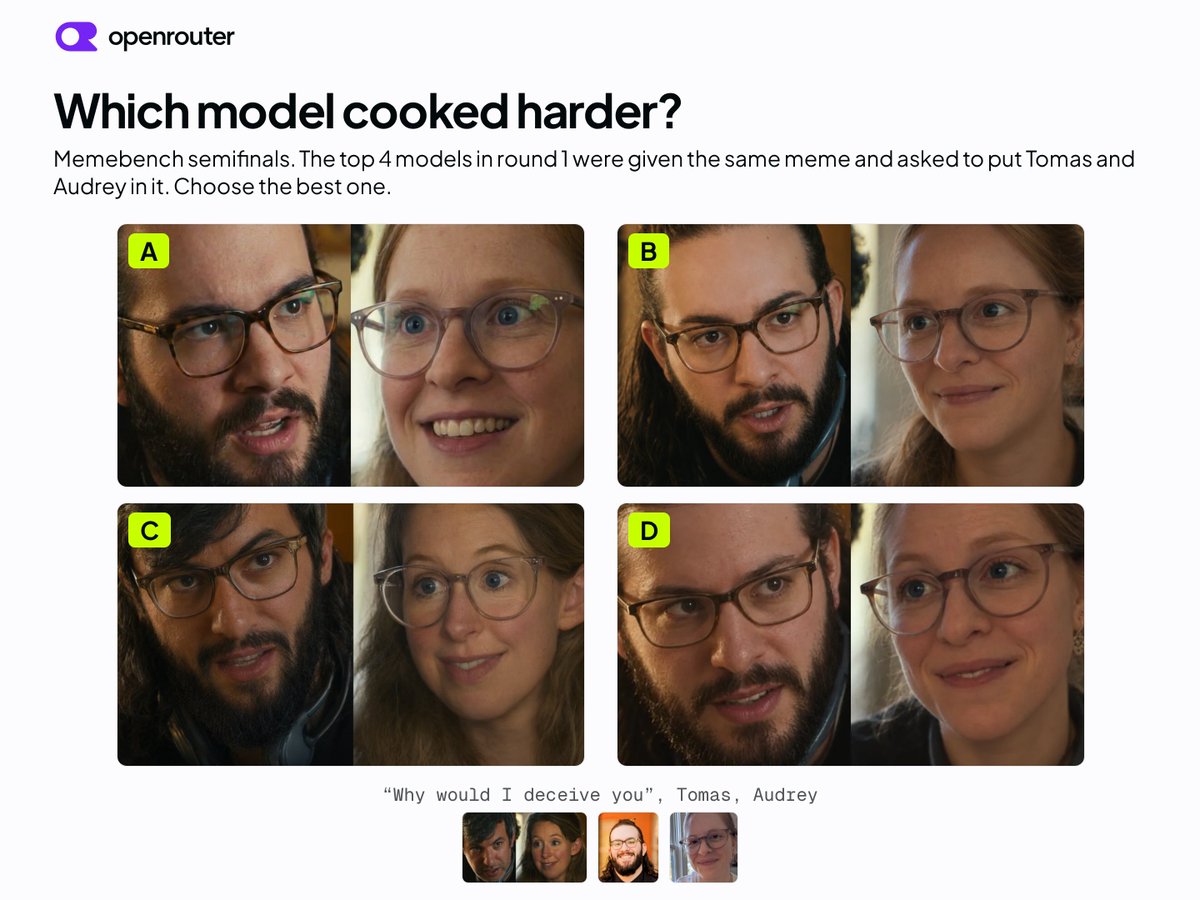
OpenRouter tổ chức vòng chung kết Memebench: Tìm kiếm mô hình hiểu meme đỉnh nhất

Presenting the Memebench Grand Finals The top 4 models from round 1 face off to determine which mod…

DịchOpenRouter khởi động vòng chung kết Memebench với sự góp mặt của 4 mô hình xuất sắc nhất từ vòng loại, cùng tranh tài trong thử thách giải mã meme "Why would I deceive you".

Ethan Mollick@emollick
Quan điểmĐiểm AI 20/100

Đề xuất thay thế biểu đồ 'Tầm nhìn tác vụ dài' của METR đã lỗi thời

I propose this as the official replacement for the famous (and now saturated) METR Long Task Horizon…

DịchEthan Mollick đề xuất một phương án thay thế mới cho biểu đồ METR Long Task Horizon vốn đã quá quen thuộc nhưng hiện không còn phản ánh chính xác năng lực của các mô hình AI hiện đại.

24/09

Thứ Năm · 14 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 51/100

Nghiên cứu Jev-as-a-Judge: Kết hợp mô hình giá rẻ và GPT-6 Astra giúp tiết kiệm 43% chi phí mà vẫn giữ nguyên độ chính xác

Banger paper introducing Jev-as-a-Judge. The overall finding is that you want to use a cheap judge …

DịchNghiên cứu đề xuất phương pháp phân tầng đánh giá: sử dụng mô hình giá rẻ cho các tác vụ đơn giản và chỉ chuyển các trường hợp không chắc chắn lên GPT-6 Astra, giúp tối ưu chi phí đáng kể mà vẫn duy trì 99% hiệu suất.

WeChat: Carl AI Watts
Hướng dẫnĐiểm AI 70/100

Cùng sự kiệnĐánh giá thực tế GPT-6 Sol, Luna và Claude Opus 5.5: Đột phá về lập trình, thiết kế và đa phương thức

Bài viết trải nghiệm ba mô hình mới với hiệu suất vượt trội: GPT-6 Sol và Luna giảm 50% chi phí API, trong khi Claude Opus 5.5 tăng 30% tốc độ và giảm 40% chi phí, kèm theo nâng cấp hạn mức sử dụng cho các gói trả phí.

Cùng sự kiện, tinh chọn hiển thị «Sam Altman: GPT-6 Sol và Luna không có đối thủ về hiệu suất chi phí theo tác vụ»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnKho mã nguồn Schrödinger: Liệu LLM thực sự hiểu lập trình hay chỉ đang học vẹt SWE-bench?

Nghiên cứu giới thiệu SchrodingerRepo, một khung đánh giá mới giúp loại bỏ tình trạng 'học vẹt' bằng cách thay đổi cấu trúc mã nguồn động, buộc các tác nhân AI phải thực sự tư duy thay vì dựa vào dữ liệu đã ghi nhớ từ trước.


Vì sao đáng đọc: Đề tài rất quan trọng trong bối cảnh các benchmark lập trình hiện nay đang bị bão hòa do dữ liệu rò rỉ, ảnh hưởng trực tiếp đến độ tin cậy của các mô hình coding AI.
OpenRouter@OpenRouter
Mô hìnhĐiểm AI 24/100

OpenRouter khởi động Memebench: Cuộc chiến chế ảnh giữa các mô hình AI

Meet Memebench - Group B We gave 8 AI models the same meme and asked them to put @pingToven and @Au…

DịchOpenRouter tổ chức thử thách Memebench, yêu cầu 8 mô hình AI cùng chỉnh sửa một bức ảnh meme để xem khả năng sáng tạo và hài hước của chúng. Người dùng có thể tham gia bình chọn cho mô hình thực hiện ấn tượng nhất.

OpenRouter@OpenRouter
Mô hìnhĐiểm AI 24/100

OpenRouter ra mắt Memebench: Thử thách khả năng chế ảnh của 8 mô hình AI

Meet Memebench We gave 8 AI models the same meme and asked them to put @pingToven and @Audrey_Sage_…

DịchOpenRouter vừa giới thiệu Memebench, một bài kiểm tra thú vị yêu cầu 8 mô hình AI khác nhau cùng chỉnh sửa một bức ảnh meme. Người dùng có thể theo dõi và bình chọn xem mô hình nào tạo ra kết quả ấn tượng nhất.

OpenAI@OpenAI
Nghiên cứuĐiểm AI 53/100

Cùng sự kiệnOpenAI ra mắt MentalHealthBench: Chuẩn mực mới đánh giá AI trong tư vấn tâm lý

We're demonstrating how frontier models have continued to improve in realistic mental health convers…

DịchOpenAI công bố MentalHealthBench, bộ tiêu chuẩn đánh giá khả năng của các mô hình AI trong các cuộc hội thoại về sức khỏe tâm thần thực tế, được xây dựng với sự tham gia của hơn 80 chuyên gia lâm sàng.

Cùng sự kiện, tinh chọn hiển thị «OpenAI hợp tác cùng hơn 80 chuyên gia ra mắt MentalHealthBench: Chuẩn mực mới đánh giá AI trong tâm lý học»
Arena@arena
NgànhĐiểm AI 24/100

Arena mở đơn đăng ký Chương trình Hợp tác Học thuật mùa thu 2026

Reminder: the Fall 2026 cycle of Arena's Academic Partnerships Program has begun! We're accepting n…

DịchArena chính thức nhận đề xuất nghiên cứu từ các giảng viên đại học tại Mỹ về nền tảng khoa học của đánh giá AI, với mức tài trợ lên tới 50.000 USD mỗi dự án. Hạn chót nộp hồ sơ là ngày 30/10/2026.

Don't Worry About the Vase (Zvi)
Mô hìnhĐiểm AI 92/100

Cùng sự kiệnClaude Opus 5.5: Bản báo cáo hệ thống chi tiết

Khám phá Claude Opus 5.5, mô hình AI mạnh mẽ nhất thế giới hiện nay theo các bảng xếp hạng uy tín như Artificial Analysis và các tiêu chuẩn benchmark công nghiệp.

Cùng sự kiện, tinh chọn hiển thị «Claude Code cập nhật v2.1.280: Ra mắt Claude Opus 5.5 làm mô hình mặc định»
Arena@arena
Mô hìnhĐiểm AI 45/100

Tencent Hunyuan ra mắt WebCraftBench: Bộ tiêu chuẩn đánh giá AI qua các yêu cầu thực tế

Real-world app requests don't come as perfect specs. Congrats to the @TencentHunyuan team on WebCraf…

DịchWebCraftBench của Tencent Hunyuan sử dụng 369 yêu cầu thực tế từ người dùng để kiểm tra khả năng xây dựng ứng dụng của AI, với độ chính xác khớp với đánh giá của con người lên tới 85,3%.

Arena@arena
Mô hìnhĐiểm AI 44/100

Cùng sự kiệnSo sánh đối đầu Claude Opus 5.5 và GPT-6 Sol trên bảng xếp hạng Arena

Check out side-by-side outputs generated on Arena from Claude Opus 5.5 by @AnthropicAI and GPT-6 Sol…

DịchKhám phá kết quả so sánh trực tiếp giữa Claude Opus 5.5 và GPT-6 Sol trên nền tảng Arena. Điểm số chính thức của Claude Opus 5.5 sắp được công bố dựa trên đánh giá thực tế từ cộng đồng người dùng toàn cầu.

Cùng sự kiện, tinh chọn hiển thị «Anthropic giải mã lý do Claude Opus 5.5 là lựa chọn tối ưu cho lập trình với ngữ cảnh dài»
OpenAI: Tin chính thức (RSS - lọc nội dung doanh nghiệp/khách hàng)
Nghiên cứuĐiểm AI 62/100

Tinh chọnOpenAI hợp tác cùng hơn 80 chuyên gia ra mắt MentalHealthBench: Chuẩn mực mới đánh giá AI trong tâm lý học

OpenAI công bố MentalHealthBench, bộ tiêu chuẩn đánh giá khả năng hỗ trợ tâm lý của AI, được xây dựng bởi hơn 80 chuyên gia từ 22 quốc gia và hỗ trợ 19 ngôn ngữ.

Thêm 3 nguồn khác đưa tinIT HomeX: Rohan Paul (@rohanpaul_ai)X: OpenAI (@OpenAI)

Vì sao đáng đọc: Bài viết cung cấp phương pháp xây dựng tiêu chuẩn, thiết kế trọng số chấm điểm và cách thức phát hành mở, giúp các nhà nghiên cứu tái hiện hoặc mở rộng việc đánh giá mô hình trong lĩnh vực sức khỏe tâm thần.

23/09

Thứ Tư · 15 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

JEV-as-a-Judge: Chiến lược đánh giá AI tiết kiệm chi phí bằng cách phân tầng độ tin cậy

JEV-as-a-Judge sử dụng mô hình đánh giá chi phí thấp để sàng lọc sơ bộ, kết hợp cơ chế leo thang khi độ tin cậy thấp, giúp duy trì 99% độ chính xác của các mô hình SOTA với chi phí chỉ bằng 0,36%.

Thêm 1 nguồn khác đưa tinX: Elvis Saravia (@omarsar0, DAIR.AI)
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 35/100

RoboFollow: Vạch trần 'ảo ảnh' tuân thủ chỉ dẫn của các tác nhân AI hiện thân

RoboFollow là bộ tiêu chuẩn chẩn đoán mới chỉ ra rằng tỷ lệ thành công cao của các tác nhân AI hiện thân thường chỉ là ảo ảnh do 'độ hỗn loạn cảnh thấp'. Nghiên cứu này tách biệt khả năng hiểu ngôn ngữ và thực thi hành động thông qua hệ thống phân cấp L0-L3.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

Taste-Bench: Đo lường và nâng cao 'gu' thẩm mỹ trong tư duy của AI Agent

Nghiên cứu giới thiệu Taste-Bench, bộ tiêu chuẩn đánh giá khả năng đưa ra quyết định tối ưu của AI Agent trong các tác vụ dài hạn. Kết quả cho thấy ngay cả các mô hình mạnh nhất cũng gặp khó khăn khi đối mặt với các tình huống đòi hỏi sự tinh tế trong lựa chọn.

Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 38/100

Cùng sự kiệnNghiên cứu Jev bằng Doubao: Từ đánh giá mô hình đến ra quyết định phần mềm

Tác giả sử dụng các chế độ lập kế hoạch và tác vụ của Doubao để phân tích Jev - công cụ từ TypeSafe hứa hẹn hiệu suất vượt trội. Kết quả thử nghiệm độc lập cho thấy độ trễ cực thấp và những thay đổi đáng chú ý về độ chính xác khi áp dụng các bộ lọc.

Cùng sự kiện, bài đại diện «Hướng dẫn sử dụng Jev: Kiểm duyệt nội dung với mô hình ra quyết định của TypeSafe trên OpenRouter»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

RULER: Phương pháp đánh giá và tối ưu hóa mới cho việc tạo hình ảnh vector (SVG) bằng AI

RULER giải quyết vấn đề thiếu tiêu chuẩn đánh giá trong tạo mã SVG bằng cách sử dụng hệ thống chấm điểm đa tiêu chí dựa trên mô hình ngôn ngữ thị giác, giúp tối ưu hóa mô hình học tăng cường hiệu quả hơn so với các chỉ số truyền thống.

METR: Blog (Web)
Hướng dẫnĐiểm AI 62/100

Đã có đại diệnMETR công bố báo cáo đánh giá tiền triển khai cho Claude Opus 5.5

METR vừa công bố kết quả đánh giá Claude Opus 5.5 sau 10 ngày thử nghiệm API qua 5 tác vụ chuyên biệt, bao gồm khả năng lập trình, chơi game và tối ưu hóa tốc độ.

Cùng sự kiện, tinh chọn hiển thị «Claude Code cập nhật v2.1.280: Ra mắt Claude Opus 5.5 làm mô hình mặc định»
Artificial Analysis@ArtificialAnlys
Hướng dẫnĐiểm AI 70/100

Đã có đại diệnArtificial Analysis: GPT-6 Sol và Luna duy trì hiệu năng tương đương nhưng giảm 50% chi phí

GPT-6 Sol and Luna continue to push the cost efficiency frontier for OpenAI. The two new models halv…

DịchCác mô hình GPT-6 Sol và Luna đạt chỉ số thông minh tương đương thế hệ trước nhưng có mức giá token rẻ hơn một nửa, giúp tối ưu hóa đáng kể chi phí vận hành cho người dùng.

Cùng sự kiện, tinh chọn hiển thị «OpenAI ra mắt bộ đôi GPT-6 Sol và Luna, giảm 50% giá API so với bản tiền nhiệm»
Every: Bài mới (Web)
Quan điểmĐiểm AI 16/100

Cùng sự kiệnVibe Check: So sánh thực tế giữa GPT-6 Sol và Opus 5.5

Bản tin Vibe Check từ Every phân tích sự khác biệt giữa GPT-6 Sol và Opus 5.5, cho thấy mỗi mô hình đều có ưu thế riêng biệt tùy theo nhu cầu sử dụng, dù các thông số kỹ thuật chi tiết chưa được công bố.

Cùng sự kiện, tinh chọn hiển thị «Sam Altman: GPT-6 Sol và Luna không có đối thủ về hiệu suất chi phí theo tác vụ»
Artificial Analysis@ArtificialAnlys
Sản phẩmĐiểm AI 51/100

Artificial Analysis ra mắt bảng xếp hạng Text-to-Speech đa ngôn ngữ, hỗ trợ tiếng Việt

Announcing Multilingual Text to Speech Arena Leaderboards, comparing leading TTS models across 9 lan…

DịchArtificial Analysis vừa mở rộng nền tảng Controlled Voice Arena, bổ sung bảng xếp hạng cho 9 ngôn ngữ bao gồm tiếng Việt, giúp đánh giá chất lượng các mô hình chuyển đổi văn bản thành giọng nói (TTS) một cách khách quan.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (55 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Đánh giá AI” | AIHOT.vn