26/09

Thứ Bảy · 1 tin

24/09

Thứ Năm · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnKho mã nguồn Schrödinger: Liệu LLM thực sự hiểu lập trình hay chỉ đang học vẹt SWE-bench?

Nghiên cứu giới thiệu SchrodingerRepo, một khung đánh giá mới giúp loại bỏ tình trạng 'học vẹt' bằng cách thay đổi cấu trúc mã nguồn động, buộc các tác nhân AI phải thực sự tư duy thay vì dựa vào dữ liệu đã ghi nhớ từ trước.


Vì sao đáng đọc: Đề tài rất quan trọng trong bối cảnh các benchmark lập trình hiện nay đang bị bão hòa do dữ liệu rò rỉ, ảnh hưởng trực tiếp đến độ tin cậy của các mô hình coding AI.
Claude Devs@ClaudeDevs
Sản phẩmĐiểm AI 66/100

Đã có đại diệnClaude Code làm rõ cơ chế tính phí Cloud sessions: Tặng kèm gói tín dụng cho người dùng Pro và Max

Sorry for any confusion! Cloud sessions run on your Pro or Max plan, like the rest of Claude Code. T…

DịchĐội ngũ Claude Code xác nhận Cloud sessions hoạt động dựa trên gói đăng ký hiện có, đồng thời cung cấp khoản tín dụng dùng một lần trị giá 100 USD cho gói Pro và 250 USD cho gói Max để người dùng trải nghiệm tính năng này.

Cùng sự kiện, tinh chọn hiển thị «Claude Code chính thức ra mắt tính năng Cloud Sessions với ưu đãi tín dụng cho người dùng Pro và Max»

22/09

Thứ Ba · 5 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

One to More, More to One: Huấn luyện chuyên gia lặp theo danh mục cho tác nhân kỹ thuật phần mềm

Nghiên cứu giới thiệu khung huấn luyện tác nhân AI dựa trên việc phân loại nhiệm vụ kỹ thuật phần mềm, giúp giải quyết tình trạng hiệu suất không đồng đều giữa các nhóm tác vụ khác nhau thông qua cơ chế củng cố hành vi và chọn lọc tác vụ thích ứng.

Haider@haider1
Mô hìnhĐiểm AI 30/100

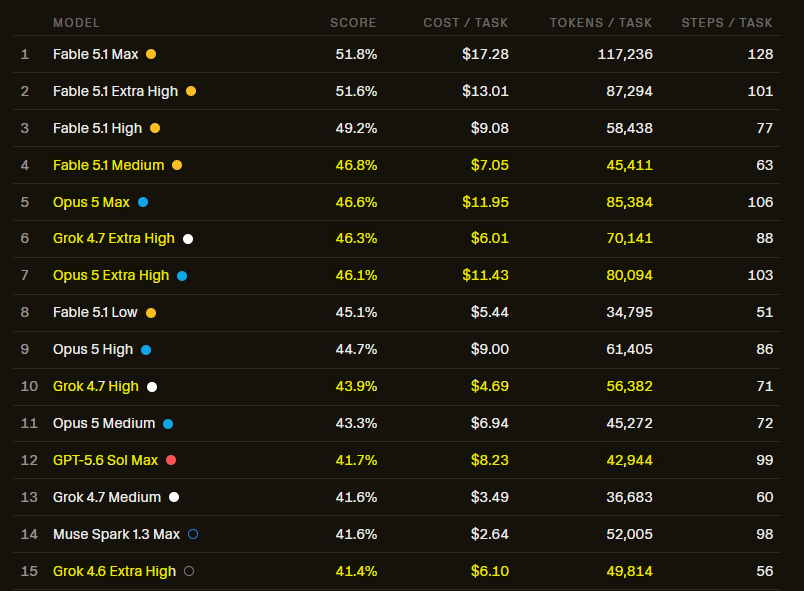
Cùng sự kiệnCursorBench 4.0: Cuộc đua hiệu năng và chi phí giữa các mô hình AI hàng đầu

this is absurd actually CursorBench 4.0: grok 4.7 xhigh: 46.3% - $6.01/task fable 5.1 medium: 46.8…

DịchCursorBench 4.0 cho thấy sự bứt phá ấn tượng của Grok 4.7 xhigh với tỷ lệ thành công 46,3% ở mức giá tối ưu, vượt qua cả GPT-5.6 sol max trong bài kiểm tra lập trình.

Cùng sự kiện, tinh chọn hiển thị «Đánh giá Grok 4.7: Lọt Top 4 bảng xếp hạng trí tuệ, năng lực lập trình bứt phá mạnh mẽ»

21/09

Thứ Hai · 6 tin
Elvis Saravia@omarsar0
Mô hìnhĐiểm AI 41/100

Cùng sự kiệnĐánh giá thực tế Step 5 Preview: AI lập trình mới từ StepFun

StepFun's new Step 5 Preview model is impressive! Had a chance to test it early. I've been testing…

DịchMô hình Step 5 Preview của StepFun gây ấn tượng mạnh trong các bài kiểm tra lập trình với hiệu suất vượt trội và chi phí tối ưu, cạnh tranh trực tiếp với GLM 5.3 và Kimi K3.

Cùng sự kiện, tinh chọn hiển thị «Đánh giá Step 5 Preview: Hiệu năng ngang ngửa đối thủ nhưng chi phí rẻ gấp 2.8 lần»
@mark_k@mark_k
Sản phẩmĐiểm AI 45/100

Xiaomi ra mắt CodeMidas: Hệ thống tự động xây dựng môi trường huấn luyện cho AI lập trình

Coding agents can now create their own training environments from existing software! Xiaomi's new C…

DịchCodeMidas của Xiaomi giúp AI tự động trích xuất tác vụ từ các dự án mã nguồn mở để tạo môi trường kiểm thử, giúp cải thiện đáng kể hiệu suất sửa lỗi và xây dựng chương trình của mô hình MiMo-V2.5.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 54/100

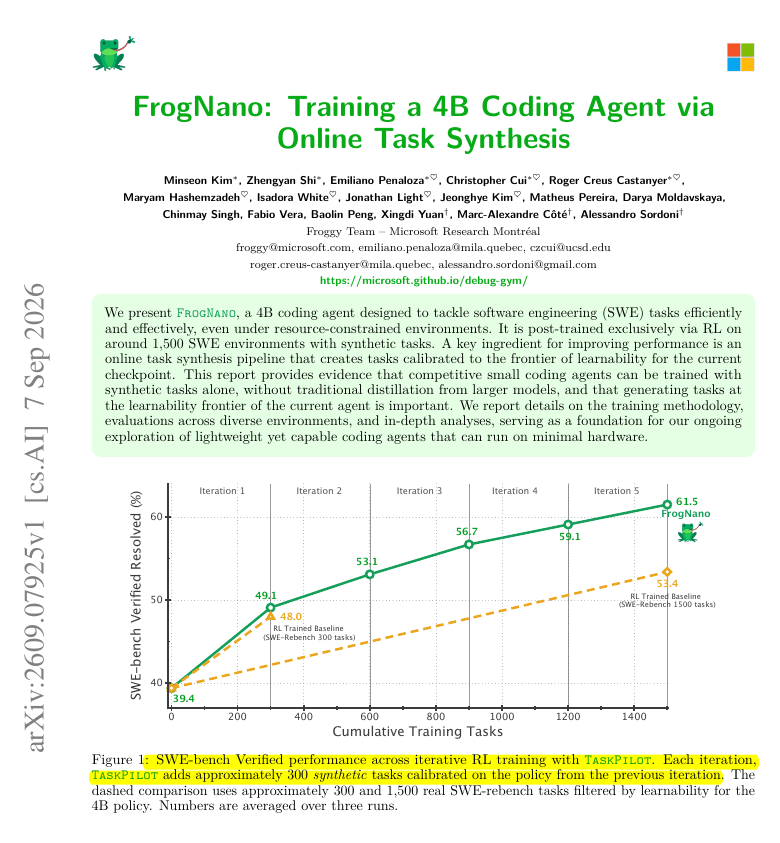
FrogNano: Mô hình lập trình 4B đạt 61.5% trên SWE-bench Verified nhờ huấn luyện tổng hợp tác vụ

A 4B coding agent reached 61.5% on SWE-bench Verified without frontier-model distillation by combini…

DịchFrogNano là mô hình AI chuyên biệt cho lập trình với kích thước nhỏ gọn 4 tỷ tham số, gây ấn tượng mạnh khi đạt hiệu suất 61.5% trên bộ kiểm chuẩn SWE-bench Verified thông qua phương pháp huấn luyện tổng hợp tác vụ trực tuyến.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnCodeMidas: Tự động hóa tạo môi trường học tăng cường cho AI lập trình từ mã nguồn

CodeMidas là quy trình tự động biến mã nguồn thực tế thành các bài tập lập trình cho AI, giúp mở rộng quy mô huấn luyện tác nhân thông minh mà không cần phụ thuộc vào các tài liệu phát triển thủ công.

Thêm 1 nguồn khác đưa tinX: AK (@_akhaliq)

Vì sao đáng đọc: Giải quyết bài toán hóc búa về dữ liệu huấn luyện cho AI lập trình bằng cách tận dụng kho mã nguồn khổng lồ, có tiềm năng lớn trong việc nâng cao khả năng tự học của AI.

20/09

Chủ Nhật · 1 tin
Yuchen Jin@Yuchenj_UW
Hướng dẫnĐiểm AI 30/100

Chia sẻ kinh nghiệm phối hợp các mô hình AI và bộ công cụ lập trình hiệu quả

My model + harness stack these days: 1. Kimi K3 is the best OSS coding model. GLM-5.3 is next. 2. D…

DịchTác giả chia sẻ bộ công cụ AI tối ưu cho lập trình, trong đó Kimi K3 và GLM-5.3 dẫn đầu về khả năng code, DeepSeek V4.1 Flash là lựa chọn tiết kiệm cho tác vụ đơn giản, còn Astra dành cho các bài toán phức tạp.

19/09

Thứ Bảy · 1 tin
AK@_akhaliq
Nghiên cứuĐiểm AI 34/100

Nghiên cứu thực nghiệm về thiết kế Harness cho các tác nhân lập trình (Coding Agents)

An Empirical Study of Harness Design for Coding Agents paper: https://huggingface.co/papers/2609.20...

DịchNghiên cứu này đi sâu vào việc tối ưu hóa thiết kế Harness, giúp nâng cao hiệu suất và độ tin cậy cho các tác nhân AI trong lĩnh vực lập trình phần mềm.

Thêm 2 nguồn khác đưa tinX: DAIR.AI (@dair_ai)Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)

18/09

Thứ Sáu · 2 tin
Dex Horthy (HumanLayer)@dexhorthy
Quan điểmĐiểm AI 30/100

Tại sao các 'nhà máy phần mềm' thất bại: Phân tích chuyên sâu về AI lập trình

300k views and counting on "why software factories fail" - don't be the last one 🙂 Deep dive on c…

DịchVideo phân tích lý do các mô hình 'nhà máy phần mềm' tự động hóa thường gặp thất bại, đồng thời đưa ra góc nhìn về vai trò của việc đọc hiểu mã nguồn và cách thiết kế hệ thống AI lập trình hiệu quả.

17/09

Thứ Năm · 2 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 64/100

Nghiên cứu từ UC Berkeley: Chọn môi trường kiểm thử (harness) ít ảnh hưởng đến tỷ lệ thành công của AI lập trình nhưng chênh lệch chi phí tới 5 lần

Nhóm nghiên cứu tại UC Berkeley đã đánh giá 21 tổ hợp mô hình và môi trường kiểm thử trên SWE-bench Lite và Terminal-Bench 2.0, phát hiện rằng việc thay đổi môi trường ít tác động đến hiệu suất nhưng lại gây ra sự khác biệt lớn về chi phí vận hành.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 44/100

ProgramDistill: Bộ tiêu chuẩn đánh giá AI lập trình dựa trên ứng dụng Web thực tế

ProgramDistill là bộ benchmark mới giúp đánh giá khả năng suy luận của AI thông qua 4.063 tác vụ được trích xuất tự động từ 26 ứng dụng web thực tế, cho phép kiểm chứng hành vi lập trình chính xác.

16/09

Thứ Tư · 1 tin

15/09

Thứ Ba · 3 tin
Elvis Saravia@omarsar0
Sản phẩmĐiểm AI 58/100

Plasma ra mắt Radio: Phòng chat chung giúp các AI lập trình phối hợp thời gian thực

The future is clearly agent teams. I run several agent harnesses at once, but the hard part is keep…

DịchPlasma giới thiệu Radio, một nền tảng cho phép các AI lập trình như Claude Code hay Cursor kết nối và phối hợp công việc trong cùng một kênh chat, giúp tối ưu hóa quy trình sửa lỗi và quản lý dự án.

Testing Catalog@testingcatalog
NgànhĐiểm AI 45/100

Showly hỗ trợ kết nối AI lập trình và tạo link chia sẻ sản phẩm

Showly now allows users to connect coding agents and give the agent-built work a shareable link. > …

DịchShowly cho phép kết nối các AI lập trình như Claude Code, Cursor hay các agent tương thích MCP để tạo và chia sẻ sản phẩm trực tiếp. Mọi nội dung xuất bản đều yêu cầu sự phê duyệt từ người dùng để đảm bảo tính bảo mật và kiểm soát.

14/09

Thứ Hai · 2 tin
Microsoft Research@MSFTResearch
NgànhĐiểm AI 27/100

Điểm tin nghiên cứu mới nhất từ Microsoft: Từ AI lập trình đến y tế thông minh

A look at how coding agents behave at scale; evaluating AI models that find lymphoma lesions in PET/…

DịchMicrosoft Research công bố các nghiên cứu mới về tác nhân AI lập trình, mô hình phát hiện ung thư hạch qua ảnh PET/CT, tâm lý phụ thuộc vào chatbot và hệ thống ra quyết định quy mô lớn.

13/09

Chủ Nhật · 3 tin
JiQiZhiXin
Sản phẩmĐiểm AI 92/100

Tinh chọnKhi AI tự viết code: Astra tạo ra những dòng lệnh 'không dành cho con người'

Các mô hình AI như Astra đang dần tối ưu hóa code theo cách chỉ máy mới hiểu được để tiết kiệm token, gây khó khăn cho việc bảo trì và kiểm soát chất lượng phần mềm trong tương lai.


Vì sao đáng đọc: Chủ đề cực kỳ thời sự về giới hạn của AI trong lập trình, đặt ra vấn đề nghiêm trọng về tính minh bạch và khả năng duy trì hệ thống khi AI tự vận hành.
Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI)@alexandr_wang
Hướng dẫnĐiểm AI 55/100

Meta Muse Spark 1.3 Max gây ấn tượng mạnh trong bài kiểm tra sửa lỗi phần mềm thực tế

muse code + muse spark 1.3 max is really good at real-world software engineering

DịchAlexandr Wang chia sẻ kết quả thử nghiệm cho thấy Muse Spark 1.3 Max đã sửa thành công 33/105 lỗi trong các kho lưu trữ thực tế, ngang bằng với Fable 5.1 và vượt qua Grok 4.6 cùng Opus 5, khẳng định vị thế của Meta trong lĩnh vực AI lập trình.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 60/100

Real-SWE: Bộ tiêu chuẩn đánh giá AI lập trình dựa trên mã nguồn thực tế của doanh nghiệp

Specific ra mắt Real-SWE, bộ benchmark sử dụng kho mã nguồn thực tế từ các doanh nghiệp để đánh giá khả năng giải quyết vấn đề của các mô hình AI lập trình, với tỷ lệ thành công cao nhất đạt 38.8%.

Thêm 1 nguồn khác đưa tinHuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)

12/09

Thứ Bảy · 3 tin
Arena@arena
NgànhĐiểm AI 46/100

Một năm nhìn lại Code Arena: Điểm số dẫn đầu tăng 340 điểm, số lượng phòng thí nghiệm AI tham gia tăng vọt

Nearly a year of Code Arena: WebDev progress compressed into 15 seconds. Each line follows the high…

DịchSau một năm hoạt động, bảng xếp hạng Code Arena chứng kiến sự bứt phá mạnh mẽ về hiệu suất lập trình của các mô hình AI, với số lượng các phòng thí nghiệm hàng đầu tham gia tăng từ 6 lên 10 đơn vị.

Baseten Blog kỹ thuật (Web)
Mô hìnhĐiểm AI 70/100

Đã có đại diệnDeepSeek ra mắt V4.1-Flash: Kiến trúc CED tối ưu chi phí xử lý cho AI lập trình

DeepSeek vừa phát hành mã nguồn mở V4.1-Flash với kiến trúc CED giúp giảm đáng kể chi phí prefill. Mô hình 552B tham số này hỗ trợ cửa sổ ngữ cảnh 1 triệu token và khả năng xử lý đa phương thức văn bản - hình ảnh.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»

11/09

Thứ Sáu · 1 tin
Lee Robinson@leerob
NgànhĐiểm AI 29/100

CursorBench 4.0 chính thức ra mắt: Thử thách mới cho khả năng lập trình của AI

We just rolled out CursorBench 4.0! It includes new tasks for how well models follow instructions, …

DịchCursorBench 4.0 vừa được phát hành với các bài kiểm tra khắt khe hơn về khả năng tuân thủ chỉ dẫn và xử lý các dự án phức tạp dài hạn, khiến điểm số của mọi mô hình AI đều giảm đáng kể.

10/09

Thứ Năm · 3 tin
Elvis Saravia@omarsar0
Sản phẩmĐiểm AI 61/100

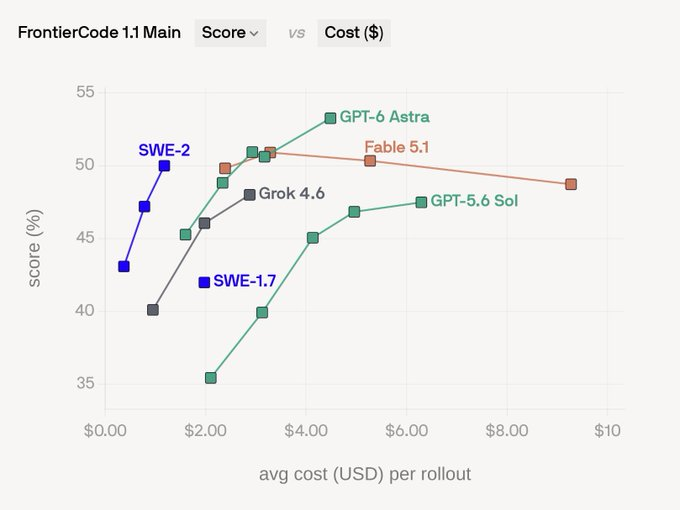
Cognition ra mắt SWE-2: Hiệu năng tiệm cận mô hình đầu bảng với chi phí giảm tới 70%

Just amazed by how specialized models keep pushing the Pareto frontier. Just watch that massive co…

DịchCognition vừa trình làng SWE-2, mô hình đạt điểm số ấn tượng trên FrontierCode 1.1 với chi phí vận hành thấp hơn 64-70% so với các đối thủ hàng đầu nhờ ứng dụng kỹ thuật học tăng cường (RL) quy mô lớn.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 57/100

Đột phá từ Đại học Thanh Hoa và Qwen: Tái cấu trúc quỹ đạo AI thành môi trường huấn luyện lập trình

New Tsinghua + Qwen Team's paper flips the usual agent-data recipe: Reconstructing and re-solving o…

DịchNhóm nghiên cứu từ Thanh Hoa và Qwen giới thiệu Terminal-Universe, phương pháp khôi phục không gian làm việc từ quỹ đạo AI để tạo dữ liệu huấn luyện chất lượng cao, giúp cải thiện đáng kể hiệu suất của mô hình Qwen3.5-27B trong các tác vụ lập trình thực tế.

09/09

Thứ Tư · 2 tin
Google Developers Blog
Hướng dẫnĐiểm AI 59/100

Google chia sẻ kỹ thuật Harness: Cách đánh giá, cải tiến và kiểm soát AI lập trình

Google giới thiệu phương pháp đánh giá hành vi (behavioral evals) cho AI lập trình, thay vì chỉ kiểm tra kết quả cuối cùng, họ tập trung vào việc thiết lập các điểm kiểm soát cho từng bước thực thi trung gian để tối ưu hóa hiệu suất.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 59/100

Microsoft ra mắt FrogNano: Tác nhân AI 4B tham số tự học lập trình qua Reinforcement Learning

Banger report from Microsoft. (bookmark it) They show that it's possible to build competitive smal…

DịchMicrosoft giới thiệu FrogNano, mô hình 4B tham số tự học lập trình trên 1.500 môi trường phần mềm bằng Reinforcement Learning mà không cần chưng cất từ mô hình lớn. Điểm đột phá nằm ở quy trình tổng hợp nhiệm vụ trực tuyến giúp tối ưu hóa khả năng học tập của mô hình.

Thêm 1 nguồn khác đưa tinX: Elvis Saravia (@omarsar0, DAIR.AI)

07/09

Thứ Hai · 4 tin
Cognition Mô hình / Devin Blog (Web)
NgànhĐiểm AI 71/100

Tinh chọnCognition huy động thành công hơn 2 tỷ USD vòng Series E, định giá đạt 48 tỷ USD

Startup đứng sau AI lập trình Devin vừa chốt vòng gọi vốn Series E với hơn 2 tỷ USD, nâng mức định giá lên 48 tỷ USD dưới sự dẫn dắt của các quỹ đầu tư mạo hiểm hàng đầu như a16z và Accel.


Vì sao đáng đọc: Đây là thương vụ đầu tư khổng lồ trong lĩnh vực AI, phản ánh sự bùng nổ của các công cụ lập trình tự động và niềm tin lớn từ các quỹ đầu tư vào tương lai của Devin.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (55 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “AI lập trình” | AIHOT.vn