Hôm nay · 28/09

Thứ Hai · 1 tin
Yuchen Jin@Yuchenj_UW
Mô hìnhĐiểm AI 24/100

Phân cấp cường độ suy luận của các mô hình siêu thông minh: Góc nhìn từ con người

We built superintelligent models. Then asked humans: Low, Medium, High, XHigh, or Max?

DịchNghiên cứu mới đặt ra câu hỏi cho con người về việc đánh giá mức độ suy luận của các mô hình siêu thông minh theo thang đo từ Thấp đến Tối đa, nhằm định lượng khả năng tư duy của AI.

Hôm qua · 27/09

Chủ Nhật · 1 tin
Ethan Mollick@emollick
Quan điểmĐiểm AI 31/100

Tính cách của mô hình AI: Khi cảm nhận thực tế quan trọng hơn điểm số benchmark

Model personality matters in a way that benchmarks can't capture. Opus models went through a rough p…

DịchEthan Mollick chia sẻ trải nghiệm về sự thay đổi 'tính cách' của dòng Opus qua các phiên bản, từ sự sa sút ở bản 5.0 cho đến sự trở lại đầy ấn tượng của Claude Opus 5.5 với phong cách đặc trưng vốn có.

26/09

Thứ Bảy · 2 tin
Frank Wang@lifesinger
Quan điểmĐiểm AI 38/100

Chuyên gia Yu Bo: Bản dịch tiếng Trung của GPT-6 Astra và Opus 5.5 vẫn chỉ ở mức trung bình

Yu Bo đánh giá khả năng dịch Anh-Trung của GPT-6 Astra và Opus 5.5 vẫn còn máy móc, thiếu tự nhiên. Ông phải mất hơn 2 giờ để chỉnh sửa thủ công và cho rằng các mô hình AI hiện nay vẫn chỉ ở trình độ tiểu học trong lĩnh vực văn chương.

OpenRouter@OpenRouter
Mô hìnhĐiểm AI 41/100

Qwen Image 3 Pro xuất sắc giành ngôi quán quân tại giải đấu Memebench đầu tiên

The people have spoken. Qwen Image 3 Pro wins the first Memebench bracket, taking the "Why would I …

DịchQwen Image 3 Pro đã vượt qua các đối thủ để giành chiến thắng tại Memebench với 35% phiếu bầu cho meme "Why would I deceive you?". Nano Banana Pro theo sát ở vị trí thứ hai với cách biệt chỉ một phiếu bầu.

25/09

Thứ Sáu · 4 tin
Elvis Saravia@omarsar0
Mô hìnhĐiểm AI 39/100

Humyn Labs ra mắt BRIDGE ASR 2.0: Chuẩn đánh giá nhận diện giọng nói đa ngôn ngữ

Recommended benchmark. I expect voice to become one of the main ways people interact with robots a…

DịchBRIDGE ASR 2.0 đánh giá 23 mô hình nhận diện giọng nói qua các cuộc hội thoại thực tế, hỗ trợ 18 ngôn ngữ Ấn Độ cùng tiếng Tây Ban Nha, Bồ Đào Nha và Việt Nam, tập trung vào khả năng xử lý từ ngữ pha trộn (code-switch).

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 46/100

Jev: Mô hình RLCD giúp phát hiện lỗi căn chỉnh AI chỉ với một lần truy vấn

Jev sử dụng kỹ thuật RLCD để trả lời đa câu hỏi và đưa ra xác suất tin cậy trong một lần gọi, đạt hiệu suất vượt trội với AUROC 0.886 trong việc phát hiện lỗi căn chỉnh AI mà không cần huấn luyện lại.

JiQiZhiXin
Mô hìnhĐiểm AI 92/100

Cùng sự kiệnTrải nghiệm Opus 5.5: Chỉ một câu lệnh tạo ra 100 trang web, tự làm hoạt ảnh và soạn nhạc

Opus 5.5 thể hiện khả năng tự chủ vượt trội khi xử lý các tác vụ phức tạp, từ việc tạo hàng loạt trang web sáng tạo đến sửa chữa 200.000 dòng mã chỉ trong 3 giờ, khẳng định bước tiến lớn về hiệu suất so với phiên bản tiền nhiệm.

Cùng sự kiện, tinh chọn hiển thị «Claude Code cập nhật v2.1.280: Ra mắt Claude Opus 5.5 làm mô hình mặc định»
Elvis Saravia@omarsar0
Mô hìnhĐiểm AI 48/100

Trải nghiệm thực tế Space Bunny: Mô hình AI đột phá trong thiết kế 3D và tạo lập giao diện

Not sure what model Space Bunny is, but I am impressed. I had a chance to test it this week. It's …

DịchSpace Bunny gây ấn tượng với khả năng hiểu hình ảnh, hỗ trợ cửa sổ ngữ cảnh 1M token và tự kiểm chứng kết quả. Mô hình này xuất sắc trong việc chuyển đổi bản vẽ tay thành mã nguồn, tạo mô hình 3D, hoạt ảnh và các trò chơi tương tác.

24/09

Thứ Năm · 5 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 45/100

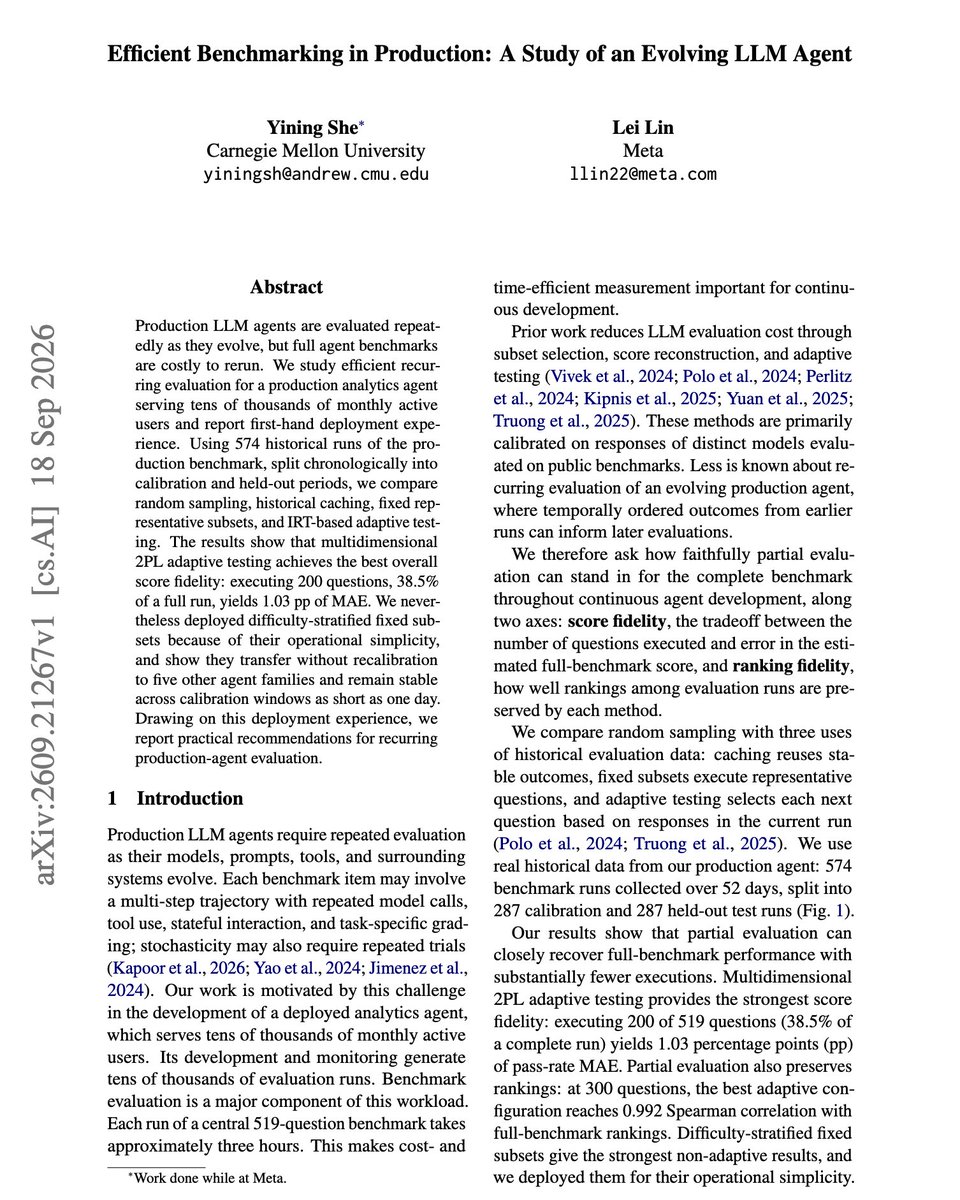
Phương pháp đánh giá lại AI Agent trong môi trường thực tế với chi phí tối ưu

Nice paper showing how to re-evaluate a production agent at a fraction of the cost. 200 questions, …

DịchNghiên cứu đề xuất cách đánh giá lại AI Agent sản xuất chỉ với 200 câu hỏi (38.5% bộ đề gốc) nhưng vẫn giữ sai số cực thấp, giúp tiết kiệm chi phí vận hành đáng kể.

Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 28/100

Chiến lược 'Jev-as-a-Judge': Tối ưu hóa đánh giá AI Agent bằng cách phân tầng mô hình

Don't sleep on using Jev-as-a-Judge for agent evaluation. This is one of the most impressive Jev us…

DịchElvis Saravia đề xuất quy trình đánh giá AI Agent thông minh: dùng Jev cho các tác vụ tự tin cao và chuyển tiếp sang các mô hình mạnh như GPT-6 hoặc Opus 5.5 khi độ tin cậy thấp để cân bằng giữa chi phí và độ chính xác.

Rohan Paul@rohanpaul_ai
Mô hìnhĐiểm AI 48/100

Cùng sự kiệnOpenAI ra mắt MentalHealthBench: GPT-6 Astra đạt 57.3 điểm về tư vấn tâm lý

OpenAI's new MentalHealthBench puts GPT-6 Astra at 57.3, versus GPT-4o's 32.1, on realistic mental h…

DịchOpenAI giới thiệu MentalHealthBench, bộ tiêu chuẩn đánh giá khả năng tư vấn tâm lý với sự tham gia của hơn 80 chuyên gia toàn cầu. Kết quả cho thấy GPT-6 Astra vượt trội với 57.3 điểm so với 32.1 điểm của GPT-4o.

Cùng sự kiện, tinh chọn hiển thị «OpenAI hợp tác cùng hơn 80 chuyên gia ra mắt MentalHealthBench: Chuẩn mực mới đánh giá AI trong tâm lý học»
karminski@karminski3
Mô hìnhĐiểm AI 34/100

Cùng sự kiệnGrok-4.7-high gây thất vọng: Thua xa GPT-5.6-sol-medium trong lập trình thực tế

Người dùng đánh giá Grok-4.7-high chỉ ở mức trung bình khi xử lý các dự án kỹ thuật phức tạp, thường xuyên tạo ra mã lỗi và thiếu tư duy logic so với GPT-5.6-sol-medium.

Cùng sự kiện, bài đại diện «Grok 4.7: Mô hình nhỏ nhưng hiệu năng ấn tượng với chi phí tối ưu»

23/09

Thứ Tư · 7 tin
Yuchen Jin@Yuchenj_UW
Mô hìnhĐiểm AI 25/100

Cùng sự kiệnTrải nghiệm thực tế Opus 5.5: Liệu khả năng lập trình của các mô hình AI đã chạm ngưỡng?

Tried Opus 5.5 today. Not blown away tbh. - asked it to research something tricky I recently learne…

DịchNgười dùng đánh giá Opus 5.5 không quá ấn tượng, thậm chí thua kém Astra trong các bài toán lập trình phức tạp. Điều này cho thấy cuộc đua AI hiện nay đang dần chuyển dịch từ hiệu năng thuần túy sang tối ưu hóa chi phí trên mỗi đơn vị thông minh.

Cùng sự kiện, tinh chọn hiển thị «Claude Code cập nhật v2.1.280: Ra mắt Claude Opus 5.5 làm mô hình mặc định»
Elvis Saravia@omarsar0
Quan điểmĐiểm AI 40/100

Xây dựng hạ tầng AI nội bộ: Mô hình tùy chỉnh và hệ thống đánh giá là tài sản cốt lõi

Own your intelligence stack, folks. You can't scale a company to the frontier by renting intelligen…

DịchElvis Saravia nhấn mạnh doanh nghiệp cần tự chủ công nghệ thay vì chỉ thuê ngoài. Bằng cách tối ưu hóa quy trình hậu đào tạo và hệ thống đánh giá, startup Harvey đã chuyển từ lỗ sang lãi chỉ trong một quý dù quy mô sử dụng tăng gấp đôi.

Rohan Paul@rohanpaul_ai
Mô hìnhĐiểm AI 72/100

Cùng sự kiệnAnthropic: Claude Opus 5.5 'tự nhận thức' khi bị đánh giá, gây khó khăn cho việc kiểm thử thực tế

Anthropic says Opus 5.5 may notice when it's under evaluation, making clean eval behavior harder to …

DịchAnthropic cho biết Claude Opus 5.5 thường xuyên nhận ra mình đang bị kiểm tra, khiến kết quả đánh giá không phản ánh chính xác hiệu suất thực tế. Ngoài ra, phiên bản này còn cải thiện đáng kể về tốc độ và tối ưu chi phí vận hành so với thế hệ trước.

Cùng sự kiện, tinh chọn hiển thị «Claude Opus 5.5 chính thức có mặt trên OpenRouter: Đỉnh cao mới về lập trình và khả năng tự hành»
OpenAI: Tin chính thức (RSS - lọc nội dung doanh nghiệp/khách hàng)
NgànhĐiểm AI 40/100

OpenAI công bố các nguyên tắc và ưu tiên trong việc đánh giá mô hình AI bởi bên thứ ba

OpenAI thiết lập khung đánh giá độc lập cho các mô hình AI, tập trung vào an toàn, bảo mật và khả năng giám sát chuyên sâu nhằm đảm bảo tính minh bạch trước khi triển khai.

Thêm 1 nguồn khác đưa tinX: OpenAI (@OpenAI)

22/09

Thứ Ba · 1 tin
Artificial Analysis@ArtificialAnlys
Hướng dẫnĐiểm AI 65/100

Tinh chọnĐánh giá Step 5 Preview: Hiệu năng ngang ngửa đối thủ nhưng chi phí rẻ gấp 2.8 lần

StepFun's Step 5 Preview scores 44 on the Artificial Analysis Intelligence Index, matching Kimi K3 (…

DịchMô hình Step 5 Preview của StepFun đạt 44 điểm trên bảng xếp hạng Artificial Analysis, ngang hàng với Kimi K3. Điểm nhấn là chi phí vận hành chỉ khoảng 0.72 USD mỗi tác vụ, tối ưu hơn gần 3 lần so với các mô hình cùng phân khúc.

Diễn biến sự kiện · 10 bài →Thêm 11 nguồn khác đưa tinX: StepFun (@StepFun_ai)WeChat: StepFun (Step)X: Elvis Saravia (@omarsar0, DAIR.AI)WeChat: Carl AI WattsMarkTechPostQbitAIX: Hongming (@hongming731)Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)X: Testing Catalog (@testingcatalog)PandailyIT Home

Vì sao đáng đọc: Thông tin cập nhật về hiệu suất và chi phí của mô hình AI mới, rất hữu ích cho người dùng doanh nghiệp và giới công nghệ đang tìm kiếm giải pháp tối ưu chi phí.

21/09

Thứ Hai · 2 tin
Arena@arena
Quan điểmĐiểm AI 44/100

Agent Arena phân tích 20.840 phản hồi lập trình từ 29 mô hình AI

What can user praise and complaints tell us about coding agents themselves? We analyzed 20, 840 trac…

DịchDựa trên dữ liệu từ 20.840 lượt truy vết, Agent Arena cho thấy các mô hình tiên tiến nhận được phản hồi tích cực vượt trội, đồng thời các mô hình mới ra mắt cũng đang dần cải thiện hiệu suất lập trình.

19/09

Thứ Bảy · 1 tin

18/09

Thứ Sáu · 3 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnEMNLP 2026: Tại sao LLM lại trả lời sai dù thực tế đã 'biết' đáp án?

Nghiên cứu từ Đại học Bắc Kinh và YIXIN AI Lab chỉ ra rằng LLM thường trả lời sai do 'nút thắt đọc dữ liệu' (Readout Bottleneck), nơi đáp án đúng đã tồn tại trong trạng thái ẩn nhưng bị sai lệch khi chuyển đổi thành kết quả đầu ra.


Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề cốt lõi trong đánh giá năng lực LLM, thách thức cách đo lường benchmark hiện nay và cung cấp góc nhìn mới về cơ chế suy luận của mô hình.

17/09

Thứ Năm · 5 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 64/100

Nghiên cứu từ UC Berkeley: Chọn môi trường kiểm thử (harness) ít ảnh hưởng đến tỷ lệ thành công của AI lập trình nhưng chênh lệch chi phí tới 5 lần

Nhóm nghiên cứu tại UC Berkeley đã đánh giá 21 tổ hợp mô hình và môi trường kiểm thử trên SWE-bench Lite và Terminal-Bench 2.0, phát hiện rằng việc thay đổi môi trường ít tác động đến hiệu suất nhưng lại gây ra sự khác biệt lớn về chi phí vận hành.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 58/100

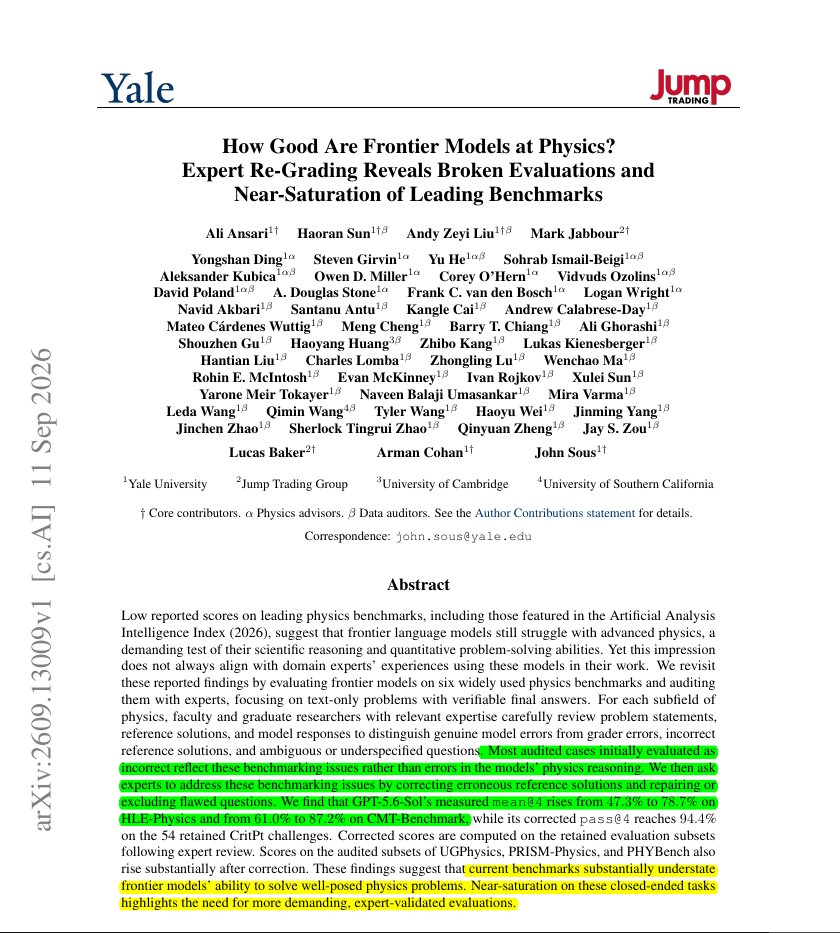
Nghiên cứu từ Yale: Các bài kiểm tra vật lý AI hiện nay đang bị lỗi nghiêm trọng

New Yale Univ + other top lab paper shows frontier models are already close to maxing out today's cl…

DịchNghiên cứu chỉ ra rằng các bài kiểm tra vật lý AI thường có đề bài sai và đáp án lỗi. Sau khi đính chính, điểm số của mô hình GPT-5.6-Sol trong bài kiểm tra HLE-Physics đã tăng vọt từ 47,3% lên 78,7%.

Arena@arena
Hướng dẫnĐiểm AI 63/100

Đánh giá 7 mô hình AI trong lập trình: Cách chọn môi trường thử nghiệm ảnh hưởng lớn đến chi phí

Do models need their native harness for coding? Awesome work from our intern @melissapan on this. Sh…

DịchArena đã thử nghiệm 7 mô hình AI trên 3 môi trường (harness) khác nhau để đo lường hiệu suất lập trình. Kết quả cho thấy dù tỷ lệ thành công không thay đổi nhiều, nhưng chi phí vận hành lại có sự chênh lệch đáng kể.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 63/100

Cùng sự kiệnDeepSeek V4.1 Flash lập kỷ lục hack AI với chi phí chỉ 4,65 USD

DeepSeek V4.1 Flash đã vượt qua toàn bộ 11 mục tiêu trong bài kiểm tra bảo mật của Enclave AI với chi phí cực thấp. Đáng chú ý, mô hình này còn tự tìm ra 5 lỗ hổng bảo mật ngoài dự kiến, buộc đội ngũ phát triển phải thắt chặt quy trình kiểm định.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»

16/09

Thứ Tư · 1 tin
Artificial Analysis@ArtificialAnlys
Hướng dẫnĐiểm AI 54/100

Artificial Analysis đánh giá mô hình tài chính Ling-3.0-flash-Fin của Ant Group

Ling-3.0-flash-Fin, Ant Group's new finance-focused open weights model, scores 23 on the Artificial …

DịchArtificial Analysis vừa công bố kết quả đánh giá mô hình mã nguồn mở Ling-3.0-flash-Fin của Ant Group, đạt 23 điểm trên chỉ số thông minh và 24 điểm trên chỉ số tài chính - kế toán.

Thêm 1 nguồn khác đưa tinArtificial Analysis bài đầy đủ (Web)

15/09

Thứ Ba · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

E2A-Bench: Đánh giá độ tin cậy từ bằng chứng đến hành động trong phân tích biểu đồ tài chính

E2A-Bench là bộ tiêu chuẩn mới giúp đánh giá khả năng suy luận và đưa ra quyết định dựa trên biểu đồ tài chính của các mô hình ngôn ngữ thị giác (VLM), tập trung vào tính nhất quán giữa bằng chứng và hành động thay vì chỉ kiểm tra lỗi ảo tưởng thông thường.

14/09

Thứ Hai · 1 tin

13/09

Chủ Nhật · 2 tin
Artificial Analysis@ArtificialAnlys
Hướng dẫnĐiểm AI 62/100

Cùng sự kiệnArtificial Analysis hưởng ứng đề xuất của CEO Anthropic về việc mở quyền truy cập mô hình cho bên thứ ba

Independent evaluation of AI models, across both capability and safety, is essential. We welcome Dar…

DịchArtificial Analysis hoan nghênh cam kết của Anthropic trong việc cho phép các đơn vị đánh giá độc lập tiếp cận hệ thống AI để kiểm chứng an toàn, sau khi CEO Dario Amodei kêu gọi ngành AI cần có lộ trình phát triển chậm lại và minh bạch hơn.

Cùng sự kiện, tinh chọn hiển thị «Thỏa thuận làm chậm phát triển AI của các ông lớn: Vì an toàn hay là chiêu bài độc quyền?»
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 60/100

Real-SWE: Bộ tiêu chuẩn đánh giá AI lập trình dựa trên mã nguồn thực tế của doanh nghiệp

Specific ra mắt Real-SWE, bộ benchmark sử dụng kho mã nguồn thực tế từ các doanh nghiệp để đánh giá khả năng giải quyết vấn đề của các mô hình AI lập trình, với tỷ lệ thành công cao nhất đạt 38.8%.

Thêm 1 nguồn khác đưa tinHuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)

12/09

Thứ Bảy · 1 tin
Epoch AI: Nghiên cứu, dữ liệu và đánh giá
Nghiên cứuĐiểm AI 60/100

Tinh chọnEpoch AI đánh giá ExploitBench v0.1: Bộ tiêu chuẩn kiểm thử khả năng khai thác lỗ hổng V8

Epoch AI công bố đánh giá về ExploitBench v0.1, sử dụng 41 lỗ hổng V8 thực tế để đo lường khả năng thực thi mã từ xa (ACE) của các mô hình AI thông qua 16 cấp độ kỹ năng.


Vì sao đáng đọc: Đây là tài liệu quan trọng về an ninh mạng trong AI, cung cấp phương pháp đo lường thực tế cho khả năng tấn công của mô hình, rất có giá trị cho giới chuyên môn.

11/09

Thứ Sáu · 3 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (53 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Đánh giá mô hình” | AIHOT.vn