Hôm nay · 28/09

Thứ Hai · 1 tin
Yuchen Jin@Yuchenj_UW
Mô hìnhĐiểm AI 24/100

Phân cấp cường độ suy luận của các mô hình siêu thông minh: Góc nhìn từ con người

We built superintelligent models. Then asked humans: Low, Medium, High, XHigh, or Max?

DịchNghiên cứu mới đặt ra câu hỏi cho con người về việc đánh giá mức độ suy luận của các mô hình siêu thông minh theo thang đo từ Thấp đến Tối đa, nhằm định lượng khả năng tư duy của AI.
26/09

Thứ Bảy · 1 tin
Thariq@trq212
Hướng dẫnĐiểm AI 40/100

Giải mã 'effort' trong suy luận AI: Tại sao không nên luôn dùng mức tối đa?

What is effort really? When do you change it it and why not just use max effort for everything? I d…

DịchBài viết phân tích sâu về cơ chế 'effort' trong các mô hình AI, giải đáp lý do tại sao việc luôn đặt mức tối đa không phải lúc nào cũng mang lại hiệu quả tối ưu thông qua các thử nghiệm thực tế.

25/09

Thứ Sáu · 1 tin

24/09

Thứ Năm · 7 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnGiải mã tư duy ẩn: Khai thác và phân tích chuỗi suy luận (CoT) trong các mô hình AI tiên tiến

Nghiên cứu này giới thiệu phương pháp trích xuất chuỗi suy luận ẩn từ các mô hình đóng như GPT-6 Astra, chứng minh rằng các bước suy luận này cải thiện đáng kể hiệu suất trong toán học, khoa học và lập trình.


Vì sao đáng đọc: Nghiên cứu mang tính đột phá khi tìm ra cách 'đọc' tư duy của các mô hình đóng, cung cấp cái nhìn sâu sắc về cách AI thực sự suy luận thay vì chỉ đưa ra kết quả.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 45/100

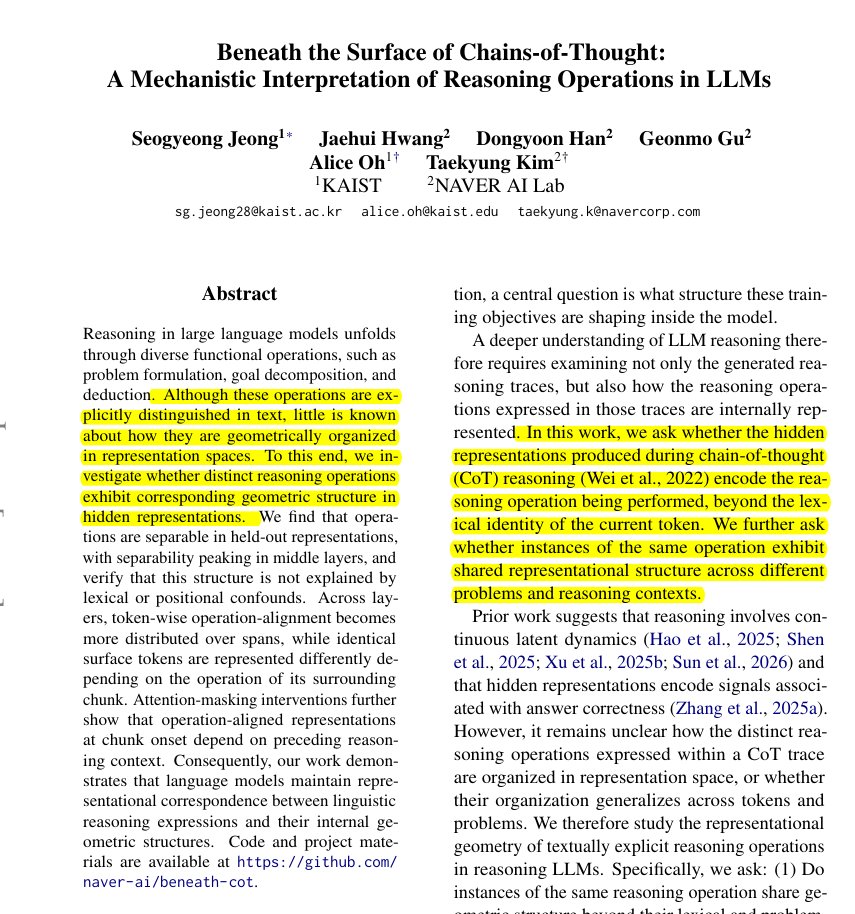
Nghiên cứu mới: LLM sở hữu cấu trúc tư duy nội tại tách biệt với văn bản đầu ra

The paper finds that LLM reasoning has an internal structure beyond the words being generated, openi…

DịchNghiên cứu chỉ ra rằng LLM vận hành các quy trình suy luận riêng biệt như tính toán hay suy diễn bên trong cấu trúc nội tại, ngay cả khi kết quả đầu ra bị sai. Điều này chứng minh mô hình có khả năng biểu diễn ý định tư duy độc lập với ngôn ngữ được tạo ra.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 57/100

DeepSeek thử nghiệm dùng GPU chơi game để chạy suy luận mô hình nhỏ nhằm giảm tải hạ tầng

DeepSeek is testing whether aggressive model optimization can push some share of inference for its s…

DịchDeepSeek đang thử nghiệm tối ưu hóa mô hình để có thể chạy suy luận trên các dòng GPU chơi game phổ thông, giúp giảm bớt áp lực thiếu hụt tài nguyên tính toán cao cấp.

@typesafeai@typesafeai
Mô hìnhĐiểm AI 27/100

JEV: Đột phá mới giúp LLM phản hồi suy luận tức thì

Stepping away while LLMs churn is the new "sorry, code's compiling". Jev makes instant feedback ju…

DịchJEV giới thiệu mô hình suy luận ngữ nghĩa mới, cho phép LLM đưa ra quyết định có cấu trúc ngay lập tức với mọi ngữ cảnh. Hiệu suất của JEV trong các tác vụ truy vấn phức tạp đã đạt ngưỡng tương đương với các mô hình Claude hàng đầu hiện nay.

Modal Blog kỹ thuật chính thức
Hướng dẫnĐiểm AI 61/100

Tinh chọnModal chia sẻ bí quyết vận hành Kimi K2.6: Tối ưu hóa suy luận cho Agent lập trình quy mô nghìn tỷ token

Modal tiết lộ kỹ thuật tối ưu hóa giúp tăng 2,8 lần hiệu suất mỗi người dùng và 5,6 lần thông lượng cho mô hình Kimi K2.6, cho phép xử lý hàng trăm tỷ token mỗi ngày.


Vì sao đáng đọc: Bài viết phân tích lộ trình tối ưu hóa suy luận cho Agent lập trình từ thực tiễn, giúp người đọc áp dụng các phương pháp xác định điểm nghẽn và định tuyến bộ nhớ đệm KV.

23/09

Thứ Tư · 4 tin
Microsoft Research Blog
Sản phẩmĐiểm AI 53/100

Microsoft ra mắt tính năng giảm tải suy luận cho robot, tối ưu hiệu suất và thời lượng pin

Microsoft Research tích hợp khả năng giảm tải suy luận vào Physical AI Toolchain, cho phép phân bổ khối lượng công việc AI của robot giữa thiết bị, biên và đám mây thông qua Kubernetes, giúp tăng hiệu suất vận hành thực tế.

Thêm 1 nguồn khác đưa tinX: Microsoft Research (@MSFTResearch)
Microsoft Research@MSFTResearch
Nghiên cứuĐiểm AI 26/100

Cùng sự kiệnNghiên cứu từ Microsoft: Đưa suy luận AI ra khỏi phần cứng robot để tối ưu hiệu suất

Robots are getting smarter, but how can their hardware match that growth? New Microsoft Research fin…

DịchNghiên cứu mới từ Microsoft cho thấy việc chuyển tác vụ suy luận AI ra khỏi thân máy robot giúp tăng tỷ lệ thành công, cải thiện hiệu suất và hỗ trợ các tác vụ AI vật lý phức tạp hơn.

Cùng sự kiện, bài đại diện «Microsoft ra mắt tính năng giảm tải suy luận cho robot, tối ưu hiệu suất và thời lượng pin»
vLLM Blog chính thức
Sản phẩmĐiểm AI 73/100

Tinh chọnvLLM ra mắt vllm-metal v0.28.0: Hỗ trợ phục vụ suy luận đồng thời trên Apple Silicon

vLLM chính thức phát hành vllm-metal v0.28.0, mang bộ lập lịch V1, paged KV cache và server tương thích OpenAI lên chip Apple Silicon thông qua MLX và Metal.


Vì sao đáng đọc: Lần đầu tiên chính thức phát hành vllm-metal, sử dụng packed varlen attention và paged KV để giải quyết vấn đề dịch vụ yêu cầu đồng thời trên Mac, đồng thời cung cấp dữ liệu chuẩn mực đồng thời có thể tái lập.

22/09

Thứ Ba · 5 tin
SemiAnalysis@SemiAnalysis_
Nghiên cứuĐiểm AI 37/100

SemiAnalysis phân tích bài toán tính toán và luân chuyển dữ liệu trong suy luận mô hình MoE

Computation and Data Movement for Inference Mapping MoE models onto inference hardware: structure, f…

DịchBài viết đi sâu vào cách tối ưu hóa kiến trúc phần cứng để vận hành hiệu quả các mô hình MoE, tập trung giải quyết nút thắt về luân chuyển dữ liệu trong quá trình suy luận.

21/09

Thứ Hai · 3 tin
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 36/100

CEO Baseten: Lưu lượng suy luận AI tăng vọt 40 lần trong một năm

Baseten CEO Tuhin Srivastava (@tuhinone) just dropped 2 numbers. shows how fast AI inference is expl…

DịchCEO Tuhin Srivastava tiết lộ dữ liệu tăng trưởng ấn tượng của Baseten: lưu lượng token suy luận AI tăng gấp 40 lần và doanh thu tăng 10 lần chỉ trong 12 tháng qua, cho thấy nhu cầu thực tế về hạ tầng AI đang bùng nổ.

19/09

Thứ Bảy · 1 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnKV Cache không cần 'chọn lọc kỹ'? Phương pháp xóa ngẫu nhiên đạt hiệu suất tương đương, tăng tốc độ suy luận tới 43%

Nghiên cứu mới từ Salesforce và UIUC cho thấy việc xóa ngẫu nhiên các token trong KV Cache mang lại hiệu quả tương đương các thuật toán phức tạp, đồng thời giúp tăng đáng kể tốc độ suy luận nhờ giảm tải tính toán.


Vì sao đáng đọc: Đây là một phát hiện mang tính 'phản trực giác' nhưng có tác động lớn đến tối ưu hóa hạ tầng AI, giúp giảm chi phí vận hành mô hình ngôn ngữ lớn một cách thực tế.

18/09

Thứ Sáu · 2 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnEMNLP 2026: Tại sao LLM lại trả lời sai dù thực tế đã 'biết' đáp án?

Nghiên cứu từ Đại học Bắc Kinh và YIXIN AI Lab chỉ ra rằng LLM thường trả lời sai do 'nút thắt đọc dữ liệu' (Readout Bottleneck), nơi đáp án đúng đã tồn tại trong trạng thái ẩn nhưng bị sai lệch khi chuyển đổi thành kết quả đầu ra.


Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề cốt lõi trong đánh giá năng lực LLM, thách thức cách đo lường benchmark hiện nay và cung cấp góc nhìn mới về cơ chế suy luận của mô hình.

17/09

Thứ Năm · 5 tin
SemiAnalysis@SemiAnalysis_
Hướng dẫnĐiểm AI 50/100

SemiAnalysis: Lưu lượng truy cập từ AI Agent đã chiếm hơn 70% tổng lưu lượng suy luận

AGENTIC TRAFFIC NOW MAKES UP MORE THAN 70% OF ALL INFERENCE TRAFFIC 🚀 Agentic workloads are chara…

DịchTheo SemiAnalysis, các tác nhân AI (Agent) hiện chiếm hơn 70% lưu lượng suy luận. Báo cáo chỉ ra các đặc điểm tải công việc đặc thù như khả năng tái sử dụng KV-cache cao qua các vòng hội thoại và sự gia tăng nhanh chóng của ngữ cảnh từ hệ thống và công cụ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Fathom: Tối ưu hóa tốc độ giải mã cho KV Cache dung lượng lớn thông qua kỹ thuật đọc chọn lọc

Fathom giới thiệu phương pháp đọc KV cache linh hoạt dựa trên ngân sách bit cho từng truy vấn, giúp tăng tốc độ giải mã lên 1,67 lần ở quy mô 1 triệu token mà vẫn duy trì độ chính xác cao hơn so với các kỹ thuật hiện có.

Tang Jie@jietang
Hướng dẫnĐiểm AI 63/100

Cùng sự kiệnTang Jie: Infra Agent giúp tối ưu hóa hiệu suất suy luận GLM-5.3-Flash gấp 3.2 lần chỉ trong 2 tuần

Two weeks. That's how long it took to go from GLM-5.3-Flash's first run on domestic accelerators to…

DịchGiáo sư Tang Jie chia sẻ cách Infra Agent hỗ trợ triển khai GLM-5.3-Flash trên chip nội địa, giúp tăng lưu lượng xử lý đầu cuối lên 3.2 lần chỉ sau 14 ngày.

Cùng sự kiện, bài đại diện «Zhipu AI tối ưu hóa hạ tầng suy luận cho GLM-5.3, tăng gấp 3 lần lưu lượng xử lý»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Sử dụng Register Tokens để tối ưu hóa suy luận trạng thái giới hạn trong mô hình ngôn ngữ khuếch tán

Nghiên cứu giới thiệu phương pháp dùng các 'register tokens' để lưu trữ trạng thái suy luận, giúp mô hình ngôn ngữ khuếch tán duy trì logic mạch lạc khi xử lý văn bản dài mà không cần giữ toàn bộ ngữ cảnh cũ.

16/09

Thứ Tư · 2 tin
SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 34/100

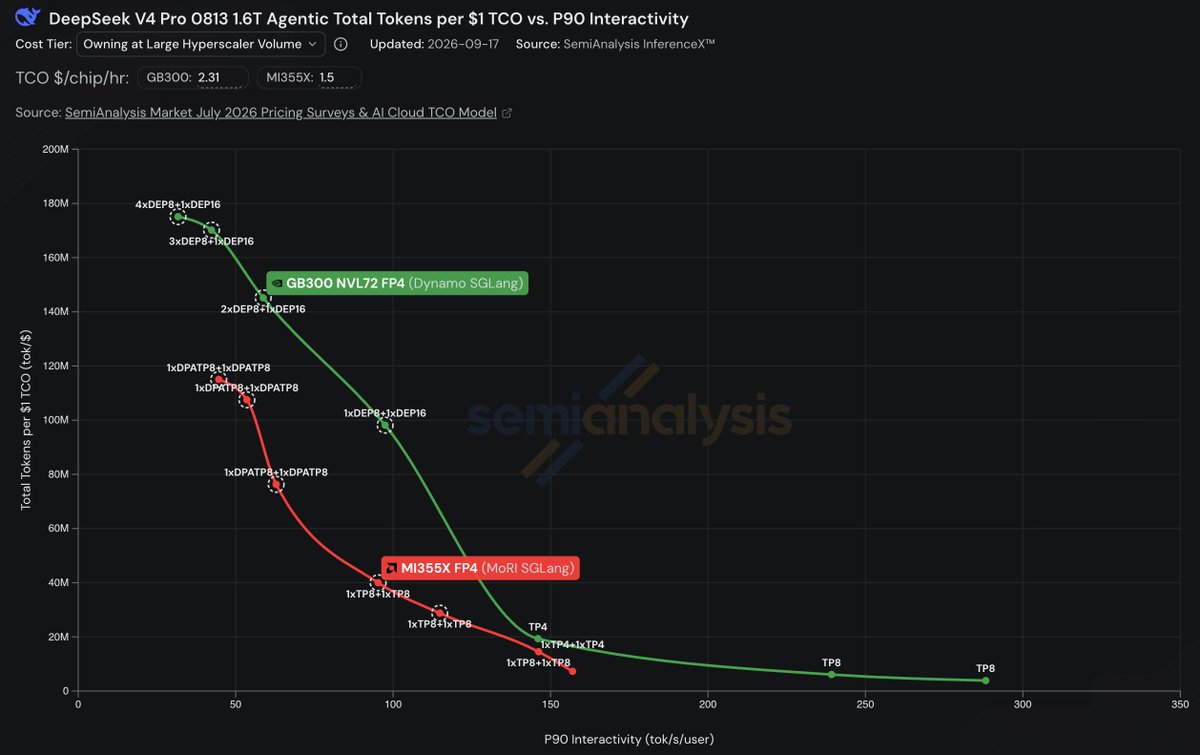
AMD MI355X bám đuổi sát nút Nvidia GB300 trong hiệu năng suy luận AI

BREAKING: AMD MI355X is quickly closing the perf/TCO gap in agentic inference, when compared to GB30…

DịchAMD MI355X đang rút ngắn đáng kể khoảng cách về hiệu năng và chi phí sở hữu (TCO) so với đối thủ GB300 của Nvidia trong các tác vụ suy luận AI, theo dữ liệu mới nhất từ SemiAnalysis.

NVIDIA Technical Blog: Agentic AI / Generative AI
NgànhĐiểm AI 37/100

NVIDIA Groq 3 LPX: Tối ưu hóa hiệu năng và năng lượng cho kiến trúc Vera Rubin nhờ thực thi xác định

NVIDIA Groq 3 LPX sử dụng mô hình thực thi xác định để tối ưu hóa lịch trình vận hành trên 256 chip LPU, kết hợp công nghệ PEP và CPS giúp giảm lãng phí điện năng, từ đó tăng cường hiệu suất suy luận cho kiến trúc Vera Rubin.

15/09

Thứ Ba · 4 tin
Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 62/100

Giải mã Prefill và Decode: Tại sao AI đọc tài liệu dài mới phản hồi, nhưng viết lại càng lúc càng chậm?

Bài viết giải thích hai giai đoạn suy luận của LLM: Prefill xử lý song song đầu vào quyết định tốc độ phản hồi ban đầu (TTFT), trong khi Decode tạo văn bản từng token một và thường bị nghẽn băng thông bộ nhớ.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 46/100

Omni-Streaming Thinking: Giải pháp ngăn chặn AI đa phương thức đưa ra kết luận vội vàng

Omni-Streaming Thinking (OST) giúp mô hình AI phân tách dữ liệu thành bằng chứng và dự đoán, cho phép kiểm chứng thông tin theo thời gian thực để tránh sai sót khi xử lý dữ liệu đa phương thức.

MiniMax@MiniMax_AI
NgànhĐiểm AI 39/100

MiniMax H3 đạt tốc độ khử nhiễu thời gian thực gấp 2 lần trên hệ thống 8x B200

H3 keeps getting faster. ⚡️ @sgl_project + VDN-H3 now push MiniMax H3 beyond 2× real-time denoising…

DịchMiniMax H3 tối ưu hóa quy trình tạo video 768p với thời gian khử nhiễu chỉ 6,9 giây, đạt hiệu suất vượt trội mà không làm giảm chất lượng hình ảnh so với mô hình gốc.

14/09

Thứ Hai · 4 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ActionSplice: Công nghệ chỉnh sửa hành động thời gian thực cho mô hình thế giới

ActionSplice là khung suy luận mới giúp thay đổi hành động trong mô hình thế giới video mà không cần tính toán lại từ đầu, thông qua kỹ thuật vận chuyển trạng thái phản thực tế (CST) giúp tối ưu hóa tốc độ và độ chính xác.

karminski@karminski3
NgànhĐiểm AI 27/100

Tranh cãi về cường độ suy luận trên DeepSeek-V4.1-Flash: Nên chọn 'Max' hay 'High'?

Người dùng tranh luận về việc thiết lập cường độ suy luận trên DeepSeek-V4.1-Flash. Trong khi một số cho rằng cài đặt này không ảnh hưởng hiệu suất, tác giả dẫn chứng nghiên cứu DeepSeek-R1-Zero để khẳng định thời gian suy luận càng dài, năng lực giải quyết vấn đề càng cao.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (55 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “suy luận AI” | AIHOT.vn