Mac Mini M6 chạy giả lập 86Box 6.0 ổn định với cấu hình Pentium II 600MHz và card đồ họa Voodoo 3, đạt hiệu suất vượt trội 20% so với thế hệ M4 trong các bài kiểm tra Cinebench 2000 và 3DMark 2000 SE.
vLLM chính thức phát hành vllm-metal v0.28.0, mang bộ lập lịch V1, paged KV cache và server tương thích OpenAI lên chip Apple Silicon thông qua MLX và Metal.
Vì sao đáng đọc: Lần đầu tiên chính thức phát hành vllm-metal, sử dụng packed varlen attention và paged KV để giải quyết vấn đề dịch vụ yêu cầu đồng thời trên Mac, đồng thời cung cấp dữ liệu chuẩn mực đồng thời có thể tái lập.
🎙️ Real-time interpretation, powered locally by VoxCPM2. Developer @HenryZ30734018 built VoxWeft, …
DịchDựa trên VoxCPM2, VoxWeft cho phép thực hiện thông dịch giọng nói thời gian thực ngay trên thiết bị Apple Silicon mà không cần gửi dữ liệu ra ngoài, đảm bảo quyền riêng tư tuyệt đối.
Jun Kim, cha đẻ của oMLX, đã gia nhập Hugging Face để phát triển toàn thời gian dự án này. oMLX sẽ tiếp tục là mã nguồn mở, đóng vai trò là cầu nối quan trọng giúp các mô hình Transformers sớm được tối ưu hóa cho chip Apple Silicon.
SiliconBench là bộ tiêu chuẩn mới đánh giá 9 công cụ chạy LLM trên Apple Silicon dựa trên ba yếu tố: tốc độ, bộ nhớ và độ chính xác, giúp tối ưu hóa việc triển khai mô hình cục bộ.
Phiên bản Laya-mlx được tối ưu trên framework MLX giúp tăng tốc độ xử lý gấp 50 lần so với Jev, chỉ chiếm tối đa 1GB RAM. Mô hình này hiện có thể điều khiển game Rắn săn mồi ngay trên chip M3 Max với tốc độ 60 khung hình/giây.
Laya (OS Jev) hiện đã hỗ trợ chạy offline trên chip Mac M4 thông qua CoreML với hiệu suất ấn tượng 45 quyết định mỗi giây. Người dùng có thể cài đặt qua uv và tải mô hình cục bộ để trải nghiệm trực tiếp.
Chỉ trong một tháng, nhóm phát triển đã đảo ngược thành công firmware AGX trên M4 Mac Mini để viết driver Linux, đạt chuẩn OpenGL ES 3.0 với hiệu năng ấn tượng: Minecraft đạt 200fps và trình duyệt chạy mượt mà.
Tác giả thực hiện kỹ thuật đảo ngược Apple Neural Engine trên chip M1, khám phá chi tiết cấu trúc 16 nhân tính toán và hệ thống điều phối tác vụ, từ đó đưa ra góc nhìn chuyên sâu về sự thay đổi của công nghệ NPU.
Các nhà phát triển đã thành công đưa công nghệ DLSS 5 lên chip Apple M5 Pro thông qua ReShade và Game Porting Toolkit. Dù cải thiện đáng kể chất lượng hình ảnh nhờ AI, hiệu năng hiện vẫn rất thấp với độ trễ lên tới 240ms do thiếu phần cứng hỗ trợ FP8 chuyên dụng.
Perplexity vừa mã nguồn mở Lily, công cụ suy luận hiệu năng cao viết bằng Rust và Metal, được thiết kế chuyên biệt để chạy mô hình Qwen3.6-35B-A3B trên chip Apple Silicon mà không cần phụ thuộc vào PyTorch hay MLX.
We're open-sourcing Lily, Perplexity's local inference engine for serving models locally on Apple Si…
DịchPerplexity vừa mã nguồn mở Lily, công cụ suy luận được tối ưu hóa cho chip Apple Silicon để chạy mô hình Qwen3.6-35B-A3B, giúp tăng tốc các tác vụ tính toán hỗn hợp trên Mac mà không phụ thuộc vào điện toán đám mây.
Today we're open-sourcing Lily, the local inference engine we built for hybrid compute in Perplexity…
DịchPerplexity vừa mã nguồn mở Lily, công cụ suy luận được tối ưu hóa đặc biệt cho mô hình Qwen3.6-35B-A3B trên chip Apple Silicon, giúp tăng tốc xử lý tác vụ trực tiếp trên thiết bị mà không bị nghẽn hiệu năng.
Fast H3 on a local device! Good news for the localhost community: open, fast, high quality video gen…
DịchFastH3 của FastVideo vừa cập nhật hỗ trợ NVIDIA DGX Spark và chip Apple Silicon qua MLX, giúp tăng tốc độ tạo video cục bộ lên gấp 8 lần so với phiên bản MiniMax H3 gốc.
(1/7) Last week FastVideo released FastH3. Today we bring it local: @NVIDIA DGX Spark 💚 and @Apple …
DịchFastVideo vừa cập nhật FastH3, cho phép chạy mô hình tạo video cục bộ trên NVIDIA DGX Spark và chip Apple Silicon (qua MLX) với hiệu suất nhanh gấp 8 lần so với MiniMax H3 tiêu chuẩn.
Hướng dẫn chi tiết cách chạy các mô hình LLM cục bộ trên Mac mini M4 Pro 48GB RAM, kết hợp dịch vụ oMLX và Tailscale để đồng bộ hóa trải nghiệm AI trên nhiều thiết bị Apple.
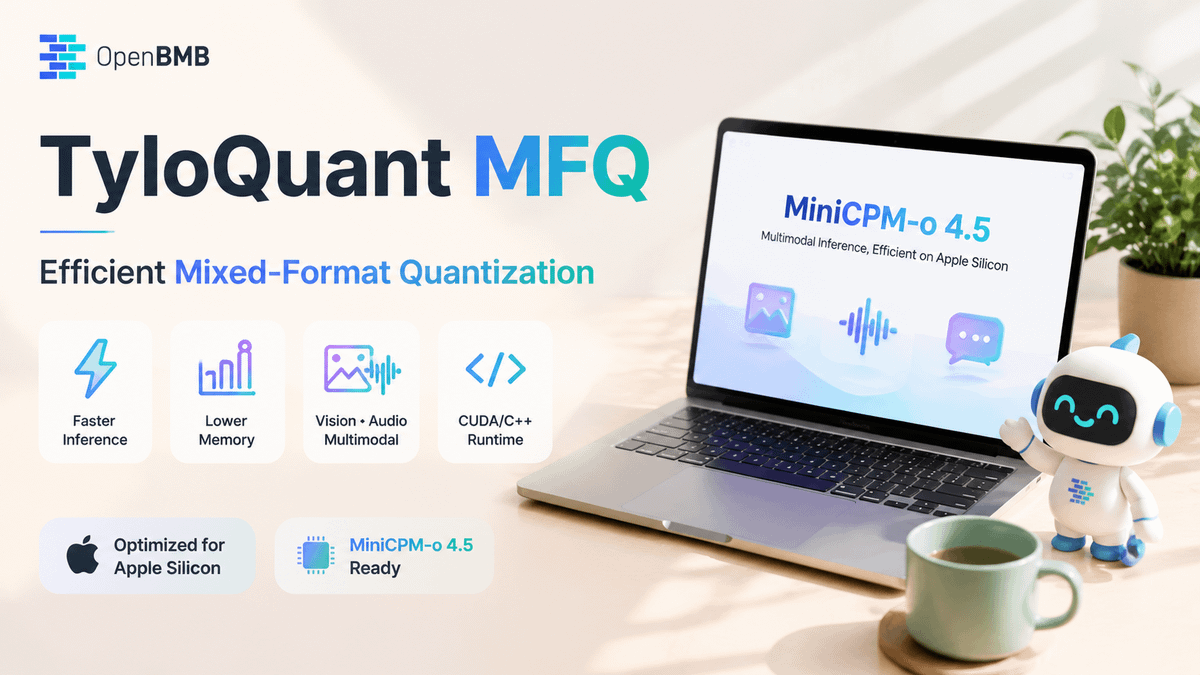
MiniCPM-o 4.5 now runs efficiently on Apple Silicon with TyloQuant MFQ! 🥰 The team at @Tylogi_ai h…
DịchMô hình MiniCPM-o 4.5 hiện đã có thể chạy cục bộ trên chip Apple Silicon thông qua kỹ thuật lượng tử hóa TyloQuant MFQ, giúp tối ưu bộ nhớ mà vẫn giữ nguyên khả năng xử lý đa phương thức và tương tác thời gian thực.
While Apple does not appear to be competing to build the world's leading standalone frontier AI mode…
DịchApple chọn tập trung vào thế mạnh phần cứng thay vì cạnh tranh mô hình AI tiên phong. Tác giả kỳ vọng vào sự kiện sắp tới và vai trò của John Ternus trong việc thúc đẩy hệ sinh thái Apple Silicon.
A 5-second 480P video, generated entirely on a Mac, in 30 seconds. No CUDA, no cloud, 3.9 GiB of mem…
DịchFastMetal mang mô hình FastWan-QAD lên chip Apple Silicon, cho phép tạo video 480P chỉ trong 30 giây với 3.9GB RAM mà không cần CUDA hay điện toán đám mây.
Dự án microGPT-C tối ưu hóa bằng NEON đạt tốc độ suy luận ấn tượng 10,16 triệu token/giây. Với chỉ 4.192 tham số, mô hình này vượt trội hơn các mô hình nội suy truyền thống trong việc dự đoán tên gọi mà không cần phụ thuộc vào thư viện bên ngoài.
A "refusal-removed" version of Qwen3.8-27B can now run locally on Apple Silicon. Even its creators …
DịchMô hình Qwen3.8-27B bản gỡ bỏ kiểm duyệt đã xuất hiện trên Apple Silicon, hỗ trợ cửa sổ ngữ cảnh 262K token. Người tạo cảnh báo mô hình có thể phản hồi các yêu cầu độc hại mà không bị từ chối.
Incredible stuff. Now I need a Navi fairy companion version.
DịchChuyên gia fofr đánh giá cao TypeGPU khi chạy mô hình độ sâu 448x448 trên chip M4 Pro chỉ trong 8ms. Giải pháp này tối ưu hóa hiệu suất bằng cách hợp nhất quy trình suy luận, chiếu sáng và kết xuất vào cùng một bộ mã hóa lệnh mà không cần đồng bộ GPU.
Bài viết phân tích cách khắc phục các lỗi kỹ thuật khi chạy mô hình Nanbeige4.2-3B trên Apple Silicon và giới thiệu chiến lược 'chunked-prefill' giúp tăng gấp 2.7 lần độ dài ngữ cảnh bằng cách giảm tải bộ nhớ cho kiến trúc Looped Transformer.
Qwen3.8-27B is available on @ollama! Any harness you run, the model always delivers. Let's code toge…
DịchMô hình mã nguồn mở Qwen3.8-27B đã có mặt trên Ollama, nổi bật với khả năng xử lý tác vụ thông minh và tích hợp mượt mà với các công cụ như Claude Code hay Hermes Agent.