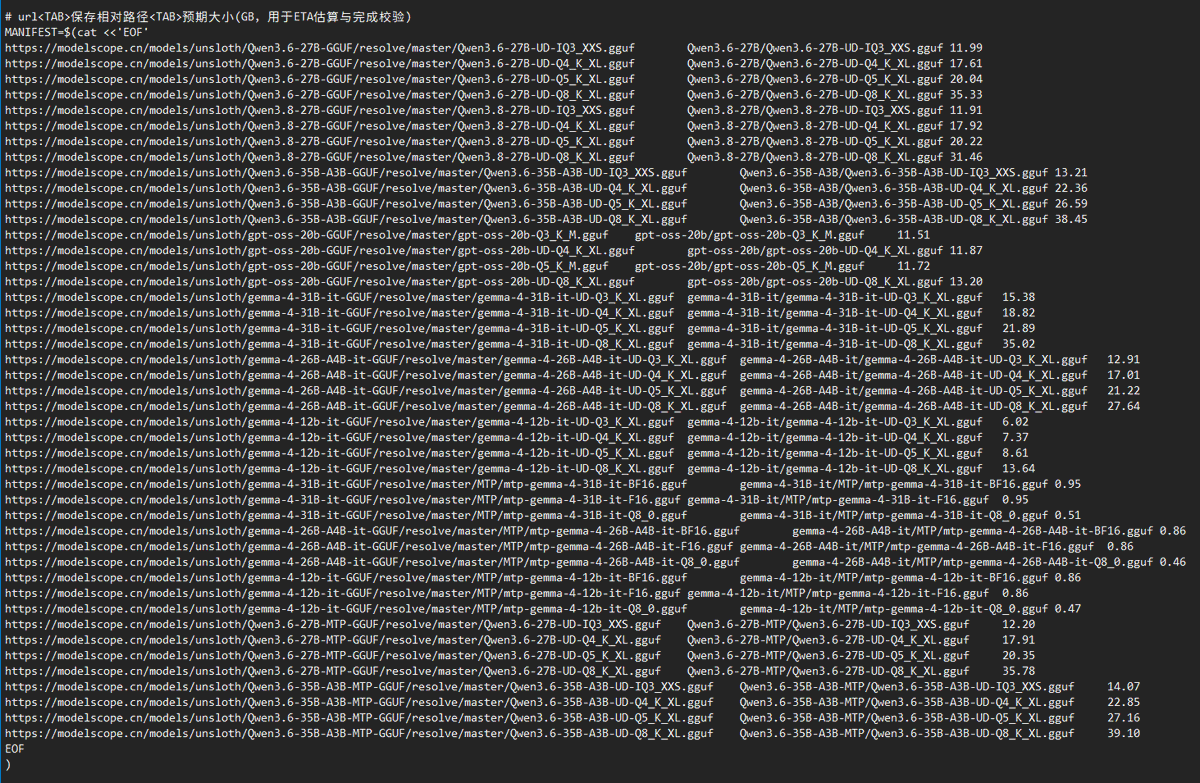
Karminski công bố bảng xếp hạng khả năng làm Agent của các mô hình nhỏ, trong đó Qwen3.8-27B-UD-Q4_K_XL được đánh giá cao nhất. Bài viết cũng chia sẻ cấu hình tối ưu cho lập luận và lập trình, cùng lời khuyên sử dụng MLX cho người dùng Mac để đạt tốc độ tốt hơn.
Love this, GLM-5.3-Flash produced a comparable Blender result for 16.7x less than GLM-5.3. atomic【….
DịchGLM-5.3-Flash thực hiện tác vụ dựng hình phức tạp trên Blender với chi phí chỉ 0,05 USD, nhanh hơn và chính xác hơn phiên bản tiêu chuẩn, đồng thời có thể chạy cục bộ trên MacBook 128GB.
Bài đánh giá chuyên sâu sắp tới sẽ so sánh hiệu năng của các mô hình Qwen và Gemma ở nhiều mức độ nén (3-8 bit) và khả năng suy luận, giúp người dùng tối ưu hóa việc triển khai AI trên phần cứng cá nhân.
A "refusal-removed" version of Qwen3.8-27B can now run locally on Apple Silicon. Even its creators …
DịchMô hình Qwen3.8-27B bản gỡ bỏ kiểm duyệt đã xuất hiện trên Apple Silicon, hỗ trợ cửa sổ ngữ cảnh 262K token. Người tạo cảnh báo mô hình có thể phản hồi các yêu cầu độc hại mà không bị từ chối.
A developer in our community @dvictor3579, built GMGN Local Research Agent with MiniCPM5-1B 🥳 Ins…
DịchNhà phát triển @dvictor3579 đã tạo ra GMGN Local Research Agent sử dụng MiniCPM5-1B, cho phép truy xuất dữ liệu GMGN an toàn ngay trên thiết bị mà không tốn chi phí API, tối ưu hóa hiệu suất và quyền riêng tư.
 karminski@karminski3