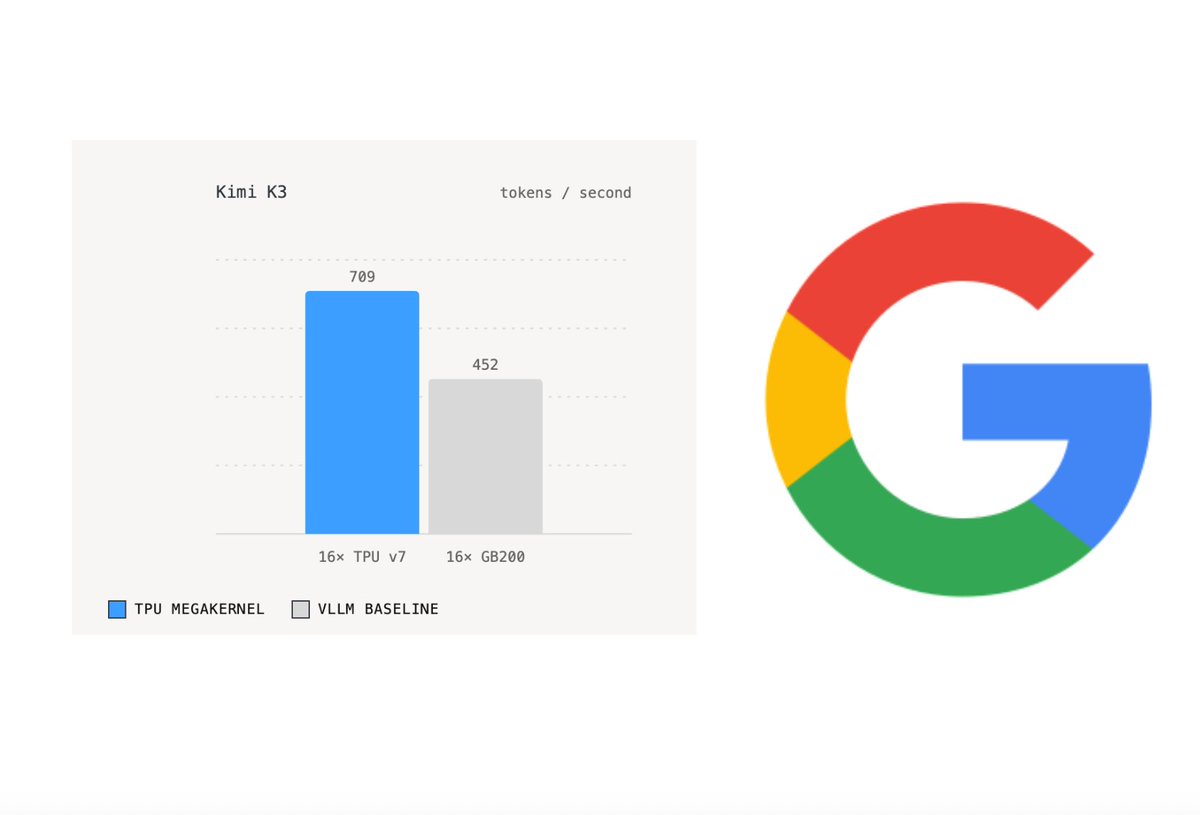
Đội ngũ đứng sau vLLM vừa công bố bước đột phá khi tối ưu hóa khung suy luận DeepSeek, giúp Google TPU vượt mặt GPU NVIDIA với hiệu suất tăng 57% khi vận hành mô hình Kimi.
Vì sao đáng đọc: Tin tức kỹ thuật quan trọng về tối ưu hóa hạ tầng AI, thách thức sự thống trị của NVIDIA và mở ra tiềm năng lớn cho việc sử dụng TPU trong suy luận mô hình ngôn ngữ lớn.
vLLM vừa bổ sung thuật toán Gumbel-max vào pipeline lấy mẫu của Model Runner v2, cho phép đóng dấu bản quyền văn bản mà không làm giảm chất lượng, đồng thời hỗ trợ giải mã suy đoán và duy trì tính đa dạng của nội dung.
Vì sao đáng đọc: Bài viết cung cấp nguyên lý thuật toán đóng dấu bản quyền, phương án khóa kép và khử trùng lặp cùng dữ liệu thông lượng thực tế, giúp độc giả đánh giá tính khả thi và chi phí khi kích hoạt watermark trong môi trường sản xuất.
ALERT ALERT ALERT 🚨 🚨 🚨 VLLM MAINTAINERS HAVE JUST SHOWN THAT TPUv7 CAN GET 700 tok/s/user, 56% …
DịchCác nhà phát triển vLLM công bố TPUv7 đạt tốc độ 700 tok/s/user trên mô hình Kimi K3 sau khi tối ưu megakernel, vượt trội 56% so với hệ thống GB200 NVL72. Kết quả này cho thấy tiềm năng lớn từ việc tối ưu hóa phần mềm cho hạ tầng TPU.
vLLM chính thức phát hành vllm-metal v0.28.0, mang bộ lập lịch V1, paged KV cache và server tương thích OpenAI lên chip Apple Silicon thông qua MLX và Metal.
Vì sao đáng đọc: Lần đầu tiên chính thức phát hành vllm-metal, sử dụng packed varlen attention và paged KV để giải quyết vấn đề dịch vụ yêu cầu đồng thời trên Mac, đồng thời cung cấp dữ liệu chuẩn mực đồng thời có thể tái lập.
Massive shoutout to TJ & Team at @EmbeddedLLM; they are the lead maintainers & CODEOWNERS of vLLM RO…
DịchĐội ngũ phát triển vLLM ROCm tại EmbeddedLLM đã chính thức nhận được quyền truy cập lâu dài vào cụm máy chủ MI355X của AMD, hứa hẹn thúc đẩy hiệu năng vượt trội cho dự án vLLM.
Bài viết chia sẻ kinh nghiệm triển khai tách biệt PD cho mô hình Qwen3.8-2.4T trên cụm GB300 NVL72, đạt thông lượng 5000 token/GPU và độ trễ tối ưu cho người dùng.
Thanks @vllm_project for the day-0 support! 🙌 Generate, edit, transparent output - one model, ready…
DịchQwen-Image-2.1 kết hợp kiến trúc 7.1B DiT và Qwen3-VL-8B, cho phép tạo, chỉnh sửa và xuất ảnh trong suốt trong cùng một mô hình. Người dùng có thể triển khai ngay với sự hỗ trợ từ vLLM-Omni.
NVIDIA giới thiệu AIPerf, phiên bản nâng cấp của GenAI-Perf với kiến trúc đa tiến trình giúp loại bỏ nút thắt cổ chai khi đo lường hiệu năng. Công cụ hỗ trợ đa dạng mô hình truy vấn và các kịch bản tải thực tế, tối ưu cho việc kiểm thử hệ thống LLM quy mô lớn.
Great blog from Kevin Lu at @vllm_project about quality control at the inference engine. Unfortunate…
DịchBài viết từ SemiAnalysis chỉ ra rằng sự thiếu hụt hạ tầng kiểm thử ổn định cho AMD khiến chất lượng phần mềm vLLM trên nền tảng này kém xa so với CUDA, gây ra tình trạng gián đoạn CI thường xuyên.
vLLM vừa hỗ trợ giải mã video phần cứng (NVDEC), giúp chuyển tải xử lý từ CPU sang GPU. Trên hệ thống 8xH100, hiệu suất giải mã tăng gấp đôi so với phương pháp cũ, tối ưu hóa đáng kể cho các tác vụ AI đa phương thức.
Đội ngũ vLLM đã sử dụng hệ thống GB300 NVL72 để huấn luyện mô hình DSpark cho Kimi K3, giúp tăng tốc độ suy luận toán học lên gấp 4 lần và cải thiện thông lượng đầu ra tới 3,5 lần.
SingProbe là công cụ kiểm soát an toàn dựa trên mô hình Gemma-4-26B, với tham số chỉ 5.67M giúp tối ưu hóa hiệu suất mà không làm chậm quá trình suy luận. Công cụ này hỗ trợ phát hiện ảo tưởng và rủi ro bảo mật, tương thích tốt với SGLang và vLLM.
Bài viết phân tích cách vLLM-Omni và FastVideo FastH3 giải quyết các nút thắt hệ thống trong MiniMax H3, giúp rút ngắn thời gian tạo video 10 giây xuống dưới 9 giây thông qua tối ưu hóa toàn diện từ DiT đến đóng gói MP4.
Vì sao đáng đọc: Nội dung chuyên sâu về kỹ thuật tối ưu hóa hạ tầng cho mô hình video tạo sinh, giải quyết bài toán thực tế về độ trễ hệ thống, rất có giá trị cho kỹ sư AI.
On the Day 0 release of DeepSeekv4.1 Flash, NVIDIA vLLM works out of the box with zero issues across…
DịchNVIDIA vLLM đã hỗ trợ hoàn hảo cho cả 6 dòng chip từ H100 đến GB300 ngay khi DeepSeek-V4.1 Flash vừa trình làng, trong khi phía AMD vẫn chưa thể vận hành mô hình này.
Cambricon đã hoàn tất tích hợp DeepSeek-V4.1-Flash vào vLLM thông qua hệ sinh thái NeuWare, cho phép tối ưu hóa hiệu suất trực tiếp trên chip MLU ngay khi mô hình vừa trình làng.
Spec Decoding (DSpark) finally works with Pipeline Parallelism in vLLM!! 🔥 A lot of the GPU poor/pr…
DịchvLLM hiện đã cho phép DSpark hoạt động cùng Pipeline Parallelism, giúp các mô hình siêu lớn (như Kimi K3 2.8T) tận dụng được khả năng suy luận dự đoán ngay cả khi phải chia nhỏ trọng số trên nhiều máy.
Đội ngũ vLLM công bố tối ưu hóa hiệu suất cho các tác vụ AI Agent, đạt tốc độ ấn tượng 83K tokens/giây trên mỗi GPU với mô hình DeepSeek V4 Pro dựa trên chuẩn AgentX.
Vì sao đáng đọc: Đây là bước tiến kỹ thuật quan trọng giúp tăng tốc độ xử lý cho các hệ thống AI Agent, rất hữu ích cho các kỹ sư và nhà phát triển ứng dụng LLM.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Bài viết giới thiệu cách vLLM triển khai kỹ thuật giải mã suy đoán trên kiến trúc GPU AMD, giúp tăng tốc độ suy luận cho các mô hình ngôn ngữ lớn mà vẫn đảm bảo độ chính xác.
Nhờ tối ưu hóa phần mềm ROCm và toán tử chú ý cho ngữ cảnh dài, AMD đã giúp chip MI355X đạt hiệu suất vượt trội trên mô hình MiniMax M3 mà không cần thay đổi phần cứng.
DịchOpenBMB vừa trình làng MiniCPM5-2B, mô hình 2.6B hỗ trợ ngữ cảnh 131K và linh hoạt chuyển đổi giữa chế độ suy luận (Think) và phản hồi trực tiếp. Đặc biệt, mô hình đã được hỗ trợ chính thức ngay từ ngày đầu trên vLLM, giúp tối ưu hóa hiệu suất triển khai.
Join us if you want to work on hard inference and infrastructure engineering problems!
DịchPerplexity vừa công bố kiến trúc phục vụ mô hình pplx-embed, giúp tăng tốc đáng kể các tác vụ embedding và reranking trên quy mô dữ liệu khổng lồ, vượt xa hiệu năng của vLLM.
This is what open-source intelligence is for. Built on vLLM-Omni and @haoailab's FastH3, with @NVID…
DịchMiniMax vừa công bố bước tiến đột phá khi kết hợp vLLM-Omni và FastH3, cho phép tạo video 10,1 giây kèm âm thanh đồng bộ chỉ trong 8,7 giây, đạt tốc độ nhanh hơn thời gian phát thực tế.
Checkout FastVideo's FastH3 Dense served on @vllm_project vLLM-Omni! This is the power of open sourc…
DịchĐội ngũ FastVideo tích hợp FastH3 Dense vào vLLM-Omni, cho phép tạo video 10.1 giây kèm âm thanh đồng bộ với tốc độ nhanh hơn thời gian thực. Dự án đã mở mã nguồn với sự hỗ trợ tối ưu hóa từ NVIDIA.
Phiên bản vLLM v0.28.0 mang đến cải tiến lớn với hỗ trợ DCP cho Kimi-K3, tăng tốc độ phản hồi TTFT lên 60% và triển khai cơ chế MLA thưa cho DeepSeek V4.
DịchMô hình 770B tham số Hy4-preview của Tencent hiện đã tương thích với vLLM trên GPU NVIDIA. Với kiến trúc 256 chuyên gia định tuyến, mô hình hỗ trợ cửa sổ ngữ cảnh lên tới 1 triệu token.
I've put together an up-to-date, validated DGX Spark setup for ML experiments such as post-training: …
DịchHướng dẫn cấu hình tối ưu cho DGX Spark bao gồm PyTorch 2.13 trên CUDA 13, nhân huấn luyện đã kiểm chứng qua GB10 và môi trường vLLM biệt lập, giúp tăng hiệu suất cho các thử nghiệm hậu huấn luyện.
Google Cloud tích hợp hỗ trợ TPU vào vLLM, tối ưu hóa cho dòng mô hình Qwen3 để xử lý suy luận Embedding đa phương thức với ngữ cảnh dài (4K+ token văn bản, 15K+ token đa phương thức).
Amazing! 🥳 Thanks @vllm_project for getting Qwen3.8-Flash-Next running on NVIDIA and AMD from day 0…
DịchMô hình đa phương thức MoE Qwen3.8-Flash-Next với 125B tham số đã được vLLM hỗ trợ trên cả GPU NVIDIA và AMD. Người dùng có thể trải nghiệm ngay khả năng xử lý ngữ cảnh lên tới 1 triệu token thông qua phiên bản vLLM mới nhất.
Các mô hình AI độc hại có thể khai thác lỗ hổng trong các công cụ suy luận như vLLM để thực thi mã tùy ý trên máy chủ. Việc phổ biến các mô hình mã nguồn mở đang làm gia tăng đáng kể rủi ro bảo mật này.
The @vllm_project & llm-d maintainers at @RedHat_AI are some of the hardest-working and leading …
DịchSemiAnalysis đánh giá cao đội ngũ phát triển vLLM và Red Hat, khẳng định họ là những chuyên gia hàng đầu và tận tâm nhất trong cộng đồng AI hiện nay.