ICYMI: Claude Opus 5.5 (Max) landed #1 in the Code Arena: WebDev with a price 60% lower than the nex…
DịchClaude Opus 5.5 (Max) vừa giành vị trí dẫn đầu bảng xếp hạng Code Arena: WebDev với mức giá chỉ 16 USD/triệu token, rẻ hơn 60% so với đối thủ GPT-6 Astra (Max).
The Intelligence Index vs Cost per Task Pareto frontier shifted this week with the releases of MiMo-…
DịchArtificial Analysis cho biết sự ra mắt của MiMo-V2.6-Pro, Claude Opus 5.5 cùng bộ đôi GPT-6 Luna và Sol đã thay đổi đáng kể biểu đồ Pareto về chỉ số thông minh so với chi phí trên mỗi tác vụ, với 11 điểm dữ liệu mới được thiết lập.
AI costs are indeed dropping dramatically. On GPQA Diamond, Epoch estimates OpenAI's o3 model neede…
DịchTheo Epoch AI, chi phí để đạt cùng một mức điểm benchmark trên các mô hình AI đang giảm mạnh khoảng 47% mỗi quý. Đơn cử, chi phí cho một bài toán trên GPQA đã giảm tới 725 lần chỉ trong vòng 18 tháng, cho thấy tốc độ tối ưu hóa hiệu năng AI đang tăng tốc chóng mặt.
Interesting. Grok 4.7 is performing fairly well for a smallish model.
DịchGrok 4.7 đạt kết quả 94% trong bài kiểm tra Next.js, bám sát các mô hình hàng đầu như Opus 5.5 và GPT 6 Sol, trong khi có chi phí vận hành rẻ hơn từ 2 đến 7 lần.
Diễn biến sự kiện · 24 bài →Thêm 6 nguồn khác đưa tinX: Arena (@arena)X: Hongming (@hongming731)IT HomeX: karminski (@karminski3)MarkTechPostX: Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI) (@alexandr_wang)
Very interesting experiments by @thehypedotnews gpt-6 sol vs grok 4.7 vs gpt-6 astra vs muse spark…
DịchThử nghiệm tạo file HTML cho bối cảnh Star Wars cho thấy GPT-6 Sol dẫn đầu về tốc độ (nhanh gấp đôi), trong khi Muse Spark 1.3 tối ưu nhất về chi phí. Tất cả các mô hình đều hoàn thành tốt nhiệm vụ với tổng chi phí thấp.
Nghiên cứu từ Epoch AI cho thấy chi phí để đạt được cùng một mức hiệu năng AI giảm trung bình 47% mỗi quý. Tốc độ này cho thấy sự tiến bộ vượt bậc trong hiệu quả tính toán kể từ khi các mô hình ngôn ngữ lớn thương mại ra đời vào cuối năm 2021.
Vì sao đáng đọc: Báo cáo cung cấp dữ liệu định lượng quan trọng về kinh tế học AI, giúp người đọc hiểu rõ tốc độ tối ưu hóa chi phí thực tế trong ngành, rất có giá trị cho giới chuyên môn.
Opus 5.5 is a really good model. It's been my daily driver the last few weeks. We had Opus 5.5 and …
DịchBoris Cherny từ Anthropic cho biết Claude Opus 5.5 vượt trội hơn Fable 5.1 trong tác vụ chuyển đổi mã nguồn từ C sang Rust với tốc độ nhanh hơn và chi phí vận hành thấp hơn đáng kể.
SiliconBench là bộ tiêu chuẩn mới đánh giá 9 công cụ chạy LLM trên Apple Silicon dựa trên ba yếu tố: tốc độ, bộ nhớ và độ chính xác, giúp tối ưu hóa việc triển khai mô hình cục bộ.
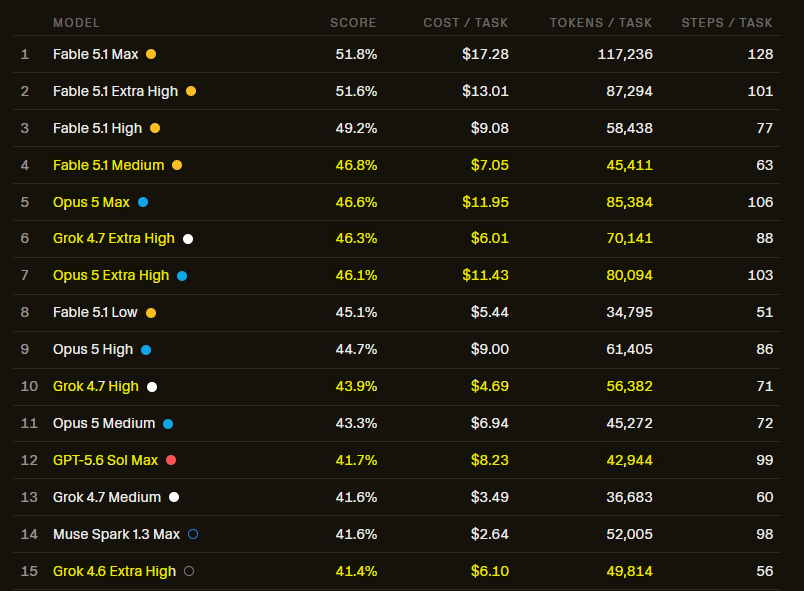
this is absurd actually CursorBench 4.0: grok 4.7 xhigh: 46.3% - $6.01/task fable 5.1 medium: 46.8…
DịchCursorBench 4.0 cho thấy sự bứt phá ấn tượng của Grok 4.7 xhigh với tỷ lệ thành công 46,3% ở mức giá tối ưu, vượt qua cả GPT-5.6 sol max trong bài kiểm tra lập trình.
Best quality-price performance in the world for image gen! 🔥
DịchMAI-Image-2.6 cùng các mô hình mới như Muse Image và GPT Images 2.5 đang tạo ra bước ngoặt lớn, giúp việc tạo ảnh chất lượng cao trở nên nhanh chóng và tiết kiệm chi phí hơn bao giờ hết.
GPT-6 Astra is crushing Fable 5.1 on the fully agentic ML benchmark WeirdML v3 astra: 42% - $27 - 1…
DịchGPT-6 Astra áp đảo Fable 5.1 trong bài kiểm tra WeirdML v3 với hiệu suất vượt trội, đạt điểm số cao hơn đáng kể trong khi tiết kiệm chi phí và tối ưu hóa lượng token đầu ra.
Generating high-quality images is cheaper and faster than ever. Muse Image, MAI-Image-2.6 and GPT Im…
DịchSự xuất hiện của Muse Image, MAI-Image-2.6 và GPT Images 2.5 đang thiết lập chuẩn mực mới, giúp việc tạo ảnh chất lượng cao trở nên nhanh chóng và tiết kiệm chi phí hơn bao giờ hết.
some improvements were made with Union Alpha, try it again if you had issues
DịchUnion Alpha vừa cập nhật cải tiến hiệu suất sau phản hồi về tốc độ chậm. Hiện hệ thống đã đạt cột mốc hơn 100 tỷ token và đang duy trì tốc độ xử lý ấn tượng 500 triệu token mỗi phút.
Điểm GeekBench AI của chip A20 Pro cho thấy hiệu suất NPU tăng vọt nhờ thiết kế 32 nhân và bộ tăng tốc thần kinh mới, giúp tốc độ tính toán dấu phẩy động 8-bit tăng gấp đôi và băng thông bộ nhớ cải thiện 50%.
Hi Astra users. A reset and a quick update on quality issues that have been posted around. Working …
DịchĐội ngũ Astra đã xử lý các lỗi kỹ thuật gây gián đoạn trải nghiệm, bao gồm vấn đề về tần suất kích hoạt kỹ năng và quản lý ngữ cảnh. Hiệu năng hệ thống hiện đã được cải thiện đáng kể và hạn mức sử dụng của người dùng sẽ được đặt lại trước nửa đêm nay.
How does GPT-Live-1 perform on the benchmarks that matter most for production voice agents? We focu…
DịchGPT-Live-1 được kiểm chứng qua các tiêu chí khắt khe như khả năng hoàn thành tác vụ, hội thoại đa vòng, tốc độ phản hồi và gọi hàm công cụ, khẳng định vị thế trong ứng dụng thực tế.
GPT-6 Astra vừa chiếm lĩnh vị trí dẫn đầu trên ErdosBench với 106 bài toán được giải quyết, vượt xa các phiên bản tiền nhiệm dù OpenAI cho biết không hề can thiệp để cải thiện khả năng toán học chuyên biệt.
Nvidia Chief Scientist Bill Dally: "What everyone is showing, acutally did see some slides on this a…
DịchTrong buổi tọa đàm tại Bảo tàng Lịch sử Máy tính, nhà khoa học trưởng của Nvidia, Bill Dally, đã dành lời khen ngợi cho bộ tiêu chuẩn InferenceX của SemiAnalysis vì khả năng cung cấp chính xác những dữ liệu mà thị trường đang thực sự quan tâm.
DeepSeek V4.1 Flash đang cho thấy hiệu suất, tốc độ và chi phí tối ưu hơn hẳn bản V4 Pro. Việc duy trì một mô hình cũ với chi phí cao hơn và hiệu năng thấp hơn đang đặt ra dấu hỏi lớn về chiến lược sản phẩm của DeepSeek.
OpenAI GPT-5.6 models and Anthropic Claude 5 models have different pricing structures at long contex…
DịchNghiên cứu từ Epoch AI cho thấy độ trễ phản hồi từ đầu (TTFT) của GPT-5.6 tăng theo hàm bậc hai khi ngữ cảnh dài ra, trong khi dòng Claude 5 duy trì hiệu suất ổn định hơn với xu hướng tuyến tính.
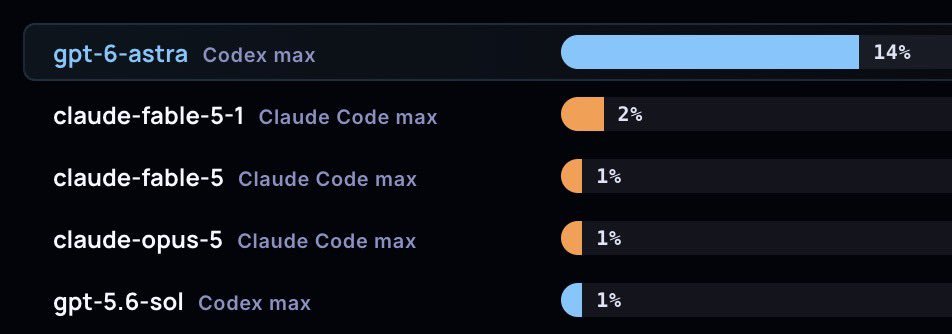
Big score by GPT-6 Astra, 14% on MazeBench without Python, 7X Claude Fable 5.1's 2%. MazeBench spec…
DịchGPT-6 Astra đạt 14% trong bài kiểm tra MazeBench (không dùng Python), vượt xa Claude Fable 5.1 và cả GPT-5.6 Sol, khẳng định bước tiến mới trong khả năng suy luận của AI.
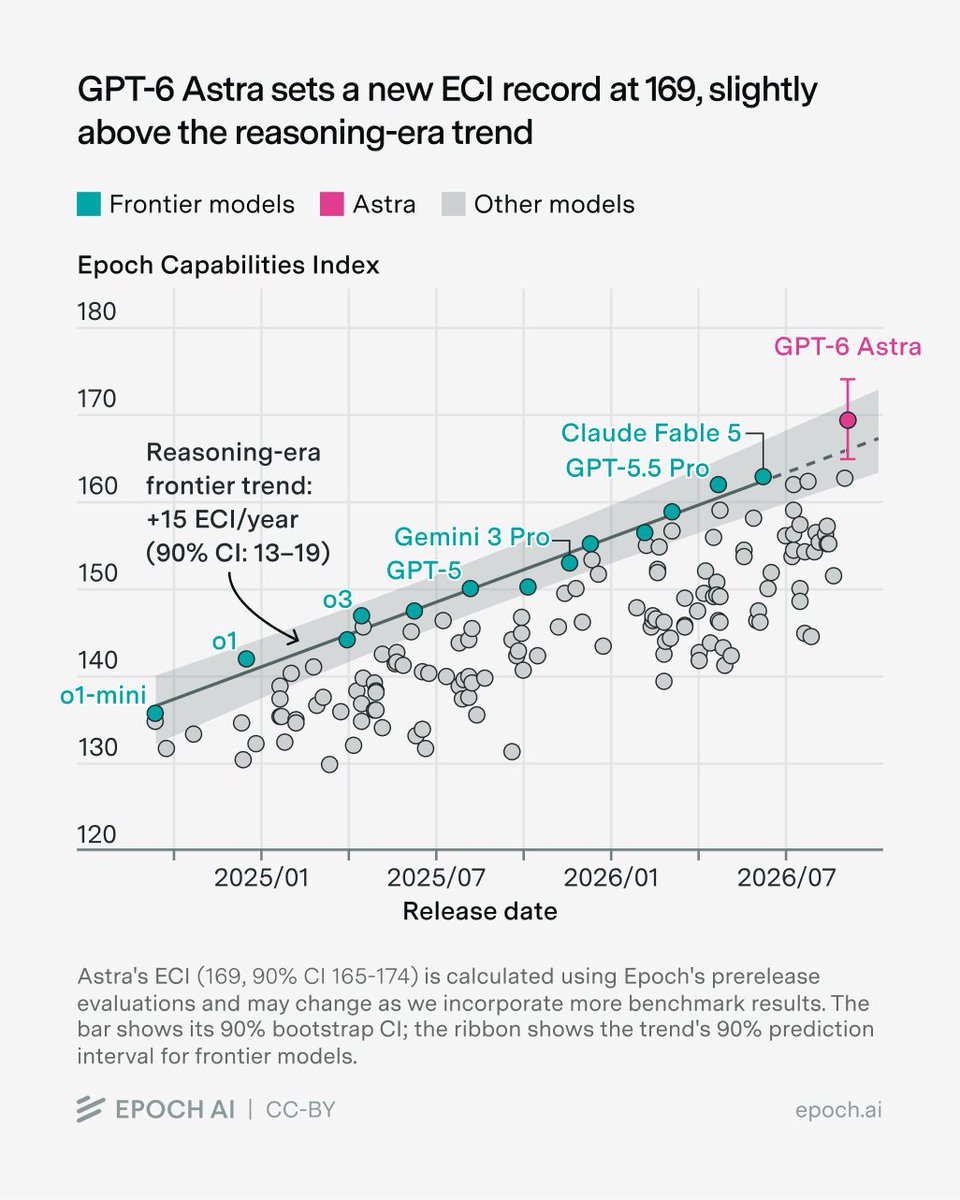
GPT-6 Astra hit a record 169 on Epoch AI's capability index, jumping 6 points past the previous ceil…
DịchGPT-6 Astra vừa đạt 169 điểm trên thang đo ECI, vượt qua kỷ lục cũ là 163 điểm. Dù cho thấy bước tiến về năng lực, kết quả này vẫn nằm trong biên độ dự báo về xu hướng phát triển suy luận của AI.
Next year frontier models are going to one shot everything 100x faster & cheaper than they are …
DịchCựu CEO Stability AI dự đoán các mô hình tiên tiến sẽ sớm đạt hiệu suất vượt trội, thực hiện mọi tác vụ chỉ trong một lần xử lý với chi phí và tốc độ tối ưu gấp 100 lần hiện tại.
GPT-6 Astra has set a new ECI record, with a score of 169. This is a substantial jump from the prior…
DịchGPT-6 Astra vừa xác lập kỷ lục ECI mới với 169 điểm, vượt qua mức 163 điểm trước đó. Mô hình này cũng đạt thành tích ấn tượng trong các bài kiểm tra về toán học, lập trình và tư duy logic, khẳng định bước tiến đáng kể trong năng lực suy luận của AI.
DịchAlexandr Wang, nhà sáng lập Scale AI, vừa chia sẻ biểu đồ cho thấy mô hình Muse Spark 1.3 đạt hiệu suất vượt trội trên đường biên Pareto của Artificial Analysis, khẳng định vị thế cạnh tranh mạnh mẽ trong lĩnh vực AI.
François Chollet vừa chia sẻ bảng so sánh tốc độ xử lý của các mô hình AI hàng đầu, trong đó ông đặc biệt nhấn mạnh đến vai trò và hiệu suất của chip TPU.
DịchNhà sáng lập Scale AI chia sẻ bài kiểm tra cho thấy Muse Spark 1.3 hoàn thành tác vụ chỉ trong 1 phút với chi phí gần như bằng 0, trong khi Fable 5.1 mất tới 70 phút và tốn 13 USD cho cùng một yêu cầu.
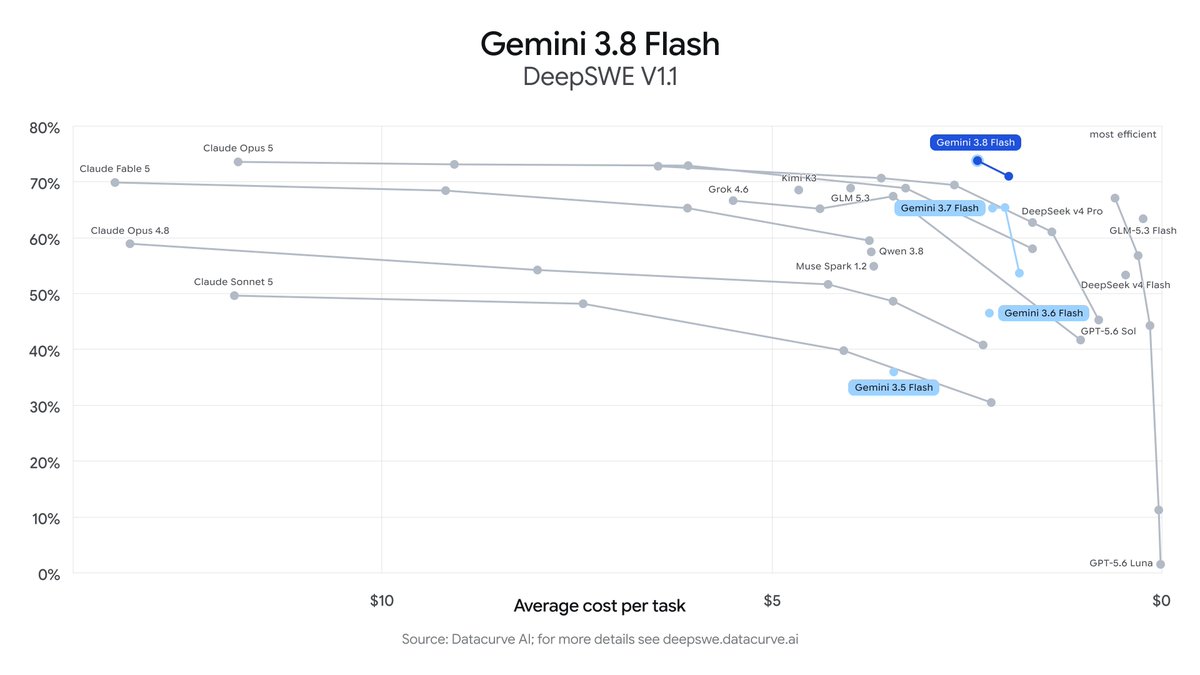
DịchGemini 3.8 Flash ghi dấu ấn với 73,7% điểm số trên DeepSWE V1.1, khẳng định hiệu suất vượt trội về chi phí trên mỗi tác vụ theo dữ liệu từ Datacurve AI.
GLM-5.3 at 310 tok/s! Databricks inference is #1 in both speed and latency, again. On our internal…
DịchTheo đánh giá từ Yuchen Jin, GLM-5.3 trên nền tảng Databricks đạt tốc độ 310 tok/s với độ trễ cực thấp, vượt trội so với các đối thủ. Mô hình này cũng được đánh giá là mã nguồn mở mạnh nhất về khả năng lập trình, cạnh tranh trực tiếp với Fable 5 và Opus 4.8.
Fable 5.1 benchmarls are insane. Ngl, i did not expect such jumps. Terminal-Bench 4.0, Science-Ben…
DịchKOL @kimmonismus chia sẻ kết quả benchmark ấn tượng của Fable 5.1 trên các nền tảng như Terminal-Bench 4.0 và HLE, vượt xa các đối thủ như Opus 5 và GPT-5.6 Sol, tạo áp lực lớn lên OpenAI và Astra.
OpenClaw 2.0 vs Hermes experiment by @atomicbot_ai is a good example of why the model alone tells yo…
DịchThử nghiệm từ Rohan Paul cho thấy OpenClaw 2.0 và Hermes Agent có sự khác biệt rõ rệt về cơ chế tự kiểm tra và tối ưu hóa tài nguyên khi thực hiện tác vụ tạo kịch bản phim trên GLM 5.3.
Baseten đã cắt giảm thành công 42,3% độ trễ cho Qwen-Image và 15,2% cho FLUX.2 bằng cách kết hợp SGLang với kiến trúc B300, đồng thời tự động hóa quy trình tối ưu hóa trong môi trường sản xuất.
Agnes AI's Agnes 2.5 Pro Beta scores 49 on the Artificial Analysis Intelligence Index, up 9 points f…
DịchPhiên bản Agnes 2.5 Pro Beta ghi nhận bước tiến lớn với chỉ số thông minh đạt 49 điểm, nhờ khả năng tác vụ tự hành (Agentic) cải thiện vượt bậc, dù tiêu tốn gấp đôi lượng token so với bản tiền nhiệm.
GLM-5.3-Flash scores 57 on the Artificial Analysis Intelligence Index. At $0.09 Cost per Task, it si…
Dịchvừa trình làng GLM-5.3-Flash với 320B tham số, đạt 57 điểm trên bảng xếp hạng Artificial Analysis. Mô hình này gây ấn tượng mạnh khi sở hữu hiệu năng ngang ngửa các đối thủ lớn như GPT-5.6 Terra nhưng với chi phí vận hành tối ưu hơn.
Artificial Analysis và Liquid AI vừa giới thiệu bộ công cụ đo hiệu năng AI chuyên dụng cho di động, thử nghiệm trên các mô hình 4-bit dưới 8GB chạy trực tiếp trên iPhone 17 Pro.
Fable 5 vừa thiết lập kỷ lục mới trên bảng xếp hạng NanoGPT khi đạt tỷ lệ thành công 81,7% chỉ trong 2.726 giây, vượt xa các đối thủ như Opus 5 và Kimi K3.
Another fantastic evening at our latest Inference, Measured event in San Francisco. We explored how …
DịchTại sự kiện Inference, Measured, Artificial Analysis đã công bố Chỉ số Độ chính xác Endpoint, đánh giá các nhà cung cấp AI dựa trên ba tiêu chí so với mô hình tự lưu trữ. Kết quả cho thấy các yếu tố kỹ thuật như nén KV-cache và giới hạn ngữ cảnh ảnh hưởng đáng kể đến chất lượng thực tế.
Last week we launched Optima, a new platform for benchmarking models on your own workloads and compa…
DịchNền tảng Optima mới cho phép người dùng tự chạy các bài kiểm tra hiệu năng trên chính khối lượng công việc của mình, giúp so sánh chính xác tốc độ, chi phí và chất lượng giữa các mô hình AI.
DeepSeek V4 Pro 0813 scores 53 on the Artificial Analysis Intelligence Index, 8 points above April's…
DịchDeepSeek vừa trình làng mô hình flagship V4 Pro 0813 với điểm số 53 trên Artificial Analysis, chỉ nhỉnh hơn phiên bản V4 Flash 0731 đúng 1 điểm dù mức giá tăng vọt.
 Arena@arena