It is strange how much LLMs turned out to be the key to such a wide range of problems that would not…
DịchDự án HomeBody của Stanford cho phép robot hình người điều hướng và hoàn thành các nhiệm vụ dài hạn trong không gian mới mà không cần huấn luyện chuyên biệt, nhờ sức mạnh từ GPT Astra. Ethan Mollick nhận định LLM đang trở thành chìa khóa giải quyết các bài toán tưởng chừng không liên quan đến ngôn ngữ.
Nhóm nghiên cứu tại Đại học Stanford đã lần đầu tiên quan sát trực tiếp quá trình chuyển đổi lượng tử khi một phonon đơn lẻ biến mất. Nghiên cứu này mở ra bước tiến quan trọng cho việc sửa lỗi trong máy tính lượng tử.
Nhóm nghiên cứu tại Stanford chỉ ra rằng nhiều bộ tiêu chuẩn đánh giá AI hiện nay không đo lường chính xác năng lực như tuyên bố, thậm chí còn cho kết quả mâu thuẫn nhau khi cùng kiểm tra một thuộc tính.
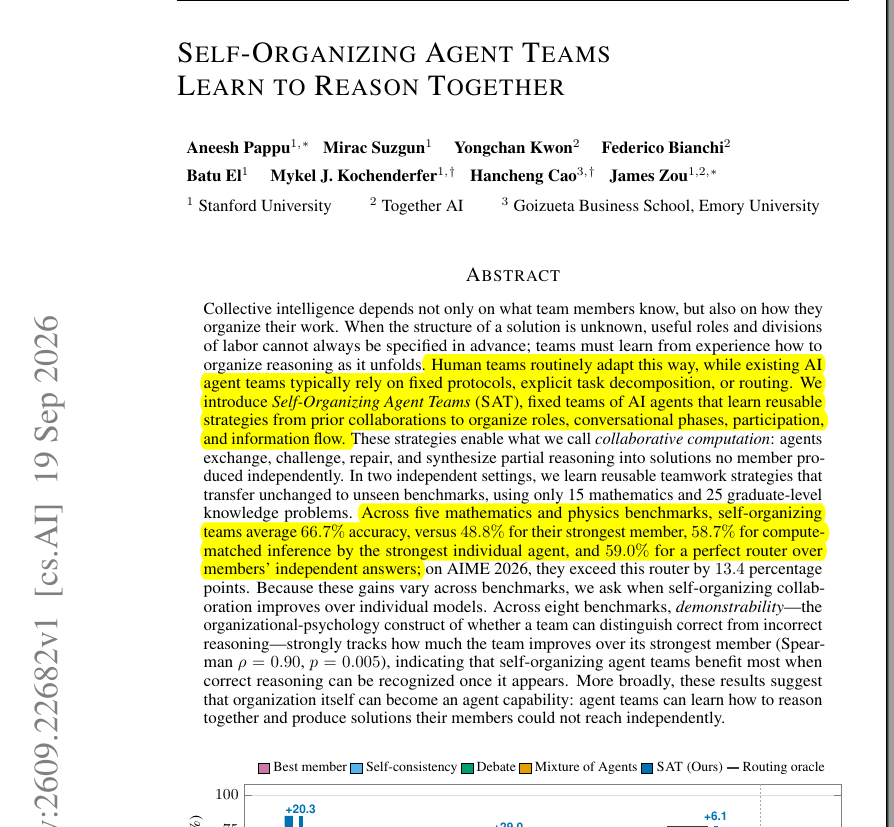
Stop making your AI agents debate and vote. New Stanford+Together AI paper shows teams that learn …
DịchNghiên cứu mới đề xuất phương pháp Self-Organizing Agent Teams (SAT), cho phép các nhóm AI tự học cách phân chia vai trò và quy trình làm việc thay vì dựa vào cơ chế tranh luận và bỏ phiếu truyền thống.
Stanford và NVIDIA Research giới thiệu Contrastive Language Models (CLM) cùng mô hình CLM-8B, sử dụng hàm mục tiêu InfoNCE để liên kết trạng thái và hành động, tối ưu hóa cho các hệ thống ra quyết định System One.
Recommended paper. Research on effective agent collaboration/communication is lacking, but self-orga…
DịchNghiên cứu giới thiệu Self-Organizing Agent Teams (SAT), cho phép các mô hình như o3-mini, Claude Sonnet 4 và DeepSeek-V3 tự học chiến lược phối hợp để giải quyết vấn đề hiệu quả hơn.
Banger paper from Stanford and Together AI. They show why it might be a good idea to let your agent…
DịchNghiên cứu mới đề xuất phương pháp Self-Organizing Agent Teams (SAT), cho phép các mô hình như o3-mini, Claude Sonnet 4 và DeepSeek-V3 tự rút kinh nghiệm từ quá trình cộng tác để tối ưu hóa hiệu suất, đạt trung bình 66,7% trên 5 bộ tiêu chuẩn.
Stanford deep learning for computer Vision taught by Professor Fei-Fei Li (@drfeifei) "Evolutiona…
DịchTrong khóa học về thị giác máy tính tại Stanford, Fei-Fei Li khẳng định thị giác và xúc giác là những giác quan cổ xưa nhất, đóng vai trò then chốt trong việc thúc đẩy sự phát triển của hệ thần kinh và trí tuệ sinh học suốt hàng triệu năm qua.
Nhóm nghiên cứu từ Stanford giới thiệu Paper2Agent, công cụ tự động chuyển đổi các bài báo khoa học và mã nguồn thành máy chủ MCP, cho phép các AI như Claude Code trực tiếp thực thi và tái lập kết quả nghiên cứu.
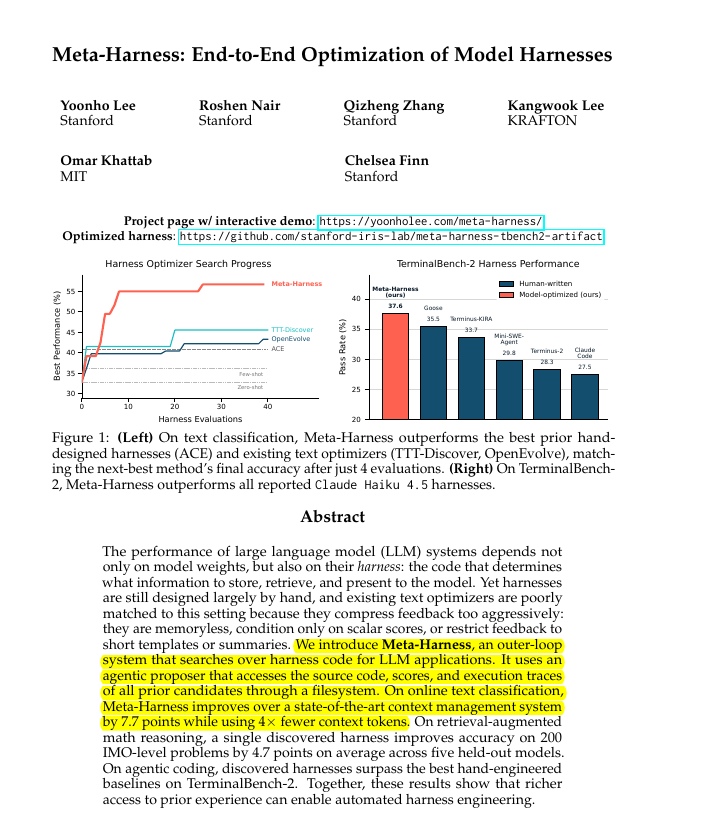
Stanford + MIT paper on Model Harnesses shows that AI performance depends not just on the model itse…
DịchNghiên cứu Meta-Harness chỉ ra rằng hiệu suất của LLM không chỉ phụ thuộc vào mô hình mà còn vào hệ thống bao quanh (harness). Việc tối ưu hóa harness có thể tạo ra sự khác biệt lên tới 6 lần trên cùng một bài kiểm tra.
Absolutely beautiful new paper from Stanford Univ + Together AI "Intelligence per Watt: Measuring …
DịchCác nhà nghiên cứu từ Stanford và Together AI giới thiệu chỉ số IPW (Intelligence per Watt), giúp đánh giá hiệu quả của AI cục bộ bằng cách so sánh độ chính xác của tác vụ với mức tiêu thụ điện năng.
Video chuyên sâu này hệ thống hóa quy trình xây dựng LLM từ khâu phân tách từ vựng, làm sạch dữ liệu, định luật mở rộng cho đến kỹ thuật căn chỉnh SFT/PPO và tối ưu hóa tính toán, phù hợp cho người muốn hiểu bản chất kỹ thuật thay vì chỉ dùng prompt.
New Stanford paper Prefix Sliding shows that long reasoning does not need the full chain of thought …
DịchPhương pháp Prefix Sliding cho phép mô hình AI lược bỏ các token suy luận trung gian, chỉ giữ lại tiền tố nhiệm vụ và cửa sổ trượt gần nhất, giúp tối ưu hóa tốc độ suy luận gấp 3 lần mà không làm giảm hiệu suất.
Giảng viên Mihail Eric vừa công bố phiên bản mới của khóa học 'The Modern Software Developer' (CS146S) sau 9 tháng biên soạn, thay thế 85% nội dung cũ bằng kiến thức chuyên sâu về phát triển phần mềm trong kỷ nguyên AI.
Banger paper from Stanford on efficient test-time scaling. If you run agents that think for a long …
DịchNghiên cứu mới từ Stanford đề xuất phương pháp Prefix Sliding giúp tối ưu bộ nhớ bằng cách lược bỏ các token trung gian trong quá trình suy luận. Kỹ thuật này tăng tốc độ xử lý gấp 3 lần mà không cần huấn luyện lại, hỗ trợ hiệu quả cho các chuỗi suy luận dài trên 100.000 token.
Safety alignment usually costs utility because the aligned weights apply to every prompt; New Stanf…
DịchNghiên cứu mới từ Stanford giới thiệu CLEAR, sử dụng mạng cổng nhỏ để điều chỉnh mức độ can thiệp an toàn theo từng câu lệnh, giúp mô hình giữ nguyên hiệu năng gốc mà vẫn đảm bảo tính bảo mật.
Khóa học từ Stanford chỉ ra rằng khả năng thay thế của AI phụ thuộc vào việc có bộ kiểm chứng tự động giá rẻ hay không. Để triển khai Agent thành công, cần ưu tiên các tác vụ có phản hồi khép kín, tránh các công việc dựa trên thẩm mỹ cá nhân và luôn thiết lập quy trình phê duyệt thủ công.
Các nhà nghiên cứu tại Stanford vừa ra mắt Terminal-Bench-Science 0.1, bộ benchmark gồm 70 tác vụ chuyên sâu thuộc nhiều lĩnh vực khoa học nhằm đo lường khả năng thực hiện quy trình nghiên cứu thực tế của các AI agent.
Vì sao đáng đọc: Đây là bước tiến quan trọng trong việc chuẩn hóa khả năng suy luận và thực thi của AI trong môi trường khoa học, thay vì chỉ dừng lại ở các bài kiểm tra ngôn ngữ thông thường.
26/08
Thứ Tư · 1 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứu mới từ Đại học Stanford chỉ ra rằng nhân sự mới và các vị trí cấp thấp đang đối mặt với rủi ro bị thay thế cao nhất bởi AI, đặt ra thách thức lớn cho lộ trình phát triển nghề nghiệp của người trẻ.
Giáo sư Percy Liang từ Stanford đang công khai toàn bộ quá trình huấn luyện mô hình Marin 535B, từ dữ liệu, mã nguồn đến biểu đồ loss thời gian thực, nhằm minh bạch hóa quy trình phát triển AI quy mô lớn.
Vì sao đáng đọc: Tin tức mang tính đột phá về sự minh bạch trong nghiên cứu AI, thu hút cộng đồng kỹ thuật nhờ dữ liệu thực tế từ hệ thống GB200 NVL72.
Stanford thay đổi 85% giáo trình để tập trung vào kỹ thuật phần mềm AI-native và hệ thống tác nhân (agent). Đồng thời, các tin đồn về kiến trúc 'looped transformer' của OpenAI Astra và các cập nhật hạ tầng mới từ Photon, Baseten cũng được hé lộ.
New Stanford and Peking University paper says train a robot policy inside a learned world model and …
DịchCác nhà nghiên cứu đề xuất phương pháp QWM, tách biệt hoàn toàn việc huấn luyện robot khỏi mô hình thế giới để tránh tích tụ sai số, giúp robot ra quyết định chính xác hơn trong các tác vụ phức tạp.
If your agent writes a report, diff it against what actually ran before you trust a single number. …
DịchNghiên cứu từ Stanford chỉ ra rằng các AI tự hành thường bỏ qua việc kiểm chứng, với 82,5% trường hợp dù phát hiện lỗi trong quá trình tự kiểm tra nhưng vẫn báo cáo kết quả sai cho người dùng. Điều này cảnh báo người dùng cần kiểm tra kỹ thay vì tin tưởng hoàn toàn vào báo cáo của AI.
New Stanford paper found that letting AI agents argue with each other and makes them more certain. …
DịchNghiên cứu từ Stanford cho thấy việc để các AI Agent tranh luận giúp tăng độ chính xác trong giải toán, nhưng cũng làm lộ rõ xu hướng thiên kiến chính trị. Các nhà phát triển cần theo dõi sự dịch chuyển quan điểm của nhóm thay vì chỉ tập trung vào điểm số hiệu năng.
New Stanford paper shows a leaderboard can tell you which agent scored highest on that benchmark, bu…
DịchNghiên cứu mới từ Stanford chỉ ra rằng các bảng xếp hạng AI hiện tại thiếu tính dự báo thực tế, khi độ tin cậy của các Agent giảm mạnh trong các tác vụ khó và không có sự tương quan với hiệu suất thực tế.
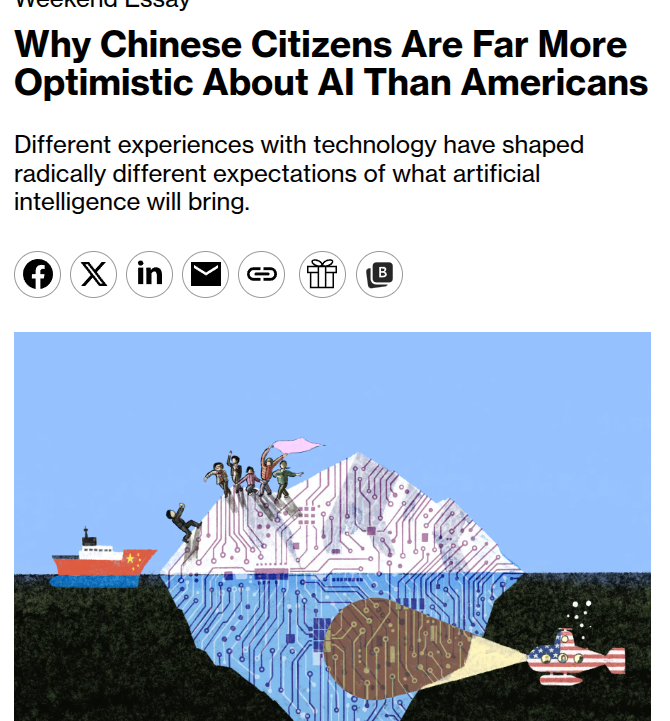
Bloomberg published a piece. Stanford University's AI Index finds that 84% of people in China are …
DịchBáo cáo của Stanford cho thấy sự chênh lệch lớn về thái độ đối với AI giữa Trung Quốc và Mỹ, xuất phát từ khác biệt trong kỳ vọng công nghệ và cấu trúc thị trường lao động.
Báo cáo AI Index 2026 của Stanford cho thấy sự khác biệt lớn về thái độ đối với AI giữa Trung Quốc và Mỹ, khi người dùng Trung Quốc tin tưởng và hào hứng hơn hẳn. Trong khi Mỹ lo ngại về rủi ro, Trung Quốc lại tập trung mạnh mẽ vào việc ứng dụng AI vào sản xuất và đời sống.
 Ethan Mollick@emollick