⚡️ As LLM reinforcement learning scales to larger GPU clusters and more training data, training effi…
DịchNghiên cứu từ Tencent Hunyuan cho thấy việc điều chỉnh learning rate giúp tăng hiệu suất huấn luyện GRPO và PPO, giúp tăng tốc độ xử lý lên 2,29 lần và tiết kiệm 29% thời gian huấn luyện.
⚡️ As LLM reinforcement learning scales to larger GPU clusters and more training data, training effi…
DịchNhóm nghiên cứu Tencent Hunyuan tối ưu hóa học tăng cường cho LLM bằng cách mở rộng kích thước batch, giúp tăng tốc độ xử lý của PPO lên 2,29 lần và rút ngắn 29% thời gian huấn luyện GRPO mà vẫn đảm bảo hiệu suất.
Real-world app requests don't come as perfect specs. Congrats to the @TencentHunyuan team on WebCraf…
DịchWebCraftBench của Tencent Hunyuan sử dụng 369 yêu cầu thực tế từ người dùng để kiểm tra khả năng xây dựng ứng dụng của AI, với độ chính xác khớp với đánh giá của con người lên tới 85,3%.
DịchĐội ngũ Tencent Hunyuan đã nén mô hình Hy4 preview từ 1,5TB xuống còn 214 GiB mà vẫn giữ nguyên 770 tỷ tham số nhờ thuật toán Sherry và định dạng STQ1_0, đạt mức trung bình 2,38 bit mỗi trọng số.
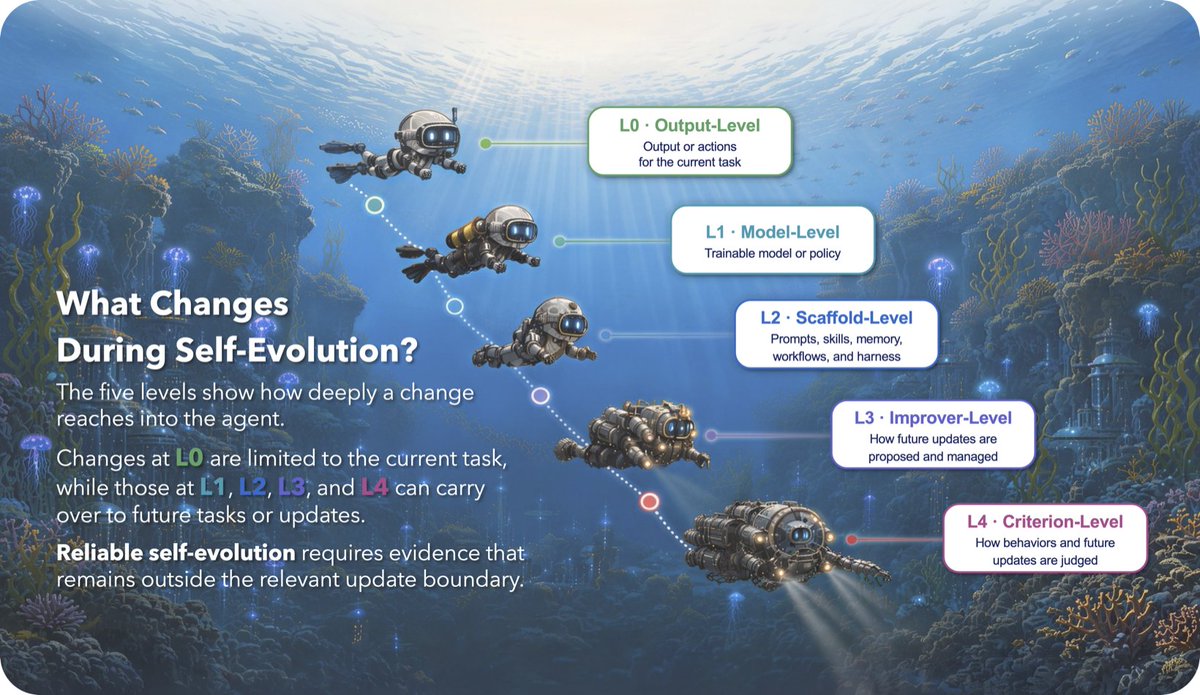
📄New Research on Self-Evolving Agents: When AI agents modify themselves, how do we know they actual…
DịchTencent Hunyuan vừa ra mắt báo cáo chuyên sâu về cơ chế tự tiến hóa của tác nhân AI, đề xuất hệ thống phân cấp L0-L4 và khung đánh giá độ tin cậy. Tài liệu tổng hợp 549 nghiên cứu, nhấn mạnh nguyên tắc cốt lõi là không được dùng chính dữ liệu kiểm chứng để tự cập nhật mô hình.
 Tencent Hunyuan@TencentHunyuan