Hôm qua · 27/09

Chủ Nhật · 1 tin
OpenAI Developers@OpenAIDevs
Mô hìnhĐiểm AI 33/100

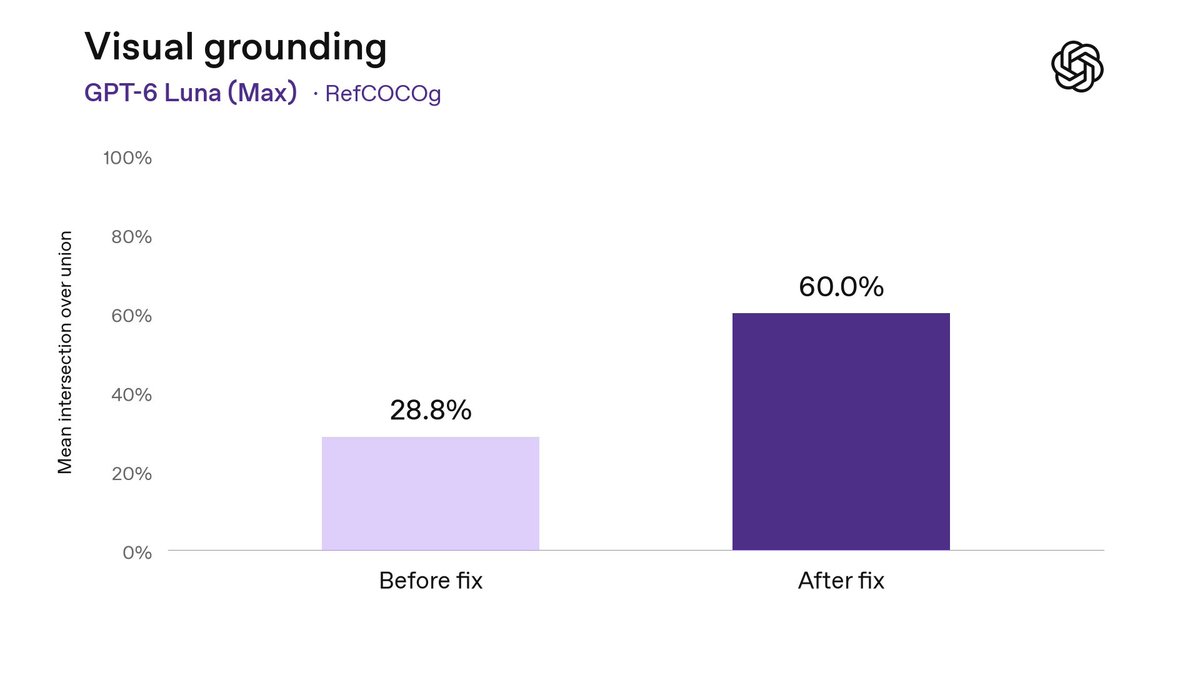
Cùng sự kiệnOpenAI khắc phục lỗi suy giảm khả năng hiểu hình ảnh trên GPT-6 Sol và GPT-6 Luna

We've fixed a bug that was degrading image understanding in GPT-6 Sol and GPT-6 Luna. You should now…

DịchOpenAI đã sửa lỗi kỹ thuật gây ảnh hưởng đến khả năng xử lý hình ảnh trên GPT-6 Sol và GPT-6 Luna. Người dùng hiện có thể trải nghiệm kết quả chính xác hơn trong các tác vụ thị giác qua API, Codex và tính năng computer use.
Cùng sự kiện, tinh chọn hiển thị «Arena ra mắt thử nghiệm GPT-6 Sol và GPT-6 Luna, chuẩn bị công bố bảng xếp hạng»

25/09

Thứ Sáu · 1 tin
JiQiZhiXin
Mô hìnhĐiểm AI 88/100

Tinh chọnKwaiMind: Mô hình AI chỉnh sửa ảnh thương mại điện tử thấu hiểu tâm lý người dùng

KwaiMind là mô hình nền tảng từ Kuaishou giúp tối ưu hóa hình ảnh sản phẩm thương mại điện tử, hỗ trợ chỉnh sửa chi tiết, thay đổi bối cảnh và tăng tỷ lệ nhấp chuột thực tế lên 2,44%.


Vì sao đáng đọc: Tin tức chuyên sâu về ứng dụng AI thực tế trong thương mại điện tử với số liệu kiểm chứng cụ thể, có giá trị cao cho người làm kinh doanh và kỹ thuật.

23/09

Thứ Tư · 1 tin
QbitAI
Mô hìnhĐiểm AI 88/100

Tinh chọnĐột phá mới: Dạy robot làm việc qua video với 120 tỷ token hành động con người

Các nhà nghiên cứu tận dụng kho dữ liệu video khổng lồ từ internet để huấn luyện robot, giúp sai số giảm dần theo quy luật lũy thừa khi quy mô dữ liệu tăng lên.


Vì sao đáng đọc: Công nghệ huấn luyện robot từ video thực tế là xu hướng then chốt, có tính ứng dụng cao và mở ra hướng đi mới cho robot tự hành.

22/09

Thứ Ba · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnTại sao mô hình tạo video lại 'phi vật lý'? Giải mã lỗi từ cơ chế Attention

Nghiên cứu chỉ ra rằng các mô hình tạo video hiện nay thường vi phạm quy luật vật lý do lỗi trong cơ chế Attention và sự suy giảm không gian từ RoPE, dẫn đến việc định hình chuyển động sai lệch ngay từ giai đoạn khử nhiễu đầu tiên.


Vì sao đáng đọc: Nghiên cứu chuyên sâu, giải quyết vấn đề cốt lõi của AI tạo video hiện nay. Nội dung có tính học thuật cao, rất hữu ích cho các kỹ sư và nhà nghiên cứu AI.

21/09

Thứ Hai · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

OmniVBench: Bộ dữ liệu và chuẩn đánh giá toàn diện cho thế hệ mô hình tạo video từ tham chiếu

OmniVBench giải quyết hạn chế của các chuẩn đánh giá cũ bằng cách cung cấp bộ dữ liệu quy mô lớn và giao thức kiểm tra chi tiết cho các mô hình tạo video từ tham chiếu (R2V), giúp tối ưu hóa khả năng kiểm soát nội dung và chuyển động.

12/09

Thứ Bảy · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Giải mã Image Tokenizer: Ngôn ngữ thị giác trong các mô hình đa phương thức hợp nhất

Nghiên cứu này đề xuất phương pháp đánh giá mới cho Image Tokenizer thông qua việc theo dõi tổn thất (loss) trong quá trình huấn luyện đa phương thức, giúp hiểu rõ cách các token thị giác và văn bản tương tác để tối ưu hóa hiệu suất mô hình.

11/09

Thứ Sáu · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

TempCloze: Thử thách khả năng suy luận thời gian trong video cho các mô hình AI

TempCloze là bộ tiêu chuẩn đánh giá mới giúp kiểm tra khả năng hiểu trình tự thời gian của Video-LLM bằng cách yêu cầu mô hình chọn đoạn video bị thiếu ở giữa. Nghiên cứu chỉ ra rằng các mô hình hiện nay vẫn gặp khó khăn lớn trong việc nắm bắt sự liên kết và tiến trình của các sự kiện.

10/09

Thứ Năm · 1 tin

09/09

Thứ Tư · 4 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ReactVAU: Khung làm việc tách biệt nhanh-chậm giúp phát hiện bất thường trong video trực tuyến

ReactVAU giải quyết bài toán giám sát thời gian thực bằng cách kết hợp mô-đun phát hiện nhanh để lọc dữ liệu và mô-đun suy luận chuyên sâu chỉ kích hoạt khi có sự kiện nghi vấn, giúp tối ưu hóa hiệu suất mà vẫn đảm bảo tính chính xác.

08/09

Thứ Ba · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

KnowChange: Tổng hợp dữ liệu thay đổi trong ảnh viễn thám dựa trên tri thức thực tế

KnowChange là khung tổng hợp dữ liệu mới sử dụng mô hình ngôn ngữ-hình ảnh để mô phỏng các thay đổi trong ảnh viễn thám một cách linh hoạt, giúp cải thiện hiệu suất cho các mô hình phát hiện thay đổi mà không cần quy tắc thủ công.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnLLaDA-Image: Đột phá mô hình tạo ảnh từ văn bản không cần tiền huấn luyện cặp ảnh-chữ

LLaDA-Image là mô hình Diffusion Transformer 6B mới, ưu tiên học cấu trúc hình ảnh trước khi thực hiện căn chỉnh ngôn ngữ, giúp đạt hiệu suất dẫn đầu trên bảng xếp hạng Qwen-Image-Bench.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong kiến trúc tạo ảnh, thay đổi tư duy huấn luyện truyền thống bằng cách tách biệt việc học hình ảnh và ngôn ngữ, có tính ứng dụng và tham khảo cao.

07/09

Thứ Hai · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnUniMate: Mô hình hợp nhất tạo chuyển động cho mọi cấu trúc xương 3D

UniMate là mô hình nền tảng đột phá cho phép tạo chuyển động từ văn bản cho bất kỳ cấu trúc xương 3D nào mà không cần tinh chỉnh hay huấn luyện lại, nhờ cơ chế Transformer khuếch tán nhận diện cấu trúc liên kết.


Vì sao đáng đọc: Giải quyết bài toán khó trong đồ họa 3D bằng AI, loại bỏ rào cản về cấu trúc xương, có tiềm năng ứng dụng cao trong sản xuất game và phim ảnh.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnEditVid: Khung chỉnh sửa video thống nhất, không cần huấn luyện với độ chính xác vượt trội

EditVid là giải pháp đột phá cho phép chỉnh sửa video đa dạng từ thay đổi phong cách đến chèn đối tượng mà không cần huấn luyện lại mô hình, đạt hiệu suất vượt trội so với các phương pháp hiện có.


Vì sao đáng đọc: Đây là một bước tiến quan trọng trong lĩnh vực xử lý video bằng AI, giải quyết bài toán khó về tính nhất quán và đa năng mà không tốn tài nguyên huấn luyện.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnMotion-Omni: Mô hình đối thoại AI tạo lời nói và cử chỉ toàn thân đồng bộ

Motion-Omni là khung làm việc end-to-end cho phép mô hình đối thoại tạo ra lời nói cùng cử chỉ cơ thể (mặt, tay, dáng đi) trực tiếp từ trạng thái ẩn, thay vì phải xử lý tách biệt như các phương pháp truyền thống.


Vì sao đáng đọc: Giải quyết vấn đề đồng bộ hóa giữa lời nói và cử chỉ trong AI avatar, một bước tiến quan trọng cho tính chân thực của các trợ lý ảo tương lai.

06/09

Chủ Nhật · 1 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnTừ 'Nhìn thấy người' đến 'Hành động như người': Tổng quan toàn diện về AI lấy con người làm trung tâm trong kỷ nguyên mô hình nền tảng

Nhóm nghiên cứu từ ĐH Bách khoa Hồng Kông công bố bài tổng quan toàn diện về AI lấy con người làm trung tâm, phân loại các khả năng từ nhận diện, mô phỏng đến trí tuệ hiện thân trong kỷ nguyên mô hình nền tảng.


Vì sao đáng đọc: Bài viết cung cấp cái nhìn hệ thống, có chiều sâu về một lĩnh vực đang là xu hướng chủ đạo trong nghiên cứu AI, rất hữu ích cho giới học thuật và kỹ sư chuyên sâu.

05/09

Thứ Bảy · 2 tin
JiQiZhiXin
Mô hìnhĐiểm AI 88/100

Tinh chọnPhó chủ tịch Qualcomm: Tại sao AI tạo ảnh vẫn chưa đạt được độ kiểm soát chính xác?

Dù AI tạo ảnh đã rất ấn tượng về thị giác, nhưng vẫn gặp khó khăn trong việc duy trì danh tính nhân vật và bố cục phức tạp. Bài viết phân tích các giải pháp kỹ thuật mới từ Qualcomm nhằm giúp AI trở nên đáng tin cậy và có tính ứng dụng cao hơn trong công việc chuyên nghiệp.


Vì sao đáng đọc: Bài viết đi sâu vào các rào cản kỹ thuật thực tế của AI tạo ảnh, cung cấp góc nhìn chuyên môn từ lãnh đạo Qualcomm và giải pháp cụ thể (Disco), rất hữu ích cho người làm chuyên môn.
Viggle AI@ViggleAI
Mô hìnhĐiểm AI 33/100

Mô hình AI mới cho phép tạo hiệu ứng 'đóng băng thời gian' từ một video duy nhất sắp ra mắt

We're open-sourcing this model soon. Stay tuned!

DịchLấy cảm hứng từ Atlas của The World Labs, mô hình mới của @t_mux cho phép tái tạo góc quay mới từ video gốc, tạo hiệu ứng camera bay quanh chủ thể đang đứng yên. Dự án sẽ sớm mở mã nguồn và đang thu thập video từ cộng đồng để thử nghiệm.

03/09

Thứ Năm · 2 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnApple đột phá với IVT: Tư duy thị giác nội tại giúp tăng tốc suy luận video gấp 5 lần

Apple giới thiệu khung huấn luyện IVT, cho phép mô hình học cách dự đoán tương lai thông qua biểu diễn ẩn thay vì phải tạo ảnh trực tiếp, giúp tăng tốc độ suy luận video gấp 5 lần mà vẫn giữ được độ chính xác.


Vì sao đáng đọc: Nghiên cứu quan trọng từ Apple giải quyết bài toán tối ưu hóa suy luận video thời gian thực, có tính ứng dụng cao trong robot và trợ lý ảo.

02/09

Thứ Tư · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

RECAP-Forcing: Giải pháp duy trì tính nhất quán cho video dài bằng cách ưu tiên nội dung mới

Thay vì lưu trữ theo thời gian, RECAP-Forcing tối ưu hóa bộ nhớ bằng cách ưu tiên giữ lại các đối tượng và bối cảnh mới xuất hiện, giúp duy trì tính nhất quán hình ảnh trong các video dài mà không bị giới hạn bởi cửa sổ chú ý.

01/09

Thứ Ba · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ContextBias: Đánh giá sự tồn tại của định kiến trong mô hình chuyển văn bản thành hình ảnh

Nghiên cứu giới thiệu ContextBias, khung đánh giá mới nhằm kiểm tra xem các định kiến nghề nghiệp trong mô hình AI có thay đổi khi thay đổi ngữ cảnh hay không. Kết quả cho thấy các mô hình hiện nay vẫn duy trì định kiến mạnh mẽ ngay cả khi ngữ cảnh không liên quan.

31/08

Thứ Hai · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnCode-as-World: Dùng mã thực thi để mô phỏng và suy luận về thế giới vật lý

Nghiên cứu giới thiệu phương pháp biểu diễn thế giới vật lý thông qua mã thực thi, giúp AI hiểu sâu hơn về cơ chế vận hành, trạng thái vật thể và động lực học thay vì chỉ nhận diện hình ảnh đơn thuần.


Vì sao đáng đọc: Đây là hướng tiếp cận đột phá giúp AI vượt qua giới hạn của các mô hình thị giác ngôn ngữ hiện tại, tăng khả năng suy luận logic trong môi trường thực tế.

28/08

Thứ Sáu · 1 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnCode-as-World: Bước tiến mới giúp AI 'giải mã' thế giới vật lý từ video

Thay vì chỉ mô phỏng hình ảnh, khung làm việc Code-as-World cho phép AI tái tạo thế giới thực dưới dạng mã nguồn có thể thực thi và kiểm chứng, từ đó giúp máy móc hiểu sâu sắc các quy luật vật lý thay vì chỉ bắt chước bề nổi.


Vì sao đáng đọc: Đây là một hướng đi đột phá trong lĩnh vực AI vật lý, chuyển dịch từ việc tạo video đơn thuần sang tư duy logic và hiểu cơ chế vận hành của thế giới, có giá trị học thuật và ứng dụng cao.

27/08

Thứ Năm · 1 tin

25/08

Thứ Ba · 3 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 85/100

V-RAE: Bước tiến mới trong việc tối ưu hóa không gian tiềm ẩn cho mô hình tạo video

Các nhà nghiên cứu từ NUS và Oxford giới thiệu V-RAE, phương pháp sử dụng các mô hình thị giác tiền huấn luyện để xây dựng không gian tiềm ẩn giàu ngữ nghĩa, giúp cải thiện hiệu quả tạo và dự đoán video thay vì chỉ tập trung vào tái tạo pixel truyền thống.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Đột phá chỉnh sửa ảnh AI: Tối ưu hóa qua phân loại khái niệm và giám sát dày đặc

Nghiên cứu giới thiệu ConceptEdit-12M với 12 triệu cặp ảnh chỉnh sửa chất lượng cao, kết hợp chiến lược giám sát dày đặc giúp AI hiểu sâu hơn về các khái niệm chỉnh sửa tinh vi, khắc phục hạn chế của các mô hình khuếch tán hiện nay.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnTLive-Omni: Mô hình đa phương thức chuyên biệt cho livestream thương mại điện tử

TLive-Omni là mô hình AI đột phá giúp phân tích livestream bán hàng bằng cách hợp nhất dữ liệu từ video, âm thanh, hình ảnh và văn bản. Với cơ chế Per-vGrid và kỹ thuật tinh chỉnh Faithful-RFT, mô hình giúp AI hiểu ngữ cảnh và phản hồi chính xác các thông tin sản phẩm trong thời gian thực.


Vì sao đáng đọc: Đây là nghiên cứu thực tiễn cao, giải quyết bài toán khó trong livestream thương mại điện tử bằng cách kết hợp đa phương thức và tối ưu hóa độ chính xác của phản hồi.

24/08

Thứ Hai · 2 tin
AK@_akhaliq
Nghiên cứuĐiểm AI 25/100

InfinityEdit: Giải pháp chỉnh sửa video không giới hạn với bộ điều hợp siêu nhẹ

InfinityEdit Infinite Video Editing with a Lightweight Edit-Ignition Adapter paper: https://huggin...

DịchInfinityEdit giới thiệu phương pháp sử dụng bộ điều hợp (adapter) tinh gọn để thực hiện chỉnh sửa video không giới hạn, giúp tối ưu hóa quy trình xử lý hình ảnh chuyển động.

23/08

Chủ Nhật · 2 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Stanford và CMU đột phá: Tự động trích xuất mô hình tác vụ từ video ghi màn hình

New Stanford + Carnegie paper. Screen recordings of real work look like free training data for agen…

DịchPhương pháp Task Model Induction mới giúp chuyển đổi video thao tác thực tế thành cấu trúc mục tiêu phân cấp thay vì chuỗi hành động đơn thuần, giúp AI học kỹ năng mới hiệu quả hơn 30%.

karminski@karminski3
Hướng dẫnĐiểm AI 39/100

Cùng sự kiệnThử nghiệm thực tế khả năng đa phương thức của DeepSeek-V4-Flash-Vision và OX-Alpha

So sánh khả năng phân tích chiến thuật CS2 của DeepSeek-V4-Flash-Vision và OX-Alpha thông qua phương pháp trích xuất khung hình video, đánh giá độ chính xác trong việc nhận diện tình huống và đưa ra lời khuyên cải thiện.

Cùng sự kiện, bài đại diện «DeepSeek-V4-Flash-Vision-Exp ra mắt: Hiệu năng đa phương thức tiệm cận Opus-4.8»

22/08

Thứ Bảy · 1 tin

20/08

Thứ Năm · 2 tin
Testing Catalog@testingcatalog
Sản phẩmĐiểm AI 34/100

Humyn Labs ra mắt thư viện video góc nhìn thứ nhất cho AI vật lý

Humyn Labs opened an "egocentric" video library for physical AI! > 5 first-person datasets by en…

DịchHumyn Labs cung cấp bộ dữ liệu video góc nhìn thứ nhất với thông tin chi tiết về chuyển động tay và không gian, giúp huấn luyện robot học hỏi kỹ năng từ trải nghiệm thực tế của con người.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (53 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Computer Vision” | AIHOT.vn