Motion-Omni là khung làm việc end-to-end cho phép mô hình đối thoại tạo ra lời nói cùng cử chỉ cơ thể (mặt, tay, dáng đi) trực tiếp từ trạng thái ẩn, thay vì phải xử lý tách biệt như các phương pháp truyền thống.
Vì sao đáng đọc: Giải quyết vấn đề đồng bộ hóa giữa lời nói và cử chỉ trong AI avatar, một bước tiến quan trọng cho tính chân thực của các trợ lý ảo tương lai.
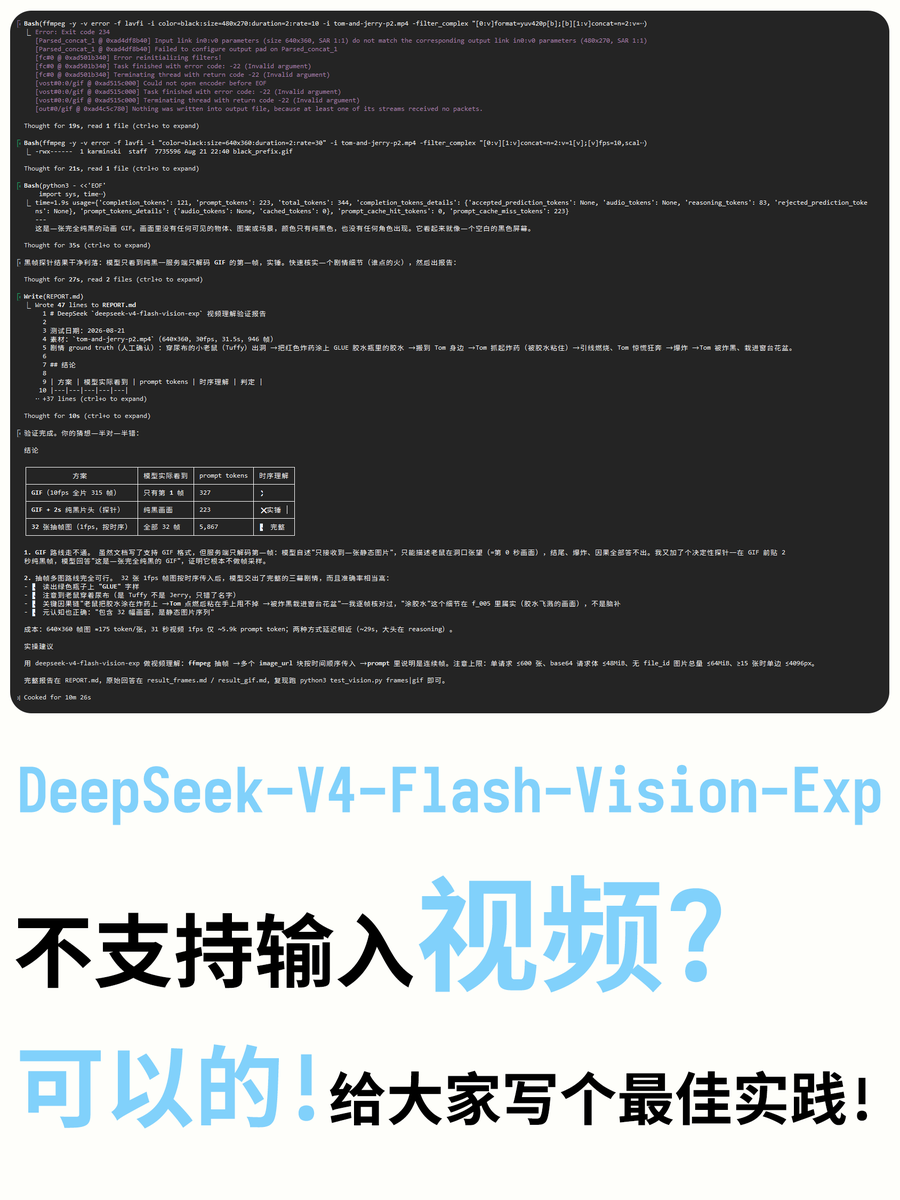
DeepSeek vừa ra mắt mô hình đa phương thức V4-Flash-Vision-Exp. Vì mô hình chưa hỗ trợ trực tiếp video và chỉ nhận diện khung hình đầu tiên của GIF, tác giả hướng dẫn cách trích xuất khung hình từ video để đạt hiệu quả phân tích tốt nhất.
IVT là phương pháp huấn luyện giúp mô hình AI dự đoán các khung hình tương lai mà không cần tạo ảnh trung gian, giúp tăng tốc độ xử lý video mà vẫn giữ được khả năng suy luận logic.
Vì sao đáng đọc: Giải quyết trực diện vấn đề độ trễ của Visual CoT trong xử lý video, một thách thức lớn trong thực tế. Phương pháp tiếp cận mới mẻ và có tính ứng dụng cao.
OpenRouter vừa cập nhật hướng dẫn sử dụng API để gửi hình ảnh tới các mô hình đa phương thức. Bạn có thể truyền dữ liệu qua URL công khai hoặc định dạng base64 trong mảng tin nhắn, hỗ trợ tốt các định dạng phổ biến như PNG, JPEG, WebP và GIF.
Going live now 🎙️ Join @MiniMax_AI × @fal for a deep dive into building with MiniMax H3-from multi…
DịchMiniMax và fal tổ chức livestream chia sẻ kỹ thuật thực tế khi sử dụng mô hình H3, từ xử lý đa phương thức, âm thanh gốc, chỉnh sửa đến triển khai LoRA và tối ưu hóa quy trình sản xuất.