SAS là phương pháp mới giúp tinh giản cơ chế Attention bằng cách tối ưu hóa trực tiếp việc chọn lọc token quan trọng, thay vì chỉ bắt chước phân phối trọng số của mô hình gốc, giúp sử dụng hiệu quả hơn ngân sách tính toán hạn chế.
Bài viết của Ma Bo giải thích tường tận mối liên hệ giữa Attention, Prefill, KV Cache và Prefix Caching, giúp bạn nắm vững nền tảng để hiểu sâu hơn về các kỹ thuật nâng cao như Multi-Head Latent Attention.
HyQuant tối ưu hóa hiệu suất LLM bằng cách kết hợp lượng tử hóa bit thấp cho hầu hết các trạng thái Attention, đồng thời giữ độ chính xác cao cho các vùng dữ liệu quan trọng, giúp giảm thiểu sai số mà vẫn đảm bảo tốc độ.
CRISP là phương pháp mới giúp tăng tốc giai đoạn tiền xử lý (prefilling) cho LLM bằng cách định tuyến thông minh dựa trên cấu trúc phân bổ trọng số attention, thay thế các cơ chế cũ kém hiệu quả.
So happy to see this new Microsoft paper. If lower inference memory is the goal, this paper finds t…
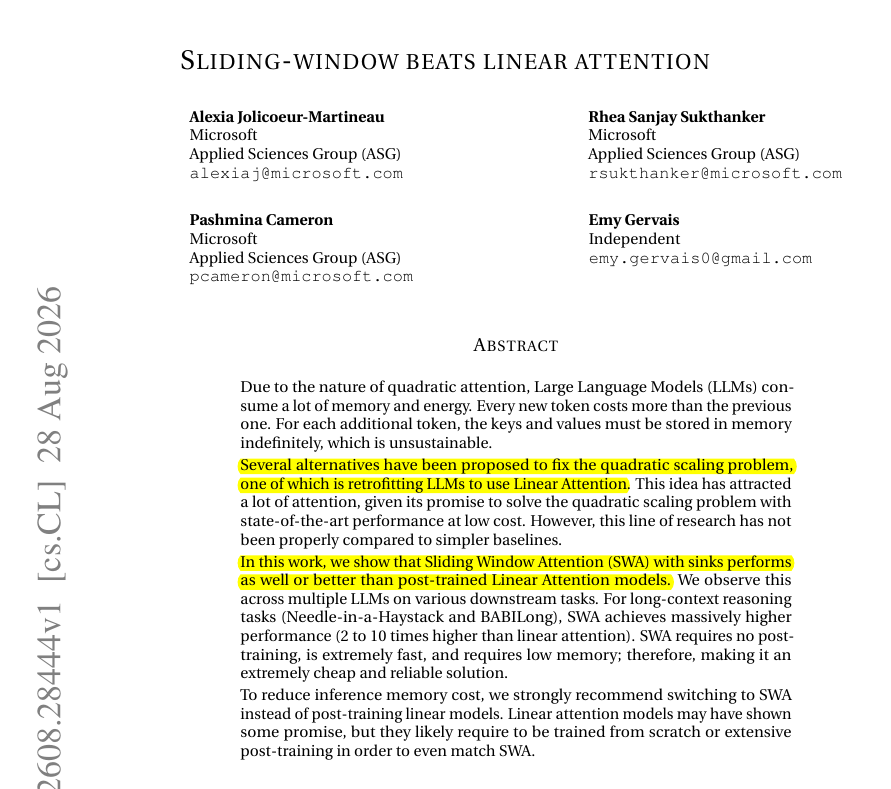
DịchNghiên cứu chỉ ra rằng Sliding-window attention (SWA) hiệu quả hơn hầu hết các phương pháp Linear attention khi tối ưu bộ nhớ suy luận, chỉ cần kết hợp cửa sổ nhỏ và 4 token 'sink' đầu tiên.
Nghiên cứu khám phá cách các mô hình ngôn ngữ truy xuất biến tiềm ẩn khi cần sử dụng linh hoạt. Kết quả cho thấy không có 'cổng kiểm soát' cố định nào, thay vào đó, nhu cầu tác vụ làm tăng khả năng hiển thị của khái niệm thông qua cơ chế Attention.