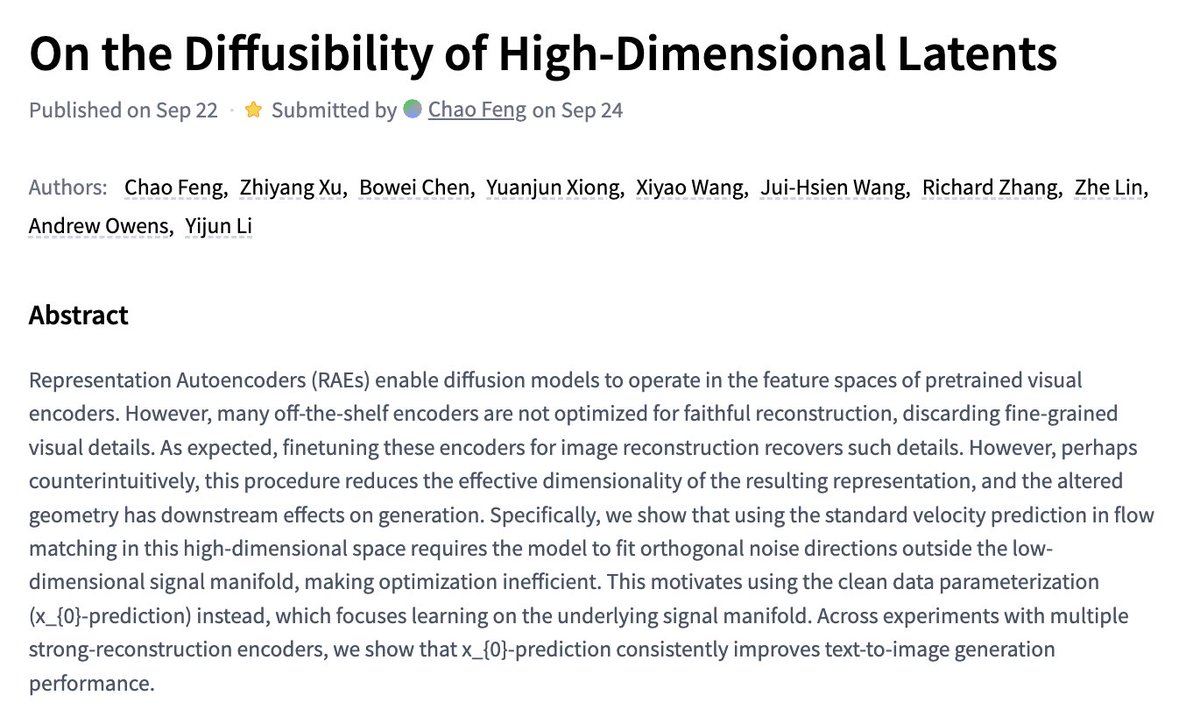
On the Diffusibility of High-Dimensional Latents paper: https://huggingface.co/papers/2609.28473
DịchBài báo khoa học này đi sâu phân tích cơ chế và tính khả thi của việc áp dụng mô hình khuếch tán (diffusion) trên các không gian biến tiềm ẩn có số chiều lớn, mở ra hướng đi mới cho việc tối ưu hóa kiến trúc mô hình tạo sinh.
Nghiên cứu khám phá cách hình học Fisher-Rao kết nối hành vi của các mô hình ngôn ngữ, cho thấy sự tương đồng về cấu trúc đầu ra giữa các kiến trúc khác nhau và khả năng chuyển đổi ngữ nghĩa hiệu quả.
Nghiên cứu giới thiệu Complex KDA (CKDA), kỹ thuật kết hợp biến đổi delta-rule với cơ chế cổng kênh để đạt được khả năng xoay 2D mà không cần tăng thứ hạng cập nhật, giúp nâng cao hiệu suất mô hình RNN.
MoME thay thế các bảng nhúng tĩnh bằng cơ chế hỗn hợp nhiều khe cắm, cho phép mô hình truy xuất thông tin linh hoạt dựa trên ngữ cảnh thay vì chỉ dựa vào từ khóa, giúp cải thiện hiệu suất đáng kể cho các dòng LLM như Llama-3 hay Qwen.
Fathom giới thiệu phương pháp đọc KV cache linh hoạt dựa trên ngân sách bit cho từng truy vấn, giúp tăng tốc độ giải mã lên 1,67 lần ở quy mô 1 triệu token mà vẫn duy trì độ chính xác cao hơn so với các kỹ thuật hiện có.
Bài viết phân tích kỹ thuật chuyên sâu về DeepSeek-V4.1-Flash, làm rõ cách thức CED và CSA2 tối ưu hóa bộ nhớ KV Cache, đồng thời đánh giá đây là bước nhảy vọt về kiến trúc tương đương thế hệ V5.
Nghiên cứu giới thiệu SpectralShift, phương pháp tối ưu hóa Gated DeltaNet bằng cách điều chỉnh các đặc tính phổ, giúp mô hình xử lý ngữ cảnh dài hiệu quả hơn mà không cần huấn luyện lại từ đầu.
Banger paper from Meta. This work shows that byte-level models start out behind token models and th…
DịchNghiên cứu từ Meta chỉ ra rằng dù ban đầu lép vế, các mô hình cấp byte sẽ vượt trội hơn mô hình token khi tăng tài nguyên tính toán, với dự báo hiệu suất dẫn trước tới 4% nhờ kỹ thuật chuyển đổi logit mới.
NCP-ArchPreview là mô hình 8.9B đột phá kết hợp dự đoán khái niệm và token tiếp theo, đạt hiệu suất tương đương mô hình 7B tiêu chuẩn chỉ với hơn một nửa lượng dữ liệu huấn luyện.
Bài viết giải thích cách tối ưu hóa LLM thông qua Prefill, lưu trữ KV cache và cơ chế Prefix Caching. Tác giả sử dụng ví dụ thực tế về truy vấn tài liệu để làm rõ giới hạn của việc tái sử dụng bộ nhớ đệm khi đầu vào thay đổi.
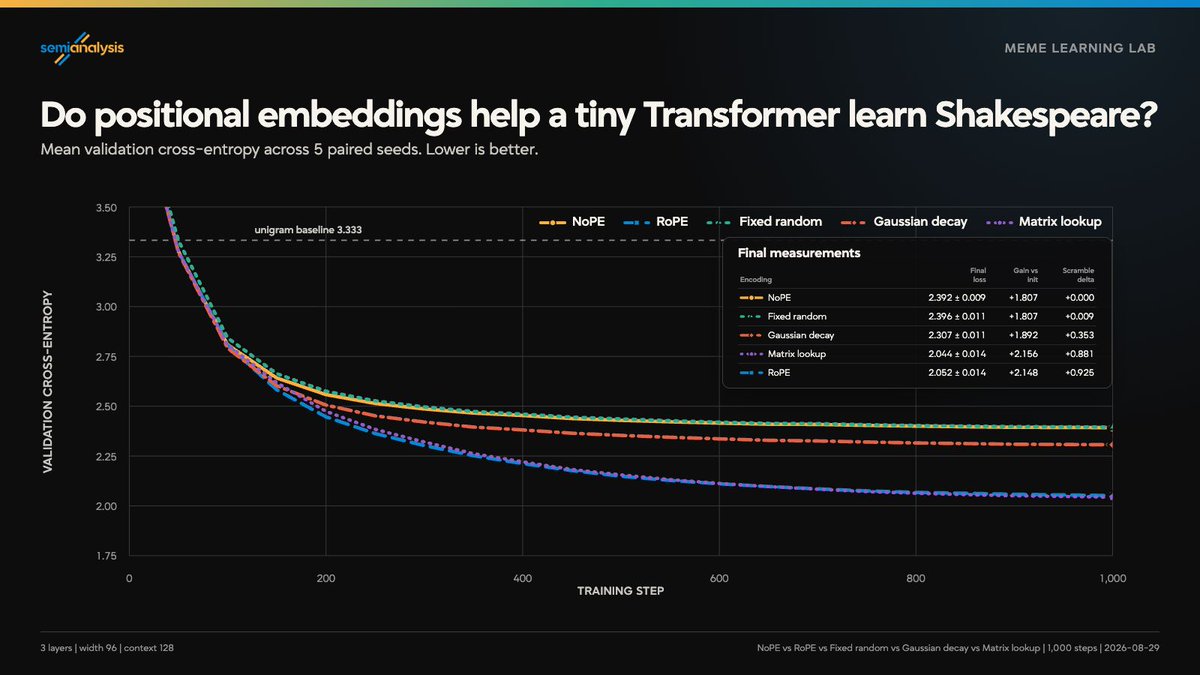
Attention has no innate notion of time. Positional embeddings are how language models tell how far a…
DịchBài viết phân tích cách các mô hình ngôn ngữ sử dụng nhúng vị trí để hiểu khoảng cách giữa các token, đồng thời đặt câu hỏi liệu việc nới lỏng các ràng buộc toán học truyền thống có mở ra không gian hàm mới hiệu quả hơn hay không.
Fly Language Model (FLM) tích hợp bản đồ kết nối thần kinh của ruồi giấm vào mô hình LiquidAI 1.2B. Kết quả thực nghiệm cho thấy việc bổ sung cấu trúc kết nối này không giúp cải thiện hiệu suất so với các mô hình đối chứng.
Interesting paper to improve recurrent reasoning. Looped models are great because you get more reas…
DịchLooped Flows giới thiệu cách huấn luyện mô hình tuần hoàn thông qua mục tiêu khử nhiễu cục bộ, giúp các trạng thái ẩn liên kết chặt chẽ và khắc phục hạn chế về dòng chảy gradient. Phương pháp này cải thiện hiệu suất vượt trội trên hầu hết các bài kiểm tra suy luận so với các kiến trúc cũ.
DeepSeek-V4.1-Flash giới thiệu kiến trúc Causal Encoder-Decoder mới, cho phép tạo KV Cache toàn cục trực tiếp từ đầu ra của encoder. Cải tiến này giúp lược bỏ việc xử lý prompt qua toàn bộ các lớp decoder, từ đó tối ưu hóa đáng kể tốc độ tiền xử lý (prefill) cho mô hình.
Kalman Delta Networks (KDNs) cải tiến cơ chế attention tuyến tính bằng cách áp dụng bộ lọc Kalman để quản lý độ bất định trong bộ nhớ, giúp mô hình tối ưu hóa việc ghi nhớ thông tin dựa trên bằng chứng tích lũy thay vì chỉ dựa vào token hiện tại.
Vì sao đáng đọc: Đây là một bước tiến kỹ thuật quan trọng trong kiến trúc mô hình ngôn ngữ, giải quyết bài toán tối ưu hóa bộ nhớ dài hạn bằng phương pháp toán học xác suất, rất có giá trị cho giới nghiên cứu AI.
Nghiên cứu SMELT từ Đại học Thanh Hoa và ByteDance giải mã hiệu năng của Looped Transformer bằng cách so sánh công bằng về chi phí tính toán, tham số và KV cache, khẳng định tiềm năng của việc tái sử dụng các lớp mạng thay vì chỉ tăng quy mô mô hình.
Safin-1 giới thiệu kiến trúc MARCH giúp mô hình tự duy trì trạng thái an toàn nội tại thông qua việc định tuyến bộ nhớ và tiến hóa trạng thái, thay vì phụ thuộc vào các bộ lọc bên ngoài.
Vì sao đáng đọc: Đề xuất hướng tiếp cận mới đầy hứa hẹn về an toàn AI bằng cách tích hợp trực tiếp vào kiến trúc thay vì chỉ dùng hậu kiểm, rất quan trọng cho các tác vụ dài hạn.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứu giới thiệu công thức SMELT, tối ưu hóa hiệu suất mô hình Transformer tuần hoàn bằng cách cân bằng ngân sách tính toán trên mỗi token, tham số và bộ nhớ đệm KV.
Nghiên cứu chỉ ra rằng việc tách biệt nhiệm vụ giúp tránh sự suy giảm hiệu năng khi mô hình đa phương thức vừa hiểu vừa tạo ảnh, đồng thời khẳng định mô hình end-to-end vượt trội hơn so với các hệ thống phân tách truyền thống.
Nghiên cứu từ StartLux và các đại học danh tiếng đã khám phá cách các lớp Full Attention ảnh hưởng đến mô hình lai, xác định hai trạng thái kích hoạt đặc trưng là 'đỉnh trước chú ý' và 'nền giữa các đỉnh', giúp tối ưu hóa hiệu năng cho các kiến trúc LLM thế hệ mới.
Vì sao đáng đọc: Nghiên cứu chuyên sâu về kiến trúc mô hình lai (Hybrid Linear Attention) đang là xu hướng quan trọng để cân bằng hiệu suất và tốc độ, có giá trị cao cho giới kỹ thuật và nghiên cứu AI.
Nghiên cứu giới thiệu kiến trúc Falcon sử dụng bộ nhớ trọng số nhanh để nén ngữ cảnh vào trạng thái hồi quy cố định, tối ưu hóa khả năng học trực tuyến cho các mô hình ngôn ngữ.
Z.ai và Qwen đã vô tình tạo ra các mô hình có kiến trúc gần như tương đồng, từ cơ chế trộn tuyến tính 3:1 đến kỹ thuật huấn luyện Muon, cho thấy sự hội tụ công nghệ thú vị trong giới AI Trung Quốc.
Bài viết đi sâu vào quy trình huấn luyện, kiến trúc kỹ thuật và các cải tiến quan trọng giúp dòng mô hình Granite 4.2 của IBM đạt hiệu suất vượt trội trong các tác vụ ngôn ngữ.
cool comment: FLOPs were intelligence; parameters were knowledge!
DịchTang Jie dẫn chứng từ Switch Transformers để khẳng định rằng hiệu quả của mô hình phụ thuộc vào sự cân bằng giữa tính toán (FLOPs) và tham số, thay vì chỉ tập trung vào quy mô đơn thuần.
ModelMap cho phép bạn xem sơ đồ cấu trúc động của bất kỳ mô hình nào trên Hugging Face mà không cần tải xuống trọng số. Công cụ hỗ trợ các mô hình phổ biến như Qwen, DeepSeek và Kimi, giúp việc phân tích kiến trúc trở nên trực quan và nhanh chóng.
Nghiên cứu khám phá cách chuyển đổi bộ nhớ dạng bảng (Engram) giữa các mô hình ngôn ngữ khác nhau, tập trung vào việc tối ưu hóa trình đọc phía đích để tận dụng tri thức đã học mà không cần huấn luyện lại.
Some architecture choices that make transformers cheaper or more stable also make them harder to ext…
DịchNghiên cứu trên 26 mô hình 7B cho thấy các lựa chọn kiến trúc như QK-norm hay Sliding Window khi kết hợp có thể làm suy giảm nghiêm trọng khả năng xử lý ngữ cảnh dài, dù các bài kiểm tra ngắn hạn không thể hiện rõ điều này.
Khung làm việc mới giúp LLM giải quyết các câu hỏi logic phức tạp bằng cách phân tách lựa chọn thành các thành phần nguyên tử, sau đó sử dụng lập trình tuyến tính để tổng hợp kết quả. Phương pháp này cải thiện đáng kể độ chính xác trên các bộ dữ liệu logic khó.
 AK@_akhaliq