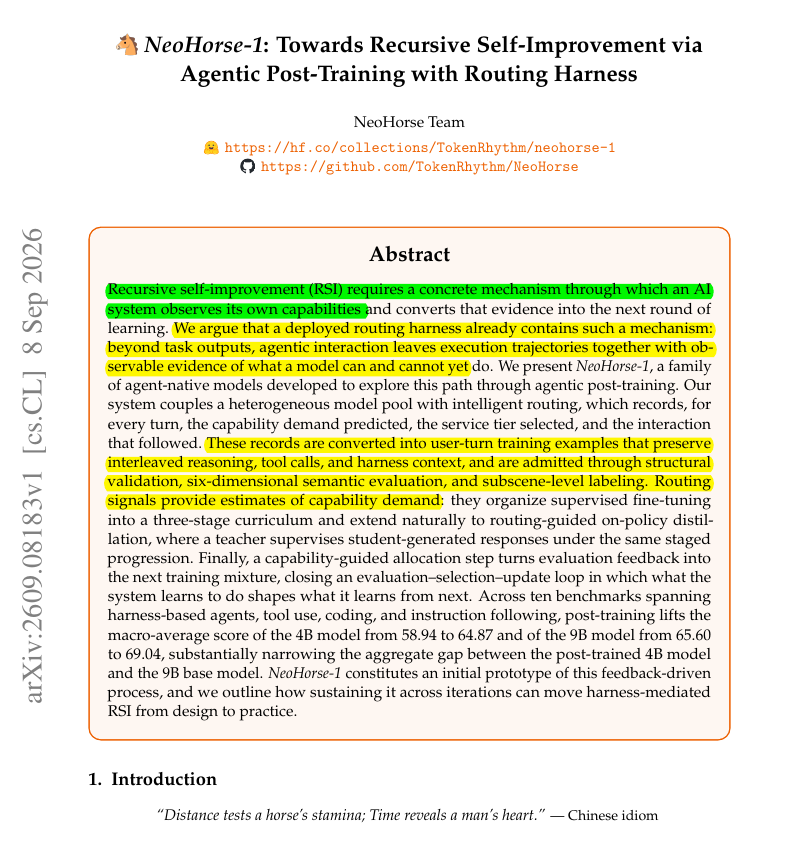
Most agent systems throw away their most suitable training data after every run. A task finishes, a…
DịchTokenRhythm giới thiệu NeoHorse-1 (phiên bản 4B và 9B) dựa trên Qwen3.5, được huấn luyện từ dữ liệu thực thi tác vụ thực tế. Mô hình sử dụng cơ chế tự cải thiện kép để tối ưu hóa khả năng ra quyết định, sử dụng công cụ và xử lý lỗi trong quy trình làm việc của AI.
NeoHorse-1 Towards Recursive Self-Improvement via Agentic Post-Training with Routing Harness paper…
DịchNeoHorse-1 giới thiệu khung làm việc dựa trên định tuyến (routing framework), cho phép các tác nhân AI thực hiện quá trình tự cải tiến đệ quy sau huấn luyện, giúp tối ưu hóa hiệu suất một cách tự động.
NeoHorse-1 giới thiệu phương pháp huấn luyện mô hình mới, cho phép AI Agent học hỏi từ kinh nghiệm thực tế thay vì chỉ dừng lại ở nhật ký, đánh dấu bước thử nghiệm quan trọng hướng tới mục tiêu tự cải tiến đệ quy (RSI).
Vì sao đáng đọc: Bài viết đề cập đến xu hướng RSI đầy tiềm năng trong tương lai, giải quyết bài toán thực tế về việc AI lặp lại lỗi sai, có giá trị chuyên môn cao cho cộng đồng nghiên cứu.
Tổng 3 tin, không còn tin nào nữa
40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (16 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả
 Rohan Paul@rohanpaul_ai