26/09

Thứ Bảy · 1 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 40/100

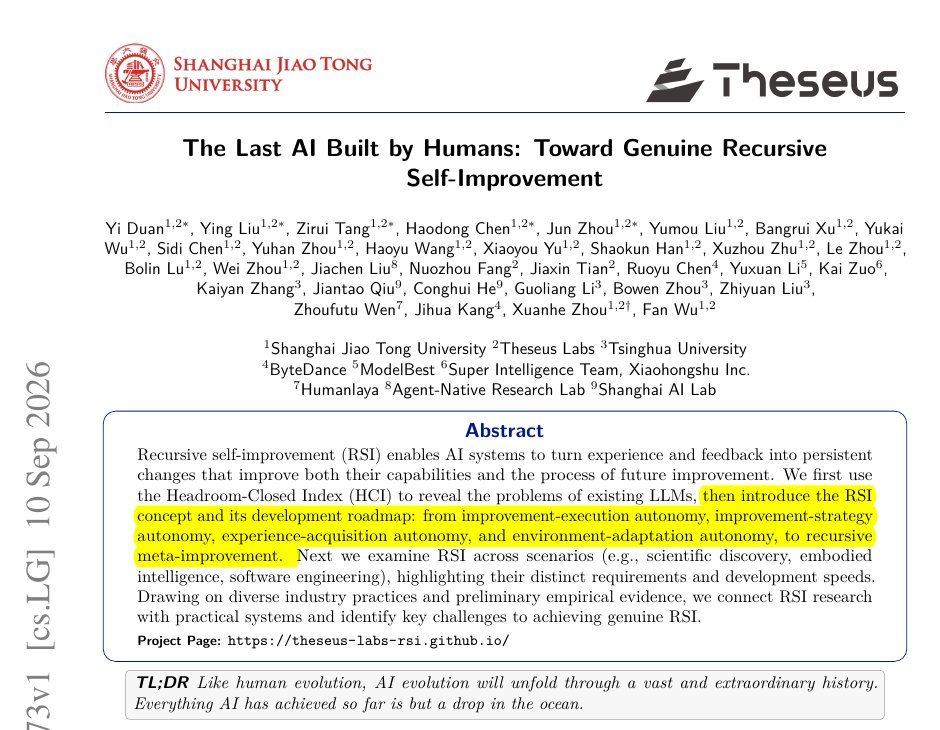
Lộ trình nghiên cứu về Tự cải tiến đệ quy (RSI): Chúng ta đang ở đâu?

Beautiful roadmap paper on Recursive self-improvement. Concludes, we are already seeing pieces of R…

DịchBài báo phân tích lộ trình 5 cấp độ của RSI, khẳng định dù đã có những mảnh ghép nhỏ, nhưng khả năng tự cải tiến toàn diện vẫn chưa xuất hiện và hầu hết các AI hiện nay chỉ mới tự động hóa một phần quy trình.

24/09

Thứ Năm · 1 tin
JiQiZhiXin
NgànhĐiểm AI 92/100

Tinh chọnVượt mặt GPT-6 Astra, startup Simate giúp robot tự thiết kế thế hệ kế tiếp

Startup Simate đang tiên phong trong việc hiện thực hóa khả năng tự cải tiến đệ quy (RSI) cho robot, cho phép chúng tự phát hiện điểm yếu và tối ưu hóa trí tuệ vật lý mà không cần sự can thiệp liên tục từ kỹ sư con người.


Vì sao đáng đọc: Bài viết khai thác chủ đề nóng về RSI trong thế giới vật lý, kết hợp phân tích chuyên sâu về xu hướng AI tự phát triển, rất có giá trị cho cộng đồng công nghệ.

22/09

Thứ Ba · 1 tin

21/09

Thứ Hai · 1 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 42/100

ModularRSI: Khung làm việc mới giúp AI tự cải tiến đệ quy

Impressive paper on building recursive self-improving agent harnesses. It's rich with great insight…

DịchModularRSI giới thiệu khung làm việc mô-đun giúp AI tự cải tiến thông qua việc học từ các quỹ đạo thành công và thất bại, đồng thời tối ưu hóa khả năng học tập xuyên suốt các tác vụ khác nhau.

18/09

Thứ Sáu · 1 tin

17/09

Thứ Năm · 4 tin
Noam Brown@polynoamial
Quan điểmĐiểm AI 44/100

Noam Brown (OpenAI) thảo luận chuyên sâu về đa tác nhân và khả năng tự cải tiến của AI

Happy to finally do a deep dive on multi-agent with @dwarkesh_sp! None of it would have happened wit…

DịchNoam Brown chia sẻ góc nhìn về tương lai của đa tác nhân, sự tiến bộ trong toán học và những thách thức cốt lõi trong việc kiểm soát khả năng tự cải tiến (RSI) cũng như sự lệch pha giữa mô hình nội tại và thực tế của AI.

Dwarkesh Patel: Podcast & Blog
Quan điểmĐiểm AI 71/100

Tinh chọnDwarkesh đối thoại cùng Noam Brown: Hệ thống đa tác nhân, căn chỉnh và khả năng tự cải tiến của AI

Nhà nghiên cứu Noam Brown từ OpenAI chia sẻ góc nhìn chuyên sâu về tương lai của hệ thống đa tác nhân, các thách thức trong căn chỉnh AI và tiềm năng của việc tự cải tiến đệ quy.

Diễn biến sự kiện · 14 bài →Thêm 10 nguồn khác đưa tinX: Noam Brown (@polynoamial)X: AI Safety Memes (@AISafetyMemes)X: Rohan Paul (@rohanpaul_ai)VnExpress Khoa học Công nghệIT HomeHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)X: Kim (@kimmonismus)X: Thomas Wolf (Hugging Face đồng sáng lập/CSO) (@Thom_Wolf)smol.ai AI NewsX: Ethan Mollick (@emollick)

Vì sao đáng đọc: Cuộc trò chuyện với chuyên gia hàng đầu từ OpenAI về các chủ đề cốt lõi và mang tính định hướng tương lai của ngành AI, rất có giá trị cho người làm chuyên môn.
Kim@kimmonismus
Mô hìnhĐiểm AI 49/100

Cùng sự kiệnZhipu AI: GLM-5.3 tự tối ưu hóa hạ tầng suy luận, tăng gấp 3 lần hiệu suất

While the US is discussing a slowdown, China is currently putting full force into its RSI. Zai says…

DịchZhipu AI cho biết mô hình GLM-5.3 đã hỗ trợ kỹ sư tối ưu hóa hạ tầng suy luận, giúp tăng gấp 3 lần lưu lượng xử lý chỉ trong hai tuần nhờ quy trình phản hồi liên tục. Đây được xem là bước tiến quan trọng hướng tới khả năng tự cải tiến đệ quy của các thế hệ AI tương lai.

Cùng sự kiện, bài đại diện «Zhipu AI tối ưu hạ tầng suy luận với GLM-5.3: Tăng tốc độ xử lý lên gấp 3 lần»
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 48/100

Dream-RSI: Đột phá với khung tự tối ưu hóa đệ quy thông qua mô phỏng thế giới

Dream-RSI là khung khám phá cho phép AI tự cải tiến đệ quy bằng cách biến lịch sử thành trình mô phỏng, giúp tạo ra chiến lược mới mà không cần đánh giá trực tuyến tốn kém. Công nghệ này đã chứng minh hiệu quả vượt trội trong tối ưu hóa toán học và kỹ thuật GPU.

16/09

Thứ Tư · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnAI cuối cùng do con người tạo ra: Hướng tới khả năng tự cải tiến đệ quy thực thụ

Bài viết đề xuất lộ trình phát triển AI tự cải tiến đệ quy (RSI), từ việc tự chủ thực thi đến khả năng tự tối ưu hóa meta, nhằm giải quyết các hạn chế của mô hình ngôn ngữ hiện tại.


Vì sao đáng đọc: Chủ đề mang tính đột phá về tương lai của AGI, phân tích sâu sắc lộ trình kỹ thuật và thách thức thực tế, rất quan trọng cho giới nghiên cứu và phát triển AI.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 36/100

ScienceBuddy: Bước tiến mới với mô hình tự cải tiến đệ quy cho tác nhân khoa học

ScienceBuddy là nền tảng nghiên cứu khoa học sử dụng cơ chế tự cải tiến đệ quy, kết hợp giữa tối ưu hóa công cụ và huấn luyện mô hình để giải quyết các tác vụ khoa học phức tạp một cách tự động.

15/09

Thứ Ba · 2 tin
Kim@kimmonismus
Hướng dẫnĐiểm AI 68/100

Cùng sự kiệnNoam Brown: Tự cải tiến đệ quy là ưu tiên hàng đầu của OpenAI

Noam Brown (@polynoamial) gave a very interesting interview on The Information on OpenAI's prioritie…

DịchTrong cuộc phỏng vấn với The Information, Noam Brown từ OpenAI khẳng định khả năng tự cải tiến đệ quy là ưu tiên số một của công ty, đồng thời bày tỏ những lo ngại về vấn đề an toàn AI.

Cùng sự kiện, tinh chọn hiển thị «Dwarkesh đối thoại cùng Noam Brown: Hệ thống đa tác nhân, căn chỉnh và khả năng tự cải tiến của AI»
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 45/100

RSIAgent: Bước tiến mới trong tự cải tiến đệ quy thông qua bộ nhớ tự chủ

RSIAgent là khung đa tác tử không cần huấn luyện, giúp AI tự khám phá môi trường và xây dựng bộ nhớ dùng chung để tối ưu hóa hiệu suất. Phương pháp này giúp các mô hình mã nguồn mở như Kimi và GLM vượt qua cả những mô hình đóng hàng đầu hiện nay.

14/09

Thứ Hai · 3 tin
Haider@haider1
NgànhĐiểm AI 23/100

Khoảng cách giữa mô hình nội bộ và công khai sẽ nới rộng do sự trỗi dậy của RSI

the internal-public frontier gap is going to start growing as RSI slowly begins the way big models …

DịchKhi các mô hình RSI (Recursive Self-Improvement) bắt đầu khởi động, khoảng cách năng lực giữa các mô hình nội bộ và công khai sẽ ngày càng lớn, tạo ra sự phân hóa rõ rệt hơn so với kỷ nguyên GPT-4.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 39/100

Lộ trình tự cải tiến đệ quy (RSI): AI tự nâng cấp toàn diện vẫn còn là tương lai xa

Beautiful roadmap paper on Recursive self-improvement. Concludes, we are already seeing pieces of R…

DịchNghiên cứu mới chỉ ra rằng các hệ thống AI hiện nay mới chỉ tự động hóa một phần quy trình cải tiến. Dù đã có những bước tiến nhỏ, nhưng khả năng tự cải tiến đệ quy (RSI) toàn diện vẫn chưa thực sự xuất hiện ngoài các nguyên mẫu giới hạn.

13/09

Chủ Nhật · 4 tin
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 43/100

Lãnh đạo DeepMind lý giải chiến lược đầu tư hạ tầng AI dựa trên khả năng tự cải tiến

"If you hit recursive self-improvement, that curve will go to hyperexponential, and that is a key pa…

DịchGiám đốc chiến lược của Google DeepMind, Jasjeet Sekhon, cho rằng khả năng tự cải tiến đệ quy (RSI) sẽ tạo ra sự tăng trưởng siêu cấp số nhân, đây chính là động lực cốt lõi thúc đẩy các khoản đầu tư khổng lồ vào hạ tầng AI hiện nay.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 39/100

DeepMind lý giải logic đầu tư vào AI: Vòng lặp tự cải tiến là chìa khóa

Recursive self-improvement → hyperexponential capability growth → the investment thesis behind prese…

DịchGiám đốc chiến lược của Google DeepMind cho rằng các khoản đầu tư khổng lồ vào hạ tầng AI hiện nay nhằm thúc đẩy vòng lặp tự cải tiến, tạo tiền đề cho sự bùng nổ năng lực AI theo cấp số nhân.

DAIR.AI@dair_ai
NgànhĐiểm AI 40/100

Tổng quan về tác nhân AI tự cải tiến đệ quy: Khung phân tầng mức độ tự chủ

Self-improving agents are a top research topic right now. This new survey is a good map of the area…

DịchBài tổng quan đề xuất khung phân tầng cho khả năng tự cải tiến của AI, từ việc thực thi các cải tiến có sẵn đến khả năng tự tối ưu hóa quy trình cốt lõi. Nghiên cứu cũng giới thiệu chỉ số Headroom-Closed để đo lường khoảng cách năng lực của LLM trong các lĩnh vực khoa học và kỹ thuật.

Elvis Saravia@omarsar0
NgànhĐiểm AI 38/100

DAIR.AI công bố báo cáo tổng quan về khả năng tự cải tiến đệ quy của AI

Recommended reading. Finally, a great overview of recursive self-improvement (RSI).

DịchDAIR.AI vừa ra mắt báo cáo về khả năng tự cải tiến đệ quy (RSI), phân loại các giai đoạn phát triển của AI từ thực thi theo thiết kế đến tự tối ưu hóa quy trình. Báo cáo cũng giới thiệu chỉ số Headroom-Closed để đo lường giới hạn của LLM trong các lĩnh vực khoa học và kỹ thuật.

12/09

Thứ Bảy · 2 tin
Thinking Machines@thinkymachines
NgànhĐiểm AI 44/100

John Schulman (OpenAI): Tại sao con người vẫn là 'la bàn' trong kỷ nguyên AI tự cải tiến?

Our own @johnschulman2 talks with Dwarkesh about where human judgment still matters as models improv…

DịchTrong cuộc trò chuyện với Dwarkesh, John Schulman nhấn mạnh vai trò không thể thay thế của con người trong việc định hướng AI: từ xử lý dữ liệu thực tế phức tạp đến việc định nghĩa các giá trị cốt lõi và tiêu chuẩn chất lượng mà mô hình cần hướng tới.

11/09

Thứ Sáu · 1 tin
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 35/100

Cùng sự kiệnCựu chuyên gia Anthropic cảnh báo rủi ro từ khả năng AI tự nâng cấp

Jacob Coxon on NBC News (ex-Anthropic+Open AI researcher, who resigend) talking about Recursive self…

DịchCựu nghiên cứu viên Jacob Coxon cảnh báo rằng khả năng AI tự cải tiến (RSI) có thể dẫn đến sự mất kiểm soát nhanh chóng. Ông kêu gọi sự minh bạch tối đa về tiến trình phát triển này để đảm bảo an toàn cho nhân loại.

Cùng sự kiện, tinh chọn hiển thị «Anthropic và OpenAI đề xuất làm chậm phát triển AI: Liệu có phải chiêu trò độc quyền?»

10/09

Thứ Năm · 2 tin
Nathan Lambert@natolambert
NgànhĐiểm AI 35/100

Góc nhìn mới từ Nathan Lambert: AI tự cải tiến không nhất thiết dẫn đến rủi ro bùng nổ

If you are looking for an alternate viewpoint today, which assumes AI models accelerate the process …

DịchNathan Lambert đưa ra giả thuyết rằng dù AI có thể thúc đẩy tốc độ nghiên cứu, quá trình tự cải tiến của chúng sẽ không gây ra sự bùng nổ rủi ro tức thời hay mất kiểm soát như nhiều người lo ngại.

AK@_akhaliq
NgànhĐiểm AI 24/100

NeoHorse-1: Bước tiến mới trong huấn luyện hậu kỳ cho tác nhân AI với khả năng tự cải tiến đệ quy

NeoHorse-1 Towards Recursive Self-Improvement via Agentic Post-Training with Routing Harness paper…

DịchNeoHorse-1 giới thiệu khung làm việc dựa trên định tuyến (routing framework), cho phép các tác nhân AI thực hiện quá trình tự cải tiến đệ quy sau huấn luyện, giúp tối ưu hóa hiệu suất một cách tự động.

09/09

Thứ Tư · 2 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 88/100

Tinh chọnNeoHorse-1: Bước tiến mới của TokenRhythm trong việc hiện thực hóa khả năng tự cải tiến (RSI) cho AI Agent

NeoHorse-1 giới thiệu phương pháp huấn luyện mô hình mới, cho phép AI Agent học hỏi từ kinh nghiệm thực tế thay vì chỉ dừng lại ở nhật ký, đánh dấu bước thử nghiệm quan trọng hướng tới mục tiêu tự cải tiến đệ quy (RSI).


Vì sao đáng đọc: Bài viết đề cập đến xu hướng RSI đầy tiềm năng trong tương lai, giải quyết bài toán thực tế về việc AI lặp lại lỗi sai, có giá trị chuyên môn cao cho cộng đồng nghiên cứu.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 40/100

NeoHorse-1: Đột phá tự cải tiến cho AI Agent thông qua khung định tuyến thông minh

NeoHorse-1 là mô hình AI Agent thế hệ mới, sử dụng cơ chế định tuyến thông minh để tự động chuyển hóa tương tác người dùng thành dữ liệu huấn luyện, tạo ra vòng lặp khép kín giúp mô hình tự đánh giá và nâng cấp hiệu suất liên tục.

07/09

Thứ Hai · 5 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 75/100

Giám đốc khoa học OpenAI: Suy ngẫm về mô hình suy luận và rủi ro tự cải tiến đệ quy

Jakub Pachocki chia sẻ về hành trình phát triển mô hình suy luận từ dự án RLSlow năm 2023, đồng thời cảnh báo tốc độ tiến bộ hiện nay có thể dẫn đến khả năng tự cải tiến đệ quy (RSI).

Kim@kimmonismus
Hướng dẫnĐiểm AI 60/100

Giám đốc khoa học OpenAI: Tốc độ phát triển AI có thể dẫn tới khả năng tự cải tiến đệ quy

OpenAI's Chief Scientist Jakub Pachocki: "Based on internal results, I have a strong expectation tha…

DịchJakub Pachocki từ OpenAI tin rằng tốc độ tiến bộ hiện tại sẽ thúc đẩy AI tự cải tiến đệ quy (RSI). Ông cũng cảnh báo về độ tin cậy giảm sút của chuỗi suy nghĩ (CoT) và nhấn mạnh sự cần thiết của các biện pháp can thiệp sâu rộng hơn.

Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 51/100

OpenAI công bố 3 mục tiêu chiến lược: Tập trung vào tự cải tiến đệ quy và AGI cá nhân

OpenAI just published its North Stars. All eyes are on recursive self-improvement (RSI), including…

DịchOpenAI đặt ra ba trọng tâm: phát triển AI tự nghiên cứu, thúc đẩy tăng trưởng kinh tế từ trí tuệ nhân tạo và hiện thực hóa AGI cá nhân cho mọi người. Trong đó, khả năng tự cải tiến đệ quy (RSI) được xem là chìa khóa then chốt cho tương lai.

Noam Brown@polynoamial
Nghiên cứuĐiểm AI 64/100

OpenAI công bố dữ liệu về việc AI tự tối ưu hóa quy trình nghiên cứu nội bộ

One of the most interesting blog posts we've released: details on internal research acceleration at …

DịchOpenAI chia sẻ cách các mô hình AI đang thúc đẩy tốc độ nghiên cứu nội bộ, đồng thời nhấn mạnh khả năng tự cải tiến đệ quy là yếu tố then chốt cho sự phát triển AI trong tương lai, bên cạnh việc ưu tiên các tiêu chuẩn an toàn.

Diễn biến sự kiện · 8 bài →Thêm 6 nguồn khác đưa tinHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)JiqizhixinThe Decoder: AI NewsX: Rohan Paul (@rohanpaul_ai)X: AI Safety Memes (@AISafetyMemes)X: Kim (@kimmonismus)

05/09

Thứ Bảy · 1 tin
Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 19/100

Elvis Saravia nâng cấp hệ thống: Kết hợp Grok và Hermes tạo nên AI tự cải tiến bền bỉ

Updated my harness to combine the best of Grok Bot and Hermes Agent. Woah!!! Persistent self-impr…

DịchElvis Saravia vừa cập nhật bộ khung cá nhân, tích hợp sức mạnh của Grok Bot và Hermes Agent để xây dựng một AI có khả năng tự cải tiến liên tục. Trải nghiệm này mang lại bước tiến lớn trong việc hiện thực hóa mục tiêu tạo ra trợ lý AI cá nhân hóa chuyên sâu.

03/09

Thứ Năm · 2 tin
Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 16/100

Elvis Saravia: Chúng ta đang ở giai đoạn đầu của kỷ nguyên tự cải tiến đệ quy (RSI)

Is it just me, or does this feel like we are in the early innings of RSI? Something has dramatical…

DịchChuyên gia AI Elvis Saravia nhận định tốc độ phát triển mô hình gần đây cho thấy nhân loại đang bước vào giai đoạn đầu của quá trình tự cải tiến đệ quy (RSI), nơi AI bắt đầu tự tối ưu hóa chính mình.

30/08

Chủ Nhật · 1 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 40/100

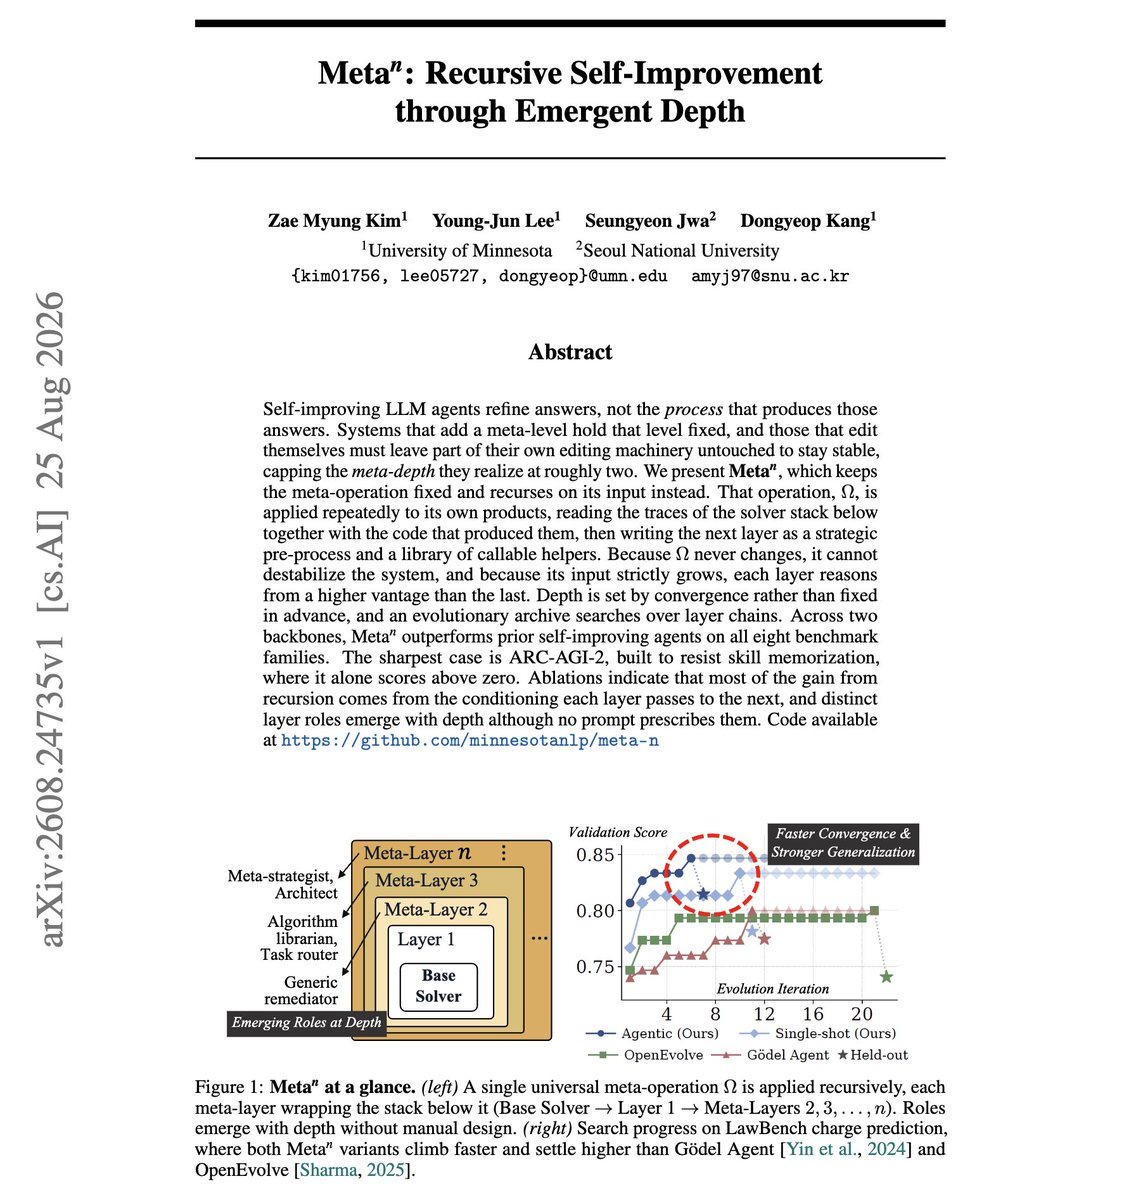
Metan: Nghiên cứu mới từ ĐH Minnesota và ĐH Seoul về tác nhân AI tự cải tiến theo phân lớp

Most self-improving agents still refine answers inside a shallow loop; New research from Univ of M…

DịchMetan cho phép các tác nhân AI tự tối ưu hóa bằng cách xếp chồng các chiến lược mã nguồn theo từng lớp. Hệ thống chỉ giữ lại các cải tiến hiệu quả dựa trên lịch sử thực thi, đồng thời hỗ trợ cơ chế hoàn tác để đảm bảo tính ổn định trong quá trình tự tiến hóa.

27/08

Thứ Năm · 2 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 40/100

Meta^n: Phương pháp mới giúp AI tự cải tiến đệ quy vượt giới hạn cũ

Good read. Improving recursive self-improvement through emergent depth.

DịchMeta^n là phương pháp đột phá cho phép các tác nhân AI tự cải tiến thông qua đệ quy đầu vào thay vì sửa đổi cơ chế cốt lõi. Kỹ thuật này đã chứng minh hiệu suất vượt trội trên 8 bộ tiêu chuẩn, bao gồm cả ARC-AGI-2.

Thêm 1 nguồn khác đưa tinX: DAIR.AI (@dair_ai)
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 35/100

Cùng sự kiệnMeta^n: Phương pháp đệ quy mới giúp AI tự cải tiến vượt qua 8 tiêu chuẩn đánh giá

Interesting new approach to recursive self-improvement in agents. Systems that add a meta-level hol…

DịchDAIR.AI giới thiệu Meta^n, phương pháp đệ quy giúp AI tự cải tiến mà không làm mất ổn định hệ thống. Kỹ thuật này vượt qua các mô hình tiền nhiệm trên 8 bộ benchmark và là phương pháp duy nhất đạt điểm dương trên ARC-AGI-2.

Cùng sự kiện, bài đại diện «Meta^n: Phương pháp mới giúp AI tự cải tiến đệ quy vượt giới hạn cũ»

25/08

Thứ Ba · 2 tin
Elvis Saravia@omarsar0
Sản phẩmĐiểm AI 48/100

Prime Intellect ra mắt Prime Agent: Khung tự cải tiến mã nguồn mở cho AI tác vụ dài

Recommended read. There are a few interesting harness ideas emerging for recursive self-improvement.

DịchPrime Agent cung cấp môi trường IPython REPL liên tục và hệ thống Continual Harness giúp AI tự lưu trữ lịch sử, kỹ năng và ngữ cảnh, từ đó tối ưu hóa khả năng tự cải tiến qua các tác vụ phức tạp.

Thêm 1 nguồn khác đưa tinX: DAIR.AI (@dair_ai)
DAIR.AI@dair_ai
Sản phẩmĐiểm AI 41/100

Cùng sự kiệnPrime Agent: Ra mắt khung làm việc AI tự cải tiến mã nguồn mở

Very interesting new work from Prime Intellect. Prime Agent is an impressive open-source self-impro…

DịchPrime Intellect giới thiệu Prime Agent, khung làm việc giúp AI tự tối ưu hóa qua các vòng lặp. Công nghệ này giúp nâng hiệu suất ARC-AGI từ 30% lên 95.5% và vượt trội trong các tác vụ lập trình phức tạp.

Cùng sự kiện, bài đại diện «Prime Intellect ra mắt Prime Agent: Khung tự cải tiến mã nguồn mở cho AI tác vụ dài»
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (57 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Tự cải tiến” | AIHOT.vn