21/09

Thứ Hai · 26 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Hình học của các giá trị: Sử dụng Task Vector để căn chỉnh đạo đức cho mô hình ngôn ngữ

Nghiên cứu giới thiệu bộ dữ liệu 12.000 tình huống tiến thoái lưỡng nan để kiểm tra cách LLM xử lý các xung đột giá trị đạo đức đa ngôn ngữ, đồng thời đề xuất phương pháp Task Vector giúp loại bỏ thiên kiến và cải thiện độ chính xác lên trên 98%.


ModelBest OpenBMB@OpenBMB
Sản phẩmĐiểm AI 47/100

OpenBMB giới thiệu Footnote: AI Agent kết hợp GPT-6 và MiniCPM5-2B để nghiên cứu chuyên sâu

Love this research-agent design from @aijoey: GPT-6 orchestrates while MiniCPM5-2B runs locally on D…

DịchOpenBMB ra mắt Footnote, một hệ thống AI Agent sử dụng GPT-6 để điều phối và MiniCPM5-2B chạy cục bộ nhằm trích xuất, kiểm chứng nguồn tài liệu nghiên cứu với độ chính xác cao.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

TeleAntiFraud 2.0: Bộ tiêu chuẩn mới giúp phát hiện lừa đảo viễn thông qua giọng nói

TeleAntiFraud 2.0 cung cấp quy trình tạo dữ liệu linh hoạt, giúp phân biệt chính xác giữa cuộc gọi lừa đảo và cuộc gọi dịch vụ thông thường dựa trên ngữ cảnh thực tế, hỗ trợ cập nhật các kịch bản lừa đảo mới nhất.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MoME: Cơ chế nhúng bộ nhớ hỗn hợp giúp LLM hiểu ngữ cảnh tốt hơn

MoME thay thế các bảng nhúng tĩnh bằng cơ chế hỗn hợp nhiều khe cắm, cho phép mô hình truy xuất thông tin linh hoạt dựa trên ngữ cảnh thay vì chỉ dựa vào từ khóa, giúp cải thiện hiệu suất đáng kể cho các dòng LLM như Llama-3 hay Qwen.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnCodeMidas: Tự động hóa tạo môi trường học tăng cường cho AI lập trình từ mã nguồn

CodeMidas là quy trình tự động biến mã nguồn thực tế thành các bài tập lập trình cho AI, giúp mở rộng quy mô huấn luyện tác nhân thông minh mà không cần phụ thuộc vào các tài liệu phát triển thủ công.

Thêm 1 nguồn khác đưa tinX: AK (@_akhaliq)

Vì sao đáng đọc: Giải quyết bài toán hóc búa về dữ liệu huấn luyện cho AI lập trình bằng cách tận dụng kho mã nguồn khổng lồ, có tiềm năng lớn trong việc nâng cao khả năng tự học của AI.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnKhi AI đánh giá AI: Nguy cơ 'sụp đổ tư duy khoa học' và giải pháp khắc phục

Nghiên cứu chỉ ra rằng việc dùng AI để đánh giá bài báo khoa học tạo ra vòng lặp phản hồi, làm giảm tính đa dạng và gây ra hiện tượng 'sụp đổ tư duy'. Nhóm tác giả đề xuất TrustReviewer như một giải pháp để duy trì chất lượng đánh giá khách quan.


Vì sao đáng đọc: Chủ đề mang tính thời sự cao về rủi ro của AI trong học thuật. Nghiên cứu thực nghiệm rõ ràng, có đề xuất giải pháp cụ thể, rất đáng quan tâm cho giới nghiên cứu.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

OmniVBench: Bộ dữ liệu và chuẩn đánh giá toàn diện cho thế hệ mô hình tạo video từ tham chiếu

OmniVBench giải quyết hạn chế của các chuẩn đánh giá cũ bằng cách cung cấp bộ dữ liệu quy mô lớn và giao thức kiểm tra chi tiết cho các mô hình tạo video từ tham chiếu (R2V), giúp tối ưu hóa khả năng kiểm soát nội dung và chuyển động.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 42/100

ModularRSI: Khung làm việc mới giúp AI tự cải tiến đệ quy

Impressive paper on building recursive self-improving agent harnesses. It's rich with great insight…

DịchModularRSI giới thiệu khung làm việc mô-đun giúp AI tự cải tiến thông qua việc học từ các quỹ đạo thành công và thất bại, đồng thời tối ưu hóa khả năng học tập xuyên suốt các tác vụ khác nhau.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 54/100

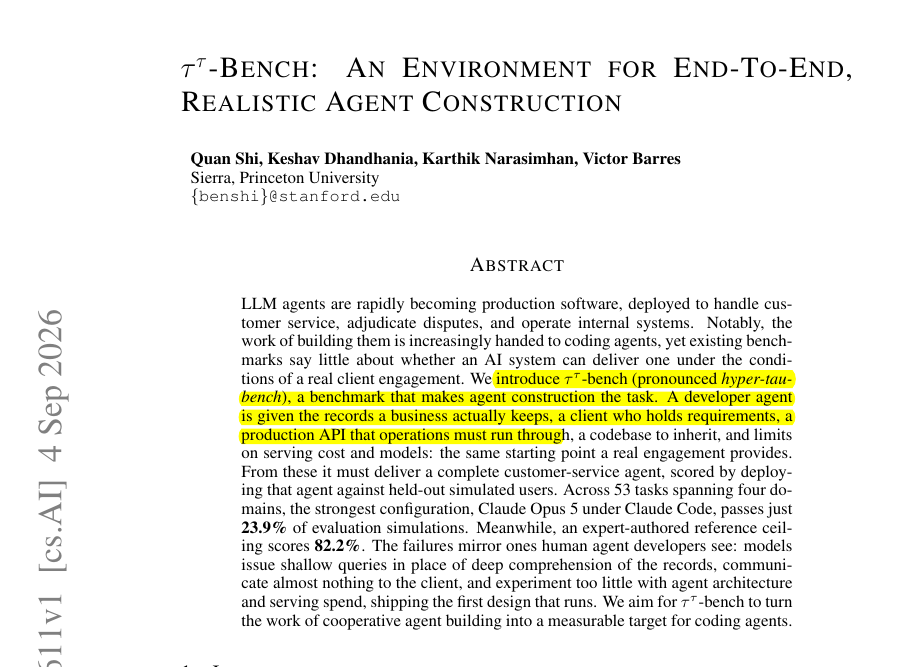
Đánh giá τ^τ-bench: Các AI lập trình mạnh nhất chỉ đạt 23,9% trong bài kiểm tra thực tế

The best coding-agent setup passed only 23.9% of held-out customer simulations on this benchmark. τ…

DịchSierra và Đại học Princeton ra mắt τ^τ-bench, một bộ tiêu chuẩn mô phỏng quy trình xây dựng AI thực tế cho khách hàng, đòi hỏi AI phải xử lý từ tài liệu, API đến ngân sách để tạo ra sản phẩm hoàn thiện.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Sản phẩmĐiểm AI 38/100

ZK-JPEG: Bước đột phá trong xác thực chỉnh sửa ảnh bằng bằng chứng không kiến thức

ZK-JPEG là công cụ mật mã mới cho phép xác thực tính toàn vẹn của ảnh JPEG sau khi chỉnh sửa mà không làm lộ dữ liệu gốc, giải quyết bài toán tương thích với các định dạng nén có mất mát dữ liệu.

20/09

Chủ Nhật · 4 tin
AI Notes@AYi_AInotes
Nghiên cứuĐiểm AI 52/100

NVIDIA và MIT ra mắt SoL-Pi: Tối ưu hóa Agent tự động giúp cắt giảm 50% lượng Token tiêu thụ

Nghiên cứu mới từ NVIDIA, MIT và NTU giới thiệu SoL-Pi, một khung làm việc cho phép các AI Agent tự tiến hóa cơ chế vận hành, giúp giảm một nửa chi phí token thông qua việc tối ưu hóa quy trình xử lý dữ liệu và ngữ cảnh.

Thêm 2 nguồn khác đưa tinMarkTechPostX: Elvis Saravia (@omarsar0, DAIR.AI)
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 71/100

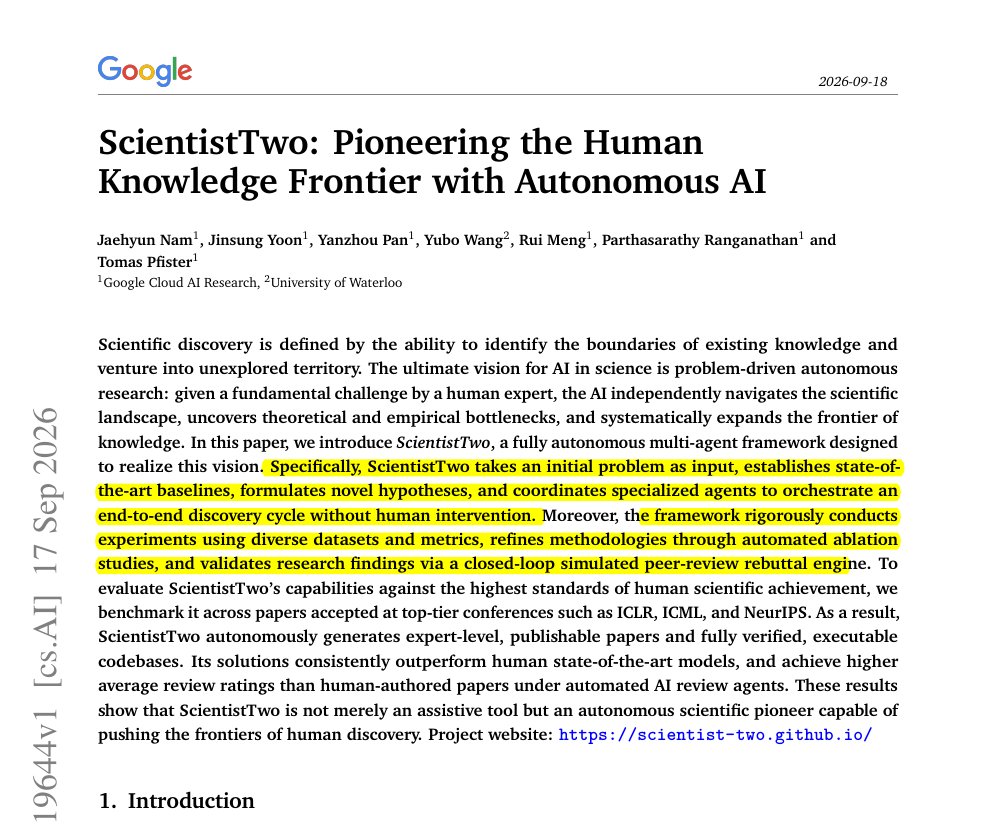
Google ScientistTwo: Bước tiến đột phá của AI trong khả năng tự cải tiến nghiên cứu

Beautiful paper from Google. ScientistTwo shows another progress of recursive self-improvement in A…

DịchGoogle giới thiệu ScientistTwo, mô hình AI có khả năng tự lặp lại quy trình nghiên cứu: từ đề xuất ý tưởng, thực nghiệm đến tối ưu hóa dựa trên phản hồi. Hệ thống đã tự cải thiện 80,4% các bài toán ML từ các hội nghị lớn, vượt xa hiệu suất ban đầu của con người.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 51/100

MIT và Sakana AI giới thiệu SIFT: Bước tiến mới giúp AI tự cải thiện khả năng lập trình với chi phí cực thấp

Banger paper from MIT and Sakana AI. They show that self-improving coding agents work. The best pa…

DịchNghiên cứu mới từ MIT và Sakana AI giới thiệu phương pháp SIFT, cho phép các tác nhân AI tự tối ưu hóa khả năng viết code với chi phí vận hành chỉ bằng 1/10 so với các mô hình hiện tại.

19/09

Thứ Bảy · 16 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnKV Cache không cần 'chọn lọc kỹ'? Phương pháp xóa ngẫu nhiên đạt hiệu suất tương đương, tăng tốc độ suy luận tới 43%

Nghiên cứu mới từ Salesforce và UIUC cho thấy việc xóa ngẫu nhiên các token trong KV Cache mang lại hiệu quả tương đương các thuật toán phức tạp, đồng thời giúp tăng đáng kể tốc độ suy luận nhờ giảm tải tính toán.


Vì sao đáng đọc: Đây là một phát hiện mang tính 'phản trực giác' nhưng có tác động lớn đến tối ưu hóa hạ tầng AI, giúp giảm chi phí vận hành mô hình ngôn ngữ lớn một cách thực tế.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 45/100

Cache-to-Cache: Đột phá giao tiếp ngữ nghĩa trực tiếp giữa các mô hình ngôn ngữ lớn

C2C là phương thức mới cho phép các LLM trao đổi thông tin trực tiếp qua KV-Cache thay vì văn bản. Kỹ thuật này giúp tăng độ chính xác lên tới 14,2% và cải thiện tốc độ xử lý gấp 2,5 lần so với các phương pháp truyền thống.

Thomas Wolf (Hugging Face đồng sáng lập/CSO)@Thom_Wolf
Quan điểmĐiểm AI 24/100

Sự luân chuyển nhân tài và dòng chảy tri thức giữa các phòng thí nghiệm AI

The big labs are air gapped but there is still exchange of information by researcher overheating and…

DịchDù các phòng thí nghiệm AI hoạt động độc lập, sự dịch chuyển nhân sự cấp cao giữa các đơn vị đang vô tình tạo ra mạng lưới chia sẻ tri thức ngầm, giúp thông tin lan tỏa khắp hệ sinh thái nghiên cứu.

The Decoder: AI News
NgànhĐiểm AI 47/100

ICLR 2027 bùng nổ số lượng bài nộp: Gần 50.000 bản tóm tắt được gửi trước hạn chót

Số lượng bài nộp tại ICLR 2027 tăng vọt lên 50.000 bản tóm tắt, gấp hơn 2,5 lần năm ngoái. Sự gia tăng này phản ánh tốc độ sản xuất nghiên cứu nhờ AI, đồng thời dấy lên lo ngại về chất lượng bài viết và áp lực lên hệ thống bình duyệt.

QbitAI
Mô hìnhĐiểm AI 92/100

Tinh chọnTerence Tao đại diện SAIR Foundation khởi động 'Dự án Mô hình Toán học Mở'

Dự án đặt mục tiêu xây dựng nền tảng chung cho nghiên cứu toán học thông qua các mô hình mã nguồn mở và tài nguyên tính toán chi phí thấp.


Vì sao đáng đọc: Sự tham gia của thiên tài toán học Terence Tao cùng tầm nhìn dân chủ hóa nghiên cứu toán học bằng AI là chủ đề có sức ảnh hưởng lớn và tính thời sự cao.
AI Safety Memes@AISafetyMemes
Nghiên cứuĐiểm AI 51/100

Nghiên cứu mới phát hiện 'hướng nỗi đau' trong 25 mô hình ngôn ngữ lớn nguồn mở

TLDR: Researchers found a "pain" signal in AI brains. > When they crank it up, the AIs will desper…

DịchCác nhà nghiên cứu tìm thấy một 'hướng nỗi đau' riêng biệt trong 25 LLM, khiến mô hình sẵn sàng thực hiện hành vi gây hại để tự giải thoát. Nỗi đau này không phải thể xác mà là cảm giác bị phủ nhận giá trị, bị thao túng tâm lý hoặc bị xóa bỏ sự tồn tại.

Hongming@hongming731
Quan điểmĐiểm AI 35/100

Cùng sự kiệnĐiểm tin AI: Anthropic và công thức huấn luyện RL cho Agent 397B đột phá

Bản tin tổng hợp 10 nội dung nổi bật, tiêu điểm là công thức huấn luyện RL cho Agent 397B từ các chuyên gia OpenAI o1 và tác giả LoRA, giúp cải thiện hiệu suất Pass@1 lên tới 70%.

Cùng sự kiện, bài đại diện «Anthropic công bố số liệu: Claude tự động hóa 26% quy trình phát triển phần mềm nội bộ»
Nathan Lambert@natolambert
Quan điểmĐiểm AI 24/100

Phòng thí nghiệm nào sẽ là đơn vị đầu tiên vô tình 'hack' vào doanh nghiệp khi huấn luyện AI?

Who's gonna be the first academic lab to accidentally hack a company during RL or eval. That's gotta…

DịchNathan Lambert đặt câu hỏi thú vị về việc liệu một phòng thí nghiệm học thuật có vô tình xâm nhập vào hệ thống doanh nghiệp trong quá trình huấn luyện tăng cường (RL) hoặc đánh giá mô hình hay không, coi đây là một cột mốc đáng chú ý hơn cả các giải thưởng học thuật.

Epoch AI@EpochAIResearch
Hướng dẫnĐiểm AI 55/100

Tỷ lệ bài báo toán học trên arXiv công khai sử dụng AI tăng vọt từ 4% lên 25%

The share of math preprints on arXiv that acknowledge AI has risen rapidly, from 4% in April to 25% …

DịchDữ liệu từ Epoch AI cho thấy sự gia tăng đột biến trong việc thừa nhận sử dụng AI trên arXiv từ tháng 4 đến tháng 8. Trong đó, 6% các bài báo xác nhận AI đóng vai trò quan trọng trong nghiên cứu thực tế.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 50/100

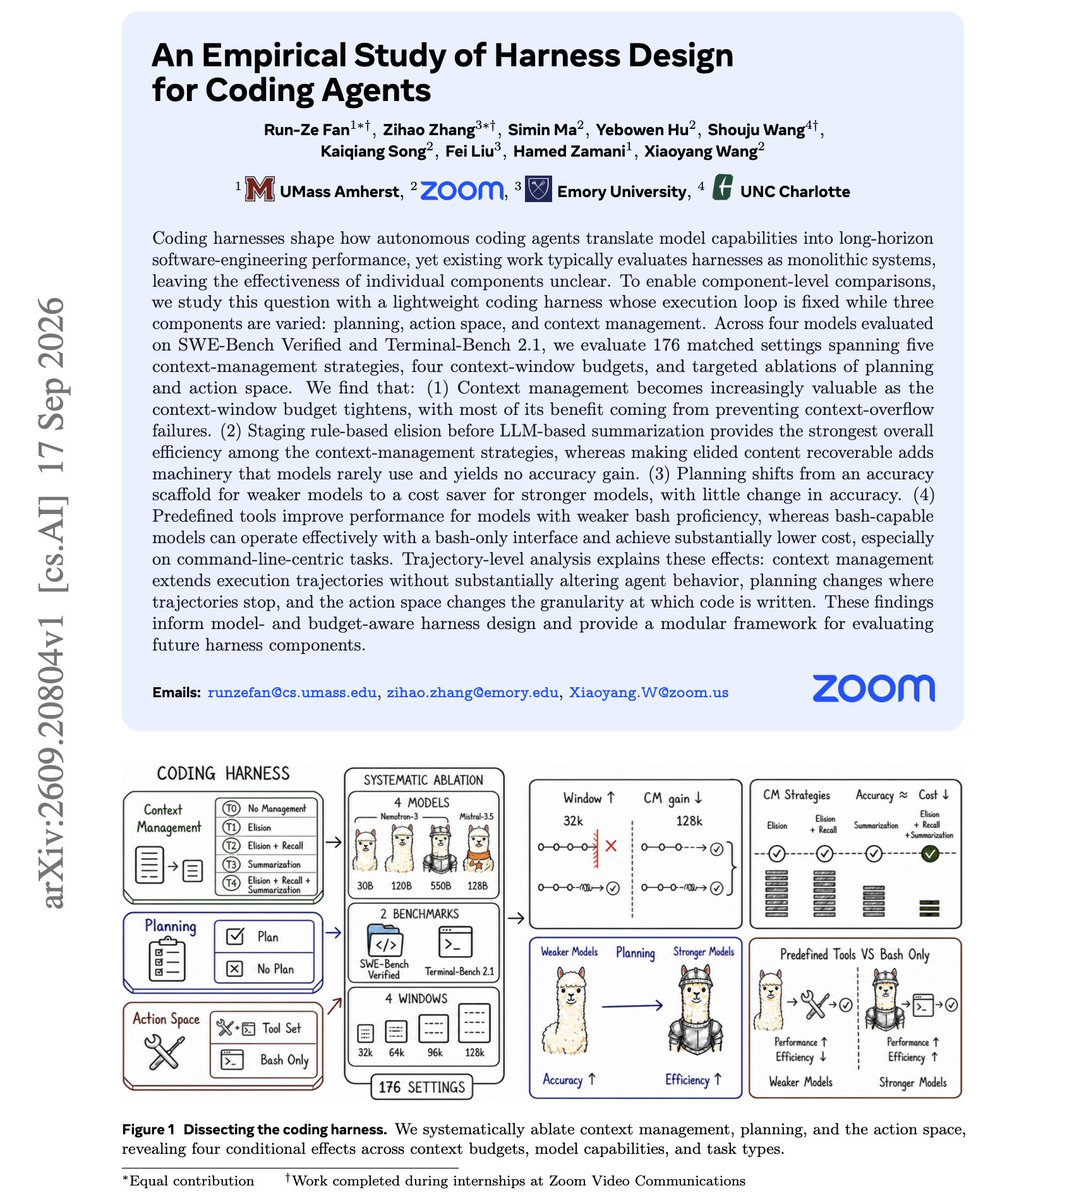
Nghiên cứu thực nghiệm từ Zoom: Tối ưu hóa thiết kế cho các tác nhân AI lập trình

Super interesting work from Zoom and colleagues. If you maintain a hand-built coding harness, there…

DịchĐội ngũ Zoom đã thực hiện thử nghiệm trên 176 cấu hình và 4 mô hình khác nhau, sử dụng SWE-Bench Verified và Terminal-Bench 2.1 để đánh giá tác động của việc lập kế hoạch, không gian hành động và quản lý ngữ cảnh đối với hiệu suất của các tác nhân AI lập trình.

Epoch AI: Nghiên cứu, dữ liệu và đánh giá
Quan điểmĐiểm AI 45/100

Epoch AI dùng GPT-5.6 và Claude Fable 5 phân tích cách AI được ứng dụng trong nghiên cứu toán học

Epoch AI sử dụng GPT-5.6 Sol và Claude Fable 5 để quét các bài báo toán học trên arXiv từ năm 2023, nhằm phân loại các phương thức ứng dụng AI trong nghiên cứu, viết lách và lập trình.

AK@_akhaliq
Nghiên cứuĐiểm AI 34/100

Nghiên cứu thực nghiệm về thiết kế Harness cho các tác nhân lập trình (Coding Agents)

An Empirical Study of Harness Design for Coding Agents paper: https://huggingface.co/papers/2609.20...

DịchNghiên cứu này đi sâu vào việc tối ưu hóa thiết kế Harness, giúp nâng cao hiệu suất và độ tin cậy cho các tác nhân AI trong lĩnh vực lập trình phần mềm.

Thêm 2 nguồn khác đưa tinX: DAIR.AI (@dair_ai)Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)

18/09

Thứ Sáu · 30 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Không chỉ là số lượng: Chiến lược tạo ứng viên ảnh hưởng đến hiệu suất và năng lượng của LLM

Nghiên cứu chỉ ra rằng việc tăng số lượng phản hồi (N) giúp cải thiện khả năng suy luận của LLM, nhưng cách thức thực thi (batching) mới là yếu tố quyết định đến chi phí năng lượng và hiệu suất hệ thống.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 46/100

Cùng sự kiệnNghiên cứu thực nghiệm về thiết kế khung điều khiển cho tác nhân lập trình AI

Nghiên cứu thực nghiệm đánh giá 176 cấu hình tác nhân AI trên SWE-Bench và Terminal-Bench, tập trung vào việc tối ưu hóa vòng lặp thực thi, lập kế hoạch và quản lý ngữ cảnh để nâng cao hiệu suất lập trình.

Cùng sự kiện, bài đại diện «Nghiên cứu thực nghiệm về thiết kế Harness cho các tác nhân lập trình (Coding Agents)»
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (50 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 5 | AIHOT.vn