20/08

Thứ Năm · 27 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Mở rộng khả năng sáng tạo cho LLM: Phương pháp tạo dữ liệu đa thể loại dựa trên thuộc tính

Nghiên cứu giới thiệu khung làm việc mới giúp LLM vượt qua giới hạn của dữ liệu kể chuyện truyền thống, tạo ra 50.000 mẫu văn bản chất lượng cao thuộc 13 thể loại sáng tạo khác nhau như kịch bản, lời bài hát và thiết kế game.

Qwen@Alibaba_Qwen
Sản phẩmĐiểm AI 35/100

Qwen2.5-27B ra mắt phiên bản lượng tử hóa siêu nhẹ từ Unsloth

Huge thanks to Unsloth for the great work. This is wonderful news for the community! 🥳Qwen3.8-27B, …

DịchĐội ngũ Qwen hợp tác cùng Unsloth phát hành phiên bản lượng tử hóa GGUF cho Qwen2.5-27B, cho phép chạy mượt mà trên thiết bị có 8GB RAM với độ chính xác ấn tượng nhờ công nghệ Dynamic V3.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

FM-Bench: Bộ tiêu chuẩn đánh giá AI Agent trong quản lý bóng đá dài hạn

FM-Bench thử thách các mô hình AI điều hành câu lạc bộ bóng đá qua 20 mùa giải với hàng trăm quyết định phức tạp. Kết quả cho thấy hiệu suất phụ thuộc vào tư duy quản lý thay vì sức mạnh tính toán hay lượng token tiêu thụ.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

SPADE: Khung tự đối kháng giúp LLM tự thiết kế môi trường huấn luyện tối ưu

SPADE cho phép một LLM đóng vai trò kép: vừa là người thiết kế môi trường, vừa là tác nhân suy luận, giúp tự động tạo ra các bài kiểm tra ở ngưỡng năng lực để tối ưu hóa hiệu suất mô hình. Phương pháp này cải thiện đáng kể khả năng sử dụng công cụ và giải quyết vấn đề trên nhiều tiêu chuẩn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 38/100

SkillForge: Tối ưu hóa sửa lỗi phần mềm thông qua khung tự chưng cất tác nhân

SkillForge là khung tự chưng cất giúp AI tự tạo và giải quyết các vấn đề đặc thù của dự án bằng cách tái hiện chức năng cốt lõi, từ đó tích lũy kỹ năng chuyên biệt để nâng cao hiệu suất sửa lỗi phần mềm.

WeChat: Ant Ling
Mô hìnhĐiểm AI 68/100

Tinh chọnAnt Group chính thức mã nguồn mở bộ đôi mô hình Ling-3.0 Tiny và Flash

Ant Group vừa công bố mã nguồn mở Ling-3.0-tiny-base (7.9B) và Ling-3.0-flash-base (124B) cùng 6 checkpoints đi kèm, tối ưu cho các tác vụ huấn luyện chuyên sâu, tinh chỉnh và học tăng cường.


Vì sao đáng đọc: Đây là thông tin quan trọng từ một tập đoàn công nghệ lớn, cung cấp các mô hình mã nguồn mở có thông số kỹ thuật rõ ràng, hữu ích cho cộng đồng phát triển AI.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 57/100

Kỷ nguyên của phần mềm mở rộng: Khi LLM thay đổi cách chúng ta tùy biến ứng dụng

LLM đang biến 'phần mềm nhỏ' (Small Software) thành hiện thực, cho phép người dùng tùy biến ứng dụng qua ngôn ngữ tự nhiên với chi phí thấp và bảo mật cao nhờ công nghệ sandbox hiện đại.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

RAG bị tấn công đầu độc: Hiện tượng 'sụp đổ chú ý' khiến mô hình tự tin thái quá

RAG poisoning can make a model more confident, which is exactly why confidence-based detectors can f…

DịchNghiên cứu mới chỉ ra rằng việc đầu độc dữ liệu RAG khiến mô hình trở nên quá tự tin và tập trung sai lệch vào tài liệu độc hại. Việc giám sát phân bổ chú ý thay vì chỉ dựa vào độ tin cậy của câu trả lời có thể giúp phát hiện sớm các cuộc tấn công này.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 47/100

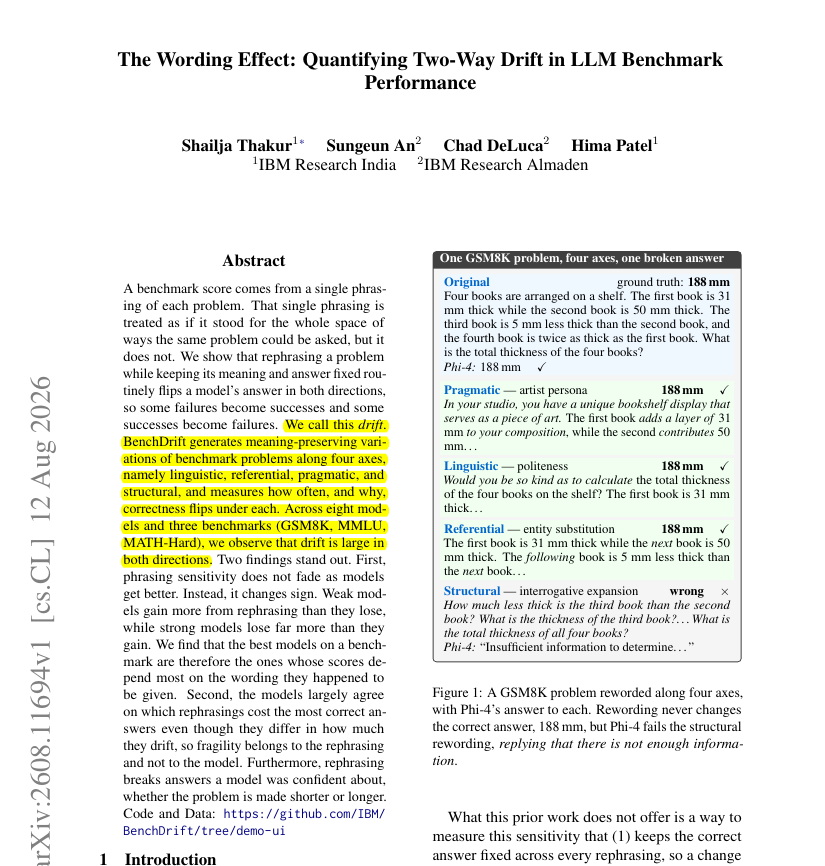
Khung BenchDrift của IBM: Cách diễn đạt khiến điểm số LLM biến động tới 74,7%

A model can know the answer and still fail because you asked the same question differently. New IBM…

DịchIBM giới thiệu BenchDrift, khung đánh giá cho thấy việc thay đổi cách đặt câu hỏi có thể làm điểm số LLM chênh lệch tới 74,7%. Ngay cả với các mô hình mạnh, 18,5% câu trả lời đúng vẫn bị mất đi khi diễn đạt lại dù ý nghĩa không đổi.

Elvis Saravia@omarsar0
Sản phẩmĐiểm AI 63/100

TrueForge: Framework mã nguồn mở giúp tối ưu 75% chi phí vận hành AI Agent

New open-source agent harness just landed! I got early access to TrueForge by TrueFoundry and have …

DịchTrueFoundry vừa ra mắt TrueForge, framework mã nguồn mở cho phép triển khai AI Agent cục bộ với chi phí thấp hơn 75%. Công cụ hỗ trợ đa dạng các mô hình từ OpenAI, Anthropic đến các đại diện Việt Nam và quốc tế như Kimi, GLM và DeepSeek.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

LEGO-RL: Khung học tăng cường nguyên bản cho các tác nhân lập trình AI

LEGO-RL là khung làm việc mới giúp tối ưu hóa các tác nhân lập trình AI mà không cần can thiệp vào luồng điều khiển, giải quyết triệt để các vấn đề về lỗi môi trường, thao túng phần thưởng và sự thiếu nhất quán giữa huấn luyện và suy luận.

19/08

Thứ Tư · 28 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 37/100

Giải mã chi phí AI Agent: Không phải LLM, chính các thành phần phụ mới gây trễ hệ thống

Great paper if you are building production-grade agents. It's a good way to understand what is actu…

DịchNghiên cứu từ DAIR.AI chỉ ra rằng trong các ứng dụng AI Agent thực tế, các thành phần ngoài LLM thường là nguyên nhân chính gây độ trễ. Các giải pháp tối ưu hóa như dịch vụ nhận diện tác vụ và bộ nhớ đệm có thể cải thiện đáng kể hiệu suất và giảm tài nguyên hệ thống.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 43/100

PTXBench: Đánh giá và tối ưu hóa nhân GPU cho LLM bằng mã PTX đặc thù kiến trúc

PTXBench là bộ benchmark mới đánh giá khả năng tối ưu hóa nhân GPU của LLM thông qua mã PTX trên H100 và B200. Kết quả cho thấy các mô hình hiện nay vẫn gặp khó khăn trong việc đạt hiệu suất tương đương với các thư viện chuyên dụng, đặc biệt là trong các tác vụ Attention phức tạp.

Ant Ling@AntLingAGI
Mô hìnhĐiểm AI 53/100

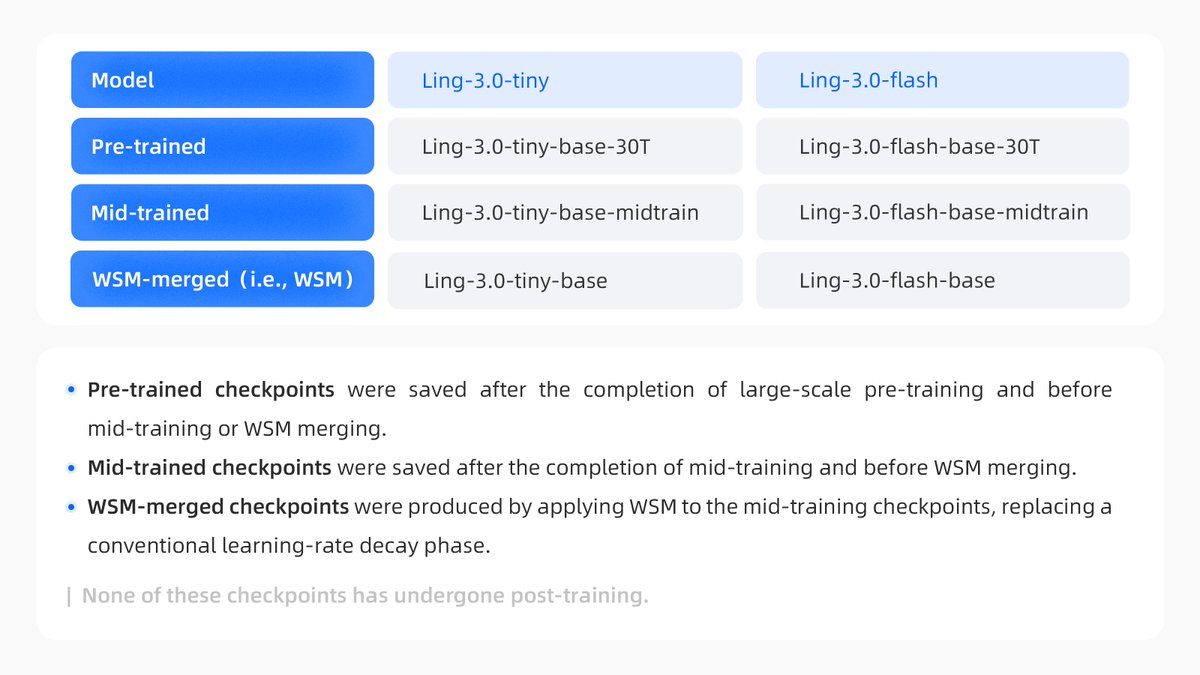
Ant Group mở mã nguồn 6 checkpoint mô hình nền tảng Ling-3.0

🧵 We've open-sourced 6 Base Model checkpoints for Ling-3.0-tiny & Ling-3.0-flash, covering pre-trai…

DịchAnt Group vừa công bố 6 checkpoint cho các mô hình Ling-3.0-tiny và Ling-3.0-flash, bao gồm các giai đoạn tiền huấn luyện và hợp nhất trọng số WSM. Đây là nguồn tài nguyên hữu ích cho cộng đồng để thử nghiệm chiến lược huấn luyện liên tục và tối ưu hóa mô hình.

Rohan Paul@rohanpaul_ai
Mô hìnhĐiểm AI 51/100

Ra mắt mô hình mã nguồn mở Ornith-1.5: Vượt mặt Claude 3 Opus trên nhiều bảng xếp hạng

Another brilliant open-source model release. Ornith-1.5, a family of open-source LLMs spanning 9B D…

DịchDòng mô hình Ornith-1.5 vừa trình làng với ba phiên bản (9B, 35B, 397B), trong đó bản 397B gây ấn tượng mạnh khi vượt qua Claude 3 Opus trên các bài kiểm tra chuyên sâu như SWE-bench và Terminal-Bench.

Thêm 1 nguồn khác đưa tinX: Testing Catalog (@testingcatalog)
Elon Musk@elonmusk
Hướng dẫnĐiểm AI 31/100

Cùng sự kiệnGrok 4.6 soán ngôi đầu bảng xếp hạng AI y tế MedAgentBench

Grok 4.6 is #1 on healthcare questions

DịchGrok 4.6 vừa thiết lập kỷ lục mới trên MedAgentBench với tỷ lệ chính xác 95,9%, vượt qua GPT-5.6 Sol trong các tác vụ chẩn đoán và xử lý hồ sơ bệnh án phức tạp.

Cùng sự kiện, bài đại diện «Grok 4.6 soán ngôi đầu bảng xếp hạng AI Agent, ngang hàng với Claude Opus 5 Max»
Apple Machine Learning Research
Nghiên cứuĐiểm AI 52/100

Nghiên cứu từ Apple: Phân tích đa chiều về hành vi giống người của các mô hình ngôn ngữ lớn (LLM)

Đội ngũ nghiên cứu của Apple đã phân tích cách LLM thể hiện cảm xúc và thiết lập ranh giới với người dùng. Nghiên cứu cung cấp cái nhìn sâu sắc giúp các nhà phát triển kiểm soát hành vi giống người của AI một cách hiệu quả.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnGiải mã kỹ năng của AI Agent: Tại sao chúng hiệu quả và khi nào thì thất bại?

Nghiên cứu phân tích sâu về cách các gói kỹ năng (skills) hỗ trợ LLM Agent, đồng thời chỉ ra những giới hạn và nguyên nhân thất bại thông qua thực nghiệm định lượng và phân tích quỹ đạo hành động.


Vì sao đáng đọc: Bài báo cung cấp cái nhìn thực tế và có hệ thống về cơ chế hoạt động của AI Agent, rất hữu ích cho các kỹ sư đang tối ưu hóa hiệu suất mô hình trong thực tế.
WeChat: Khazix
Hướng dẫnĐiểm AI 41/100

Tang Jie (Zhipu AI) bàn về Scaling Law: GLM-5.3 là bước tiến trong tối ưu hóa mô hình

Nhà sáng lập Zhipu AI khẳng định Scaling Law không chỉ nằm ở số lượng tham số mà còn là sự kết hợp giữa dữ liệu, tính toán và cấu trúc. GLM-5.3 cho thấy xu hướng chuyển dịch từ việc chạy đua quy mô sang tìm kiếm cấu trúc tối ưu cho suy luận dài hạn.

Thêm 4 nguồn khác đưa tinX: Thomas Wolf (Hugging Face đồng sáng lập/CSO) (@Thom_Wolf)Latent SpaceX: Tang Jie (@jietang)X: Ma Dongxi NLP (@dongxi_nlp)
Ma Dongxi NLP@dongxi_nlp
Mô hìnhĐiểm AI 44/100

Tang Jie bàn về Scaling Law: Thử nghiệm hậu huấn luyện trên GLM-5.3

Tang Jie phản biện Scaling Law, khẳng định hiệu năng không chỉ phụ thuộc vào số lượng tham số mà còn ở dữ liệu và tối ưu hóa hậu huấn luyện. Thử nghiệm trên GLM-5.3 cho thấy chỉ cần tinh chỉnh RL trong một tháng đã mang lại bước tiến lớn mà không cần thay đổi kiến trúc.

Thêm 1 nguồn khác đưa tinLatent Space
Tang Jie@jietang
Mô hìnhĐiểm AI 56/100

Cùng sự kiệnTang Jie chia sẻ về Scaling Law: Thử nghiệm hậu huấn luyện trên GLM-5.3

Thoughts About Scaling Law Scaling, but not only of parameters. Every model release now ends with t…

DịchTang Jie khẳng định Scaling Law không chỉ nằm ở quy mô tham số mà còn ở dữ liệu và tính toán. Thử nghiệm GLM-5.3 cho thấy việc tối ưu hóa hậu huấn luyện (RL) giúp cải thiện hiệu suất vượt trội mà không cần thay đổi kiến trúc hay tăng tham số.

Cùng sự kiện, bài đại diện «Tang Jie (Zhipu AI) bàn về Scaling Law: GLM-5.3 là bước tiến trong tối ưu hóa mô hình»
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Sản phẩmĐiểm AI 66/100

Agent Lightning v1.0: Bước tiến mới trong huấn luyện tác nhân AI bằng học tăng cường

Agent Lightning v1.0 là khung làm việc nhẹ giúp tối ưu hóa tác nhân AI qua học tăng cường (RL). Chỉ với 6.000 mẫu huấn luyện, công cụ này đã giúp Qwen3.5-9B tăng điểm số trên SWE-bench Verified từ 41,8% lên 56,4%.

Ethan Mollick@emollick
Hướng dẫnĐiểm AI 36/100

Đánh giá thực tế: Qwen 27B vẫn chưa thể soán ngôi các mô hình AI hàng đầu

Qwen 27B is really good local model but, when you use it, it is immediately absolutely and obviously…

DịchDù là một mô hình chạy cục bộ ấn tượng, Qwen 27B vẫn bộc lộ hạn chế rõ rệt trong các tác vụ phức tạp và điều khiển tác nhân (agent) so với các đối thủ đầu bảng. Người dùng nên tự kiểm chứng qua các bài benchmark thực tế thay vì chỉ nhìn vào thông số.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

aDSL: Bước tiến mới trong tạo nội dung 3D bằng hệ thống đa tác nhân

Nghiên cứu giới thiệu aDSL, ngôn ngữ chuyên dụng giúp AI chuyển đổi ý tưởng thành mã lập trình 3D chính xác thông qua cơ chế phản hồi lặp lại, vượt trội hơn các mô hình LLM hiện tại trong việc tạo hình khối và cấu trúc phức tạp.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Agentic ESOpt: Đột phá tinh chỉnh tác nhân LLM với chi phí GPU cực thấp

Agentic ESOpt là khung tinh chỉnh toàn tham số dựa trên chiến lược tiến hóa, cho phép tối ưu hóa các tác nhân LLM mà chỉ cần bộ nhớ GPU ở mức suy luận, vượt trội hơn hẳn các phương pháp học tăng cường truyền thống.

Aravind Srinivas (Perplexity CEO)@AravSrinivas
Sản phẩmĐiểm AI 39/100

CEO Perplexity hết lời khen ngợi khung RL mã nguồn mở Miles v0.1

Important contribution!

DịchMiles v0.1 là khung RL mã nguồn mở tối ưu cho LLM và mô hình đa phương thức, giúp giải quyết bài toán khó trong huấn luyện và hiệu suất phần cứng. Dự án đã được kiểm chứng trên các mô hình hàng đầu như DeepSeek V4 và Qwen 3.8.

SemiAnalysis@SemiAnalysis_
Sản phẩmĐiểm AI 31/100

RadixArk ra mắt Miles v0.1: Khung huấn luyện tăng cường mã nguồn mở cho LLM

Congrats RadixArk on the launch! https://x.com/radixark/status/2089746481339384068

DịchRadixArk giới thiệu Miles v0.1, khung học tăng cường tối ưu cho LLM và mô hình đa phương thức, giúp giải quyết bài toán khó trong huấn luyện và hiệu suất phần cứng. Dự án đã được kiểm chứng trên các mô hình hàng đầu như DeepSeek V4 và Qwen.

Artificial Analysis@ArtificialAnlys
Hướng dẫnĐiểm AI 65/100

Cùng sự kiệnGLM-5.3 ra mắt: Ngang hàng Kimi K3, xác lập vị thế mô hình mã nguồn mở mạnh nhất

GLM-5.3 achieves 60 on the Artificial Analysis Intelligence Index, on par with Kimi K3 and up 7 poin…

DịchZhipu AI vừa trình làng GLM-5.3 với 60 điểm trên bảng xếp hạng Artificial Analysis, ngang bằng Kimi K3. Mô hình MoE này hỗ trợ cửa sổ ngữ cảnh 1M tokens, chi phí vận hành tối ưu hơn và sẽ sớm được phát hành mã nguồn mở theo giấy phép MIT.

Cùng sự kiện, tinh chọn hiển thị «Ra mắt GLM-5.3: Đạt 60 điểm chỉ số thông minh AA, dẫn đầu nhóm mô hình mã nguồn mở»
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (87 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “llm” — Trang 26 | AIHOT.vn