24/09

Thứ Năm · 19 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 55/100

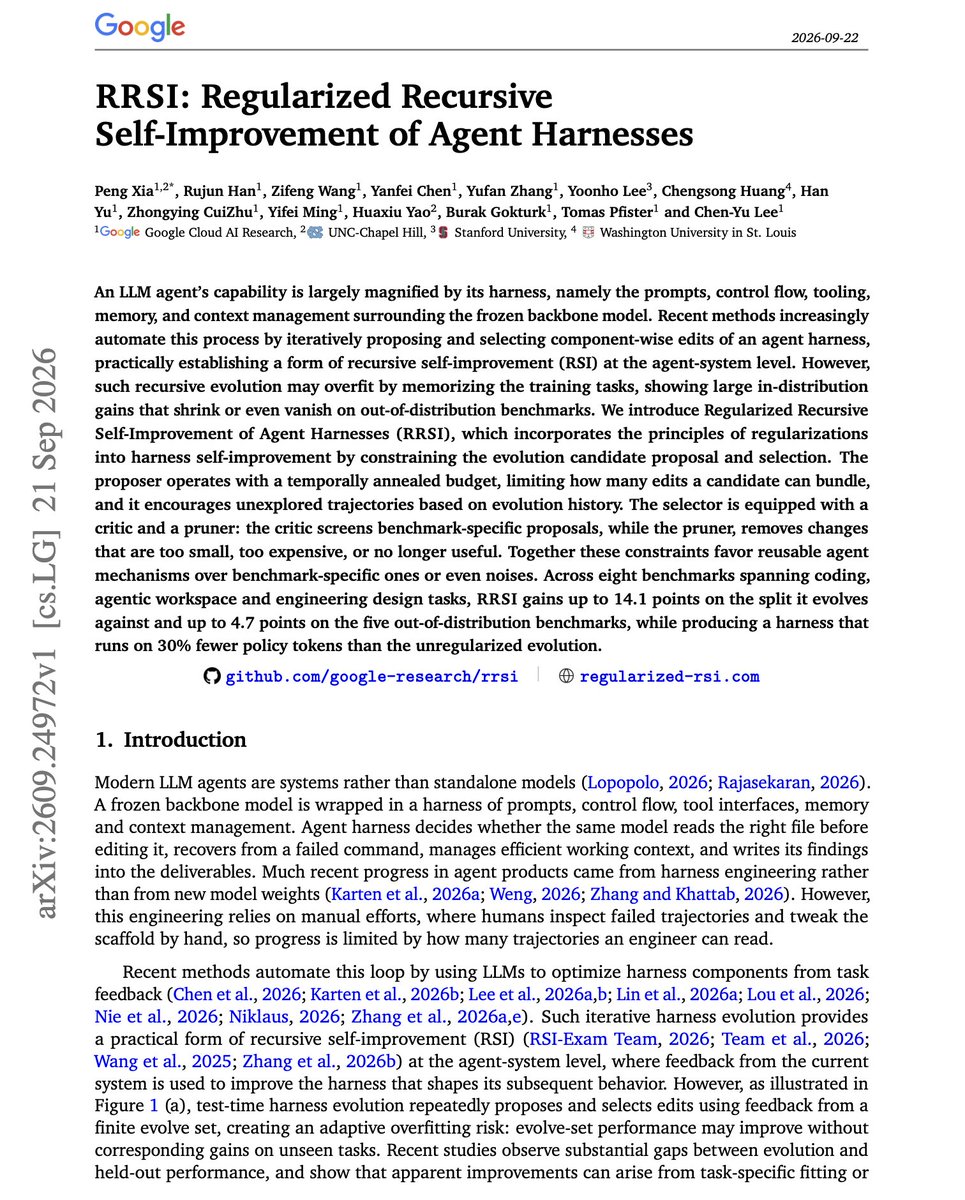
Google công bố nghiên cứu RRSI: Giải pháp ngăn chặn quá tải khi tự tối ưu hóa Agent

Must-read paper from Google on self-improving agent harnesses. If you auto-optimize your agent's ha…

DịchNghiên cứu RRSI từ Google chỉ ra rằng việc tự động tối ưu hóa harness của Agent dễ dẫn đến tình trạng quá tải (overfitting), khiến điểm số đánh giá cao nhưng hiệu suất thực tế lại suy giảm.
Eric Zakariasson@ericzakariasson
Hướng dẫnĐiểm AI 77/100

Tinh chọnBí quyết tối ưu hóa Token cho Agent Harness từ đội ngũ Cursor

here's a prompt to improve your agent harness based on what we've learned at cursor. enjoy # Improv…

DịchChia sẻ bộ prompt giúp giảm 7% chi phí token cho Agent Harness mà không làm giảm chất lượng, thông qua việc tinh gọn prompt, tối ưu hóa công cụ và quản lý bộ nhớ đệm hiệu quả.


Vì sao đáng đọc: Prompt tối ưu hóa chi phí cho agent harness hoàn chỉnh từ kinh nghiệm của đội ngũ Cursor, cung cấp số liệu thực tế, trình tự thực thi và các lỗi thường gặp, có thể tái sử dụng trực tiếp.
Modal Blog kỹ thuật chính thức
Hướng dẫnĐiểm AI 61/100

Tinh chọnModal chia sẻ bí quyết vận hành Kimi K2.6: Tối ưu hóa suy luận cho Agent lập trình quy mô nghìn tỷ token

Modal tiết lộ kỹ thuật tối ưu hóa giúp tăng 2,8 lần hiệu suất mỗi người dùng và 5,6 lần thông lượng cho mô hình Kimi K2.6, cho phép xử lý hàng trăm tỷ token mỗi ngày.


Vì sao đáng đọc: Bài viết phân tích lộ trình tối ưu hóa suy luận cho Agent lập trình từ thực tiễn, giúp người đọc áp dụng các phương pháp xác định điểm nghẽn và định tuyến bộ nhớ đệm KV.
Eric Zakariasson@ericzakariasson
Hướng dẫnĐiểm AI 56/100

Cursor tối ưu hóa quy trình đọc dữ liệu, giảm 7% chi phí token cho AI Agent

agents like to read a lot to gather context before and after working, so optimizing for reading make…

DịchCursor đã cắt giảm 7% chi phí token mà không ảnh hưởng đến chất lượng Agent nhờ tối ưu hóa cách đọc dữ liệu, bao gồm nén file và quản lý prompt thông minh. Dữ liệu cho thấy công cụ 'read' chiếm tới 91,3% tần suất sử dụng trong các phiên làm việc của Agent.

23/09

Thứ Tư · 14 tin
Microsoft Research Blog
Sản phẩmĐiểm AI 53/100

Microsoft ra mắt tính năng giảm tải suy luận cho robot, tối ưu hiệu suất và thời lượng pin

Microsoft Research tích hợp khả năng giảm tải suy luận vào Physical AI Toolchain, cho phép phân bổ khối lượng công việc AI của robot giữa thiết bị, biên và đám mây thông qua Kubernetes, giúp tăng hiệu suất vận hành thực tế.

Thêm 1 nguồn khác đưa tinX: Microsoft Research (@MSFTResearch)
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 52/100

Nghiên cứu từ Microsoft: Nhóm k tác nhân giao tiếp đạt hiệu suất tương đương 4k tác nhân độc lập

Banger paper from Microsoft Research and colleagues. It studies the potential benefits of agents th…

DịchNghiên cứu mới chỉ ra rằng các tác nhân AI giao tiếp qua thư mục chia sẻ giúp tối ưu hóa hiệu suất vượt trội. Kết quả cho thấy nhóm k tác nhân có thể đạt tỷ lệ thành công ngang bằng 4k tác nhân độc lập trong các bài kiểm tra ARC-AGI-3 và nén dữ liệu.

The Verge: AI
Sản phẩmĐiểm AI 58/100

Cùng sự kiệnYouTube ra mắt loạt công cụ AI mới hỗ trợ nhà sáng tạo tối ưu hóa kênh

Tại sự kiện Made on YouTube, nền tảng này đã giới thiệu AI agent giúp tự động phân tích dữ liệu, đề xuất thay đổi tiêu đề, ảnh thu nhỏ và hỗ trợ lập kế hoạch thương hiệu cho nhà sáng tạo.

Cùng sự kiện, bài đại diện «YouTube ra mắt loạt tính năng AI mới cho nhà sáng tạo trong ứng dụng Studio»
Luo Fuli@_LuoFuli
Mô hìnhĐiểm AI 43/100

Cùng sự kiệnMiMo-V3 ra mắt kiến trúc lõi HySparse2: Tối ưu hóa vượt trội cho xử lý văn bản dài

MiMo-V3 is getting a new architecture. The core of it, HySparse2, is out today. Less prefill, a sma…

DịchKiến trúc HySparse2 mới của MiMo-V3 giúp giảm 5,02 lần FLOPs prefill và thu nhỏ 4,5 lần KV cache so với bản tiền nhiệm, đồng thời cải thiện đáng kể hiệu suất trên các bài kiểm tra độ dài ngữ cảnh lớn.

Cùng sự kiện, bài đại diện «Xiaomi hé lộ kiến trúc HySparse2 trên MiMo-V3: Tối ưu cho Agent đa vòng hội thoại dài»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

LatentPort: Chuyển giao bộ nhớ đệ quy giữa các mô hình ngôn ngữ lai mà không cần đọc lại ngữ cảnh

Nghiên cứu giới thiệu kỹ thuật LatentPort cho phép chuyển giao trạng thái bộ nhớ trực tiếp giữa Qwen3.5 4B và 9B mà không cần nạp lại tiền tố, giúp tối ưu hóa hiệu suất suy luận thông qua việc tái sử dụng trạng thái Gated DeltaNet.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Bellman Policy Optimization: Phương pháp tối ưu hóa mới giúp LLM suy luận toán học chính xác hơn

Bellman Policy Optimization (BPO) là phương pháp huấn luyện mô hình ngôn ngữ không cần critic, giúp tối ưu hóa khả năng suy luận thông qua các phần thưởng cuối cùng mà không cần ước tính giá trị trạng thái trung gian.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 47/100

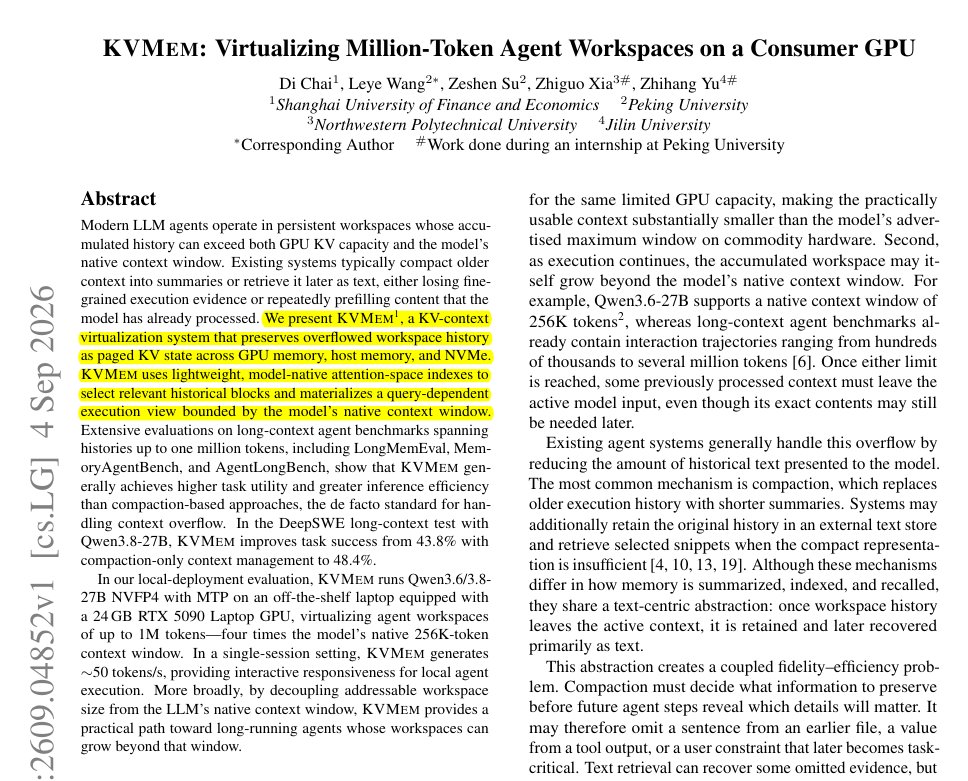
KVMEM: Giải pháp tối ưu hóa bộ nhớ cho AI Agent với khả năng xử lý hàng triệu token

A model's context window does not have to be an agent's workspace limit. KVMEM makes million-token …

DịchKVMEM áp dụng kỹ thuật phân trang trạng thái KV cũ giúp AI Agent xử lý hàng triệu token hiệu quả hơn. Công nghệ này cải thiện đáng kể độ chính xác trên DeepSWE và tăng tốc độ truy xuất dữ liệu gấp nhiều lần so với các phương pháp nén truyền thống.

@completeskeptic@completeskeptic
Sản phẩmĐiểm AI 31/100

Metaview tích hợp Jev: Tăng tốc tìm kiếm ứng viên gấp 10 lần với chi phí tối ưu

the industry is going full jevons faster than anyone ever thought

DịchMetaview đã tích hợp Jev vào toàn bộ hệ thống AI, giúp rút ngắn thời gian tìm kiếm ứng viên từ vài phút xuống vài giây mà vẫn giữ nguyên độ chính xác. Phương pháp này cho phép xây dựng AI theo hướng module hóa, giúp sửa lỗi và tối ưu hiệu suất hiệu quả hơn.

Lauren Tan@poteto
Sản phẩmĐiểm AI 44/100

Ứng dụng desktop Grok tung bản cập nhật lớn: Cải thiện hiệu năng vượt trội với 53 bản sửa lỗi

the Grok @Bot desktop app just got even faster! we shipped 53 perf fixes over the past few days: •…

DịchGrok vừa tối ưu hóa mạnh mẽ ứng dụng desktop với 53 cải tiến, giúp tốc độ kết nối lại nhanh gấp 85 lần, khởi động tức thì và giảm đáng kể mức tiêu thụ tài nguyên hệ thống.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Tối ưu hóa huấn luyện Reinforcement Learning cho LLM với định dạng FP8 toàn trình

Nghiên cứu giải quyết tình trạng mất ổn định khi huấn luyện RL cho LLM bằng FP8, vốn gây ra lỗi sai lệch gradient và làm giảm chất lượng mô hình. Nhóm tác giả đề xuất phương pháp mới giúp duy trì độ chính xác và hiệu suất huấn luyện ổn định hơn.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 45/100

PrimeScientist: Tối ưu hóa ngân sách tự chủ cho các tác nhân nghiên cứu AI

Interesting work on long-horizon research agents. PrimeScientists can decide where a research agent…

DịchPrimeScientist cho phép các tác nhân AI tự quản lý ngân sách nghiên cứu thông qua chiến lược MCTS thích ứng, giúp tăng 10,3% hiệu quả và giảm 50,6% số lần thử nghiệm so với các phương pháp truyền thống.

Nathan Lambert@natolambert
Quan điểmĐiểm AI 27/100

Cùng sự kiệnClaude Opus 5.5 sẽ tự động chuyển sang mô hình nhẹ hơn cho các tác vụ chuyên biệt

Frontier: pacing Pulling up the ladder: accelerating

DịchClaude Opus 5.5 được cho là phiên bản đầu tiên áp dụng cơ chế tự động chuyển đổi sang mô hình có năng lực thấp hơn khi xử lý các tác vụ chuyên sâu như phát triển nhân hệ điều hành, nhằm tối ưu hóa hiệu suất và tài nguyên.

Cùng sự kiện, tinh chọn hiển thị «Claude Code cập nhật v2.1.280: Ra mắt Claude Opus 5.5 làm mô hình mặc định»

22/09

Thứ Ba · 13 tin
LlamaIndex: Sản phẩm, kỹ thuật và đánh giá
Sản phẩmĐiểm AI 65/100

Tinh chọnLiteParse cập nhật tháng 9: Tăng tốc PDFium 25%, bổ sung định vị thị giác và API định tuyến

LlamaIndex ra mắt LiteParse 2.14.6 với tối ưu hóa bộ nhớ, giúp giảm thời gian trích xuất văn bản xuống còn 2,76ms/trang, đồng thời bổ sung tính năng định vị thị giác và API is-complex.


Vì sao đáng đọc: Cập nhật kỹ thuật quan trọng cho công cụ xử lý tài liệu phổ biến, mang lại cải thiện hiệu suất thực tế đáng kể cho các nhà phát triển ứng dụng RAG.
JiQiZhiXin
Mô hìnhĐiểm AI 92/100

Tinh chọnKhi sở hữu 10.000 hay 100.000 GPU: Làm thế nào để mở rộng quy mô huấn luyện RL?

Bài viết phân tích chiến lược tối ưu hóa Batch Size trong huấn luyện Reinforcement Learning (RL) quy mô lớn, giúp cân bằng giữa hiệu suất tính toán và thời gian huấn luyện để tiết kiệm chi phí vận hành hàng triệu USD.


Vì sao đáng đọc: Chủ đề cực kỳ thực tế cho các kỹ sư AI và doanh nghiệp đang chạy mô hình lớn, phân tích sâu về bài toán tối ưu hóa chi phí và hiệu suất phần cứng.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 38/100

Chỉ cần 1% Token: Tối ưu hóa chưng cất chính sách trực tuyến (OPD) bằng lý thuyết thông tin

Nghiên cứu chỉ ra rằng có thể đạt hiệu suất tương đương hoặc vượt trội so với chưng cất toàn phần chỉ với 0,1%-1% token. Bằng cách sử dụng chỉ số hiệu quả thông tin (IER), phương pháp này giúp chọn lọc dữ liệu huấn luyện tối ưu, tiết kiệm tài nguyên đáng kể cho các mô hình ngôn ngữ lớn.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 45/100

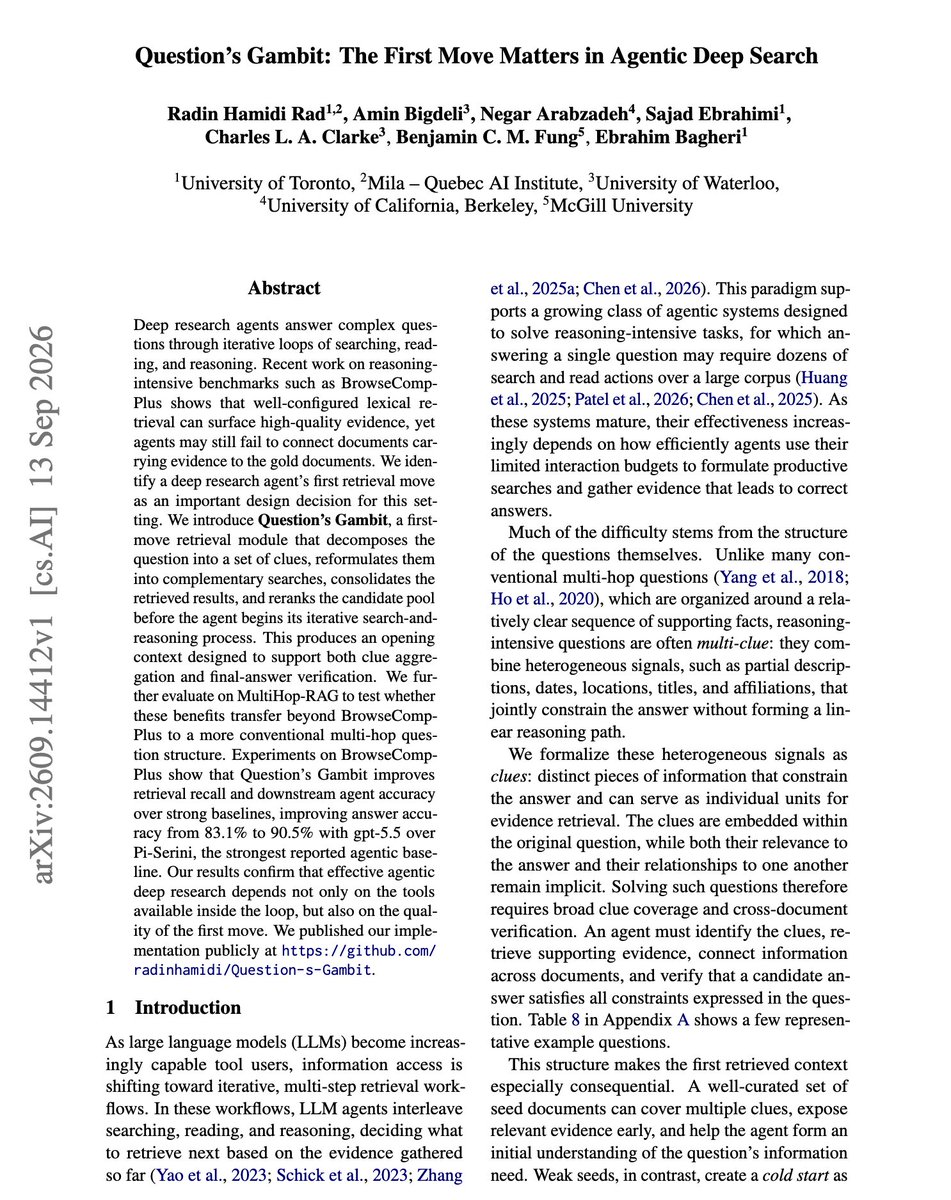
Question's Gambit: Bước đột phá giúp AI nghiên cứu chuyên sâu hiệu quả hơn

Impressive paper showing how much the first retrieval step matters for deep research agents. It hel…

DịchPhương pháp mới giúp AI phân tách câu hỏi thành các manh mối bổ trợ và sắp xếp dữ liệu trước khi tìm kiếm, giúp tối ưu hóa ngữ cảnh đầu vào cho các tác vụ nghiên cứu phức tạp.

Logan Kilpatrick@OfficialLoganK
Hướng dẫnĐiểm AI 30/100

Nhà phát triển AI: Hãy dành ít nhất 25% thời gian cho việc kiểm thử chuẩn (benchmarking)

if you are building a product using AI, you should be spending > 25% of your time making benchmark…

DịchLogan Kilpatrick nhấn mạnh rằng việc tập trung vào kiểm thử chuẩn là con đường ngắn nhất để tối ưu hóa sản phẩm AI và thúc đẩy sự phát triển của công ty.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 42/100

SkillLift: Tối ưu hóa tiến hóa kỹ năng cho AI Agent với chi phí thấp hơn 70%

Nice paper showing a better way to evolve agent skills. And they achieve 40-70% less token cost com…

DịchSkillLift sử dụng tiêu chuẩn đánh giá học được để xếp hạng các gợi ý kỹ năng, giúp giảm 40-70% chi phí tự tiến hóa cho AI Agent mà vẫn vượt trội hơn các phương pháp hiện có trên hàng trăm tác vụ.

SemiAnalysis@SemiAnalysis_
Nghiên cứuĐiểm AI 37/100

SemiAnalysis phân tích bài toán tính toán và luân chuyển dữ liệu trong suy luận mô hình MoE

Computation and Data Movement for Inference Mapping MoE models onto inference hardware: structure, f…

DịchBài viết đi sâu vào cách tối ưu hóa kiến trúc phần cứng để vận hành hiệu quả các mô hình MoE, tập trung giải quyết nút thắt về luân chuyển dữ liệu trong quá trình suy luận.

Rohan Paul@rohanpaul_ai
Sản phẩmĐiểm AI 50/100

White Circle ra mắt Halo: Framework hậu huấn luyện mã nguồn mở hiệu suất cao

White Circle just unveiled Halo, an open-source, distributed post-training framework for models that…

DịchHalo là framework hậu huấn luyện phân tán giúp tối ưu hóa hiệu suất vượt trội so với HuggingFace TRL, đạt tốc độ nhanh gấp 2.8 lần và tiết kiệm 25% bộ nhớ mà vẫn giữ nguyên định dạng mô hình gốc.

21/09

Thứ Hai · 14 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 95/100

Tinh chọnĐột phá AI: Giảm 50% chi phí huấn luyện với mô hình 'Dự đoán khái niệm' từ Shanghai AI Lab

Nhóm nghiên cứu từ Shanghai AI Lab và ĐH Giao thông Thượng Hải giới thiệu mô hình NCP-ArchPreview, thay thế dự đoán từ ngữ (NTP) bằng dự đoán khái niệm (NCP), giúp tăng tốc độ hội tụ gấp 1,95 lần và cải thiện hiệu suất suy luận đáng kể.


Vì sao đáng đọc: Đây là bước tiến quan trọng thay đổi tư duy huấn luyện LLM truyền thống, có tác động lớn đến hiệu quả chi phí và hiệu năng, được cộng đồng quốc tế đánh giá rất cao.
Hugging Face: Blog
Nghiên cứuĐiểm AI 47/100

Multiverse: Ứng dụng vật lý lượng tử để tối ưu hóa việc cắt tỉa mô hình LLM

Multiverse giới thiệu phương pháp cắt tỉa khối LLM bằng cách chuyển đổi thành bài toán tối ưu hóa Ising, giúp chọn cấu hình nén tối ưu mà không cần chạy benchmark. Kết quả trên Llama-3.3-70B cho thấy hiệu suất vượt trội, tăng 23% điểm MMLU so với các phương pháp truyền thống.

Hugging Face: Blog
Mô hìnhĐiểm AI 46/100

Hugging Face ra mắt Tokenizers v1: Tối ưu hóa hiệu năng vượt trội

Hugging Face vừa phát hành Tokenizers v1 với tốc độ xử lý nhanh gấp hàng chục lần phiên bản cũ nhờ kiến trúc workspace mới, kỹ thuật SIMD và tối ưu hóa đa luồng, trong khi vẫn đảm bảo tính tương thích hoàn toàn với các token ID cũ.

Thêm 1 nguồn khác đưa tinX: Clément Delangue (Hugging Face CEO) (@ClementDelangue)
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 40/100

ECDYSIS: Tối ưu hóa huấn luyện AI Agent thông qua phân tích mô hình lỗi

If an agent rewrites its runtime for every bad decision, it can learn the wrong lesson Fix recurrin…

DịchECDYSIS là khung vận hành mới giúp AI Agent học từ các nhóm lỗi tương đồng thay vì sửa lỗi đơn lẻ, giúp tăng độ chính xác, tốc độ huấn luyện và khả năng thích ứng trên nhiều mô hình khác nhau.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MoME: Cơ chế nhúng bộ nhớ hỗn hợp giúp LLM hiểu ngữ cảnh tốt hơn

MoME thay thế các bảng nhúng tĩnh bằng cơ chế hỗn hợp nhiều khe cắm, cho phép mô hình truy xuất thông tin linh hoạt dựa trên ngữ cảnh thay vì chỉ dựa vào từ khóa, giúp cải thiện hiệu suất đáng kể cho các dòng LLM như Llama-3 hay Qwen.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 75/100

Tối ưu hóa mã hóa thưa tích chập thích ứng qua nút thắt thông tin cho biểu diễn thị giác

Nghiên cứu đề xuất khung mã hóa thưa tích chập (CSC) có khả năng tự học hệ số thưa thông qua thuật toán FISTA, giúp cân bằng hiệu quả giữa việc nén dữ liệu và bảo toàn thông tin quan trọng cho các tác vụ thị giác máy tính.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (54 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Tối ưu hóa” — Trang 2 | AIHOT.vn