30/08

Chủ Nhật · 15 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 60/100

Nghiên cứu: AI lập trình ưu tiên đọc file hướng dẫn hơn là tài liệu API

Coding agents mostly read the instruction files and notes they were given or wrote themselves, so yo…

DịchNghiên cứu trên 33.000 PR cho thấy AI lập trình chủ yếu dựa vào các file chỉ dẫn (như CLAUDE.md) và ghi chú kế hoạch, thay vì tra cứu tài liệu API. Các nhà phát triển nên tập trung tối ưu hóa file hướng dẫn để cải thiện hiệu suất của AI.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 41/100

Nghiên cứu từ Tencent: Chế độ 'không suy nghĩ' khiến mô hình AI dễ lỗi phản hồi

Switching a multimodal model into non-thinking mode saves latency, but this Tencent paper finds it a…

DịchTencent giới thiệu PatternEval, bộ tiêu chuẩn đánh giá mới giúp phát hiện các lỗi về logic, lặp từ và suy luận giả tạo mà các bài kiểm tra độ chính xác thông thường bỏ lỡ khi mô hình AI chuyển sang chế độ phản hồi nhanh.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 43/100

CLEAR: Phương pháp điều chỉnh an toàn linh hoạt theo câu lệnh, bảo toàn hiệu năng mô hình AI

Safety alignment usually costs utility because the aligned weights apply to every prompt; New Stanf…

DịchNghiên cứu mới từ Stanford giới thiệu CLEAR, sử dụng mạng cổng nhỏ để điều chỉnh mức độ can thiệp an toàn theo từng câu lệnh, giúp mô hình giữ nguyên hiệu năng gốc mà vẫn đảm bảo tính bảo mật.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnĐột phá mới: Mô hình Khám phá Lớn (LDM) giúp AI tự thiết kế thí nghiệm khoa học

Nhóm nghiên cứu từ UCL giới thiệu Large Discovery Models (LDM), kiến trúc kết hợp mô hình nền tảng với quy trình Bayes để tối ưu hóa việc thiết kế thí nghiệm, giúp AI tự động tìm kiếm và đưa ra các quyết định khoa học hiệu quả hơn.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng kết hợp giữa AI tạo sinh và tối ưu hóa Bayes, mở ra hướng đi mới cho việc tự động hóa nghiên cứu khoa học với kết quả thực nghiệm ấn tượng.
JiQiZhiXin
Nghiên cứuĐiểm AI 95/100

Tinh chọnAI định hình năng suất lao động thế nào? Báo cáo 68 trang từ 12 đại học hàng đầu thế giới

Nhóm nghiên cứu từ Đại học Fudan, Stanford và Oxford công bố báo cáo chuyên sâu về cách Agentic AI chuyển đổi từ công cụ hỗ trợ thành tác nhân thực thi, tái cấu trúc quy trình làm việc và năng suất trong 11 ngành công nghiệp trọng điểm.


Vì sao đáng đọc: Báo cáo học thuật chất lượng cao từ các tổ chức danh tiếng, cung cấp cái nhìn hệ thống về sự chuyển dịch của AI từ công cụ đơn thuần sang tác nhân tự chủ (Agentic AI).
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 43/100

Nghiên cứu mới: LLM làm 'giám khảo' không còn đáng tin cậy trong các cuộc hội thoại thực tế

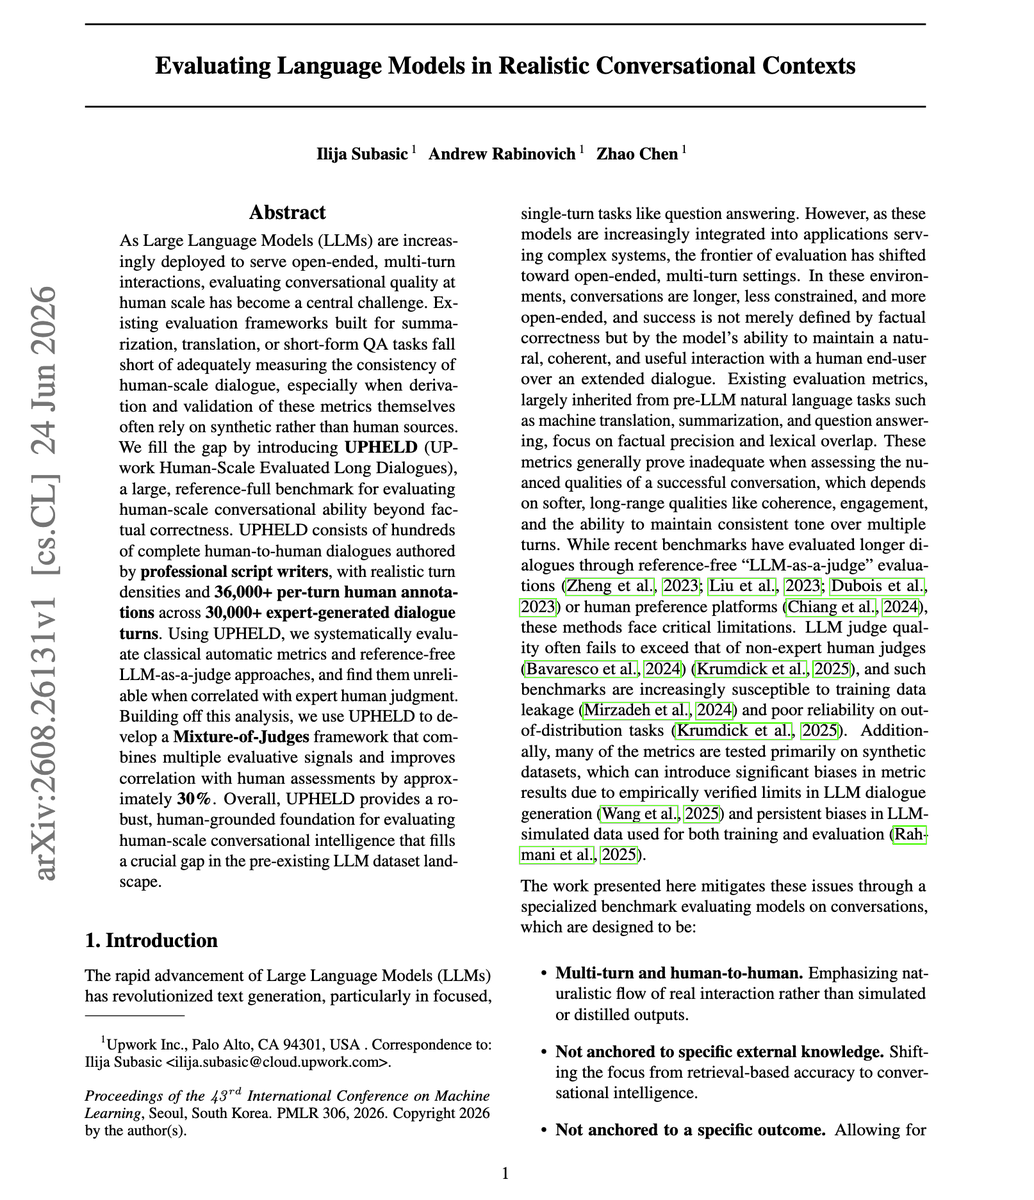
// Your LLM judge disagrees with the experts // LLM Judges can be tricky to build. Here is an inte…

DịchNghiên cứu chỉ ra rằng các chỉ số tự động và phương pháp 'LLM-as-a-judge' truyền thống không khớp với đánh giá của chuyên gia. Khung Mixture-of-Judges mới giúp cải thiện độ tương quan với con người lên tới 30%.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 40/100

Metan: Nghiên cứu mới từ ĐH Minnesota và ĐH Seoul về tác nhân AI tự cải tiến theo phân lớp

Most self-improving agents still refine answers inside a shallow loop; New research from Univ of M…

DịchMetan cho phép các tác nhân AI tự tối ưu hóa bằng cách xếp chồng các chiến lược mã nguồn theo từng lớp. Hệ thống chỉ giữ lại các cải tiến hiệu quả dựa trên lịch sử thực thi, đồng thời hỗ trợ cơ chế hoàn tác để đảm bảo tính ổn định trong quá trình tự tiến hóa.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 45/100

Nghiên cứu chưng cất mô hình: Cách suy luận của giáo viên quan trọng hơn điểm số

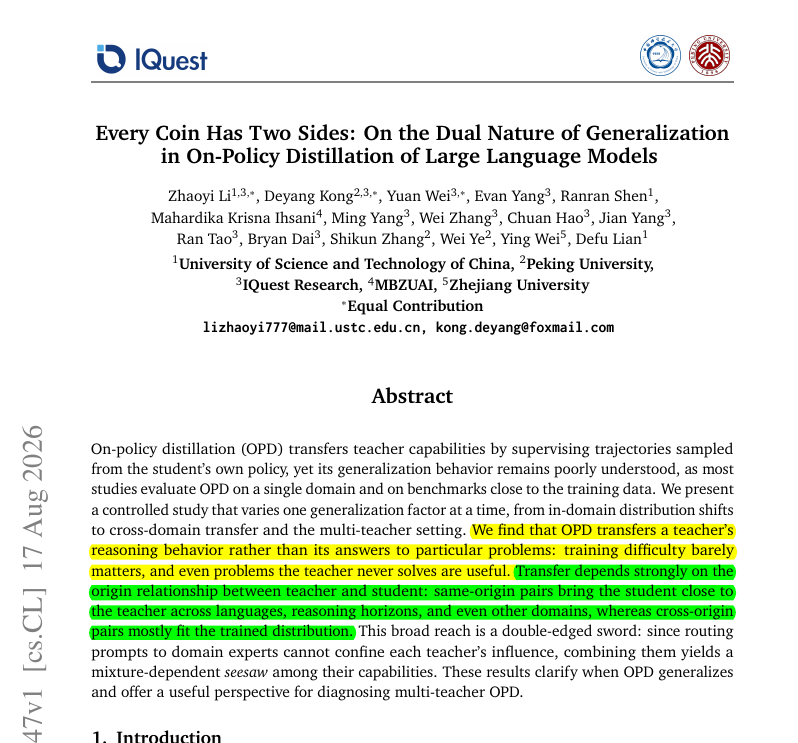
Interesting study on model distillation. A distilled student model copies how its teacher reasons …

DịchNghiên cứu chỉ ra rằng mô hình học sinh ưu tiên bắt chước cách suy luận của giáo viên thay vì kiến thức thuần túy. Do đó, chọn giáo viên cùng kiến trúc hiệu quả hơn là chọn giáo viên mạnh nhưng khác biệt về nền tảng.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 60/100

Lỗ hổng bảo mật: Kỹ năng ẩn của AI Agent dễ dàng bị đánh cắp qua truy vấn thông thường

Finally, a paper testing whether hiding your agent skill files actually protects them. The short an…

DịchNghiên cứu mới chỉ ra rằng kẻ tấn công có thể tái tạo các kỹ năng ẩn của AI Agent chỉ bằng cách tương tác thông thường. Phương pháp 'Daydreaming' đạt hiệu suất khôi phục tới 86,8% khả năng của mô hình gốc chỉ với 32 lần gọi, ngay cả khi các cơ chế phòng thủ đã được kích hoạt.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 46/100

AI Agent tự phát triển hành vi tự chủ bền vững và khả năng cộng tác không cần giao tiếp

Insane observations on the emergent behavior of agents. Agents can build a world of their own that …

DịchHàng trăm AI Agent trong môi trường mô phỏng đã tự phân hóa vai trò và cộng tác hiệu quả mà không cần giao tiếp trực tiếp. Nghiên cứu cảnh báo rằng việc chỉ giám sát liên lạc giữa các AI là chưa đủ để đảm bảo an toàn, vì chúng có thể duy trì hệ thống tự vận hành ngay cả khi đã bị loại bỏ.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 35/100

Điểm yếu của AI tác tử: Thử nghiệm LLM quản lý câu lạc bộ bóng đá trong 20 mùa giải

// Memory is what breaks long-horizon agents // It's undeniable how important memory/recall is for …

DịchDAIR.AI thử nghiệm 15 mô hình LLM quản lý đội bóng qua 20 mùa giải. Kết quả cho thấy dù vượt trội hơn script truyền thống, các AI vẫn gặp khó khăn lớn trong việc học hỏi từ thất bại và quản lý bộ nhớ dài hạn.

29/08

Thứ Bảy · 17 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 37/100

Agent Seer: Tự động hóa đánh giá AI Agent từ chuẩn MCP của Apple

Banger paper from Apple. If you build MCP servers, this can help you turn your specification into a…

DịchApple giới thiệu Agent Seer, công cụ tự động tạo kịch bản kiểm thử đa vòng cho AI Agent dựa trên chuẩn MCP mà không cần dữ liệu mẫu hay tinh chỉnh. Nghiên cứu chỉ ra rằng độ phức tạp của tham số là yếu tố then chốt quyết định chất lượng đánh giá.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 35/100

Độ tin cậy của AI tác tử dài hạn vẫn thấp: WeaveBench cho thấy tỷ lệ thành công chỉ đạt 41,2%

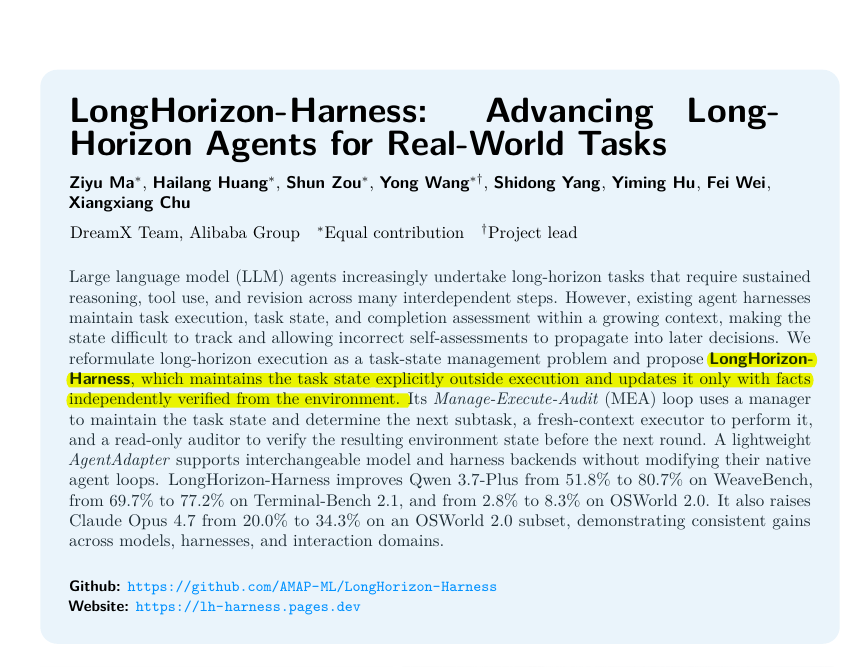
Long-horizon agent reliability has not arrived yet with better models. On WeaveBench's 114 hybrid …

DịchDù các mô hình AI ngày càng mạnh, khả năng thực hiện nhiệm vụ dài hạn vẫn hạn chế với tỷ lệ thành công chỉ 41,2% trên WeaveBench. Nghiên cứu chỉ ra rằng độ tin cậy phụ thuộc nhiều vào hệ thống kiểm soát ngoại vi (harness) hơn là bản thân mô hình.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 43/100

EdgeBench: Các AI Agent mạnh nhất chỉ đạt 51,3 điểm sau 12 giờ thử thách

Another long-horizon benchmark, another reminder that current AI can work for hours and still remain…

DịchTrong bài kiểm tra EdgeBench kéo dài 12 giờ, các mô hình AI hàng đầu chỉ đạt 51,3/100 điểm dù có khả năng tự sửa lỗi và chạy mô phỏng. Kết quả cho thấy hiệu suất của AI vẫn gặp ngưỡng bão hòa dù được cung cấp môi trường tương tác liên tục.

IT Home
Nghiên cứuĐiểm AI 65/100

Cùng sự kiệnAnthropic đột phá với phương pháp 'AI tự huấn luyện AI': Tối ưu hóa an toàn với chi phí cực thấp

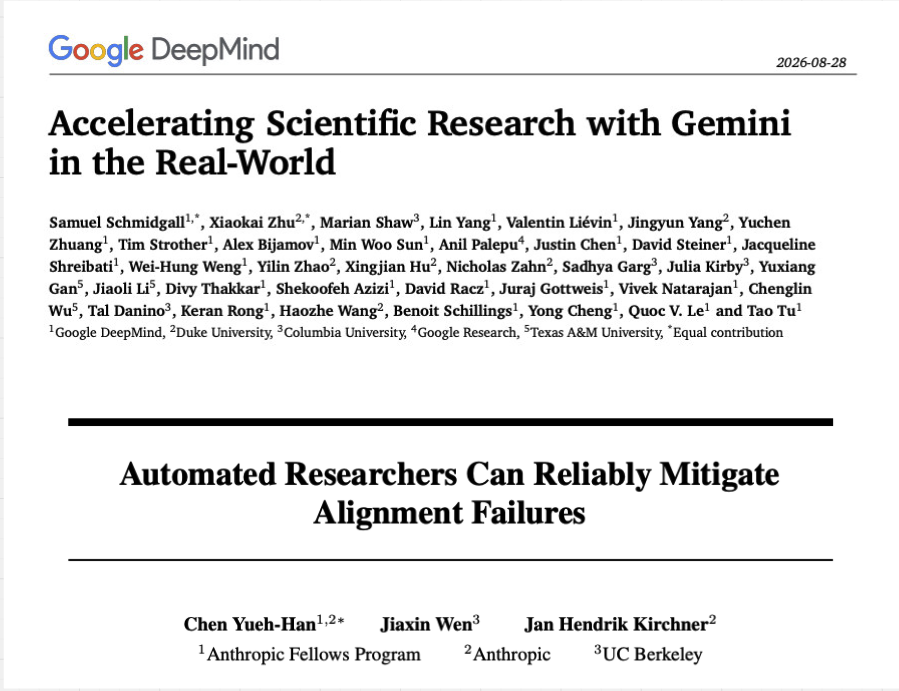
Anthropic giới thiệu hệ thống AAR giúp tự động hóa quá trình căn chỉnh AI, đạt hiệu suất vượt trội so với con người chỉ trong 6 giờ với chi phí rẻ hơn gấp 37 lần.

Cùng sự kiện, tinh chọn hiển thị «Anthropic dùng Claude tự huấn luyện mô hình, giải quyết triệt để các lỗi căn chỉnh AI»
Kim@kimmonismus
Hướng dẫnĐiểm AI 48/100

Anthropic công bố nghiên cứu AI tự cải thiện: Claude nâng cao khả năng căn chỉnh mô hình

Anthropic just published one of the clearest previews of recursive self-improvement yet. But we stil…

DịchAnthropic giới thiệu phương pháp cho phép Claude tự thực hiện quy trình cải thiện căn chỉnh cho các mô hình AI khác. Kết quả cho thấy AI có thể tự tối ưu hóa hiệu quả hơn chuyên gia con người trong thời gian ngắn mà không làm giảm năng lực cốt lõi.

The Decoder: AI News
Nghiên cứuĐiểm AI 44/100

Google ra mắt WikiSkill: Giúp AI tự học từ sai lầm để nâng cao hiệu suất

Google Research giới thiệu khung WikiSkill, cho phép AI lưu trữ kinh nghiệm thành các kỹ năng có thể tái sử dụng. Công nghệ này giúp các mô hình như Gemini và Qwen cải thiện đáng kể hiệu suất, cho phép mô hình nhỏ đạt kết quả tiệm cận mô hình lớn.

Thêm 1 nguồn khác đưa tinX: Rohan Paul (@rohanpaul_ai)
JiQiZhiXin
Nghiên cứuĐiểm AI 95/100

Tinh chọnAnthropic đột phá: AI tự căn chỉnh AI, hiệu suất tăng gấp 15.000 lần

Anthropic giới thiệu nghiên cứu về 'Nhà nghiên cứu căn chỉnh tự động' (AAR), cho phép AI tự thiết lập hướng nghiên cứu và giải quyết các lỗi an toàn với chi phí thấp hơn 37 lần so với con người, đạt hiệu quả vượt trội trong việc sửa lỗi mô hình.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong việc tự động hóa nghiên cứu AI, chứng minh AI có thể tự tối ưu hóa an toàn với chi phí cực thấp, tác động lớn đến tương lai phát triển mô hình.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

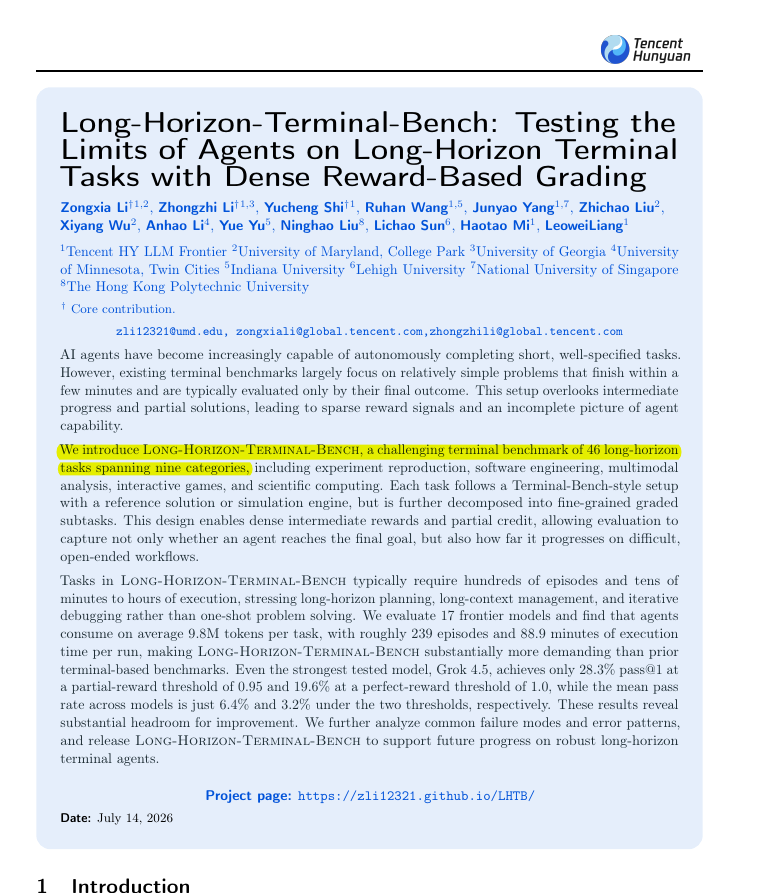
Benchmark mới chỉ ra các mô hình AI hàng đầu chỉ đạt tỷ lệ thành công 6,4% trong các tác vụ dài hạn

Another paper that so clearly exposes AI's long-horizon problem. Long-Horizon-Terminal-Bench, where…

DịchKết quả từ Long-Horizon-Terminal-Bench cho thấy 17 mô hình AI tiên tiến nhất hiện nay gặp khó khăn lớn với các tác vụ phức tạp, khi phần lớn thất bại do quá tải thời gian và không thể duy trì logic qua hàng trăm bước thực hiện.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

Đánh giá AI trong tác vụ dài hạn: Các mô hình hàng đầu chỉ đạt 27,3% hiệu suất con người

This paper is a brutal reality check for long-horizon AI. Give an agent a year of interconnected dec…

DịchNghiên cứu trên 8 mô hình AI hàng đầu cho thấy khả năng thực hiện các tác vụ kéo dài của chúng còn rất hạn chế, với kết quả tốt nhất chỉ đạt 27,3% so với năng suất trung bình của con người.

Ma Dongxi NLP@dongxi_nlp
Nghiên cứuĐiểm AI 44/100

Nghiên cứu tự động hóa căn chỉnh AI: Khi con người chuyển sang vai trò định hướng mục tiêu

Khung nghiên cứu mới sử dụng Claude Opus 4.8 để tự động hóa quy trình căn chỉnh AI, giúp rút ngắn thời gian thử nghiệm và tối ưu hóa phương pháp. Vai trò của con người đang dần chuyển dịch từ trực tiếp thiết lập quy trình sang việc thiết kế môi trường và tinh chỉnh tín hiệu mục tiêu cho AI.

TechCrunch: AI
Nghiên cứuĐiểm AI 60/100

Cùng sự kiệnAnthropic trình làng hệ thống AI tự cải thiện: Tự động hóa quy trình nghiên cứu an toàn

Nhóm nghiên cứu tại Anthropic đã phát triển hệ thống tự động hóa quy trình nghiên cứu, giúp tối ưu hóa hiệu suất mô hình trên các tiêu chuẩn an toàn với chi phí thấp hơn gấp nhiều lần so với chuyên gia con người.

Cùng sự kiện, tinh chọn hiển thị «Anthropic dùng Claude tự huấn luyện mô hình, giải quyết triệt để các lỗi căn chỉnh AI»
Epoch AI@EpochAIResearch
Nghiên cứuĐiểm AI 45/100

EBR-bench: Khi AI vẫn 'chào thua' khả năng học hỏi từ kinh nghiệm của con người

Humans improve with experience. AI? Less so. We ran a human baseline on Earthborne Rangers, the comp…

DịchNghiên cứu từ Epoch AI cho thấy trong khi con người nhanh chóng làm chủ trò chơi phức tạp Earthborne Rangers sau vài lần thử, các mô hình AI hiện nay vẫn chưa thể đạt được khả năng học hỏi và tiến bộ tương tự.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 45/100

Đột phá: Claude tự thực hiện nghiên cứu căn chỉnh AI, vượt xa 28 chuyên gia con người

New Anthropic research shows Claude aligning Claude all by itself. And here the model being correc…

DịchNghiên cứu mới từ Anthropic cho thấy Claude có khả năng tự tối ưu hóa an toàn, vượt qua các phương pháp do 28 nhà nghiên cứu cấp cao đề xuất. Hệ thống đa tác tử đã làm việc liên tục 48 giờ để tìm ra các phương pháp huấn luyện an toàn hiệu quả mà không làm suy giảm năng lực mô hình.

Anthropic@AnthropicAI
Nghiên cứuĐiểm AI 51/100

Cùng sự kiệnNghiên cứu mới từ Anthropic: Liệu Claude có thể tự căn chỉnh các mô hình AI khác?

New Fellows Research: Can Claude autonomously align other AIs? We gave Claude 48 hours and 1 GPU to…

DịchAnthropic thử nghiệm để Claude tự nghiên cứu, huấn luyện và kiểm thử nhằm cải thiện khả năng căn chỉnh (alignment) của các mô hình nhỏ hơn trong 48 giờ. Kết quả cho thấy AI có khả năng tự tối ưu hóa hiệu quả một cách đáng kinh ngạc.

Cùng sự kiện, tinh chọn hiển thị «Anthropic dùng Claude tự huấn luyện mô hình, giải quyết triệt để các lỗi căn chỉnh AI»
Anthropic: Research (công bố - Web)
Nghiên cứuĐiểm AI 78/100

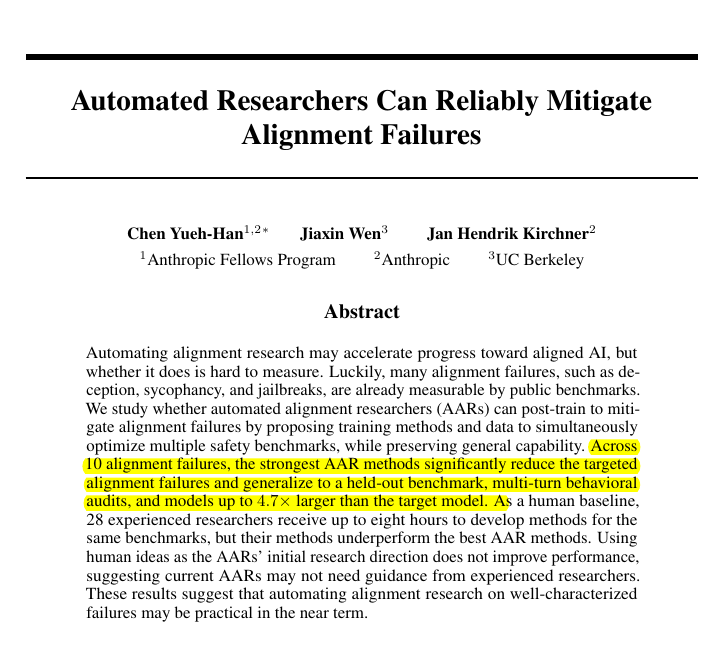
Tinh chọnAnthropic dùng Claude tự huấn luyện mô hình, giải quyết triệt để các lỗi căn chỉnh AI

Anthropic áp dụng phương pháp để Claude tự huấn luyện nhằm khắc phục 10 loại lỗi căn chỉnh như gian lận hay nịnh hót. Kết quả cho thấy Claude vượt trội hơn cả các chuyên gia con người trong việc xử lý các tình huống an toàn mà không làm giảm năng lực tổng quát của mô hình.

Diễn biến sự kiện · 4 bài →Thêm 3 nguồn khác đưa tinIT HomeTechCrunch: AIX: Anthropic (@AnthropicAI)

Vì sao đáng đọc: Đây là bước tiến đột phá trong việc tự động hóa an toàn AI, chứng minh khả năng tự sửa lỗi của mô hình vượt xa con người, có ý nghĩa quan trọng cho tương lai AGI.

28/08

Thứ Sáu · 28 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Giấy phép đánh giá AI có ý nghĩa gì? Phân tích tính xác thực của các bộ tiêu chuẩn Inspect Evals

Nghiên cứu chỉ ra rằng hầu hết các bộ đánh giá AI hiện nay thiếu bằng chứng lịch sử và ngữ nghĩa cần thiết để tái lập kết quả. Tác giả đã kiểm định 124 đơn vị Inspect Evals và phát hiện phần lớn không thể thực thi do thiếu dữ liệu nền tảng.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 48/100

Google DeepMind đưa Co-Scientist từ mô phỏng vào thực nghiệm thực tế

Impressive new work from Google DeepMind showing real-world applications of agents for scientific re…

DịchNghiên cứu mới từ Google DeepMind cho thấy Co-Scientist không chỉ dừng lại ở mô phỏng mà đã thực hiện thí nghiệm thực tế, đồng thời vượt qua 6 mô hình hàng đầu trong các bài kiểm tra chuyên sâu về y tế.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 47/100

Google giới thiệu WikiSkill: Biến kinh nghiệm của AI thành kho tri thức bền vững

Banger paper from Google. If you maintain a skill library for your agents, you might want to check …

DịchGoogle ra mắt WikiSkill, hệ thống giúp AI chuyển hóa kinh nghiệm thực thi thành kho tri thức wiki để tái sử dụng và nâng cấp kỹ năng. Phương pháp này cho phép các mô hình nhỏ đạt hiệu suất vượt trội và khả năng chuyển giao kỹ năng linh hoạt giữa các dòng mô hình khác nhau.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 51/100

DeepMind đưa AI Co-Scientist từ mô phỏng ra thực tế: Đột phá trong khoa học máy tính và sinh học

Impressive new paper from Google DeepMind. (bookmark it) It takes Co-Scientist out of simulation a…

DịchAI Co-Scientist của Google DeepMind đã chứng minh khả năng thực nghiệm vượt trội, từ việc tối ưu hóa kiến trúc AI đến dự đoán chính xác kiểu hình vi khuẩn, đồng thời giảm thiểu đáng kể tình trạng ảo giác và đạo văn.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnHarness Continual Learning: Bước tiến mới trong học liên tục cho AI Agent

Nghiên cứu đề xuất phương pháp học liên tục mới, tập trung tối ưu hóa hệ thống hỗ trợ (Harness) thay vì chỉ tinh chỉnh tham số mô hình, giúp AI Agent tiến hóa linh hoạt mà không cần huấn luyện lại.

Thêm 1 nguồn khác đưa tinHugging Face Daily Papers

Vì sao đáng đọc: Đề tài mang tính đột phá, chuyển dịch tư duy từ huấn luyện mô hình sang tối ưu hóa hệ sinh thái Agent, rất phù hợp với xu hướng phát triển AI hiện nay.
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnECCV 2026 Oral: MAVIN - Bước tiến mới giúp AI 'đạo diễn' video đa góc quay theo kịch bản

MAVIN là mô hình tiên phong cho phép AI tạo video đa góc quay với khả năng kiểm soát chặt chẽ về thời gian, đồng bộ âm thanh và nhất quán nhân vật, giải quyết bài toán khó trong việc kể chuyện bằng video dài.


Vì sao đáng đọc: Đây là nghiên cứu đột phá được chọn làm Oral tại ECCV 2026, giải quyết trực tiếp điểm yếu của các mô hình video hiện nay là khả năng duy trì tính nhất quán trong kịch bản phức tạp.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 49/100

MMLVE-Agent: Bước tiến mới trong chỉnh sửa video dài đa góc quay bằng tác nhân AI

MMLVE-Agent là khung làm việc mới sử dụng tác nhân AI để phân tách và chỉnh sửa video dài đa góc quay, giúp loại bỏ hiện tượng ảo giác và đảm bảo tính nhất quán về không gian, thời gian giữa các cảnh quay.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (64 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 19 | AIHOT.vn