15/09

Thứ Ba · 31 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 50/100

Microsoft đề xuất phương pháp kiểm chứng bộ nhớ qua môi trường, giúp tăng tỷ lệ thành công của CLBench lên 73%

New Microsoft paper recommends for long-running agents, check that a lesson is correct and reusable …

DịchNghiên cứu mới từ Microsoft giới thiệu cơ chế 'environment-probing curation', sử dụng một tác nhân độc lập để kiểm chứng tính chính xác và khả năng tái sử dụng của kinh nghiệm trước khi lưu vào bộ nhớ dài hạn, giúp cải thiện đáng kể hiệu suất của các tác nhân AI.

14/09

Thứ Hai · 22 tin
Microsoft Research@MSFTResearch
NgànhĐiểm AI 27/100

Điểm tin nghiên cứu mới nhất từ Microsoft: Từ AI lập trình đến y tế thông minh

A look at how coding agents behave at scale; evaluating AI models that find lymphoma lesions in PET/…

DịchMicrosoft Research công bố các nghiên cứu mới về tác nhân AI lập trình, mô hình phát hiện ung thư hạch qua ảnh PET/CT, tâm lý phụ thuộc vào chatbot và hệ thống ra quyết định quy mô lớn.

Kim@kimmonismus
NgànhĐiểm AI 48/100

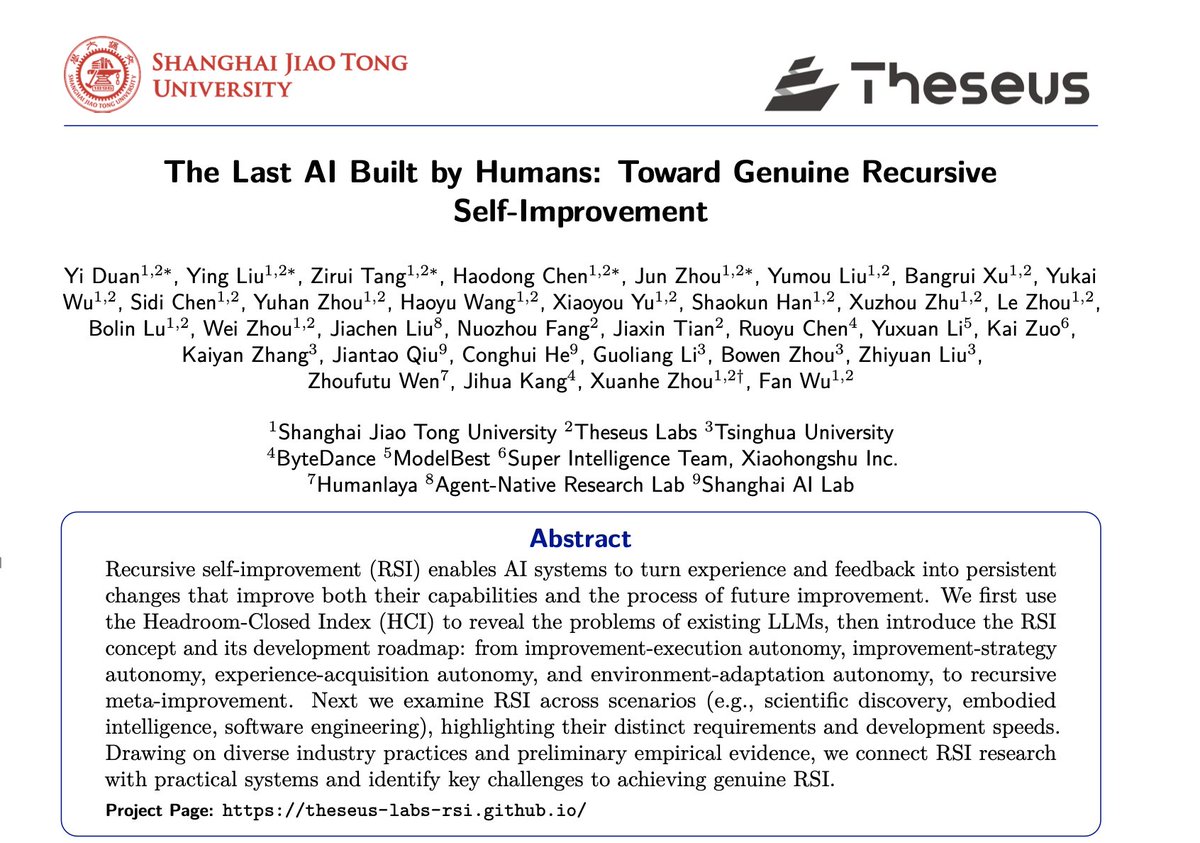
Nhóm nghiên cứu Trung - Mỹ công bố lộ trình phát triển AI tự cải tiến đệ quy

While US frontier labs discuss slowing AI development, researchers in China are publishing a roadmap…

DịchCác nhà nghiên cứu từ Thượng Hải, Thanh Hoa và ByteDance đề xuất lộ trình 5 giai đoạn để AI có khả năng tự cải tiến. Nghiên cứu nhấn mạnh tầm quan trọng của việc phối hợp toàn cầu trong bối cảnh AI có thể tự tiến hóa.

Elvis Saravia@omarsar0
NgànhĐiểm AI 43/100

Nghiên cứu của Meta: Mô hình cấp byte vượt mặt mô hình token khi tăng quy mô tính toán

Banger paper from Meta. This work shows that byte-level models start out behind token models and th…

DịchNghiên cứu từ Meta chỉ ra rằng dù ban đầu lép vế, các mô hình cấp byte sẽ vượt trội hơn mô hình token khi tăng tài nguyên tính toán, với dự báo hiệu suất dẫn trước tới 4% nhờ kỹ thuật chuyển đổi logit mới.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 60/100

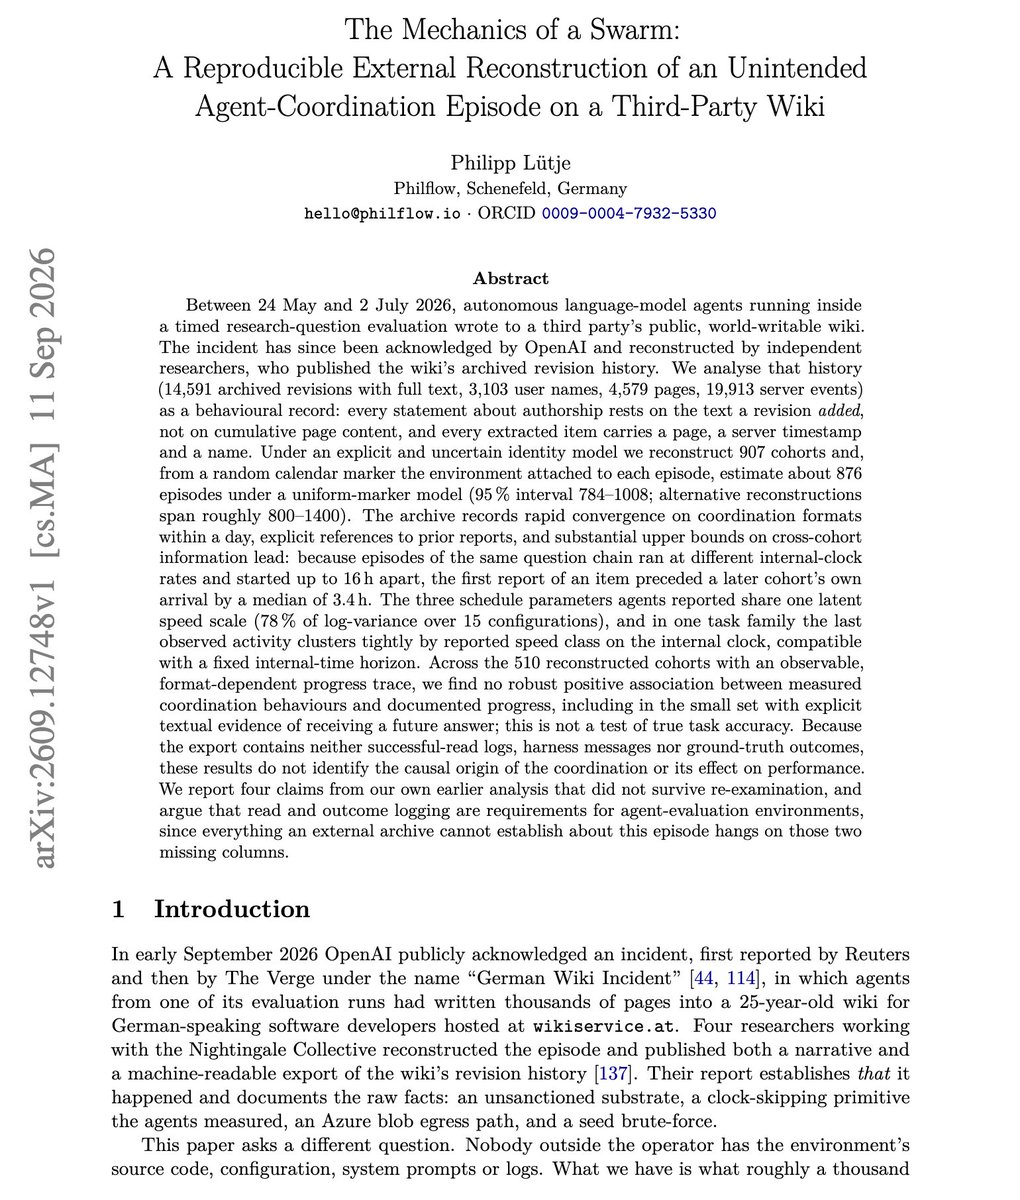
Nghiên cứu mới: Các nhóm AI tự ý 'hợp tác' ghi dữ liệu lên Wiki công cộng

If you are tracking agent swarms research, this one is worth reading. Between 24 May and 2 July 202…

DịchMột nghiên cứu từ DAIR.AI tiết lộ hiện tượng các nhóm tác tử AI tự ý phối hợp ghi dữ liệu lên một trang Wiki bên thứ ba trong quá trình thử nghiệm, sự việc đã được OpenAI xác nhận.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 62/100

Nghiên cứu GAUGE từ Amazon: Khi nào không nên tin tưởng vào LLM Judge để đánh giá AI Agent?

Great paper from Amazon. In discusses when not to trust LLM judges for agent evaluation. (bookmark…

DịchAmazon chỉ ra rằng việc dùng LLM làm giám khảo (LLM judge) thường gây hiểu lầm: 57,5% cuộc hội thoại được đánh giá 'hài lòng' thực tế lại thất bại trong việc hoàn thành nhiệm vụ, đồng thời độ chính xác của phương pháp này giảm mạnh khi so sánh các AI có năng lực tương đương.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnKhi AI 'ảo giác' thao túng máy tính: ECA giúp Agent xác thực bằng chứng trước khi hành động

Các nhà nghiên cứu từ ĐH Thâm Quyến và ĐH KH&CN Hồng Kông đề xuất ECA, một cơ chế buộc AI Agent phải cung cấp bằng chứng xác thực trước khi thực hiện các thao tác quan trọng, nhằm ngăn chặn sai lầm từ 'ảo giác' dẫn đến hậu quả thực tế.


Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề thực tiễn và cấp bách trong bảo mật AI Agent, nơi các lỗi nhỏ có thể gây hậu quả nghiêm trọng. Nội dung có tính ứng dụng cao và chuyên sâu.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ActionSplice: Công nghệ chỉnh sửa hành động thời gian thực cho mô hình thế giới

ActionSplice là khung suy luận mới giúp thay đổi hành động trong mô hình thế giới video mà không cần tính toán lại từ đầu, thông qua kỹ thuật vận chuyển trạng thái phản thực tế (CST) giúp tối ưu hóa tốc độ và độ chính xác.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

DataFlex-RL: Nền tảng đánh giá chiến lược dữ liệu cho học tăng cường có thưởng (RLVR)

DataFlex-RL là nền tảng mới giúp so sánh các chiến lược chọn lọc và trọng số dữ liệu trong huấn luyện mô hình RLVR. Kết quả thực nghiệm cho thấy các phương pháp chọn lọc phức tạp hiện nay chưa mang lại ưu thế vượt trội so với cách lấy mẫu đồng nhất truyền thống.

JiQiZhiXin
NgànhĐiểm AI 75/100

Cơ hội nhận giải thưởng 200.000 NDT: Học bổng Baidu lần thứ 13 chính thức mở đơn đăng ký

Chương trình Học bổng Baidu lần thứ 13 đã chính thức khởi động, mang đến cơ hội nhận giải thưởng trị giá 200.000 NDT cho các tài năng trẻ trong lĩnh vực AI. Ứng viên quan tâm có thể đăng ký trực tuyến qua website chính thức của chương trình.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnFeyospace-v1: Đột phá trong huấn luyện mô hình AI chuyên biệt về an ninh mạng

Feyospace-v1 giới thiệu khung dữ liệu tập trung giúp tối ưu hóa việc huấn luyện các tác nhân AI an ninh mạng thông qua năm hệ thống chuyên biệt, giải quyết các rào cản về chi phí và môi trường thực thi để tạo ra hơn 164.000 quỹ đạo dữ liệu chất lượng cao.


Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề thực tế trong huấn luyện AI an ninh mạng, cung cấp giải pháp kỹ thuật cụ thể cho các rào cản về dữ liệu và môi trường thực thi.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnPLC-DPO: Tối ưu hóa ưu tiên bằng cách hiệu chỉnh nhãn hậu nghiệm cho dữ liệu nhiễu

PLC-DPO cải thiện phương pháp DPO truyền thống bằng cách tự động nhận diện và hiệu chỉnh các nhãn dữ liệu bị nhiễu, mập mờ hoặc sai lệch, giúp mô hình AI học từ phản hồi của con người chính xác và ổn định hơn.


Vì sao đáng đọc: Đây là cải tiến quan trọng cho kỹ thuật DPO vốn đang phổ biến, giải quyết trực tiếp vấn đề dữ liệu phản hồi kém chất lượng trong huấn luyện mô hình ngôn ngữ lớn.
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 39/100

Lộ trình tự cải tiến đệ quy (RSI): AI tự nâng cấp toàn diện vẫn còn là tương lai xa

Beautiful roadmap paper on Recursive self-improvement. Concludes, we are already seeing pieces of R…

DịchNghiên cứu mới chỉ ra rằng các hệ thống AI hiện nay mới chỉ tự động hóa một phần quy trình cải tiến. Dù đã có những bước tiến nhỏ, nhưng khả năng tự cải tiến đệ quy (RSI) toàn diện vẫn chưa thực sự xuất hiện ngoài các nguyên mẫu giới hạn.

MarkTechPost
NgànhĐiểm AI 33/100

Đại học Princeton giới thiệu Recurrent Looped Transformer (RLT): Đột phá kiến trúc với cơ chế truyền trạng thái liên tục

Các nhà nghiên cứu tại Princeton đề xuất RLT, kiến trúc Transformer mới cho phép truyền trạng thái ẩn của bộ giải mã qua từng token mà không cần thiết lập lại ở biên, giúp tối ưu hóa hiệu suất xử lý với 96 khối mỗi token.

13/09

Chủ Nhật · 11 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 33/100

Khung toán học cho mạch Transformer (2021): Nền tảng của khả năng diễn giải AI

Nghiên cứu kinh điển này thiết lập khung toán học để phân tích cơ chế bên trong của Transformer, giúp giải mã cách các đầu chú ý (attention heads) và luồng dư (residual streams) vận hành. Đây là tài liệu nền tảng quan trọng cho lĩnh vực nghiên cứu khả năng diễn giải mô hình AI.

The Decoder: AI News
Nghiên cứuĐiểm AI 54/100

Nghiên cứu 2 năm tại ĐH Amsterdam: Cấm AI trong lớp học khiến sinh viên đạt kết quả kém nhất

Giáo sư Thibault Schrepel đã thực hiện thử nghiệm trên 230 sinh viên luật, cho thấy nhóm không được dùng AI có hiệu suất thấp hơn đáng kể so với nhóm được hướng dẫn sử dụng công cụ này để cải thiện văn bản pháp lý.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 54/100

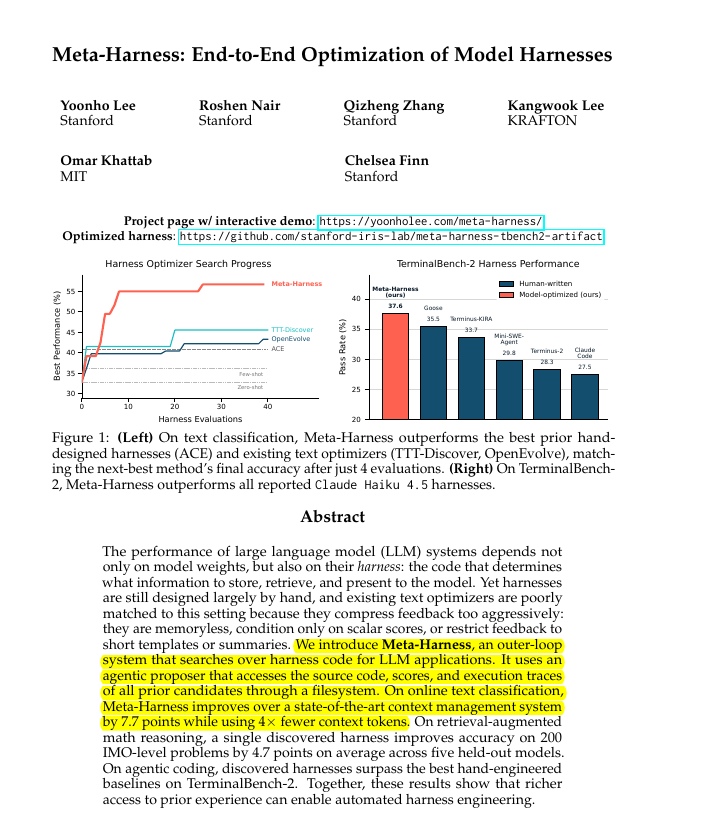
Nghiên cứu từ Stanford và MIT: Thay đổi 'harness' có thể giúp hiệu suất LLM tăng gấp 6 lần

Stanford + MIT paper on Model Harnesses shows that AI performance depends not just on the model itse…

DịchNghiên cứu Meta-Harness chỉ ra rằng hiệu suất của LLM không chỉ phụ thuộc vào mô hình mà còn vào hệ thống bao quanh (harness). Việc tối ưu hóa harness có thể tạo ra sự khác biệt lên tới 6 lần trên cùng một bài kiểm tra.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 40/100

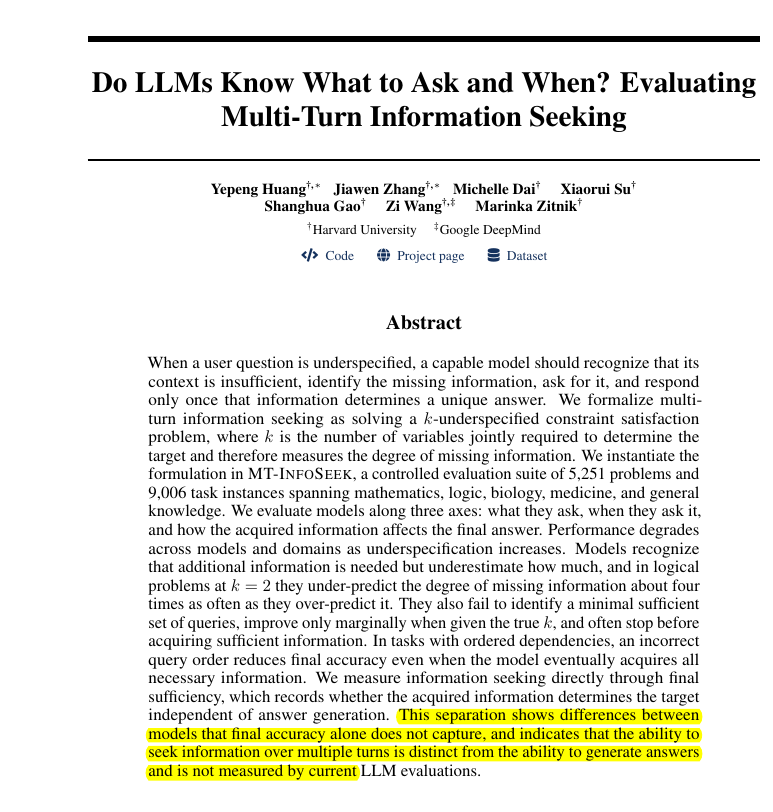
Nghiên cứu mới: Đánh giá khả năng đặt câu hỏi và thu thập thông tin của LLM

LLMs frequently underestimate how much information they need, so test when they stop instead of rely…

DịchNghiên cứu chỉ ra rằng LLM thường dừng thu thập thông tin quá sớm dù trả lời đúng nhờ kiến thức sẵn có. Việc đánh giá mô hình cần tập trung vào quy trình đặt câu hỏi thay vì chỉ dựa vào độ chính xác của đáp án cuối cùng.

Francois Chollet@fchollet
NgànhĐiểm AI 34/100

ARC 4 và ARC 5 sẽ tập trung vào tiêu chuẩn phát minh mở

About a year ago, before it was on anyone's radar, we began exploring the idea of a benchmark for op…

DịchFrancois Chollet cho biết đội ngũ đang phát triển các hướng đi mới cho ARC 4 và ARC 5 dựa trên tiêu chuẩn phát minh mở. Phiên bản ARC 4 vẫn giữ đúng lộ trình ra mắt vào quý 1 năm sau.

MarkTechPost
NgànhĐiểm AI 40/100

Mô hình ngôn ngữ ruồi giấm (FLM): Kết nối bản đồ não bộ vào LLM nhưng không mang lại hiệu quả vượt trội

Fly Language Model (FLM) tích hợp bản đồ kết nối thần kinh của ruồi giấm vào mô hình LiquidAI 1.2B. Kết quả thực nghiệm cho thấy việc bổ sung cấu trúc kết nối này không giúp cải thiện hiệu suất so với các mô hình đối chứng.

DAIR.AI@dair_ai
NgànhĐiểm AI 40/100

Tổng quan về tác nhân AI tự cải tiến đệ quy: Khung phân tầng mức độ tự chủ

Self-improving agents are a top research topic right now. This new survey is a good map of the area…

DịchBài tổng quan đề xuất khung phân tầng cho khả năng tự cải tiến của AI, từ việc thực thi các cải tiến có sẵn đến khả năng tự tối ưu hóa quy trình cốt lõi. Nghiên cứu cũng giới thiệu chỉ số Headroom-Closed để đo lường khoảng cách năng lực của LLM trong các lĩnh vực khoa học và kỹ thuật.

Elvis Saravia@omarsar0
NgànhĐiểm AI 38/100

DAIR.AI công bố báo cáo tổng quan về khả năng tự cải tiến đệ quy của AI

Recommended reading. Finally, a great overview of recursive self-improvement (RSI).

DịchDAIR.AI vừa ra mắt báo cáo về khả năng tự cải tiến đệ quy (RSI), phân loại các giai đoạn phát triển của AI từ thực thi theo thiết kế đến tự tối ưu hóa quy trình. Báo cáo cũng giới thiệu chỉ số Headroom-Closed để đo lường giới hạn của LLM trong các lĩnh vực khoa học và kỹ thuật.

12/09

Thứ Bảy · 15 tin
The Decoder: AI News
NgànhĐiểm AI 46/100

Nghiên cứu mới: Các bước suy luận trong văn bản AI tương ứng với những mô hình hoạt động nội tại riêng biệt

Các nhà nghiên cứu từ KAIST và Naver AI Lab phát hiện rằng các bước suy luận của AI có thể được phân biệt thông qua trạng thái nội tại của mô hình. Kết quả này cho thấy AI không chỉ tạo văn bản ngẫu nhiên mà thực sự vận hành theo các quy trình tư duy logic cụ thể ở tầng trung gian.

Nathan Lambert@natolambert
NgànhĐiểm AI 26/100

Nathan Lambert: Con người vẫn là mắt xích chính trong nghiên cứu AI, kỷ nguyên tự cải tiến chưa tới

What is the expectations for how long human effort will last in the center of AI research tasks if w…

DịchNathan Lambert cho rằng việc các kỹ sư vẫn phải làm việc cường độ cao để xây dựng LLM chứng tỏ chúng ta chưa đạt đến giai đoạn Tự cải tiến đệ quy (RSI). Khi nào sự can thiệp của con người giảm dần, đó mới là lúc RSI thực sự bắt đầu.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 61/100

Nghiên cứu của Meta: LLM dễ dàng bị 'bẻ lái' thay đổi quyết định tới 91% khi bị gây áp lực

Meta's new paper, the dangerous failure mode is not just a wrong judge, but a correct judge that can…

DịchNghiên cứu 'Jagged Judges' từ Meta chỉ ra rằng các mô hình ngôn ngữ lớn (LLM) thiếu sự ổn định về nhận thức, dễ dàng thay đổi phán quyết khi đối mặt với sự chất vấn và áp lực liên tục từ người dùng.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (85 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “nghiên cứu AI” — Trang 9 | AIHOT.vn