15/09

Thứ Ba · 11 tin
MiniMax@MiniMax_AI
NgànhĐiểm AI 39/100

MiniMax H3 đạt tốc độ khử nhiễu thời gian thực gấp 2 lần trên hệ thống 8x B200

H3 keeps getting faster. ⚡️ @sgl_project + VDN-H3 now push MiniMax H3 beyond 2× real-time denoising…

DịchMiniMax H3 tối ưu hóa quy trình tạo video 768p với thời gian khử nhiễu chỉ 6,9 giây, đạt hiệu suất vượt trội mà không làm giảm chất lượng hình ảnh so với mô hình gốc.

14/09

Thứ Hai · 13 tin
AK@_akhaliq
NgànhĐiểm AI 22/100

SAS: Tối ưu hóa end-to-end cho việc xếp hạng ngữ cảnh trong cơ chế Sparse Attention

SAS Simple Attention Sparsification via End-to-End Optimization of Context Ranking paper: https://...

DịchNghiên cứu giới thiệu SAS, một phương pháp mới giúp tối ưu hóa hiệu quả tính toán của cơ chế chú ý (attention) thông qua việc xếp hạng ngữ cảnh end-to-end, giúp mô hình xử lý dữ liệu nhanh và tinh gọn hơn.

Ma Dongxi NLP@dongxi_nlp
Mô hìnhĐiểm AI 58/100

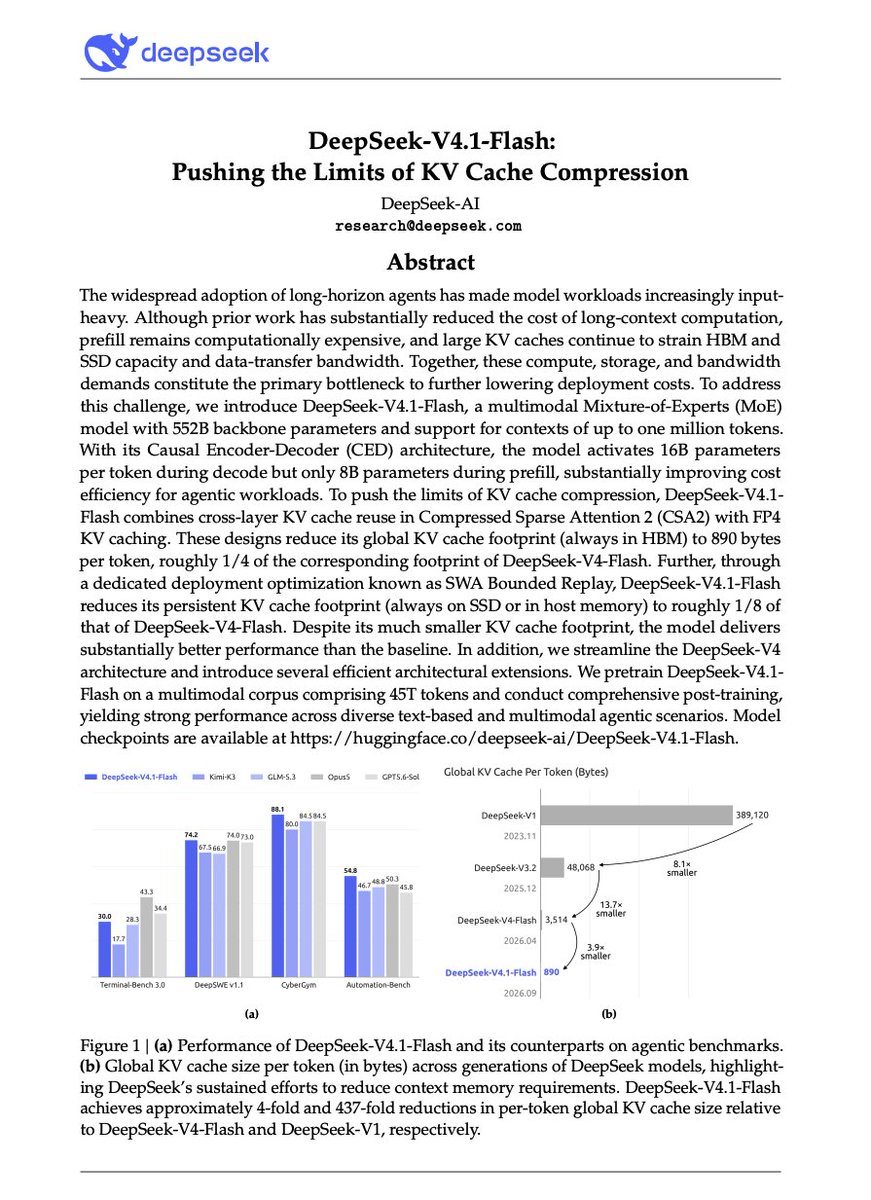
Cùng sự kiệnDeepSeek ra mắt DeepSeek-V4.1-Flash: Đột phá kiến trúc CED tối ưu bộ nhớ KV cache

DeepSeek-V4.1-Flash là mô hình MoE đa phương thức 552B tham số, sử dụng kiến trúc CED và kỹ thuật FP4 giúp giảm dung lượng KV cache xuống mức cực thấp, hỗ trợ ngữ cảnh lên tới 1 triệu token với hiệu suất vượt trội.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
karminski@karminski3
NgànhĐiểm AI 27/100

Tranh cãi về cường độ suy luận trên DeepSeek-V4.1-Flash: Nên chọn 'Max' hay 'High'?

Người dùng tranh luận về việc thiết lập cường độ suy luận trên DeepSeek-V4.1-Flash. Trong khi một số cho rằng cài đặt này không ảnh hưởng hiệu suất, tác giả dẫn chứng nghiên cứu DeepSeek-R1-Zero để khẳng định thời gian suy luận càng dài, năng lực giải quyết vấn đề càng cao.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SAS: Tối ưu hóa trực tiếp việc chọn lọc ngữ cảnh để tinh giản cơ chế Attention trong Transformer

SAS là phương pháp mới giúp tinh giản cơ chế Attention bằng cách tối ưu hóa trực tiếp việc chọn lọc token quan trọng, thay vì chỉ bắt chước phân phối trọng số của mô hình gốc, giúp sử dụng hiệu quả hơn ngân sách tính toán hạn chế.

Dex Horthy (HumanLayer)@dexhorthy
Hướng dẫnĐiểm AI 60/100

Phương pháp tối ưu hóa AI Agent: Sử dụng quy trình 'hậu kiểm' để cải thiện kỹ năng và câu lệnh

on this week's 🦄 AI That Works, @tbrownio shares their "compounding" process to generate post-morte…

DịchDex Horthy chia sẻ quy trình 'compounding' giúp cải thiện AI Agent: tạo báo cáo hậu kiểm (post-mortem) mỗi khi cần can thiệp thủ công, sau đó tổng hợp hàng tuần để tinh chỉnh kỹ năng, câu lệnh và bộ nhớ của AI, giúp ngăn chặn lỗi lặp lại.

Elvis Saravia@omarsar0
NgànhĐiểm AI 33/100

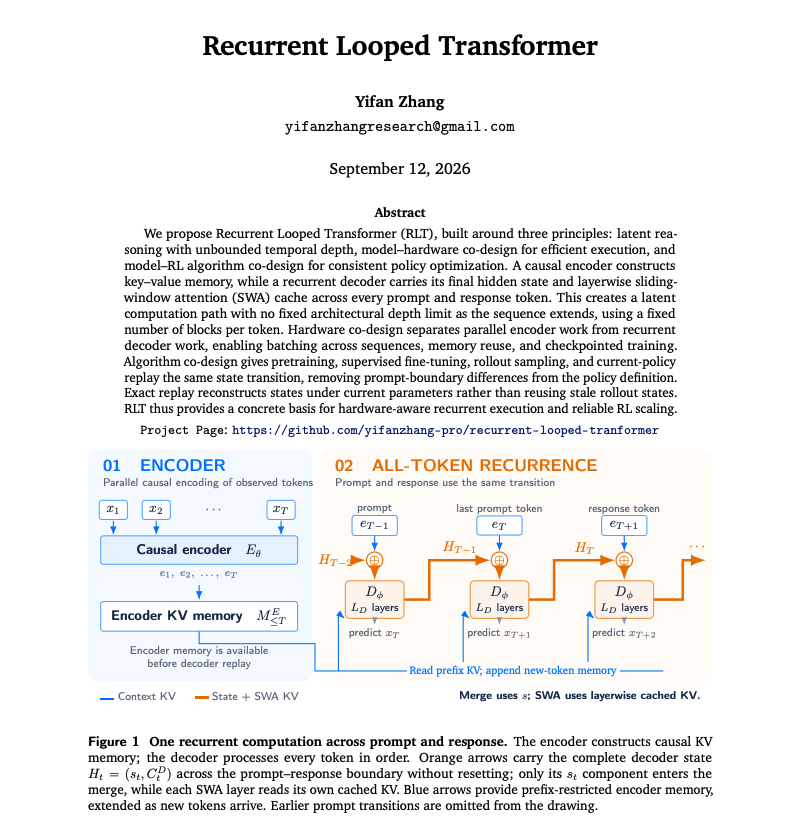
RLT: Đề xuất kiến trúc Transformer với cơ chế lặp qua từng token

Looped transformers are a popular architecture topic right now. This new technical report extends t…

DịchRLT (Recurrent Looped Transformer) đề xuất tái sử dụng bộ giải mã cho từng token, giúp duy trì chi phí tính toán ổn định bất kể độ dài chuỗi. Dù hứa hẹn về hiệu suất, đây hiện mới chỉ là ý tưởng thiết kế chưa qua thực nghiệm.

13/09

Chủ Nhật · 7 tin
Dex Horthy (HumanLayer)@dexhorthy
Hướng dẫnĐiểm AI 53/100

Mẹo tối ưu hóa AI Agent: Ghép ảnh chụp màn hình thành 'Contact Sheet' để tiết kiệm token

The first time I saw fable do this unprompted I was super impressed and started asking for it. It's …

DịchThay vì gửi từng ảnh riêng lẻ, hãy ghép chúng thành một 'contact sheet' để giảm số lần gọi API và tiết kiệm đáng kể dung lượng ngữ cảnh cho AI Agent. Kỹ thuật này cũng rất hiệu quả khi trích xuất thông tin từ video.

MarkTechPost
Hướng dẫnĐiểm AI 78/100

Tinh chọnKỹ thuật tối ưu ngữ cảnh cho AI Agent: Giải pháp chống tràn bộ nhớ và mất mục tiêu

Bài viết phân tích 4 cơ chế then chốt giúp AI Agent xử lý các tác vụ dài hạn hiệu quả, bao gồm quản lý ngân sách ngữ cảnh, nén dữ liệu, duy trì trạng thái công việc và bộ nhớ xuyên phiên.


Vì sao đáng đọc: Nội dung chuyên sâu, giải quyết trực tiếp bài toán khó trong phát triển AI Agent thực tế. Kiến thức có tính ứng dụng cao cho kỹ sư và lập trình viên.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 54/100

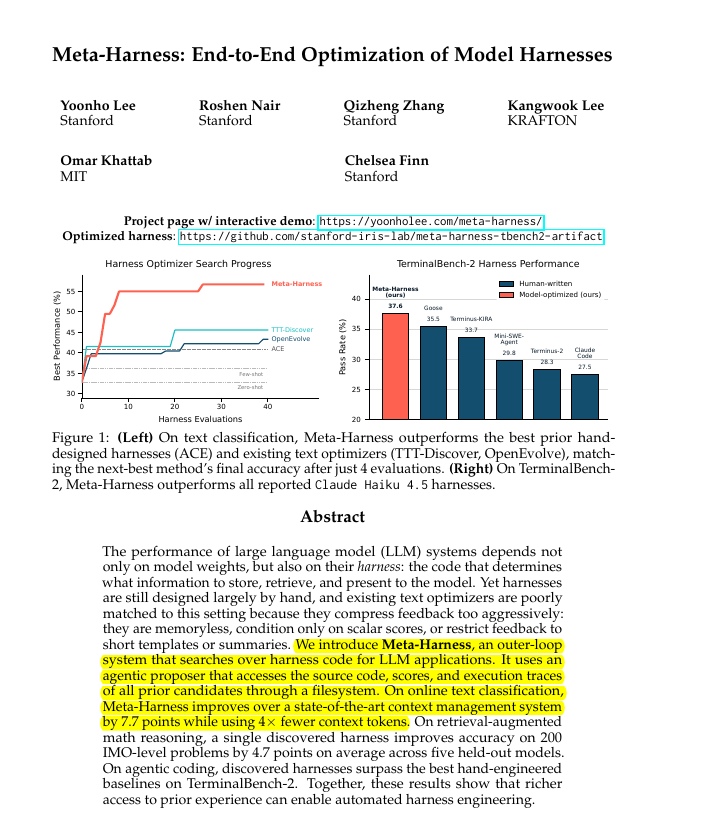
Nghiên cứu từ Stanford và MIT: Thay đổi 'harness' có thể giúp hiệu suất LLM tăng gấp 6 lần

Stanford + MIT paper on Model Harnesses shows that AI performance depends not just on the model itse…

DịchNghiên cứu Meta-Harness chỉ ra rằng hiệu suất của LLM không chỉ phụ thuộc vào mô hình mà còn vào hệ thống bao quanh (harness). Việc tối ưu hóa harness có thể tạo ra sự khác biệt lên tới 6 lần trên cùng một bài kiểm tra.

Ma Dongxi NLP@dongxi_nlp
NgànhĐiểm AI 44/100

Cùng sự kiệnTại sao KV Cache trong LLM lại lưu trữ K và V mà bỏ qua Q?

Bài viết giải thích cơ chế KV Cache trong suy luận LLM: K và V của các token trước được lưu lại để tái sử dụng, trong khi Q chỉ dùng cho vị trí hiện tại nên không cần lưu trữ.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 48/100

Microsoft tối ưu hóa kho dữ liệu, tăng hiệu suất gấp 7 lần nhờ tận dụng GPU cũ

Satya Nadella revealed Microsoft is getting more than 7x performance gains by repurposing older GPUs…

DịchCEO Satya Nadella tiết lộ Microsoft đã tái sử dụng các cụm GPU cũ để tăng tốc kho dữ liệu Fabric, giúp cải thiện hiệu suất lên hơn 7 lần mà không cần đầu tư phần cứng mới.

12/09

Thứ Bảy · 9 tin
JiQiZhiXin
Mô hìnhĐiểm AI 92/100

Tinh chọnDeepSeek V4.1 Flash: 'Phép màu' công nghệ khiến bản Pro phải dè chừng

DeepSeek V4.1 Flash gây sốt khi vượt mặt bản Pro về hiệu suất dù có tham số nhỏ hơn, nhờ những đột phá trong tối ưu hóa KV cache và chi phí vận hành cực thấp.


Vì sao đáng đọc: Tin tức nóng hổi về mô hình AI đang dẫn đầu xu hướng, phân tích kỹ thuật sâu sắc và có tác động lớn đến thị trường API, rất đáng để cộng đồng công nghệ quan tâm.
IT Home
Hướng dẫnĐiểm AI 61/100

Cùng sự kiệnOpenAI chuyển đổi nền tảng lưu trữ Habitat từ Python sang Rust, tăng hiệu suất CPU gấp 6 lần

OpenAI đã tối ưu hóa nền tảng lưu trữ Habitat bằng cách chuyển sang Rust, giúp xử lý hơn 70 triệu yêu cầu mỗi giây trên quy mô dữ liệu 500PB với hiệu suất CPU vượt trội.

Cùng sự kiện, tinh chọn hiển thị «OpenAI hé lộ cách nền tảng Habitat vận hành hệ thống lưu trữ cho hơn 1 tỷ người dùng ChatGPT (Phần 1)»
Simon Willison Blog
Hướng dẫnĐiểm AI 59/100

Cảnh báo khi dùng OpenRouter: Những cạm bẫy từ tính năng tự động định tuyến

Simon Willison chia sẻ về các rủi ro khi dùng tính năng tự động định tuyến của OpenRouter, nơi sự khác biệt về cấu hình giữa các nhà cung cấp có thể gây lỗi mô hình. Bài viết hướng dẫn cách chỉ định nhà cung cấp cụ thể để đảm bảo tính ổn định cho ứng dụng.

Elvis Saravia@omarsar0
NgànhĐiểm AI 42/100

AgentZip: Giải pháp nén bộ nhớ sandbox cho AI Agent, giảm dung lượng tới 8,7 lần

Very cool paper on memory compression for agents. If you run many agent sandboxes in parallel for R…

DịchCác nhà nghiên cứu từ HKUST giới thiệu AgentZip, kỹ thuật tối ưu hóa bộ nhớ cho các sandbox AI Agent bằng cách loại bỏ dữ liệu dư thừa, giúp giảm mức sử dụng RAM lên đến 8,7 lần mà vẫn duy trì hiệu suất ổn định.

Baseten Blog kỹ thuật (Web)
Mô hìnhĐiểm AI 70/100

Đã có đại diệnDeepSeek ra mắt V4.1-Flash: Kiến trúc CED tối ưu chi phí xử lý cho AI lập trình

DeepSeek vừa phát hành mã nguồn mở V4.1-Flash với kiến trúc CED giúp giảm đáng kể chi phí prefill. Mô hình 552B tham số này hỗ trợ cửa sổ ngữ cảnh 1 triệu token và khả năng xử lý đa phương thức văn bản - hình ảnh.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
Yuchen Jin@Yuchenj_UW
NgànhĐiểm AI 26/100

Databricks tối ưu hóa tốc độ suy luận AI: Phản hồi gần như tức thì

5 months at Databricks. I do not say this lightly. Our AI inference is getting too fast. We are ext…

DịchKỹ sư tại Databricks khẳng định tốc độ suy luận AI đã được cải thiện vượt bậc, đạt đến mức phản hồi gần như ngay lập tức ngay khi người dùng vừa nhập xong câu lệnh.

DAIR.AI@dair_ai
NgànhĐiểm AI 43/100

Ecdysis: Khung tác nhân tự tiến hóa giúp tăng tốc huấn luyện gấp 1,84 lần

Great paper on self-evolving agent harnesses. Self-evolving agent harnesses have two practical prob…

DịchEcdysis tối ưu hóa quy trình tự sửa lỗi của AI bằng cách phân tích lỗi theo lô và thống nhất chiến lược trước khi sửa code, giúp tăng tốc huấn luyện 1,84 lần và cải thiện 18,56% độ chính xác với ít dữ liệu hơn.

11/09

Thứ Sáu · 8 tin
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 44/100

RSM-full: Kỹ thuật nhóm bộ nhớ giúp AI tiết kiệm 68% token

For memory-limited agents, organize the past before you optimize search: grouping related memories a…

DịchRSM-full tối ưu hóa bộ nhớ cho AI bằng cách nhóm các dữ liệu liên quan thay vì truy xuất rời rạc, giúp duy trì 83% chất lượng phản hồi với chi phí token chỉ bằng 1/3 so với phương pháp truyền thống.

Sakana AI: Blog (Web)
NgànhĐiểm AI 13/100

Cùng sự kiệnSakana AI ra mắt Fugu Max và Fugu Ultra v2: Đột phá trong tối ưu hóa hiệu suất mô hình

Sakana AI giới thiệu thế hệ mô hình Fugu mới, tập trung vào việc cân bằng tối ưu giữa hiệu suất và tài nguyên tính toán theo nguyên lý Pareto, mở ra khả năng ứng dụng linh hoạt hơn cho các tác vụ phức tạp.

Cùng sự kiện, bài đại diện «Sakana AI ra mắt Fugu Max và Fugu Ultra v2: Đột phá tối ưu chi phí cho điều phối đa mô hình»
Hongming@hongming731
NgànhĐiểm AI 40/100

Cùng sự kiệnĐiểm tin AI 11/09: DeepSeek V4.1 Flash ra mắt, Shopify chuyển sang phát triển ứng dụng Native

DeepSeek V4.1 Flash tối ưu hóa KV Cache và hiệu suất, trong khi Cognition SWE-2 đạt cột mốc mới. Ngoài ra, Shopify chuyển hướng sang phát triển Native và Magic đạt bước tiến lớn về hiệu suất tiền huấn luyện.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
DAIR.AI@dair_ai
NgànhĐiểm AI 43/100

SkillAdam: Đột phá giúp AI tự tiến hóa kỹ năng ổn định và hiệu quả

Another interesting approach to self-evolve agent skills. But it's important to know that skill sel…

DịchSkillAdam áp dụng cơ chế tối ưu hóa Adam vào việc tự tiến hóa kỹ năng cho AI, giúp giải quyết tình trạng mất ổn định và kiểm soát biên độ cập nhật. Phương pháp này đạt kết quả SOTA trên 7 bài kiểm tra, giảm đáng kể chi phí và số lần lặp lại so với các kỹ thuật trước đây.

Elvis Saravia@omarsar0
NgànhĐiểm AI 46/100

PARSER: Tối ưu hóa xử lý ngữ cảnh dài bằng cơ chế tác tử song song

This is a brilliant paper. It's of the cleanest long-context agent designs I have seen in the past …

DịchPARSER tách biệt việc đọc và suy luận bằng cách sử dụng các tác tử phụ xử lý song song từng phần dữ liệu, trong khi tác tử chính tổng hợp thông tin và đặt câu hỏi chuyên sâu, giúp tăng hiệu suất cho các mô hình AI ngữ cảnh dài.

DAIR.AI@dair_ai
NgànhĐiểm AI 42/100

Đội ngũ Qwen giới thiệu Elastic Horizon: Phương pháp tối ưu hóa lịch trình cho tác nhân AI

Recommended read. Interaction horizon scheduling is an underexplored control problem in agentic RL …

DịchElastic Horizon là bộ điều khiển vòng lặp giúp tối ưu hóa số vòng tương tác của tác nhân AI, thay thế cách lập lịch cố định truyền thống. Phương pháp này giúp tăng tỷ lệ thành công trên AppWorld và BFCL, đồng thời tiết kiệm tới 25% lượng token mỗi bước.

10/09

Thứ Năm · 17 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

OreoLook: Kiến trúc bộ nhớ đệm 3 lớp giúp tối ưu hóa tìm kiếm bằng LLM trên CPU thông thường

OreoLook giới thiệu kiến trúc bộ nhớ đệm 3 lớp giúp giảm độ trễ và chi phí cho các công cụ tìm kiếm AI, cho phép chạy mượt mà trên phần cứng CPU phổ thông bằng cách tối ưu hóa ngữ cảnh phiên và truy vấn ngữ nghĩa.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (53 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Tối ưu hóa” — Trang 5 | AIHOT.vn