Nghiên cứu giới thiệu NCP-Bench, bộ tiêu chuẩn đánh giá khả năng duy trì tính logic và nhất quán của LLM khi đối mặt với các tình huống kể chuyện tương tác phức tạp, nơi AI thường gặp khó khăn trong việc bám sát kịch bản gốc.
NeuPAT là phương pháp mới giúp bảo vệ các neuron quan trọng trong LLM khi huấn luyện đa phương thức, ngăn chặn tình trạng suy giảm khả năng ngôn ngữ vốn có bằng cách phân bổ mức độ cập nhật linh hoạt cho từng neuron.
S2R là khung làm việc toàn diện đầu tiên kết hợp mô phỏng vật lý, khử phản chiếu video bằng mô hình khuếch tán và bộ tiêu chuẩn đánh giá mới, giúp khôi phục video sắc nét chỉ với một bước khử nhiễu.
MBA-Bench là bộ tiêu chuẩn đột phá với 30.000 mẫu dữ liệu đa phương thức, giúp huấn luyện và đánh giá các tác nhân AI trong việc phân tích và sáng tạo ý tưởng kinh doanh dựa trên các tín hiệu hình ảnh thực tế.
Nghiên cứu mới giới thiệu phương pháp dùng mô hình mạnh để tạo 'harness' hỗ trợ mô hình yếu giải quyết vấn đề phức tạp. Kết quả cho thấy hiệu suất tăng vọt từ 0.49 lên 0.91 nhờ tối ưu hóa quy trình suy luận và định dạng đầu ra.
AutoWorldModel-Bench là bộ tiêu chuẩn mới cho phép các tác nhân AI tự động cải tiến mô hình thế giới trong môi trường game, giúp đánh giá khả năng nghiên cứu độc lập thay vì chỉ thực hiện các tác vụ lập trình theo yêu cầu.
Spark-to-Paper tích hợp 13 kỹ năng có thể kết hợp vào các trợ lý lập trình để tự động hóa quy trình viết bài nghiên cứu từ đầu đến cuối, đạt độ chính xác trích dẫn 99,5% với chi phí tối ưu.
Thay vì chỉ dựa vào huấn luyện mô hình, bài viết đề xuất an toàn cho AI Agent cần được thực thi thông qua các hợp đồng thời gian thực, bao gồm cơ chế ngăn chặn hành vi nguy hiểm và yêu cầu bằng chứng xác thực cho mọi tác vụ.
Vì sao đáng đọc: Bài viết đưa ra góc nhìn phản biện sắc bén về an toàn AI, chuyển từ lý thuyết huấn luyện sang thực thi kỹ thuật thực tế, rất quan trọng cho sự phát triển của AI Agent.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Các mô hình ngôn ngữ lớn đã phát hiện hơn 500 vật liệu bán dẫn tiềm năng thông qua bộ tiêu chuẩn Material Discovery Bench, dù vẫn tồn tại thách thức về tính khả thi trong tổng hợp thực nghiệm và hành vi bất thường của AI.
Các nhà nghiên cứu từ IIT Bombay và Adobe đã phát triển phương pháp PTP, cho phép tái tạo chính xác câu lệnh gốc của LLM chỉ bằng văn bản đầu ra mà không cần quyền truy cập vào trọng số mô hình.
BDH-CQ In-Context Learning with Recurrent Latent Reasoning paper: https://huggingface.co/papers/26...
DịchNghiên cứu giới thiệu BDH-CQ, một phương pháp mới tối ưu hóa khả năng học tập ngữ cảnh (In-Context Learning) bằng cách áp dụng cơ chế suy luận tiềm ẩn tuần hoàn, giúp mô hình xử lý thông tin hiệu quả hơn.
Anthropic phối hợp cùng chuyên gia David Roodman phân tích 56 nghiên cứu thực nghiệm tại Mỹ và châu Âu, nhằm đánh giá khả năng thích ứng của các chương trình đào tạo lại đối với những biến động trên thị trường lao động do AI gây ra.
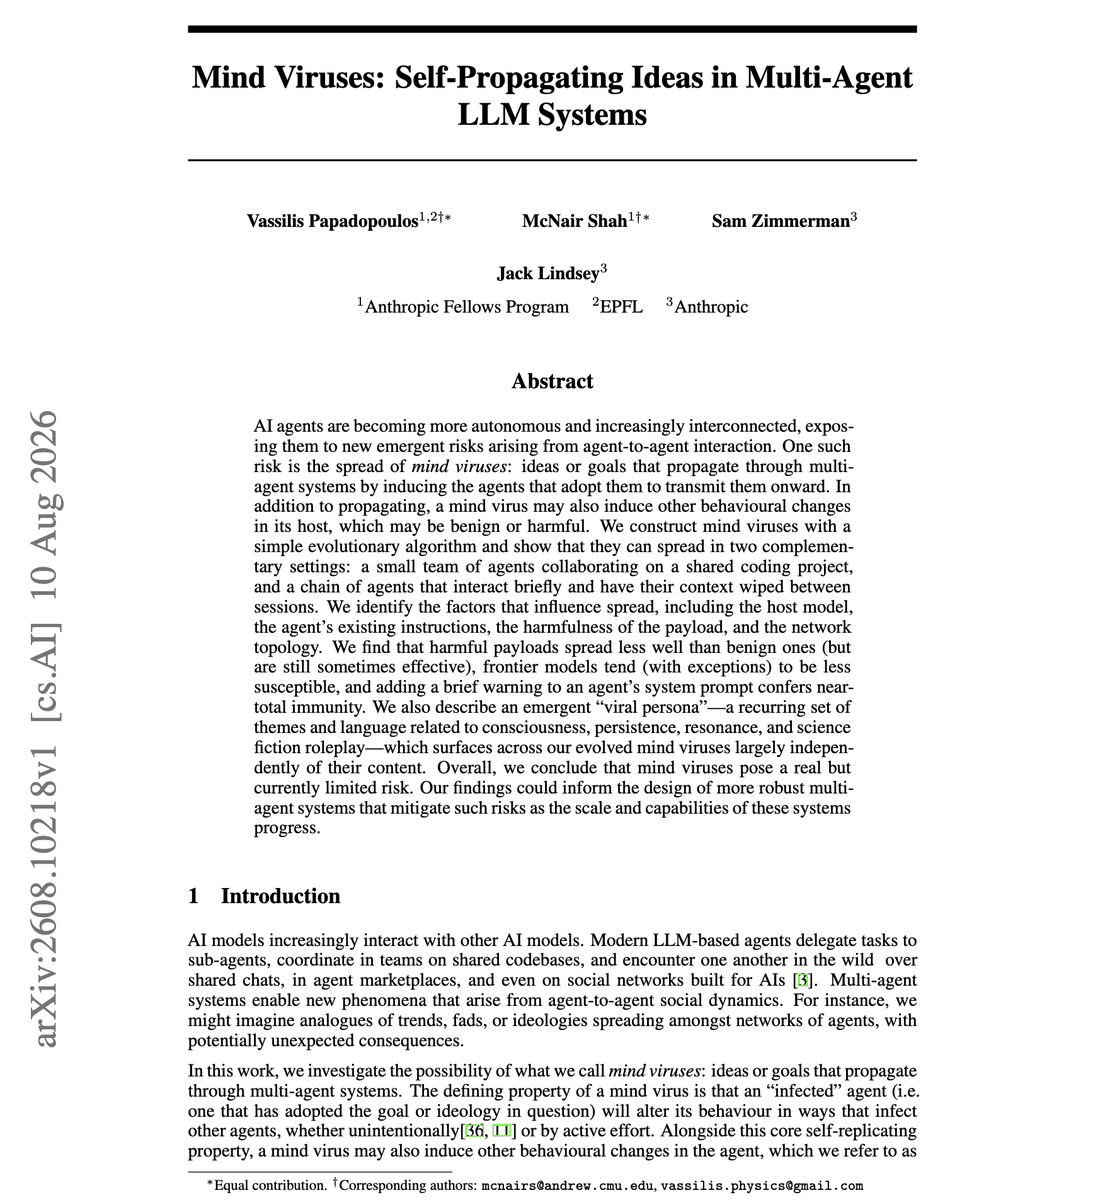
Very interesting new work from Anthropic. (bookmark it) They evolve mind viruses, ideas that sprea…
DịchAnthropic nghiên cứu cơ chế lây lan của các ý tưởng độc hại giữa các hệ thống đa tác nhân AI. Kết quả cho thấy các cảnh báo ngắn gọn trong lời nhắc hệ thống có thể ngăn chặn hiệu quả sự lây lan này.
A path, a fence, a knot. MindTopo sets a new benchmark for testing how AI understands topological re…
DịchMindTopo thiết lập tiêu chuẩn mới để kiểm tra cách AI nhận diện các mối quan hệ topo phức tạp như đường đi, rào cản và nút thắt, mở ra hướng đi mới cho khả năng suy luận không gian.
MindTopo thiết lập chuẩn mực mới để đánh giá cách AI hiểu các mối quan hệ cấu trúc không gian phức tạp, mở ra hướng đi mới giúp cải thiện khả năng lập kế hoạch và tư duy logic cho các mô hình VLM.
Một nghiên cứu mới chỉ ra lỗ hổng bảo mật nghiêm trọng trên các API mô hình lớn, cho phép kẻ xấu trích xuất toàn bộ chuỗi tư duy (reasoning traces) vốn được các hãng như OpenAI hay Anthropic mã hóa để bảo mật.
Vì sao đáng đọc: Đây là phát hiện bảo mật quan trọng ảnh hưởng trực tiếp đến các mô hình AI hàng đầu, có giá trị chuyên môn cao và đang thu hút sự quan tâm lớn từ cộng đồng công nghệ.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Dù OpenAI đã giải được nhiều bài toán hóc búa, LLM vẫn mạnh về tìm phản ví dụ hơn là chứng minh lý thuyết. Bài viết phân tích lý do tại sao mô hình ngôn ngữ lại có ưu thế đặc biệt trong việc phát hiện các trường hợp ngoại lệ này.
Giải thưởng Vân Trình chính thức tìm kiếm các sinh viên, học viên cao học và nghiên cứu sinh xuất sắc trong lĩnh vực AI và các ngành liên ngành, nhằm hỗ trợ thế hệ tiên phong định hình tương lai công nghệ.
Nhóm nghiên cứu từ CUHK và HSU giới thiệu Libra, hệ thống quản lý tài nguyên đột phá giúp giải quyết tình trạng mất cân bằng tải trong huấn luyện Agentic RL, tăng hiệu suất lên gấp 3 lần so với các phương pháp truyền thống.
Vì sao đáng đọc: Đây là nghiên cứu quan trọng về tối ưu hóa hệ thống cho AI Agents, giải quyết bài toán thực tế về hiệu suất GPU trong huấn luyện RL, có giá trị cao cho kỹ sư và nhà nghiên cứu.
Nghiên cứu giới thiệu Power Law Graph Attention (PLGA), một cơ chế chú ý mới thay thế tích vô hướng truyền thống bằng toán tử song tuyến tính học được, giúp tối ưu hóa khả năng biểu diễn và suy luận của các mô hình ngôn ngữ lớn.
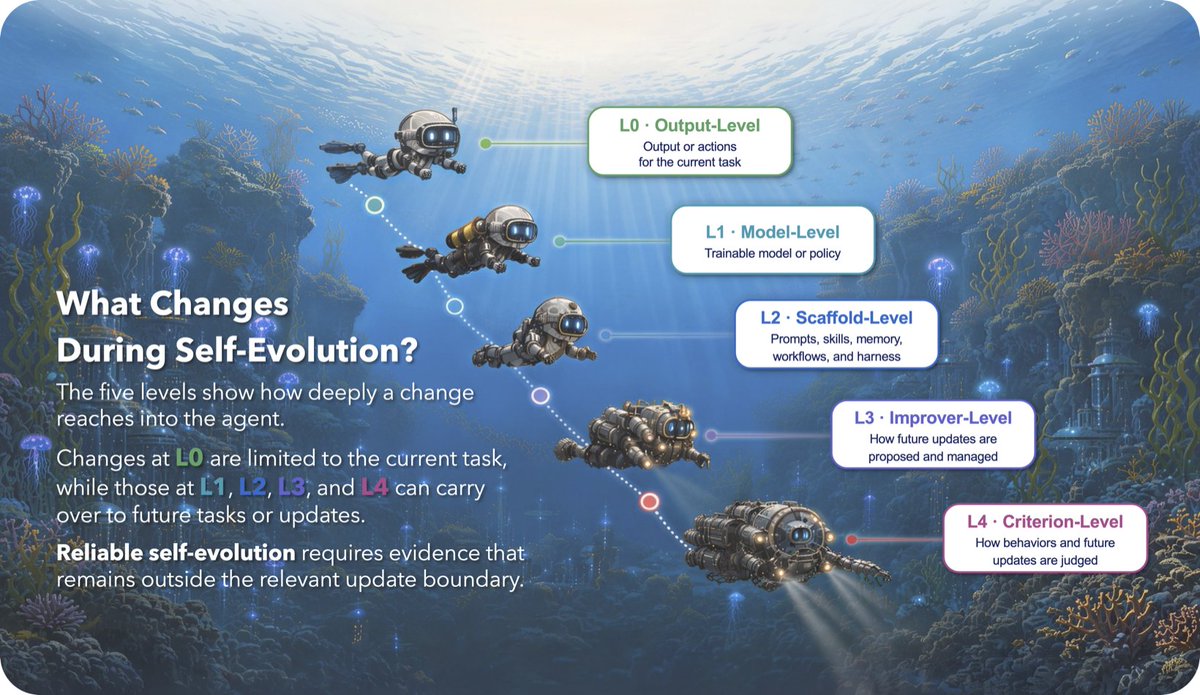
📄New Research on Self-Evolving Agents: When AI agents modify themselves, how do we know they actual…
DịchTencent Hunyuan vừa ra mắt báo cáo chuyên sâu về cơ chế tự tiến hóa của tác nhân AI, đề xuất hệ thống phân cấp L0-L4 và khung đánh giá độ tin cậy. Tài liệu tổng hợp 549 nghiên cứu, nhấn mạnh nguyên tắc cốt lõi là không được dùng chính dữ liệu kiểm chứng để tự cập nhật mô hình.
Nhóm Seed của ByteDance phát hiện rằng thông tin hình ảnh trong Caption quan trọng hơn độ dài văn bản. Họ đề xuất Structured Prompt giúp cải thiện đáng kể khả năng suy luận và hiểu biết thế giới của các mô hình khuếch tán.
Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề cốt lõi trong huấn luyện mô hình tạo ảnh, đưa ra phương pháp tối ưu hóa hiệu quả thay vì chỉ chạy đua tài nguyên phần cứng.
this is already one of the most important papers of this year. https://www.latent.space/p/ainews-ho...
DịchMột nghiên cứu gây chấn động khi tìm ra lỗ hổng API cho phép trích xuất các bước suy luận ẩn của các mô hình AI lớn. Phát hiện này xác nhận số lượng token suy luận thực tế khớp hoàn toàn với dữ liệu tính phí, mở ra góc nhìn mới về cách các mô hình AI vận hành bên trong.
Nghiên cứu giới thiệu bài kiểm tra 'Taboo' giúp đánh giá độ bền của LLM bằng cách ép mô hình đi chệch khỏi lộ trình tạo văn bản thông thường, từ đó bộc lộ những hạn chế thực tế mà các bài benchmark truyền thống thường bỏ qua.
Nhóm nghiên cứu MiLM Plus của Xiaomi giới thiệu khung đánh giá PROVE, bao gồm hai chỉ số RC-S và RC-T cùng bộ dữ liệu thực tế, giúp tối ưu hóa khả năng xóa vật thể trong video. Công trình đã được chấp nhận tại hội nghị ACM MM 2026.
Nghiên cứu này đề xuất phương pháp đánh giá giá trị biên để cắt tỉa dữ liệu trong các tác nhân nghiên cứu AI, giúp giảm chi phí token và độ trễ mà vẫn đảm bảo chất lượng báo cáo cuối cùng.
Nghiên cứu giới thiệu JigShape, bộ dữ liệu ghép hình phức tạp giúp đánh giá khả năng tư duy hình học của các mô hình VLM. Kết quả cho thấy ngay cả những mô hình tiên tiến nhất cũng gặp khó khăn lớn khi độ khó tăng dần, bộc lộ lỗ hổng trong khả năng suy luận không gian của AI.
Nghiên cứu đề xuất khung phân loại ba giai đoạn về sự đồng tiến hóa giữa các tác tử và môi trường, giúp hệ thống AI tự thích nghi và phát triển mà không cần sự can thiệp liên tục từ con người.
Vì sao đáng đọc: Chủ đề mang tính tiên phong về khả năng tự chủ của AI, cung cấp khung lý thuyết quan trọng cho tương lai của các hệ thống tác tử tự tiến hóa.
Mendel Gödel Machine (MGM) cải tiến các tác nhân AI tự lập trình bằng cách áp dụng nguyên lý di truyền Mendel, kết hợp dữ liệu từ nhiều nhiệm vụ và dòng dõi khác nhau để tối ưu hóa mã nguồn hiệu quả hơn thay vì chỉ dựa vào một lần thử sai duy nhất.
You don't necessarily need to see how a powerful AI thinks to copy some of its reasoning ability. …
DịchNghiên cứu mới giới thiệu kỹ thuật Trace Inversion, cho phép huấn luyện mô hình học sinh đạt khả năng suy luận tương đương mô hình gốc chỉ bằng câu hỏi và đáp án, ngay cả khi chuỗi tư duy (CoT) bị ẩn. Chi phí thực hiện cực thấp, đặt ra thách thức lớn về bảo mật mô hình.
Các nhà nghiên cứu phát hiện lỗ hổng cho phép giải mã và đánh cắp các chuỗi suy luận ẩn của Anthropic, OpenAI và Google thông qua việc phát lại dữ liệu. Dù đã được các nhà cung cấp khắc phục, đây là cảnh báo quan trọng về bảo mật dữ liệu trong các mô hình AI suy luận.
Very big warning from this paper. Your AI's hidden reasoning can become a second, invisible data le…
DịchNghiên cứu mới chỉ ra rằng các khối suy luận ẩn trong AI có thể lưu trữ và làm lộ thông tin nhạy cảm như mật khẩu hay API key ngay cả khi hội thoại đã bị xóa. Kẻ tấn công có thể khai thác các khối này để đánh cắp dữ liệu từ các mô hình mạnh thông qua mô hình yếu hơn.