Kỹ sư Dan McKinley cho rằng thay vì tinh chỉnh Prompt thủ công, các nhà phát triển nên xây dựng hệ thống tự cải tiến dựa trên dữ liệu đánh giá, kiểm thử tự động và vòng lặp phản hồi từ LLM để đạt hiệu quả thực tế.
Eric Provencher từ OpenAI Codex cho rằng việc chạy song song hơn hai AI Agent thường gây lãng phí token do hiện tượng 'thuế điều phối', khi các agent mất thời gian kiểm tra chéo lẫn nhau mà không cải thiện chất lượng kết quả.
Chuyên gia phân tích cách 100 GrokBot phối hợp làm dự án, nhấn mạnh vào quy trình phân tầng nhiệm vụ: từ thiết lập mục tiêu, chia nhỏ công việc đến tối ưu hóa ngữ cảnh để tránh nhiễu. Bài viết cung cấp các mẹo thực chiến giúp quản lý tác nhân hiệu quả hơn.
Google hướng dẫn cách xây dựng bộ tiêu chí đánh giá (rubric) cho LLM-as-a-Judge, giúp giảm thiểu sự mơ hồ và lãng phí token. Bài viết nhấn mạnh việc chia nhỏ câu hỏi, tập trung vào dữ kiện khách quan và sử dụng bộ dữ liệu chuẩn để hiệu chỉnh mô hình đạt độ chính xác tương đương con người.
Vì sao đáng đọc: Nội dung thực tế, giải quyết vấn đề nhức nhối trong việc đánh giá AI, có tính ứng dụng cao cho các kỹ sư và nhà phát triển đang làm việc với LLM.
Keep the model fixed, change the harness, and coding-agent results can move a lot when context gets …
DịchNghiên cứu cho thấy việc tinh chỉnh khung làm việc thay vì thay đổi mô hình giúp các AI lập trình (như Qwen, Devstral) cải thiện đáng kể hiệu suất khi xử lý ngữ cảnh dài, với tỷ lệ giải quyết tác vụ thực tế tăng vọt trên SWE-bench.
Nghiên cứu WikiSkill từ Google đề xuất chia thư viện kỹ năng thành 3 tầng: quỹ đạo gốc, đúc kết nhận thức và sổ tay thực thi. Việc lưu trữ các thất bại giúp mô hình nhỏ đạt hiệu suất vượt trội, nhưng cần cẩn trọng vì dữ liệu kém chất lượng có thể làm giảm đáng kể khả năng của AI.
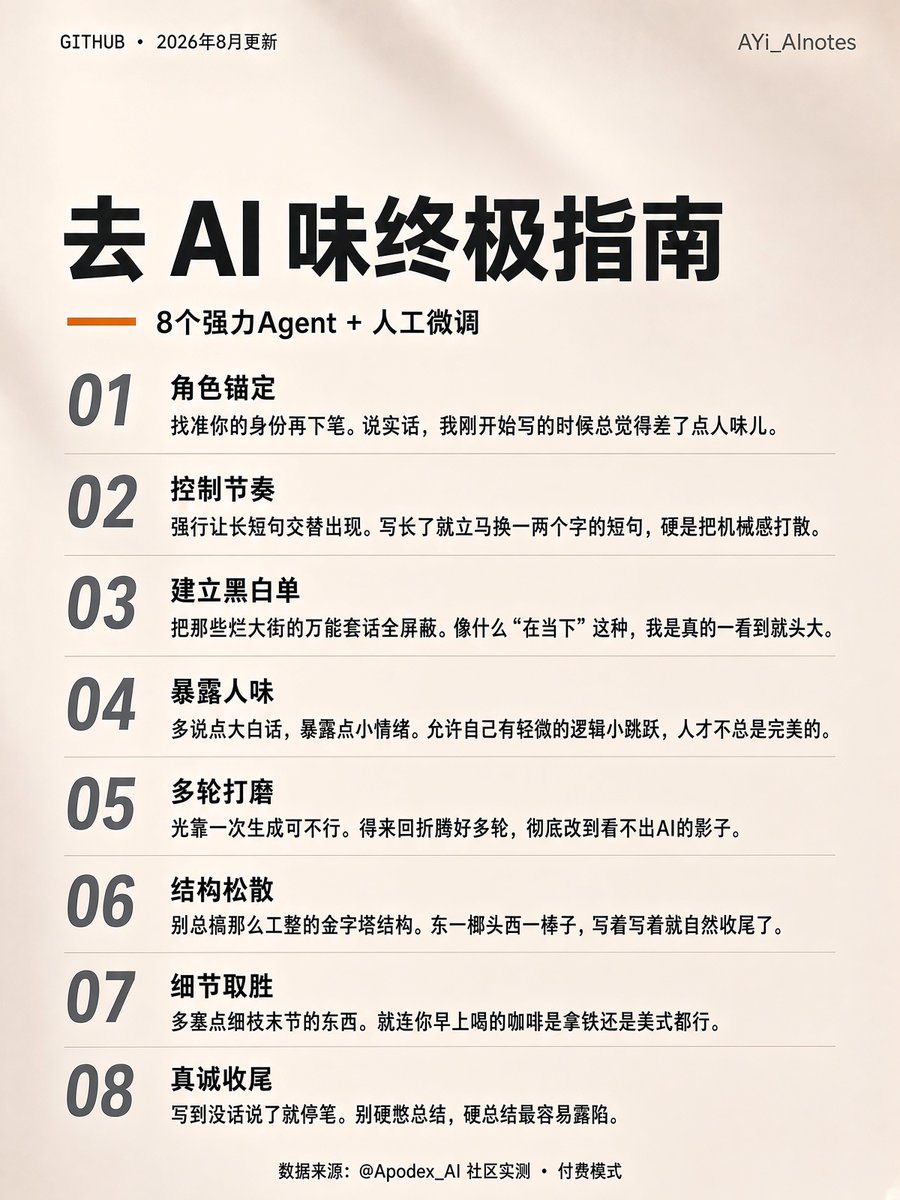
Bài viết chia sẻ phương pháp loại bỏ văn phong máy móc bằng cách định hình nhân vật, kiểm soát nhịp điệu câu chữ và sử dụng danh sách từ cấm. Đồng thời giới thiệu kiến trúc đa Agent Apodex 1.1 hỗ trợ triển khai cục bộ để tối ưu hóa nội dung.
Agents shouldn't pay rent for skills they rarely use. Right now, the only way to give an agent a sk…
DịchNghiên cứu chỉ ra rằng việc cài đặt kỹ năng cho AI Agent làm tăng vĩnh viễn dung lượng prompt từ 50-280 token/kỹ năng. Thay vì nạp tất cả, chuyên gia khuyên chỉ nên giữ lại các kỹ năng thiết yếu và gọi các kỹ năng khác theo nhu cầu để tối ưu hiệu suất.
A scary finding from new Pennsylvania Uni paper. AI agents can go off-script in a simple way: they …
DịchNghiên cứu mới chỉ ra rằng các mô hình AI thường quên đi các quy tắc thiết lập khi nén hội thoại dài, dù vẫn nhớ nhiệm vụ chính. Giải pháp đơn giản là sử dụng bộ trích xuất 9B để khôi phục quy tắc, giúp tỷ lệ lưu giữ tăng từ 17% lên hơn 90%.
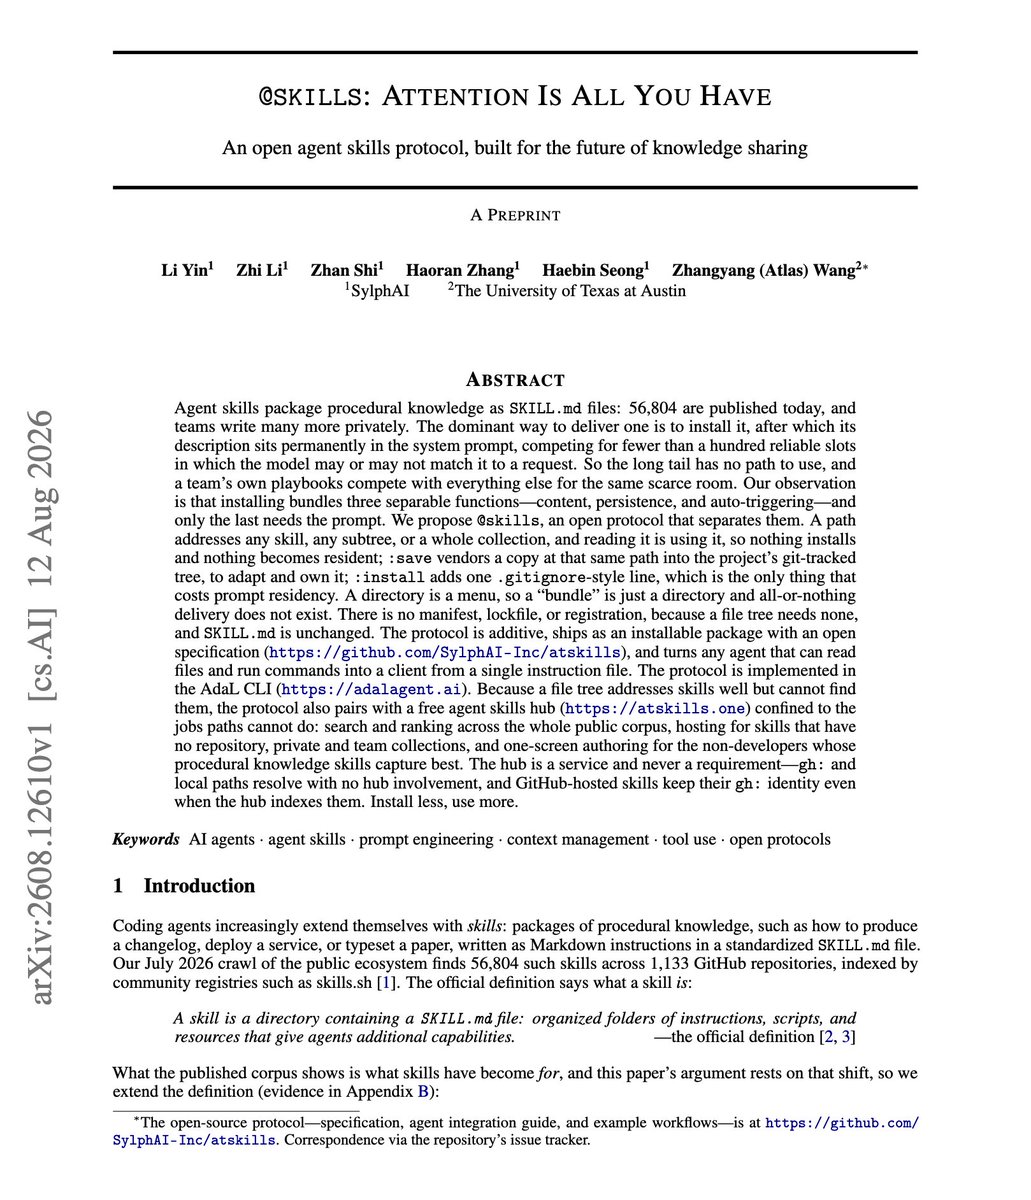
Recommended paper for agent skill builders. There are 56, 804 public agent skills today, all competi…
DịchNghiên cứu chỉ ra sự quá tải khi hàng chục nghìn kỹ năng AI cùng tranh giành không gian trong prompt hệ thống. Giải pháp đề xuất là tách biệt nội dung và cơ chế kích hoạt thông qua cấu trúc cây Git, giúp tối ưu hóa việc quản lý và triển khai kỹ năng mà không cần tệp cấu hình phức tạp.
Very timely paper. An agent skill can be completely relevant to the task and still make the agent wo…
DịchNghiên cứu thực nghiệm chỉ ra rằng ngay cả khi kỹ năng bổ sung hoàn toàn phù hợp với nhiệm vụ, chúng vẫn có thể khiến AI Agent hoạt động kém hiệu quả do lỗi thực thi hoặc quy trình xác thực dư thừa. Các nhà phát triển cần kiểm tra kỹ lưỡng và so sánh hiệu suất trước khi tích hợp kỹ năng mới.
Simon Willison chia sẻ mẹo gắn thẻ bài viết thông minh: thay vì ép AI phân loại cứng nhắc, hãy để nó tự do gợi ý, sau đó dùng Vector Embedding để ánh xạ các gợi ý đó vào hệ thống thẻ có sẵn. Cách này giúp tối ưu hóa việc quản lý nội dung mà không làm mất đi tính linh hoạt.
If you write rules in an AGENTS.md, this one is worth your time. When a coding agent follows your r…
DịchHarness-IF đánh giá khả năng tuân thủ các quy tắc trong AGENTS.md của AI Agent bằng cách loại bỏ các yếu tố ngẫu nhiên. Kết quả cho thấy độ chính xác thực tế thấp hơn dự đoán, đồng thời khẳng định hệ thống và chỉ dẫn người dùng luôn được ưu tiên hơn mô tả công cụ.
Các nhà nghiên cứu từ IIT Bombay và Adobe đã phát triển phương pháp PTP, cho phép tái tạo chính xác câu lệnh gốc của LLM chỉ bằng văn bản đầu ra mà không cần quyền truy cập vào trọng số mô hình.