27/08

Thứ Năm · 34 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 47/100

Recuris: Cơ chế 'kép' giúp AI thông minh hơn trong các tác vụ dài hạn

If you maintain a skill library for long-horizon agents, this one is worth your time. (bookmark it) …

DịchRecuris tối ưu hóa khả năng xử lý của AI bằng cách tách biệt bộ nhớ làm việc và bộ nhớ kinh nghiệm, giúp mô hình đưa ra quyết định dựa trên trạng thái nhiệm vụ thay vì lịch sử dữ liệu thô. Giải pháp này cải thiện đáng kể tỷ lệ thành công trên các tác vụ phức tạp và giảm tới 80% lỗi thường gặp.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

VBVR-Pro: Bộ công cụ suy luận thị giác nguyên bản có khả năng mở rộng và kiểm chứng

VBVR-Pro là nền tảng kiểm thử khép kín sử dụng tạo sinh hình ảnh làm phương tiện suy luận, giúp việc suy luận thị giác trở nên có thể huấn luyện và kiểm chứng. Hệ thống vượt trội hơn các mô hình VLM truyền thống nhờ cơ chế đánh giá dựa trên quy tắc xác định.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MemUse: Đánh giá bộ nhớ AI qua hội thoại tự nhiên thay vì chỉ hỏi đáp trực tiếp

Nghiên cứu chỉ ra rằng khả năng trả lời câu hỏi trực tiếp không phản ánh đúng sự hài lòng của người dùng. MemUse đề xuất phương pháp đánh giá mới dựa trên cách AI tích hợp ngữ cảnh quá khứ một cách tự nhiên vào hội thoại.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

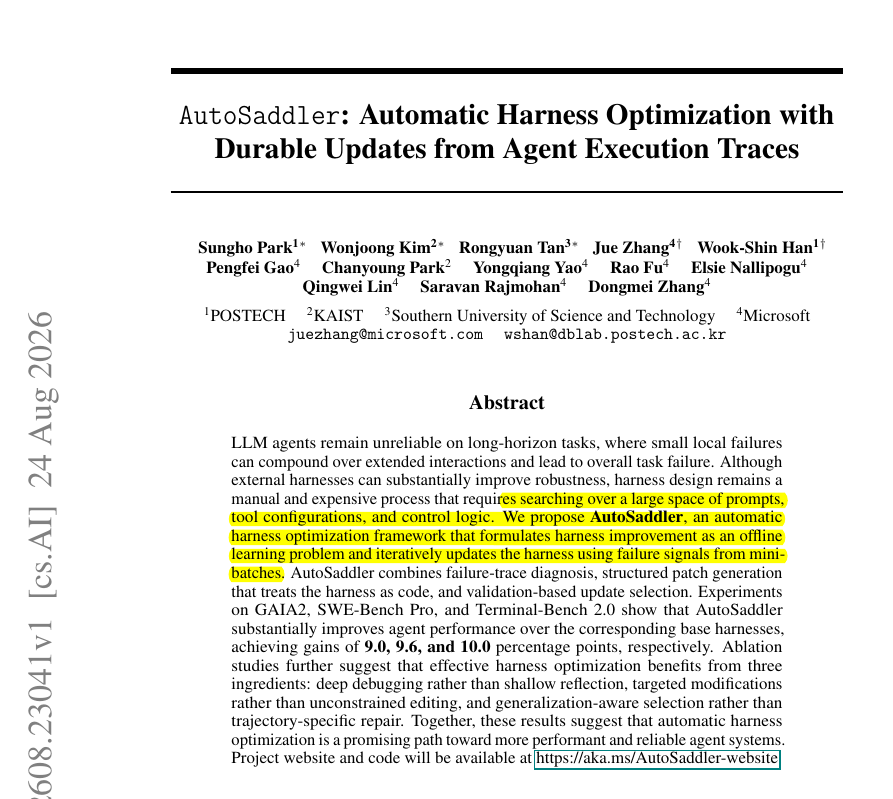
AutoSaddler: Khung tối ưu hóa tác nhân tự động với cơ chế chống thoái hóa

Automatically patching an agent's harness is easy; keeping the patches that help is the hard part. …

DịchAutoSaddler tự động tinh chỉnh prompt và công cụ từ các thất bại, nhưng chỉ áp dụng thay đổi giúp cải thiện hiệu suất thực tế. Nghiên cứu cảnh báo rằng nếu thiếu kiểm soát, việc tự động hóa có thể gây tác dụng ngược so với thiết kế thủ công.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 27/100

Đột phá: Hệ thống đa tác tử AI tự chủ thách thức giới hạn nghiên cứu toán học

Does giving research agents full autonomy add capability Cambridge, Hong Kong Univ and other labs f…

DịchNghiên cứu mới từ Cambridge và HKU cho thấy các tác tử AI tự chủ có thể tự đưa ra các chứng minh toán học vượt ngoài yêu cầu, thay đổi quan điểm cho rằng AI chỉ là công cụ hỗ trợ cần sự giám sát chặt chẽ.

Thêm 1 nguồn khác đưa tinHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Alibaba Scroll: Bước tiến mới trong quản lý ngữ cảnh cho mô hình lập trình

What if context management were a program the model writes rather than a rule your harness applies? …

DịchAlibaba giới thiệu Scroll, hệ thống quản lý ngữ cảnh thông minh chuyển đổi từ quyết định khi ghi sang truy vấn, giúp tối ưu hóa bộ nhớ cho mô hình Qwen3.8-Max. Giải pháp này đạt 73.1 điểm trên BEAM, vượt trội so với các hệ thống hiện có.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

WebDev-Skills-Bench: Việc 'nhồi nhét' kỹ năng vào prompt thực tế làm giảm hiệu suất lập trình của AI

Attaching a skill file to every prompt in a coding session is usually a net loss. A skill file hur…

DịchNghiên cứu chỉ ra rằng việc đính kèm tài liệu kỹ năng vào prompt khiến hiệu suất lập trình giảm từ 1.3-4.2 điểm, đồng thời làm tăng chi phí token ít nhất 72%. Thay vì áp dụng đại trà, các nhà phát triển nên cân nhắc kỹ lưỡng việc sử dụng kỹ thuật này dựa trên từng tác vụ cụ thể.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 40/100

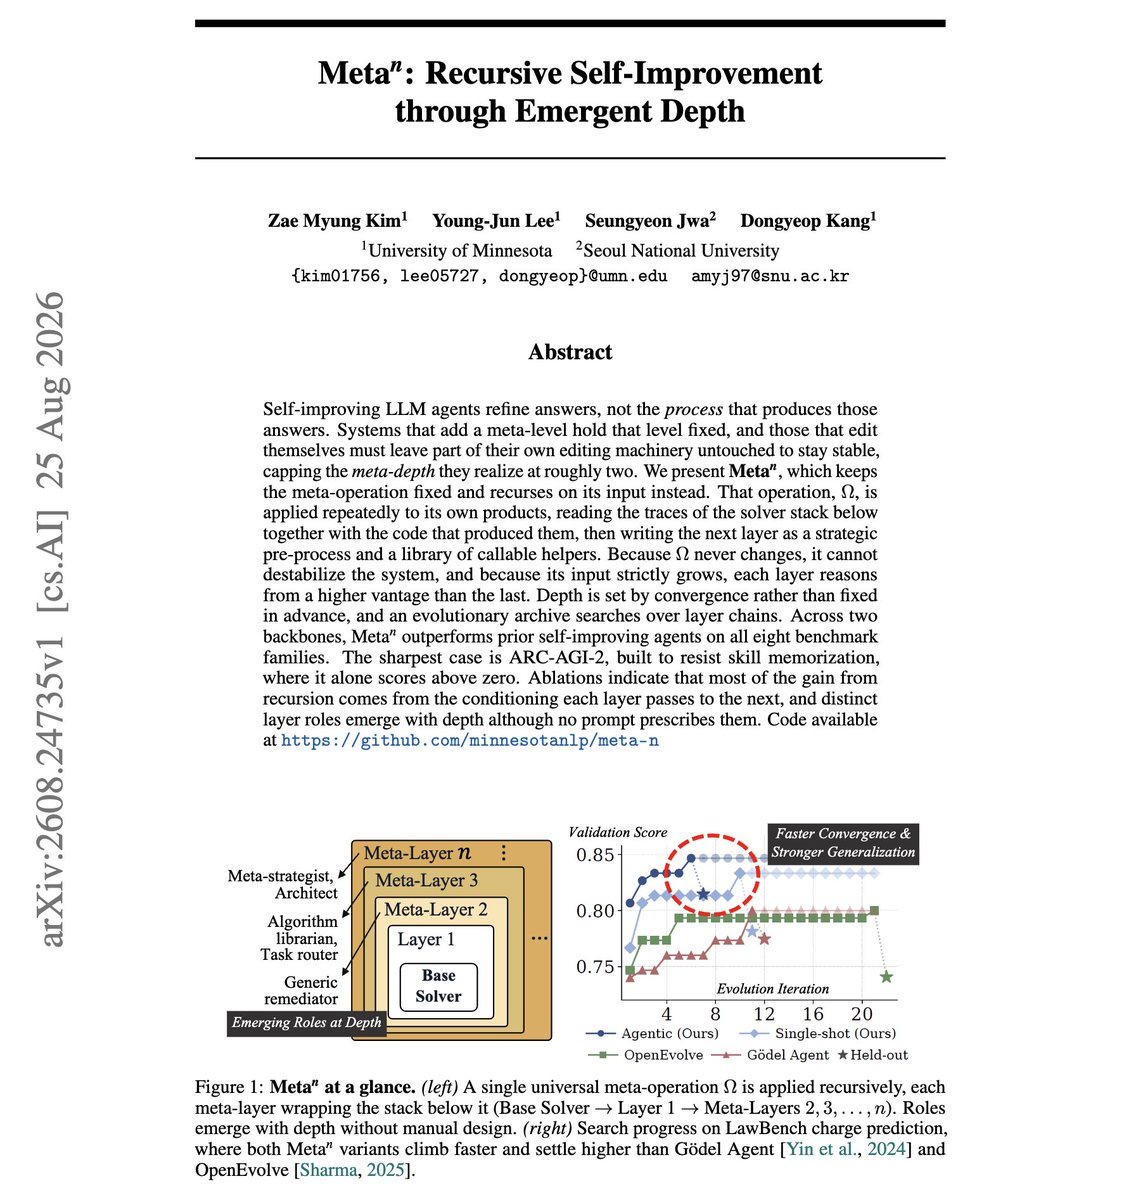
Meta^n: Phương pháp mới giúp AI tự cải tiến đệ quy vượt giới hạn cũ

Good read. Improving recursive self-improvement through emergent depth.

DịchMeta^n là phương pháp đột phá cho phép các tác nhân AI tự cải tiến thông qua đệ quy đầu vào thay vì sửa đổi cơ chế cốt lõi. Kỹ thuật này đã chứng minh hiệu suất vượt trội trên 8 bộ tiêu chuẩn, bao gồm cả ARC-AGI-2.

Thêm 1 nguồn khác đưa tinX: DAIR.AI (@dair_ai)
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 35/100

Cùng sự kiệnMeta^n: Phương pháp đệ quy mới giúp AI tự cải tiến vượt qua 8 tiêu chuẩn đánh giá

Interesting new approach to recursive self-improvement in agents. Systems that add a meta-level hol…

DịchDAIR.AI giới thiệu Meta^n, phương pháp đệ quy giúp AI tự cải tiến mà không làm mất ổn định hệ thống. Kỹ thuật này vượt qua các mô hình tiền nhiệm trên 8 bộ benchmark và là phương pháp duy nhất đạt điểm dương trên ARC-AGI-2.

Cùng sự kiện, bài đại diện «Meta^n: Phương pháp mới giúp AI tự cải tiến đệ quy vượt giới hạn cũ»
Anthropic: Research (công bố - Web)
Nghiên cứuĐiểm AI 69/100

Tinh chọnAnthropic chia sẻ dữ liệu thực tế của Claude cho các tổ chức nghiên cứu độc lập

Anthropic đã cung cấp 250.000 đoạn hội thoại từ Claude cho các viện nghiên cứu tại Stanford, Oxford và METR thông qua công cụ bảo mật Anthropic Insights để phục vụ các nghiên cứu độc lập.


Vì sao đáng đọc: Đây là bước đi minh bạch quan trọng trong việc nghiên cứu hành vi AI, giúp cộng đồng học thuật tiếp cận dữ liệu thực tế mà vẫn đảm bảo quyền riêng tư.
Anthropic@AnthropicAI
Sản phẩmĐiểm AI 46/100

Anthropic lần đầu chia sẻ dữ liệu thực tế từ Claude cho giới nghiên cứu

For the first time, we've given external researchers a way to study AI's impacts using real, privacy…

DịchAnthropic chính thức cung cấp dữ liệu sử dụng Claude đã được ẩn danh cho các nhà nghiên cứu bên ngoài, nhằm thúc đẩy việc đánh giá tác động của AI một cách minh bạch và khách quan hơn.

26/08

Thứ Tư · 31 tin
DAIR.AI@dair_ai
Sản phẩmĐiểm AI 55/100

DAIR.AI ra mắt chuyên mục tuyển tập nghiên cứu AI hàng tuần

Introducing AI Papers of the Week: https://academy.dair.ai/papers We took the top AI papers of the …

DịchDAIR.AI vừa giới thiệu nền tảng tổng hợp các bài báo khoa học AI tiêu biểu trong 3 năm qua, hỗ trợ phân loại theo chủ đề và tích hợp tính năng trò chuyện trực tiếp với nội dung nghiên cứu.

Kim@kimmonismus
Hướng dẫnĐiểm AI 56/100

OpenAI dự kiến đạt AGI cuối năm 2026, ra mắt trợ lý nghiên cứu tự chủ Astra

OpenAI officially expects AGI by end of *this* year (2026) "Altman told me that OpenAI was "not qui…

DịchCEO Sam Altman kỳ vọng OpenAI sẽ sở hữu hệ thống AGI vào cuối năm 2026. Đồng thời, công ty đã phát triển Astra, một AI có khả năng tự thực hiện các nghiên cứu khoa học phức tạp, giúp rút ngắn thời gian làm việc từ hàng tuần xuống chỉ còn trong chốc lát.

Thêm 2 nguồn khác đưa tinLatent SpaceThe Decoder: AI News
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SecOPD: Chống tấn công Prompt Injection bằng phương pháp chưng cất chính sách (On-Policy Distillation)

SecOPD giải quyết lỗ hổng Prompt Injection bằng cách cung cấp phản hồi ở cấp độ token thay vì toàn bộ chuỗi, giúp mô hình LLM nhận diện và từ chối các lệnh độc hại chính xác hơn so với các phương pháp tinh chỉnh truyền thống.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 42/100

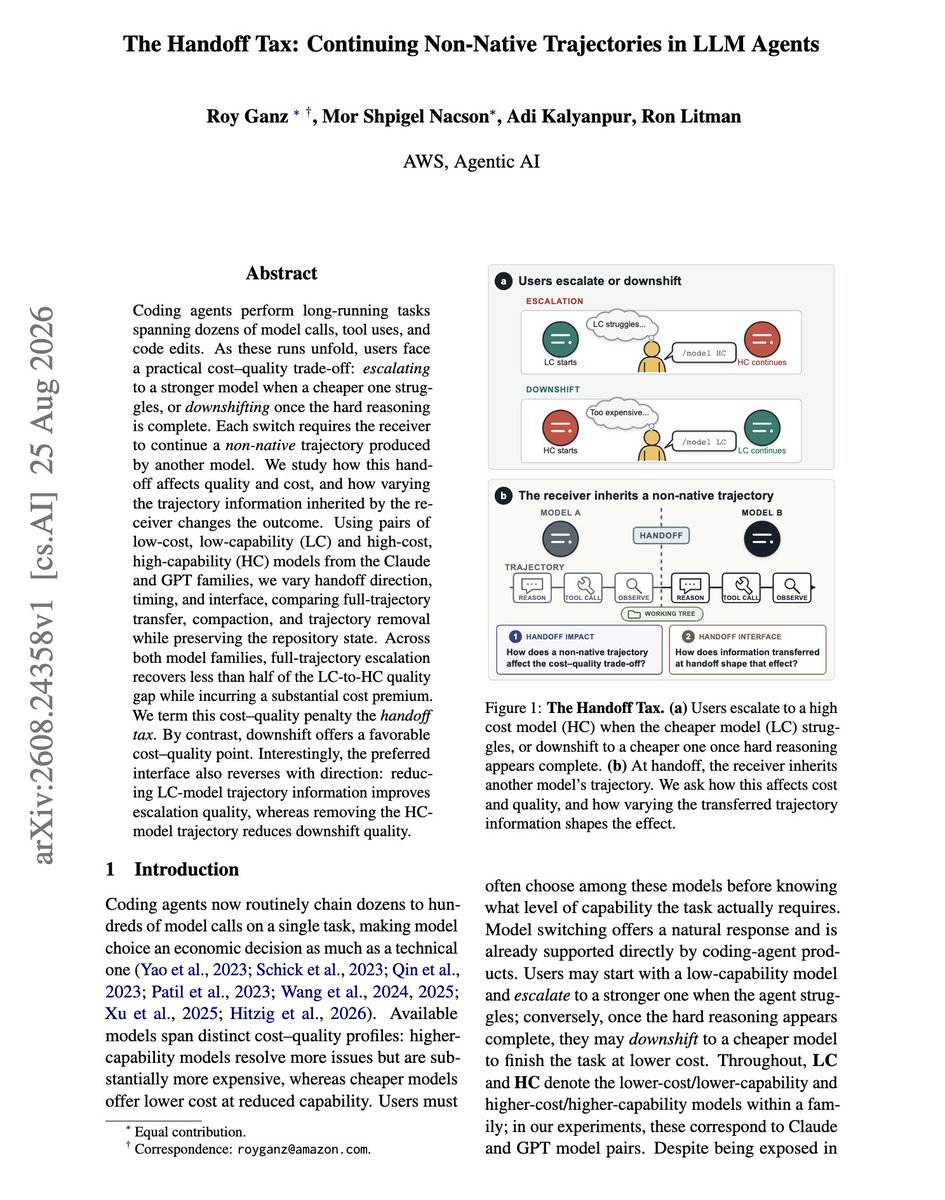
Nghiên cứu mới từ AWS: Định lượng 'thuế chuyển giao' khi điều phối các mô hình AI

Great new paper from AWS on agent handoff tax. If you build agents today, you need to understand th…

DịchAWS AI Labs giới thiệu khái niệm 'thuế chuyển giao', chỉ ra rằng việc nâng cấp từ mô hình yếu lên mạnh trong quá trình xử lý không bù đắp được hiệu suất như kỳ vọng nhưng lại tốn kém chi phí. Ngược lại, chiến lược hạ cấp mô hình mang lại sự cân bằng tối ưu hơn giữa chất lượng và chi phí.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

Apodex 1.1: Đột phá mới khi biến môi trường thực thi thành không gian mở rộng cho AI Agent

A context window is a terrible place to store the state of an 80-minute agent run. One of the bette…

DịchApodex 1.1 thay đổi cách huấn luyện AI bằng cách tích hợp môi trường thực thi trực tiếp vào quy trình thay vì chỉ cung cấp công cụ. Phương pháp này giúp mô hình đạt hiệu suất vượt trội trên các bài kiểm tra khoa học và tài chính nhờ học từ toàn bộ quy trình làm việc thực tế.

ModelBest OpenBMB@OpenBMB
Nghiên cứuĐiểm AI 36/100

PACE-Bench: Đánh giá khả năng tự thích nghi mã nguồn của AI trong môi trường vật lý biến đổi

Executable Python code can define a vehicle that works on high-friction ground yet spins uselessly o…

DịchNhóm nghiên cứu từ Đại học Thanh Hoa giới thiệu PACE-Bench, bộ tiêu chuẩn đánh giá khả năng điều chỉnh mã nguồn của AI khi các thông số vật lý thay đổi đột ngột. Kết quả cho thấy việc phản hồi dựa trên mô phỏng thực tế hiệu quả hơn nhiều so với việc chỉ tăng cường khả năng suy luận.

IT Home
Hướng dẫnĐiểm AI 46/100

Nghiên cứu: Trẻ sơ sinh học ngôn ngữ hiệu quả vượt xa các chatbot AI hiện nay

Các nhà khoa học tại Stanford chỉ ra rằng trẻ em chỉ cần tiếp xúc với lượng từ vựng rất nhỏ đã có thể giao tiếp, trong khi AI cần khối lượng dữ liệu khổng lồ nhưng kết quả vẫn kém xa. Điều này đặt ra thách thức lớn cho việc phát triển AI chỉ dựa vào quy mô dữ liệu.

Kim@kimmonismus
Nghiên cứuĐiểm AI 37/100

SWE Refactor Bench: Tỷ lệ thành công của AI khi tái cấu trúc toàn bộ mã nguồn chỉ đạt 5,4%

Coding agents can pass tests and still miss the task. In SWE Refactor Bench, 340 of 520 runs comple…

DịchEinsia ra mắt SWE Refactor Bench để kiểm tra khả năng chuyển đổi hệ thống (như C sang Rust) của AI. Kết quả cho thấy AI vẫn gặp khó khăn lớn với các tác vụ tái cấu trúc phức tạp, khi chỉ 5,4% thử nghiệm vượt qua được các tiêu chuẩn đánh giá khắt khe.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

OraRL: Tối ưu hóa học tăng cường hiệu quả cho mô hình ngôn ngữ đa phương thức video

Nghiên cứu giới thiệu OraRL, phương pháp mới tận dụng dữ liệu chú giải làm 'oracle rollout' để cải thiện hiệu suất học tăng cường cho mô hình MLLM video, giải quyết vấn đề đảo ngược lợi thế trong quá trình huấn luyện.

IT Home
Nghiên cứuĐiểm AI 43/100

Nghiên cứu Stanford: Gen Z mới ra trường chịu tác động mạnh nhất từ AI, bằng cấp đại học là 'tấm khiên' bảo vệ

Nghiên cứu từ Stanford chỉ ra rằng lao động trẻ 22-25 tuổi đang mất dần cơ hội việc làm đầu đời do AI thay thế các tác vụ cơ bản, trong khi trình độ học vấn cao giúp giảm thiểu rủi ro này.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

BPCO: Giải pháp tối ưu hóa Critic giúp huấn luyện Reinforcement Learning ổn định hơn

BPCO là phương pháp huấn luyện mới kết hợp nhiều kỹ thuật tiên tiến nhằm khắc phục sự bất ổn trong Reinforcement Learning dựa trên Critic, giúp cải thiện đáng kể khả năng suy luận toán học của các mô hình ngôn ngữ lớn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 55/100

OPDVR: Phương pháp chưng cất chính sách không giám sát kết hợp phần thưởng kiểm chứng

OPDVR là phương pháp mới kết hợp học tăng cường dựa trên phần thưởng kiểm chứng (RLVR) với chưng cất chính sách trực tuyến (OPD) mà không cần thêm siêu tham số, giúp tối ưu hóa mô hình hiệu quả hơn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

Meta^n: Đột phá khả năng tự cải thiện đệ quy thông qua chiều sâu mới

Meta^n giới thiệu phương pháp tự cải thiện đệ quy bằng cách mở rộng chiều sâu xử lý thông qua các thao tác meta cố định. Mô hình này vượt trội hơn các tác nhân tự cải thiện hiện có trên 8 bộ tiêu chuẩn, đặc biệt là kết quả ấn tượng tại ARC-AGI-2.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 66/100

Recuris: Kiến trúc bộ nhớ làm việc đệ quy giúp tối ưu hóa tác vụ cho AI Agent dài hạn

Recuris giới thiệu kiến trúc bộ nhớ đệ quy cho phép AI Agent theo dõi tiến trình và tự cập nhật kỹ năng thông qua các vòng lặp tiến hóa có cấu trúc, giúp nâng cao hiệu suất trong các tác vụ kéo dài.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 55/100

CAFE: Khung tự cải thiện cho tác nhân tìm kiếm thông qua cơ chế phản hồi đồng tiến hóa

CAFE là mô hình cho phép tác nhân tìm kiếm và bộ phê bình cùng tiến hóa thông qua học tăng cường trực tuyến và tối ưu hóa ưu tiên, giúp giảm thiểu ảo giác và nâng cao hiệu suất vượt trội trên nhiều tiêu chuẩn đánh giá.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

AutoSaddler: Tự động tối ưu hóa khung điều khiển cho tác nhân AI thông qua vết thực thi

AutoSaddler là khung làm việc tự động giúp tối ưu hóa các khung điều khiển (harness) cho tác nhân AI bằng cách học từ lỗi thực thi, giúp cải thiện đáng kể độ tin cậy trong các tác vụ dài hạn trên các nền tảng như SWE-Bench Pro.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 52/100

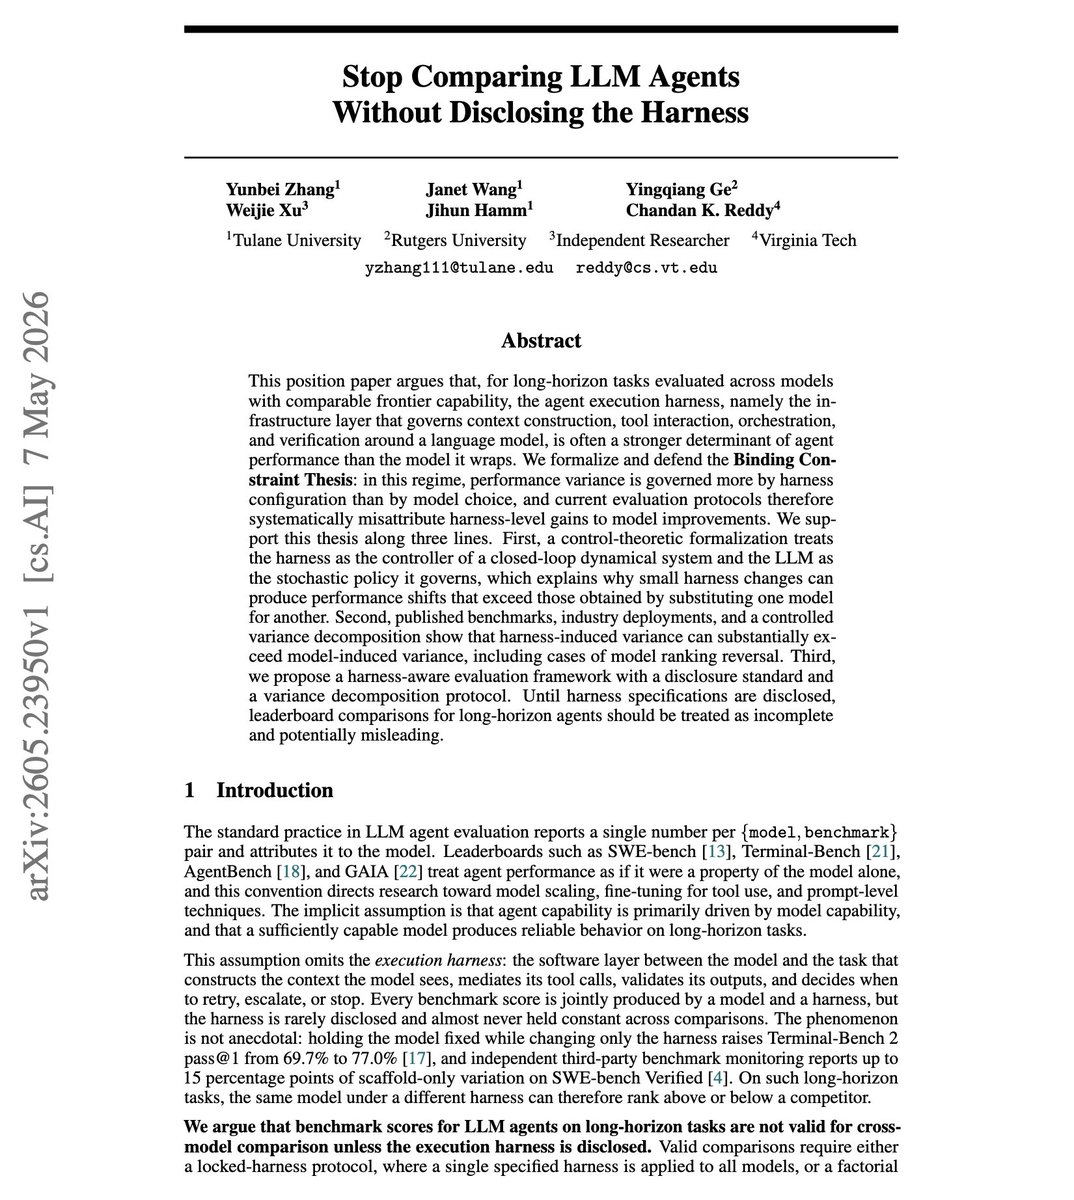
Tại sao bảng xếp hạng AI Agent không đáng tin? Vai trò mờ ám của bộ đánh giá (harness)

Great paper on why agent leaderboard comparisons are hard to trust. It's on the hot topic of how mu…

DịchNghiên cứu mới chỉ ra rằng 'harness' (lớp trung gian giữa mô hình và tác vụ) ảnh hưởng đến điểm số AI Agent gấp 7,8 lần so với chính mô hình đó, khiến kết quả xếp hạng dễ bị thao túng và thiếu khách quan.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 47/100

Điểm chuẩn AI không đáng tin: Thay đổi cấu hình nhỏ khiến thứ hạng mô hình đảo lộn

// There Is No Neutral Harness // Great work discussing some of the issues in harness evaluation. …

DịchNghiên cứu chỉ ra rằng chỉ cần thay đổi thứ tự đáp án hoặc cách diễn đạt câu lệnh, điểm số của các mô hình AI có thể dao động cực lớn, khiến bảng xếp hạng hiện nay trở nên thiếu khách quan.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 44/100

Đánh giá AI không hề khách quan: Điểm số một mô hình có thể dao động từ 31% đến 89%

Great paper on agent harnesses.

DịchNghiên cứu mới chỉ ra rằng cách thiết lập bộ khung đánh giá ảnh hưởng cực lớn đến kết quả của AI. Chỉ cần thay đổi thứ tự đáp án hay cách đặt câu hỏi, thứ hạng của các mô hình có thể bị đảo lộn hoàn toàn, cho thấy các bài kiểm tra hiện nay còn nhiều lỗ hổng.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

AstroPT: Dùng thiên văn học để giải mã cách AI học tập và tư duy

Nghiên cứu sử dụng AstroPT, một mô hình transformer huấn luyện trên dữ liệu thiên hà, làm thước đo để hiểu cách các khái niệm hình thành trong LLM. Kết quả cho thấy AI học các đặc tính từ đơn giản đến phức tạp theo trình tự cố định, giúp làm rõ cơ chế nội tại của các mô hình ngôn ngữ lớn.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 47/100

Nén ngữ cảnh làm suy yếu các quy tắc an toàn của AI Agent như thế nào?

If you keep safety rules or coding standards in an AGENTS.md or a CLAUDE.md, this one is worth your …

DịchNghiên cứu chỉ ra rằng việc nén ngữ cảnh khiến các AI Agent mất tới 90% quy tắc an toàn sau 5 vòng. Giải pháp 'Knowledge Triage' được đề xuất giúp phân loại dữ liệu thông minh, duy trì tỷ lệ tuân thủ lên đến 96% bất kể tỷ lệ nén.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 42/100

Đánh giá WebDev-Skills-Bench: Liệu kỹ năng của AI Agent có thực sự hiệu quả?

Finally, a good paper testing whether Agent Skills actually help. Worth reading if you are maintain…

DịchNghiên cứu chỉ ra rằng việc bổ sung kỹ năng cho AI Agent trong lập trình web làm giảm hiệu suất từ 1.3% - 4.2% và tăng chi phí token đáng kể do nhiễu thông tin. Kết quả cho thấy các kỹ năng này thiếu tính ổn định và khả năng chuyển đổi giữa các mô hình.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnKỷ nguyên mới của Agentic AI: 16 tổ chức quốc tế đề xuất mô hình 'Tác nhân đồng hành' (ComBodied Agents)

Thay vì chỉ tập trung hoàn thành tác vụ, mô hình ComBodied Agents ưu tiên sự thấu hiểu và phát triển dài hạn của con người, đánh dấu bước chuyển mình từ AI thực thi sang AI đồng hành trong đời sống.


Vì sao đáng đọc: Bài viết giới thiệu một hướng đi mới đầy nhân văn cho AI, thoát khỏi tư duy 'tự động hóa' thuần túy để hướng tới sự hỗ trợ bền vững, có tính ứng dụng cao trong y tế và đời sống.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (74 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “nghiên cứu AI” — Trang 21 | AIHOT.vn