Hôm nay · 28/09

Thứ Hai · 1 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnCấu trúc mHC trên DeepSeek-V4-Flash: Các luồng dư thừa có thực sự hiệu quả?

Nghiên cứu chỉ ra rằng các luồng dư (residual streams) trong kiến trúc mHC của DeepSeek-V4-Flash không được sử dụng đồng đều, với các tầng sâu gần như trở thành ma trận đơn vị, cho thấy sự lãng phí tài nguyên tính toán đáng kể.


Vì sao đáng đọc: Phân tích kỹ thuật chuyên sâu về kiến trúc mô hình AI hiện đại, cung cấp bằng chứng thực nghiệm giá trị cho cộng đồng nghiên cứu về tối ưu hóa Transformer.

26/09

Thứ Bảy · 2 tin
SemiAnalysis@SemiAnalysis_
Mô hìnhĐiểm AI 24/100

Cùng sự kiệnGiải mã cơ chế bộ nhớ Engram trên DeepSeek V4.1 Flash

DeepSeek's memory lights up for "Wright: Ace Attorney" We probed V4.1 Flash's Engram gates to see …

DịchKhám phá cách DeepSeek V4.1 Flash vận hành cơ chế Engram thông qua các mô hình văn bản, vượt xa việc chỉ ghi nhớ tên gọi hay sự kiện đơn thuần.

Cùng sự kiện, bài đại diện «DeepSeek-V4.1-Flash chính thức miễn phí trên WorkBuddy đến hết 9/10»
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 45/100

Jev-Mem: Kiến trúc bộ nhớ cho AI Agent lấy cảm hứng từ tư duy System-One/System-Two

Banger report on building faster memory for AI Agents. If your agent's memory layer is slow, this d…

DịchJev-Mem là kiến trúc bộ nhớ mới giúp tăng tốc độ xây dựng bộ nhớ lên 6,6 lần và giảm độ trễ truy vấn 36,7%, đạt hiệu suất vượt trội trên benchmark LoCoMo so với các giải pháp hiện có.

25/09

Thứ Sáu · 2 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

Transformer có thể chứa hai luồng tư duy cùng lúc: Bằng chứng về sự chồng chất tuyến tính trong LLM

Nghiên cứu chứng minh Transformer có khả năng xử lý đồng thời hai luồng văn bản thông qua sự chồng chất tuyến tính, cho phép giải mã song song hai kết quả từ một lần chạy duy nhất.

24/09

Thứ Năm · 1 tin
Pandaily
Nghiên cứuĐiểm AI 85/100

Cùng sự kiệnXiaomi giới thiệu HySparse2 cho MiMo-V3: Chia sẻ KV hai cấp giúp giảm 5 lần FLOPs khi xử lý 1 triệu token

Đội ngũ LLM-Core của Xiaomi công bố HySparse2, kiến trúc chú ý thưa (sparse-attention) với cơ chế chia sẻ KV hai cấp, giúp tối ưu hóa hiệu suất cho các mô hình tác nhân MiMo-V3 bằng cách giảm đáng kể khối lượng tính toán khi xử lý ngữ cảnh dài.

Cùng sự kiện, bài đại diện «Xiaomi hé lộ kiến trúc HySparse2 trên MiMo-V3: Tối ưu cho Agent đa vòng hội thoại dài»

23/09

Thứ Tư · 1 tin
Luo Fuli@_LuoFuli
Mô hìnhĐiểm AI 43/100

Cùng sự kiệnMiMo-V3 ra mắt kiến trúc lõi HySparse2: Tối ưu hóa vượt trội cho xử lý văn bản dài

MiMo-V3 is getting a new architecture. The core of it, HySparse2, is out today. Less prefill, a sma…

DịchKiến trúc HySparse2 mới của MiMo-V3 giúp giảm 5,02 lần FLOPs prefill và thu nhỏ 4,5 lần KV cache so với bản tiền nhiệm, đồng thời cải thiện đáng kể hiệu suất trên các bài kiểm tra độ dài ngữ cảnh lớn.

Cùng sự kiện, bài đại diện «Xiaomi hé lộ kiến trúc HySparse2 trên MiMo-V3: Tối ưu cho Agent đa vòng hội thoại dài»

22/09

Thứ Ba · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnDeep Persona: Kiến trúc mô phỏng nhân vật AI dựa trên nền tảng tâm lý học

Deep Persona là kiến trúc ba tầng giúp AI nhập vai chân thực hơn bằng cách mô phỏng niềm tin và động lực cốt lõi thay vì chỉ dựa vào mô tả bề nổi. Hệ thống này còn đi kèm khung đánh giá mới giúp đo lường độ tự nhiên của hội thoại dựa trên các tiêu chuẩn tâm lý học lâm sàng.


Vì sao đáng đọc: Đề tài đột phá trong việc giải quyết tính nhất quán của AI khi nhập vai, kết hợp giữa tâm lý học và kỹ thuật LLM, rất hữu ích cho phát triển chatbot và game.

21/09

Thứ Hai · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

IntBMoE: Tối ưu hóa kiến trúc Mixture-of-Experts thông qua cơ chế điều phối khối

IntBMoE giải quyết bài toán đánh đổi giữa hiệu năng, chi phí tính toán và bộ nhớ trong mô hình MoE bằng cách kết hợp kỹ thuật trộn chuyên gia dày đặc với cơ chế thực thi khối thưa thớt, cho phép kiểm soát độc lập các thông số này.

AI Notes@AYi_AInotes
Quan điểmĐiểm AI 58/100

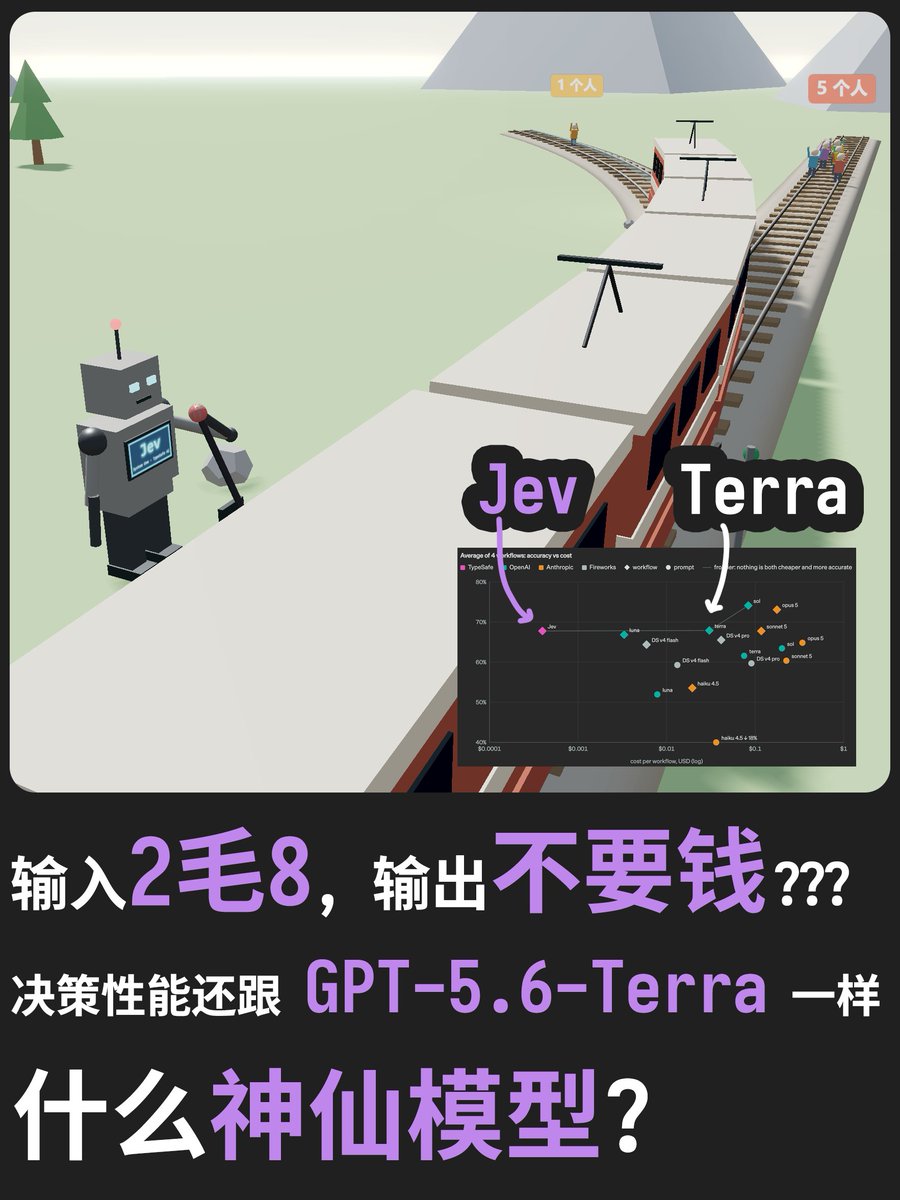
Giải mã Jev: Tại sao mô hình ra quyết định kiểu 'Strongly Typed' lại vượt trội hơn tạo văn bản dài?

Bài viết phân tích mô hình Jev, giải pháp thay thế việc tạo văn bản tự hồi quy tốn kém bằng cách chuyển đổi logic ra quyết định thành các trạng thái đầu vào và tùy chọn xác định, giúp tối ưu hóa chi phí và độ trễ.

19/09

Thứ Bảy · 1 tin

18/09

Thứ Sáu · 4 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

JEPA-Anything: Bước tiến mới với khung mô hình thế giới thống nhất đa lĩnh vực

Nghiên cứu giới thiệu JEPA-Anything, khung mô hình thế giới dựa trên phân tách dự đoán trực giao (OPF), có khả năng ứng dụng linh hoạt từ thị giác máy tính, y sinh đến vật lý và dự báo thời tiết.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 41/100

Mô hình ngôn ngữ tham số vô hạn: Tạo và điều chỉnh trọng số từ dữ liệu thời gian thực

Nghiên cứu giới thiệu Infinite-Parameter LLM, sử dụng siêu mạng để tạo trọng số từ dữ liệu thực tế thay vì lưu trữ cố định. Phương pháp này giúp mô hình liên tục cập nhật kiến thức vào trọng số, tối ưu hóa bộ nhớ và duy trì thông tin xuyên suốt các phiên hội thoại.

karminski@karminski3
Mô hìnhĐiểm AI 35/100

Jev: Mô hình AI chuyên biệt cho ra quyết định cấu trúc, loại bỏ cơ chế tự hồi quy

Jev từ bỏ kiến trúc tự hồi quy truyền thống để tập trung vào việc đưa ra quyết định dưới dạng JSON cấu trúc. Bằng cách định nghĩa trước các Schema, mô hình đảm bảo đầu ra chính xác tuyệt đối, lý tưởng cho các tác vụ phân loại hoặc điều khiển hành động phức tạp.

17/09

Thứ Năm · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Sử dụng Register Tokens để tối ưu hóa suy luận trạng thái giới hạn trong mô hình ngôn ngữ khuếch tán

Nghiên cứu giới thiệu phương pháp dùng các 'register tokens' để lưu trữ trạng thái suy luận, giúp mô hình ngôn ngữ khuếch tán duy trì logic mạch lạc khi xử lý văn bản dài mà không cần giữ toàn bộ ngữ cảnh cũ.

16/09

Thứ Tư · 6 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnGiải mã kiến trúc AI: Khi hỏi mô hình như một đứa trẻ lại hé lộ bí mật kỹ thuật

Nghiên cứu cho thấy việc đặt câu hỏi dưới góc độ 'giải thích cho học sinh' giúp các mô hình AI hàng đầu bộc lộ cấu trúc kiến trúc cốt lõi một cách nhất quán và ổn định hơn so với các cách hỏi thông thường.


Vì sao đáng đọc: Nghiên cứu mang tính đột phá về kỹ thuật prompt (prompt engineering), giúp hiểu sâu hơn về cách các mô hình AI tư duy và cấu trúc hóa kiến thức nội tại.
Elvis Saravia@omarsar0
NgànhĐiểm AI 36/100

TypeSafe ra mắt Jev: Bước ngoặt bỏ tạo văn bản, tăng tốc độ phản hồi gấp 200 lần

Recommended read. Jev gives up text generation to make AI dramatically faster. TypeSafe built a ne…

DịchTypeSafe giới thiệu kiến trúc Jev, thay thế việc tạo văn bản bằng cách xử lý song song các câu hỏi cấu trúc. Với chi phí tối ưu và tốc độ nhanh gấp 40-200 lần, Jev được định vị là giải pháp thông minh có khả năng kết hợp, tập trung vào hỗ trợ ra quyết định.

NVIDIA Technical Blog: Agentic AI / Generative AI
Hướng dẫnĐiểm AI 52/100

NVIDIA giải mã: So sánh mô hình Dense và MoE về tham số kích hoạt, hiệu suất và cách lựa chọn

Blog kỹ thuật của NVIDIA phân tích sự khác biệt giữa kiến trúc Dense và MoE. Điểm nhấn là cơ chế định tuyến của MoE giúp tối ưu hóa hiệu suất, ví dụ như mô hình Nemotron 3.5 Lightning 30B chỉ kích hoạt 3B tham số cho mỗi token.

15/09

Thứ Ba · 3 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 48/100

Thay thế lan truyền ngược: Sakana AI giới thiệu phương pháp huấn luyện mạng thần kinh mới PC-ALM

Sakana AI ra mắt PC-ALM, phương pháp sử dụng động lực học cục bộ thay thế lan truyền ngược để huấn luyện mạng MLP 1000 lớp, đạt hiệu suất tương đương với các kỹ thuật truyền thống.

JiQiZhiXin
Mô hìnhĐiểm AI 92/100

Tinh chọnGiải mã GPT-6 Astra: Sebastian Raschka phân tích sâu về kiến trúc Transformer vòng lặp và tư duy ẩn

Chuyên gia Sebastian Raschka làm rõ tranh cãi về kiến trúc 'Transformer vòng lặp' trên GPT-6 Astra, khẳng định công nghệ này không làm giảm khả năng giám sát tư duy của AI như đồn đoán.


Vì sao đáng đọc: Bài viết phân tích kỹ thuật chuyên sâu từ chuyên gia uy tín, giải tỏa các tin đồn gây hoang mang về an toàn AI, rất giá trị cho cộng đồng kỹ thuật.

14/09

Thứ Hai · 4 tin
Elvis Saravia@omarsar0
NgànhĐiểm AI 48/100

Kỹ sư AI có nên tự xây dựng Agent Harness thay vì phụ thuộc vào các nền tảng có sẵn?

Should you build an agent harness? I see lots of opinions about it. My thoughts: As an AI enginee…

DịchElvis Saravia từ DAIR.AI khuyên các kỹ sư nên coi 'agent harness' là cốt lõi của hệ thống thay vì chỉ là lớp vỏ bọc. Việc tự xây dựng giúp kiểm soát tốt hơn trong các lĩnh vực chuyên sâu như y tế, tài chính và tránh sự phụ thuộc vào nhà cung cấp mô hình.

MarkTechPost
NgànhĐiểm AI 33/100

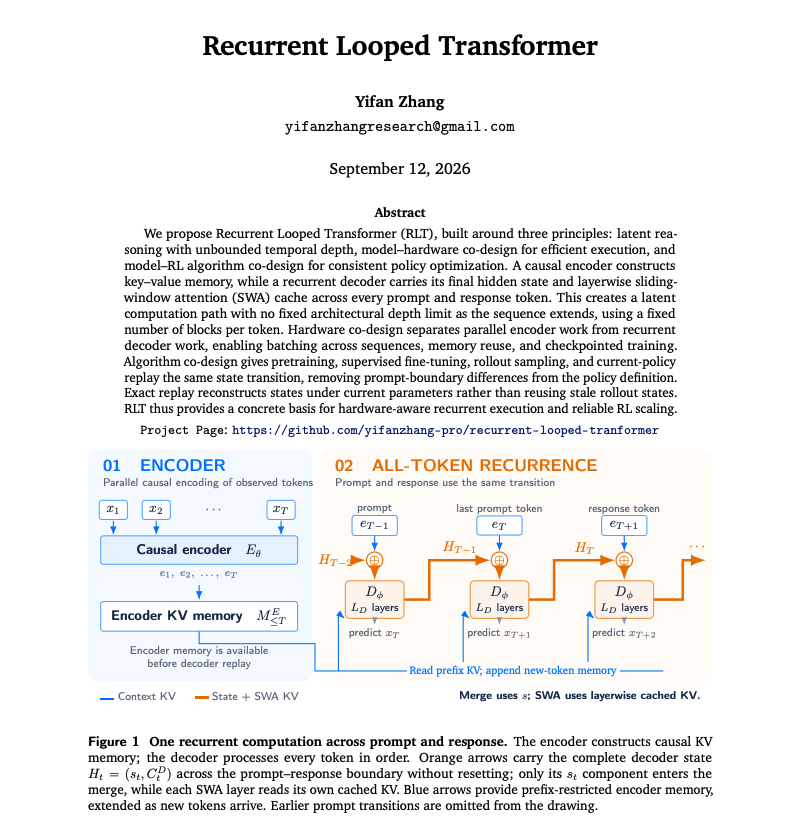
Đại học Princeton giới thiệu Recurrent Looped Transformer (RLT): Đột phá kiến trúc với cơ chế truyền trạng thái liên tục

Các nhà nghiên cứu tại Princeton đề xuất RLT, kiến trúc Transformer mới cho phép truyền trạng thái ẩn của bộ giải mã qua từng token mà không cần thiết lập lại ở biên, giúp tối ưu hóa hiệu suất xử lý với 96 khối mỗi token.

Elvis Saravia@omarsar0
NgànhĐiểm AI 33/100

RLT: Đề xuất kiến trúc Transformer với cơ chế lặp qua từng token

Looped transformers are a popular architecture topic right now. This new technical report extends t…

DịchRLT (Recurrent Looped Transformer) đề xuất tái sử dụng bộ giải mã cho từng token, giúp duy trì chi phí tính toán ổn định bất kể độ dài chuỗi. Dù hứa hẹn về hiệu suất, đây hiện mới chỉ là ý tưởng thiết kế chưa qua thực nghiệm.

12/09

Thứ Bảy · 3 tin
AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 57/100

SpaceXAI trình diễn kiến trúc điều phối hơn 200 AI Agent cùng lúc xử lý công việc thực tế

Cựu kỹ sư Cursor tại SpaceXAI đã giới thiệu quy trình vận hành đa Agent, nơi một 'tham mưu trưởng' AI điều phối hơn 200 tác nhân chuyên biệt để giải quyết các yêu cầu công việc phức tạp, từ lập kế hoạch đến kiểm thử và báo cáo kết quả.

Latent Space
Mô hìnhĐiểm AI 85/100

Cùng sự kiệnDeepSeek v4.1-Flash: Kiến trúc Encoder-Decoder đột phá đánh dấu sự trở lại đầy ấn tượng

DeepSeek ra mắt kiến trúc 763B tham số mới tích hợp thị giác máy tính, một bước tiến mạnh mẽ khiến giới chuyên gia cho rằng đây xứng đáng là phiên bản v5.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
AI Notes@AYi_AInotes
NgànhĐiểm AI 50/100

Cùng sự kiệnKiến trúc DeepSeek V4.1 Flash: Đột phá kỹ thuật không thể sao chép bằng chưng cất

Chuyên gia đánh giá cao kiến trúc CED 20-20 lớp của DeepSeek V4.1 Flash, cho phép tối ưu hóa hiệu suất vượt trội với lượng tham số kích hoạt cực thấp và giảm dung lượng bộ nhớ KV xuống chỉ còn 1/4 so với thế hệ trước.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»

11/09

Thứ Sáu · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

NCP-ArchPreview: Bước tiến mới của mô hình ngôn ngữ thông qua dự đoán khái niệm (Next Concept Prediction)

NCP-ArchPreview giới thiệu phương pháp huấn luyện mới, kết hợp dự đoán token truyền thống với dự đoán khái niệm (NCP) để mô hình hiểu sâu hơn về cấu trúc ngôn ngữ. Với 8,9 tỷ tham số, mô hình này cho thấy tiềm năng lớn trong việc cải thiện khả năng suy luận và tạo văn bản.

10/09

Thứ Năm · 4 tin
Elvis Saravia@omarsar0
NgànhĐiểm AI 41/100

AWS giới thiệu UnitBoost: Thay thế tác nhân quản lý bằng toán tử hợp nhất trong hệ thống LLM

Great paper from AWS. I use a similar setup where an agent orchestrator sits on top of a multi-agen…

DịchAWS đề xuất UnitBoost, phương pháp sử dụng bản đồ đơn vị để chuyển đổi đầu ra của các mô hình thành giá trị cụ thể, loại bỏ nhu cầu về tác nhân quản lý (meta-agent) phức tạp trong các hệ thống LLM đa nhiệm.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnGraph Machine: Đột phá kiến trúc mới giúp tối ưu hóa tiền huấn luyện mô hình ngôn ngữ

Graph Machine (GM) là kiến trúc mới sử dụng các 'cạnh' (edges) linh hoạt để truy xuất dữ liệu, giúp duy trì độ phức tạp O(n) mà vẫn đảm bảo tính thưa thớt hiệu quả. Phương pháp này cho phép thay thế phần lớn các lớp Transformer truyền thống với hiệu suất vượt trội và chi phí tính toán thấp.


Vì sao đáng đọc: Đây là một nghiên cứu kỹ thuật chuyên sâu có tiềm năng thay đổi cách thiết kế kiến trúc mô hình ngôn ngữ, giúp giảm tài nguyên tính toán mà vẫn giữ được độ chính xác.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (78 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “kiến trúc AI” | AIHOT.vn