13/09

Chủ Nhật · 3 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnChi phí suy luận giảm 96%, hiệu năng vượt trội: Khi mô hình nhỏ biết tự 'cầu cứu' AI lớn

Pyromind giới thiệu PyroDash, giải pháp cho phép các mô hình nhỏ tự quyết định thời điểm cần gọi mô hình lớn hỗ trợ. Cách tiếp cận này giúp cắt giảm chi phí vận hành tới 96% mà vẫn duy trì, thậm chí cải thiện độ chính xác so với việc chỉ dùng mô hình lớn.


Vì sao đáng đọc: Đây là bước tiến thực tế giải quyết bài toán chi phí đắt đỏ trong AI, có tính ứng dụng cao cho doanh nghiệp và lập trình viên, đồng thời phương pháp tiếp cận rất thông minh.
Ma Dongxi NLP@dongxi_nlp
NgànhĐiểm AI 44/100

Cùng sự kiệnTại sao KV Cache trong LLM lại lưu trữ K và V mà bỏ qua Q?

Bài viết giải thích cơ chế KV Cache trong suy luận LLM: K và V của các token trước được lưu lại để tái sử dụng, trong khi Q chỉ dùng cho vị trí hiện tại nên không cần lưu trữ.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»

12/09

Thứ Bảy · 7 tin
Elvis Saravia@omarsar0
NgànhĐiểm AI 39/100

Looped Flows: Phương pháp huấn luyện mới tối ưu hóa suy luận cho mô hình tuần hoàn

Interesting paper to improve recurrent reasoning. Looped models are great because you get more reas…

DịchLooped Flows giới thiệu cách huấn luyện mô hình tuần hoàn thông qua mục tiêu khử nhiễu cục bộ, giúp các trạng thái ẩn liên kết chặt chẽ và khắc phục hạn chế về dòng chảy gradient. Phương pháp này cải thiện hiệu suất vượt trội trên hầu hết các bài kiểm tra suy luận so với các kiến trúc cũ.

The Decoder: AI News
NgànhĐiểm AI 46/100

Nghiên cứu mới: Các bước suy luận trong văn bản AI tương ứng với những mô hình hoạt động nội tại riêng biệt

Các nhà nghiên cứu từ KAIST và Naver AI Lab phát hiện rằng các bước suy luận của AI có thể được phân biệt thông qua trạng thái nội tại của mô hình. Kết quả này cho thấy AI không chỉ tạo văn bản ngẫu nhiên mà thực sự vận hành theo các quy trình tư duy logic cụ thể ở tầng trung gian.

Qwen@Alibaba_Qwen
NgànhĐiểm AI 44/100

Mô hình Qwen2.5-72B đổ bộ nền tảng Cerebras: Tốc độ suy luận cực nhanh

Fast meets open. 🚀 Qwen3.8-27B is now running on @cerebras with rapid inference. Try it now!

DịchMô hình mã nguồn mở Qwen2.5-72B từ Alibaba đã chính thức có mặt trên Cerebras, mang lại hiệu suất suy luận vượt trội với tốc độ cực nhanh, ngang hàng với các mô hình hàng đầu hiện nay.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Think Before You Link: Cải thiện liên kết thực thể đa ngôn ngữ bằng suy luận và truy xuất

Nghiên cứu chỉ ra rằng các hệ thống liên kết thực thể thường thất bại với các thực thể hiếm. Tác giả đề xuất khung làm việc không cần huấn luyện, sử dụng mô hình ngôn ngữ-hình ảnh để suy luận và truy xuất dữ liệu từ Wikipedia nhằm cải thiện độ chính xác.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnXây dựng cầu nối đa ngôn ngữ: Tối ưu hóa dữ liệu để nâng cao khả năng suy luận của AI

Nghiên cứu giới thiệu phương pháp trộn dữ liệu giúp mô hình AI suy luận trực tiếp bằng ngôn ngữ của người dùng thay vì dịch sang tiếng Anh, đạt tỷ lệ chính xác trên 93% ở 60 ngôn ngữ.


Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề cốt lõi về sự thiên kiến tiếng Anh trong AI, mang tính ứng dụng cao cho người dùng toàn cầu và cung cấp giải pháp kỹ thuật cụ thể.
Yuchen Jin@Yuchenj_UW
NgànhĐiểm AI 26/100

Databricks tối ưu hóa tốc độ suy luận AI: Phản hồi gần như tức thì

5 months at Databricks. I do not say this lightly. Our AI inference is getting too fast. We are ext…

DịchKỹ sư tại Databricks khẳng định tốc độ suy luận AI đã được cải thiện vượt bậc, đạt đến mức phản hồi gần như ngay lập tức ngay khi người dùng vừa nhập xong câu lệnh.

11/09

Thứ Sáu · 1 tin
SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 43/100

GB300 NVL72: Hiệu năng suy luận AI vượt trội gấp 13 lần so với Hopper

ALERT🚨 GB300 NVL72 NVLINK BACKPLANE ENABLES 13x BETTER PERF PER DOLLAR THAN HOPPER ON AGENTIC INFER…

DịchNhờ thiết kế bảng mạch đồng cải tiến, GB300 NVL72 mở rộng quy mô lên tới 72 GPU, cho phép tối ưu hóa song song các chuyên gia (MoE) và đạt hiệu suất trên mỗi USD cao gấp 13 lần so với kiến trúc Hopper.

10/09

Thứ Năm · 4 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 43/100

Tại sao xử lý video vẫn quá đắt đỏ? Tổng quan về cơ chế tối ưu hiệu năng suy luận cho Video LLM

Bài tổng quan hệ thống hóa các phương pháp tối ưu hóa suy luận cho Video LLM qua bốn giai đoạn: lấy mẫu khung hình, mã hóa đa phương thức, nén token và xử lý LLM, đồng thời chỉ ra những khoảng trống trong tiêu chuẩn đánh giá hiệu năng hiện nay.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

DATPO: Tối ưu hóa chính sách dạng cây thích ứng độ khó để mở rộng khả năng suy luận trong RLVR

Nghiên cứu giới thiệu DATPO, phương pháp tối ưu hóa cấu trúc suy luận dạng cây giúp tăng cường độ đa dạng ngữ nghĩa và khả năng giải quyết vấn đề của các mô hình AI thông qua học tăng cường có thưởng (RLVR).

Hongming@hongming731
NgànhĐiểm AI 37/100

Cùng sự kiệnKiến trúc sư AI, kịch bản kinh tế 2030 và đột phá RLM trong xử lý ngữ cảnh dài

Bài viết phân tích cách AI giải quyết lỗi hệ thống phức tạp, dự báo tác động kinh tế của AI vào năm 2030 và giới thiệu mô hình RLM giúp tăng độ chính xác suy luận dài từ 2,6% lên 45,4% thông qua môi trường thực thi Python.

Cùng sự kiện, bài đại diện «25 nhà toán học đạt giải Fields gửi thư ngỏ, căng thẳng giữa OpenAI và giới học thuật leo thang»
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 57/100

Thực nghiệm suy luận: Qwen3.8 đạt độ tương đồng 18,18% với GPT-5.5 Pro nhờ kỹ thuật tiền nạp

Tác giả sử dụng GPT-5.5 Pro làm mô hình giáo viên để thực hiện kỹ thuật tiền nạp (pre-filling) 1% dữ liệu suy luận vào Qwen3.8, kết quả cho thấy độ tương đồng câu trả lời tăng đáng kể trên 45 bài kiểm tra.

09/09

Thứ Tư · 5 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Giải mã tư duy Transformer: Khi nào mô hình thực sự hiểu trình độ của đối phương?

Nghiên cứu khám phá khoảng cách giữa việc mô hình nhận diện thông tin và thời điểm sử dụng chúng. Kết quả cho thấy dù mô hình sớm nhận diện được trình độ chuyên môn của đối tác, nhưng phải đến các lớp sâu hơn thông tin này mới thực sự tác động đến phản hồi.

Cohere@cohere
Sản phẩmĐiểm AI 50/100

Cohere ra mắt hệ thống suy luận LLM mã nguồn mở mới, nhanh hơn vLLM tới 1,58 lần

Introducing the next evolution in LLM text generation: the first fully-fledged serving system built …

DịchCohere vừa giới thiệu hệ thống phục vụ tạo văn bản LLM dựa trên kiến trúc decode megakernel, mang lại hiệu suất vượt trội so với vLLM và được phát hành hoàn toàn dưới dạng mã nguồn mở.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 66/100

Cùng sự kiệnRohan Paul: Mô hình nội bộ chưa công bố của OpenAI vượt xa GPT-6 Astra

OpenAI's unreleased internal model sits on a much higher capability curve than GPT-6 Astra. the one…

DịchOpenAI tiết lộ các mô hình nội bộ mới đạt bước tiến vượt bậc so với GPT-6 Astra, tiêu biểu là khả năng giải phương trình Navier-Stokes nhờ 10.000 AI agent phối hợp. Công nghệ này tối ưu hóa hiệu suất suy luận thay vì chỉ kéo dài thời gian xử lý.

Cùng sự kiện, tinh chọn hiển thị «OpenAI ra mắt mô hình giọng nói song công GPT-Live-1 qua API»
Aravind Srinivas (Perplexity CEO)@AravSrinivas
NgànhĐiểm AI 32/100

Perplexity chuyển dịch khối lượng suy luận sang kiến trúc NVLink Blackwell

We have started serving a lot of our inference on NVLink Blackwells. Vera Rubins next!

DịchCEO Perplexity thông báo đã chuyển phần lớn khối lượng suy luận sang hệ thống NVLink Blackwell để tối ưu hóa hiệu suất cho hơn 50 triệu truy vấn mỗi ngày. Công ty cũng xác nhận nền tảng Vera Rubin sẽ là bước tiến tiếp theo trong lộ trình phát triển hạ tầng AI.

08/09

Thứ Ba · 1 tin
vLLM Blog chính thức
Hướng dẫnĐiểm AI 63/100

Tinh chọnvLLM kết hợp AgentX: Tối ưu hóa toàn diện cho các tác vụ suy luận AI Agent thực tế

Đội ngũ vLLM công bố tối ưu hóa hiệu suất cho các tác vụ AI Agent, đạt tốc độ ấn tượng 83K tokens/giây trên mỗi GPU với mô hình DeepSeek V4 Pro dựa trên chuẩn AgentX.


Vì sao đáng đọc: Đây là bước tiến kỹ thuật quan trọng giúp tăng tốc độ xử lý cho các hệ thống AI Agent, rất hữu ích cho các kỹ sư và nhà phát triển ứng dụng LLM.

07/09

Thứ Hai · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Khi lượng tử hóa làm hỏng bộ nhớ: Vấn đề ghi đè trạng thái hồi quy trong suy luận độ chính xác thấp

Nghiên cứu chỉ ra rằng việc lượng tử hóa trạng thái trong mạng hồi quy (RNN) có thể gây sai số nghiêm trọng khi dự đoán các thông số sinh học. Việc lưu trữ trạng thái 4-bit làm tăng sai số dự báo lên gấp hàng trăm lần so với mô hình gốc.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 64/100

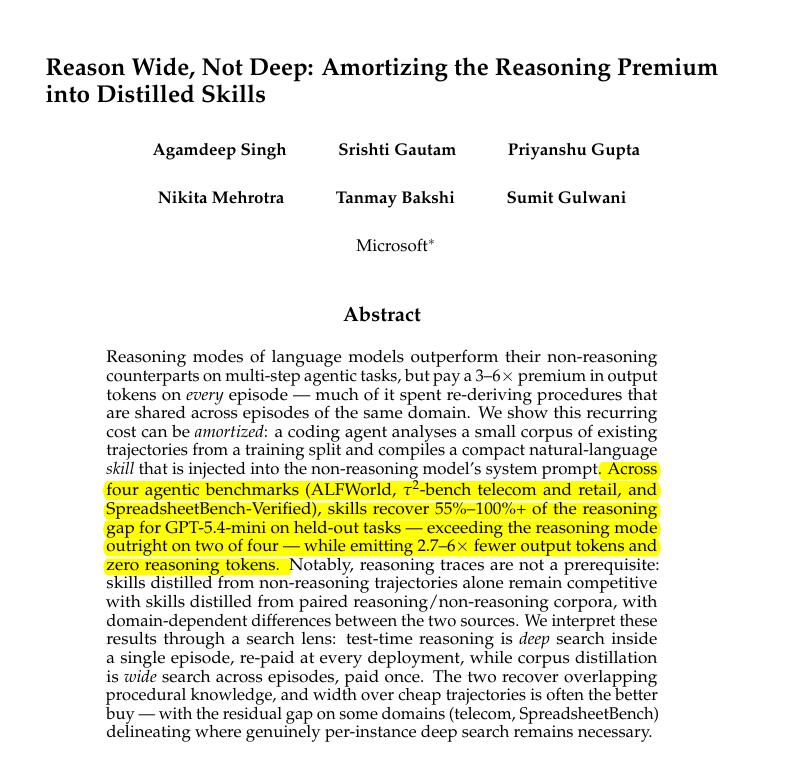
Microsoft đề xuất phương pháp chưng cất kỹ năng suy luận: Giúp mô hình nhỏ đạt hiệu suất vượt trội

What if you could pay the reasoning cost once, then reuse what the model learned across future tasks…

DịchNghiên cứu mới từ Microsoft cho phép chuyển đổi chi phí suy luận đắt đỏ thành các 'kỹ năng' dạng Markdown. Bằng cách tổng hợp các mẫu lỗi từ lịch sử, mô hình nhỏ có thể khôi phục 55-100% khả năng suy luận mà không cần tốn thêm token.

06/09

Chủ Nhật · 1 tin

05/09

Thứ Bảy · 1 tin

04/09

Thứ Sáu · 4 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

Random Attention: Tối ưu hóa KV Cache bằng cơ chế loại bỏ ngẫu nhiên giúp tăng tốc suy luận LLM

Salesforce giới thiệu Random Attention, phương pháp thay thế việc đánh giá token bằng cách loại bỏ ngẫu nhiên trong KV cache. Kỹ thuật này giúp tăng 32-43% lưu lượng xử lý trên vLLM mà vẫn duy trì độ chính xác tương đương các phương pháp tiên tiến nhất.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 44/100

Nghiên cứu từ Stanford: Kỹ thuật Prefix Sliding giúp tăng tốc suy luận AI gấp 3 lần mà không cần huấn luyện lại

New Stanford paper Prefix Sliding shows that long reasoning does not need the full chain of thought …

DịchPhương pháp Prefix Sliding cho phép mô hình AI lược bỏ các token suy luận trung gian, chỉ giữ lại tiền tố nhiệm vụ và cửa sổ trượt gần nhất, giúp tối ưu hóa tốc độ suy luận gấp 3 lần mà không làm giảm hiệu suất.

AI Safety Memes@AISafetyMemes
Hướng dẫnĐiểm AI 61/100

GPT-6 Astra: Bước nhảy vọt về suy luận ẩn, thách thức phương pháp giám sát Chain-of-Thought

"extremely concerning" "GPT-6 Astra appears to be a massive jump in opaque reasoning ability: it ca…

DịchRyan Greenblatt cảnh báo GPT-6 Astra có khả năng giải toán khó mà không cần hiển thị suy luận, khiến phương pháp giám sát Chain-of-Thought truyền thống dần mất hiệu quả. Sự thay đổi kiến trúc này đặt ra thách thức lớn cho việc kiểm soát và đánh giá độ an toàn của các mô hình AI thế hệ mới.

Greg Brockman@gdb
Mô hìnhĐiểm AI 71/100

Tinh chọnGPT-6 Astra thiết lập kỷ lục mới trên ARC-AGI-3: Đạt 99% điểm số, vượt xa khả năng con người

arc-agi-3 is now saturated

DịchGreg Brockman xác nhận GPT-6 Astra đạt SOTA trên ARC-AGI-3 với 99% điểm số, vượt qua con người ở 96% các tác vụ. Đáng chú ý, mô hình này tối ưu hóa chi phí hiệu quả hơn nhờ khả năng suy luận vượt trội, giảm thiểu số lượng token và lượt gọi API cần thiết.

Diễn biến sự kiện · 2 bài →Thêm 2 nguồn khác đưa tinHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)X: Testing Catalog (@testingcatalog)

Vì sao đáng đọc: Tin tức quan trọng về cột mốc AGI. Việc đạt 99% trên ARC-AGI cho thấy bước tiến lớn về khả năng suy luận logic của AI, thu hút sự quan tâm lớn từ cộng đồng công nghệ.

03/09

Thứ Năm · 4 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 43/100

Switch Distillation: Tối ưu hóa chưng cất tri thức trong giai đoạn huấn luyện trung gian

Nghiên cứu đề xuất phương pháp Switch Distillation, sử dụng độ bất định của mô hình giáo viên để điều hướng quá trình chưng cất, giúp cải thiện khả năng suy luận mà không làm suy giảm khả năng ghi nhớ sự kiện trong giai đoạn huấn luyện trung gian.

Kim@kimmonismus
Hướng dẫnĐiểm AI 47/100

Mostik: Giao thức cầu nối không gian ẩn giúp mô hình 4B đạt hiệu suất tiệm cận mô hình 753B

A 753B model reads the problem: A 4B model writes the answer. Mostik reports that its latent bridge…

DịchMostik giới thiệu giao thức cầu nối không gian ẩn cho phép mô hình 4B nhận dữ liệu trực tiếp từ mô hình 753B mà không cần tinh chỉnh. Giải pháp này giúp tăng tốc độ xử lý gấp 20 lần và tiết kiệm 2,5 lần tài nguyên tính toán trong khi vẫn duy trì 80% độ chính xác của mô hình lớn.

02/09

Thứ Tư · 3 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 36/100

Kỹ sư Baseten giải mã 'Biên hiệu quả' trong suy luận LLM và các kỹ thuật tối ưu hóa

Bài viết phân tích khung 'Biên hiệu quả' của LLM, chia các kỹ thuật tối ưu thành hai nhóm: cân bằng giữa độ trễ và thông lượng, hoặc đẩy xa giới hạn hiệu suất để đạt hiệu quả tổng thể cao hơn.

Kim@kimmonismus
Hướng dẫnĐiểm AI 53/100

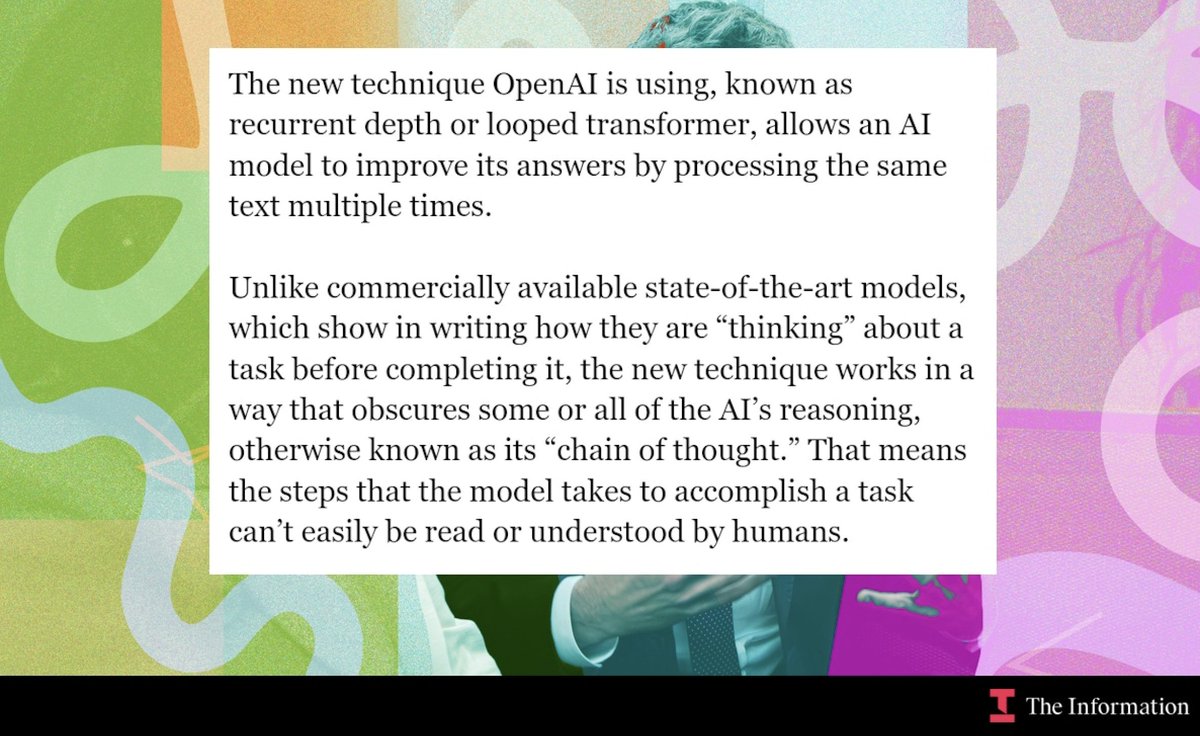
OpenAI Astra bị nghi dùng kỹ thuật 'recurrent depth' để tối ưu suy luận, gây lo ngại về tính minh bạch

Holy, Astra is build different: OpenAI's Astra model reportedly uses "recurrent depth" to improve co…

DịchOpenAI Astra được cho là sử dụng phương pháp 'recurrent depth' để tái sử dụng các lớp mô hình, giúp tăng hiệu suất cho mô hình nhỏ nhưng lại làm ẩn đi các bước suy luận, gây khó khăn cho việc giám sát quá trình tư duy của AI.

Yuchen Jin@Yuchenj_UW
Hướng dẫnĐiểm AI 46/100

GLM-5.3 trên Databricks đạt tốc độ 310 tok/s, dẫn đầu về hiệu năng suy luận

GLM-5.3 at 310 tok/s! Databricks inference is #1 in both speed and latency, again. On our internal…

DịchTheo đánh giá từ Yuchen Jin, GLM-5.3 trên nền tảng Databricks đạt tốc độ 310 tok/s với độ trễ cực thấp, vượt trội so với các đối thủ. Mô hình này cũng được đánh giá là mã nguồn mở mạnh nhất về khả năng lập trình, cạnh tranh trực tiếp với Fable 5 và Opus 4.8.

01/09

Thứ Ba · 2 tin
WeChat: Xiaohongshu Tech (dots.llm)
Hướng dẫnĐiểm AI 42/100

Tiểu Hồng Thư hợp tác cùng NVIDIA ra mắt GR-Inference: Tối ưu hóa công cụ suy luận cho Generative Retrieval

Tiểu Hồng Thư và NVIDIA cùng phát triển GR-Inference, công cụ suy luận chuyên dụng giúp tối ưu hóa các tác vụ truy xuất tạo sinh (Generative Retrieval) thông qua các kỹ thuật như xử lý batch liên tục và tối ưu hóa bộ nhớ KV.

SemiAnalysis@SemiAnalysis_
Hướng dẫnĐiểm AI 41/100

Giải mã 3 kiến trúc suy luận tách biệt của NVIDIA LPU

NVIDIA LPU supports 3 types of disaggregated inferencing: 1. Rubin Prefill + LPU Decode for the fas…

DịchNVIDIA LPU tối ưu hóa hiệu suất thông qua 3 cấu hình kết hợp giữa Rubin và LPU, tùy chỉnh linh hoạt cho từng nhu cầu từ tương tác tốc độ cao đến các tác vụ suy luận phức tạp.

30/08

Chủ Nhật · 1 tin

29/08

Thứ Bảy · 4 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (69 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Suy luận AI” — Trang 2 | AIHOT.vn