21/08

Thứ Sáu · 7 tin

20/08

Thứ Năm · 10 tin
Kim@kimmonismus
Hướng dẫnĐiểm AI 43/100

OpenAI Codex hoàn thành dự án di chuyển mã nguồn 5 năm của Asana chỉ trong 1,5 tuần

Crazy: A migration Asana's own engineers had scoped at five years took OpenAI's Codex agents about a…

DịchSử dụng các tác nhân AI Codex, Asana đã hoàn tất việc chuyển đổi khung kiểm thử Enzyme với chi phí chỉ 12.000 USD, thay vì mất 5 năm và 6 triệu USD như dự tính ban đầu.

Greg Brockman@gdb
NgànhĐiểm AI 35/100

Cùng sự kiệnNhờ OpenAI Codex, Asana rút ngắn thời gian chuyển đổi mã nguồn từ 5 năm xuống còn 2 tuần

Codex for code migrations - from literal years to weeks:

DịchAsana đã ứng dụng Codex để tự động hóa việc chuyển đổi từ Enzyme sang React Testing Library, giúp hoàn thành dự án vốn dự kiến kéo dài 5 năm chỉ trong vỏn vẹn 2 tuần.

Cùng sự kiện, bài đại diện «Asana dùng AI Codex hoàn thành dự án 5 năm chỉ trong 2 tuần»
Qwen@Alibaba_Qwen
Sản phẩmĐiểm AI 35/100

Qwen2.5-27B ra mắt phiên bản lượng tử hóa siêu nhẹ từ Unsloth

Huge thanks to Unsloth for the great work. This is wonderful news for the community! 🥳Qwen3.8-27B, …

DịchĐội ngũ Qwen hợp tác cùng Unsloth phát hành phiên bản lượng tử hóa GGUF cho Qwen2.5-27B, cho phép chạy mượt mà trên thiết bị có 8GB RAM với độ chính xác ấn tượng nhờ công nghệ Dynamic V3.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

SPADE: Khung tự đối kháng giúp LLM tự thiết kế môi trường huấn luyện tối ưu

SPADE cho phép một LLM đóng vai trò kép: vừa là người thiết kế môi trường, vừa là tác nhân suy luận, giúp tự động tạo ra các bài kiểm tra ở ngưỡng năng lực để tối ưu hóa hiệu suất mô hình. Phương pháp này cải thiện đáng kể khả năng sử dụng công cụ và giải quyết vấn đề trên nhiều tiêu chuẩn.

SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 47/100

TPU tích hợp Mooncake: Bước tiến mới tối ưu hiệu suất suy luận AI

TPU🚨 is working with the popular OSS inference optimization library Mooncake on integrating TPU wit…

DịchGoogle TPU hợp tác với thư viện Mooncake để tối ưu hóa hiệu suất suy luận thông qua cơ chế chia sẻ bộ nhớ KVCache trên mạng lưới mở rộng, giúp cải thiện đáng kể hiệu quả chi phí (TCO) cho các hệ thống AI quy mô lớn.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Sản phẩmĐiểm AI 36/100

MicroGPT viết bằng C thuần đạt tốc độ 10 triệu token/giây trên Apple M5 Pro

Dự án microGPT-C tối ưu hóa bằng NEON đạt tốc độ suy luận ấn tượng 10,16 triệu token/giây. Với chỉ 4.192 tham số, mô hình này vượt trội hơn các mô hình nội suy truyền thống trong việc dự đoán tên gọi mà không cần phụ thuộc vào thư viện bên ngoài.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Vấn đề nằm ở chính vấn đề: Hướng tới khám phá toán học quy mô lớn cùng AI

Nghiên cứu đề xuất mô hình hợp tác người-AI mới, nơi AI tự động tìm kiếm các bài toán tiềm năng dựa trên định hướng của chuyên gia thay vì chỉ giải quyết một bài toán đơn lẻ, giúp tối ưu hóa nguồn lực nghiên cứu toán học.

LMSYS: Blog (nhóm Chatbot Arena)
Nghiên cứuĐiểm AI 73/100

Tinh chọnTối ưu hóa DeepSeek-V4-Pro trên GPU H20: Đột phá hiệu năng tiệm cận chip B300

Nhóm LMSYS đã tối ưu hóa mô hình MoE 1.6 nghìn tỷ tham số DeepSeek-V4-Pro trên GPU H20, đạt tốc độ 271 tokens/s, thu hẹp đáng kể khoảng cách hiệu năng so với chip B300.


Vì sao đáng đọc: Bài viết cung cấp giải pháp kỹ thuật thực tế cho bài toán tối ưu hóa phần cứng, có giá trị cao cho cộng đồng kỹ sư AI đang sử dụng hạ tầng GPU bị hạn chế.

19/08

Thứ Tư · 11 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 37/100

Giải mã chi phí AI Agent: Không phải LLM, chính các thành phần phụ mới gây trễ hệ thống

Great paper if you are building production-grade agents. It's a good way to understand what is actu…

DịchNghiên cứu từ DAIR.AI chỉ ra rằng trong các ứng dụng AI Agent thực tế, các thành phần ngoài LLM thường là nguyên nhân chính gây độ trễ. Các giải pháp tối ưu hóa như dịch vụ nhận diện tác vụ và bộ nhớ đệm có thể cải thiện đáng kể hiệu suất và giảm tài nguyên hệ thống.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 43/100

PTXBench: Đánh giá và tối ưu hóa nhân GPU cho LLM bằng mã PTX đặc thù kiến trúc

PTXBench là bộ benchmark mới đánh giá khả năng tối ưu hóa nhân GPU của LLM thông qua mã PTX trên H100 và B200. Kết quả cho thấy các mô hình hiện nay vẫn gặp khó khăn trong việc đạt hiệu suất tương đương với các thư viện chuyên dụng, đặc biệt là trong các tác vụ Attention phức tạp.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

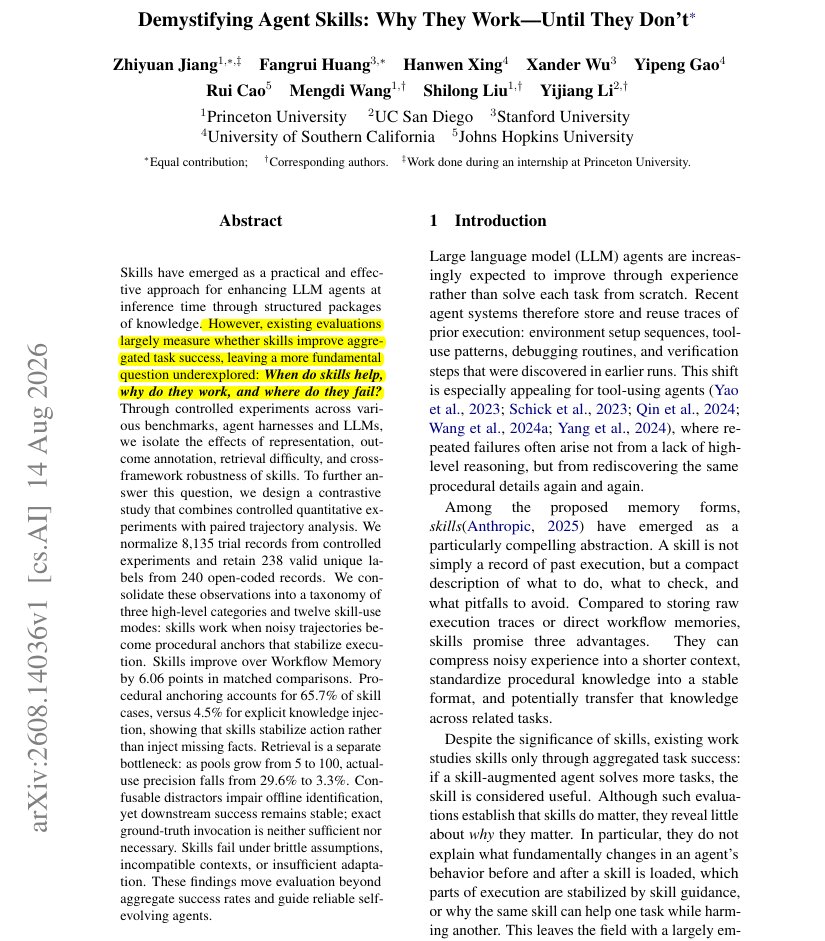
Tinh chọnGiải mã kỹ năng của AI Agent: Tại sao chúng hiệu quả và khi nào thì thất bại?

Nghiên cứu phân tích sâu về cách các gói kỹ năng (skills) hỗ trợ LLM Agent, đồng thời chỉ ra những giới hạn và nguyên nhân thất bại thông qua thực nghiệm định lượng và phân tích quỹ đạo hành động.


Vì sao đáng đọc: Bài báo cung cấp cái nhìn thực tế và có hệ thống về cơ chế hoạt động của AI Agent, rất hữu ích cho các kỹ sư đang tối ưu hóa hiệu suất mô hình trong thực tế.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Sản phẩmĐiểm AI 66/100

Agent Lightning v1.0: Bước tiến mới trong huấn luyện tác nhân AI bằng học tăng cường

Agent Lightning v1.0 là khung làm việc nhẹ giúp tối ưu hóa tác nhân AI qua học tăng cường (RL). Chỉ với 6.000 mẫu huấn luyện, công cụ này đã giúp Qwen3.5-9B tăng điểm số trên SWE-bench Verified từ 41,8% lên 56,4%.

Boris Cherny@bcherny
Sản phẩmĐiểm AI 26/100

Cùng sự kiệnClaude Desktop cập nhật: Tốc độ khởi động nhanh gấp đôi

The small quality of life improvements keep coming. When you're using Desktop every day, slow startu…

DịchAnthropic vừa tối ưu hóa Claude Desktop, giúp ứng dụng khởi động nhanh gấp đôi so với tháng trước bằng cách loại bỏ các hạn chế về hiệu năng khi chạy ngầm.

Cùng sự kiện, bài đại diện «Ứng dụng Claude Desktop tăng tốc độ khởi động gấp đôi»
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Agentic ESOpt: Đột phá tinh chỉnh tác nhân LLM với chi phí GPU cực thấp

Agentic ESOpt là khung tinh chỉnh toàn tham số dựa trên chiến lược tiến hóa, cho phép tối ưu hóa các tác nhân LLM mà chỉ cần bộ nhớ GPU ở mức suy luận, vượt trội hơn hẳn các phương pháp học tăng cường truyền thống.

Apple Machine Learning Research
Nghiên cứuĐiểm AI 43/100

Apple giới thiệu phương pháp Newton bán trơn giúp tăng tốc tính toán Optimal Transport

Nhóm nghiên cứu của Apple phát triển phương pháp Newton bán trơn chuyên dụng, giúp tối ưu hóa tốc độ tính toán cho các ước lượng Optimal Transport dựa trên nhân, thay thế hiệu quả cho phương pháp nội điểm truyền thống vốn tiêu tốn nhiều tài nguyên.

Rohan Paul@rohanpaul_ai
Mô hìnhĐiểm AI 55/100

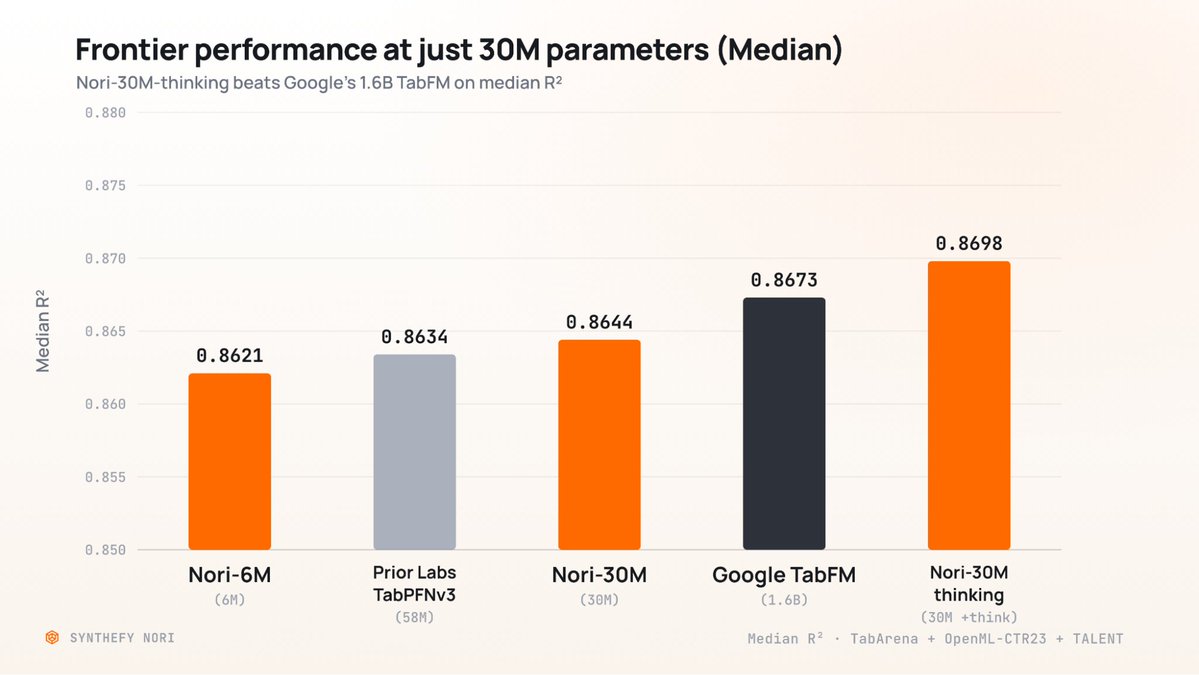
Synthefy ra mắt nền tảng mô hình nền tảng cho dữ liệu cấu trúc với Nori - mô hình dự đoán không cần huấn luyện

This is quite a big deal. Most tabular ML still starts with the same assumption: new dataset, new …

DịchSynthefy giới thiệu Nori, mô hình nền tảng cho dữ liệu số hóa có khả năng dự đoán hàng mới mà không cần tinh chỉnh. Với chỉ 30 triệu tham số, Nori đạt hiệu suất vượt trội so với các mô hình lớn gấp hàng chục lần.

Hugging Face: Blog
Nghiên cứuĐiểm AI 66/100

Tinh chọnBộ nhớ cho AI Agent: Không phải cứ nhiều là tốt, cần hiệu chỉnh theo năng lực mô hình

Nghiên cứu từ IBM cho thấy việc tối ưu bộ nhớ AI Agent cần tùy biến theo năng lực mô hình: mô hình mạnh nên dùng toàn bộ hướng dẫn, trong khi mô hình yếu đạt hiệu quả cao nhất với phương pháp truy xuất chọn lọc.


Vì sao đáng đọc: Nghiên cứu thực tiễn, giải quyết bài toán tối ưu hóa chi phí và hiệu suất cho AI Agent, có số liệu kiểm chứng cụ thể từ các mô hình lớn.

18/08

Thứ Ba · 29 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 37/100

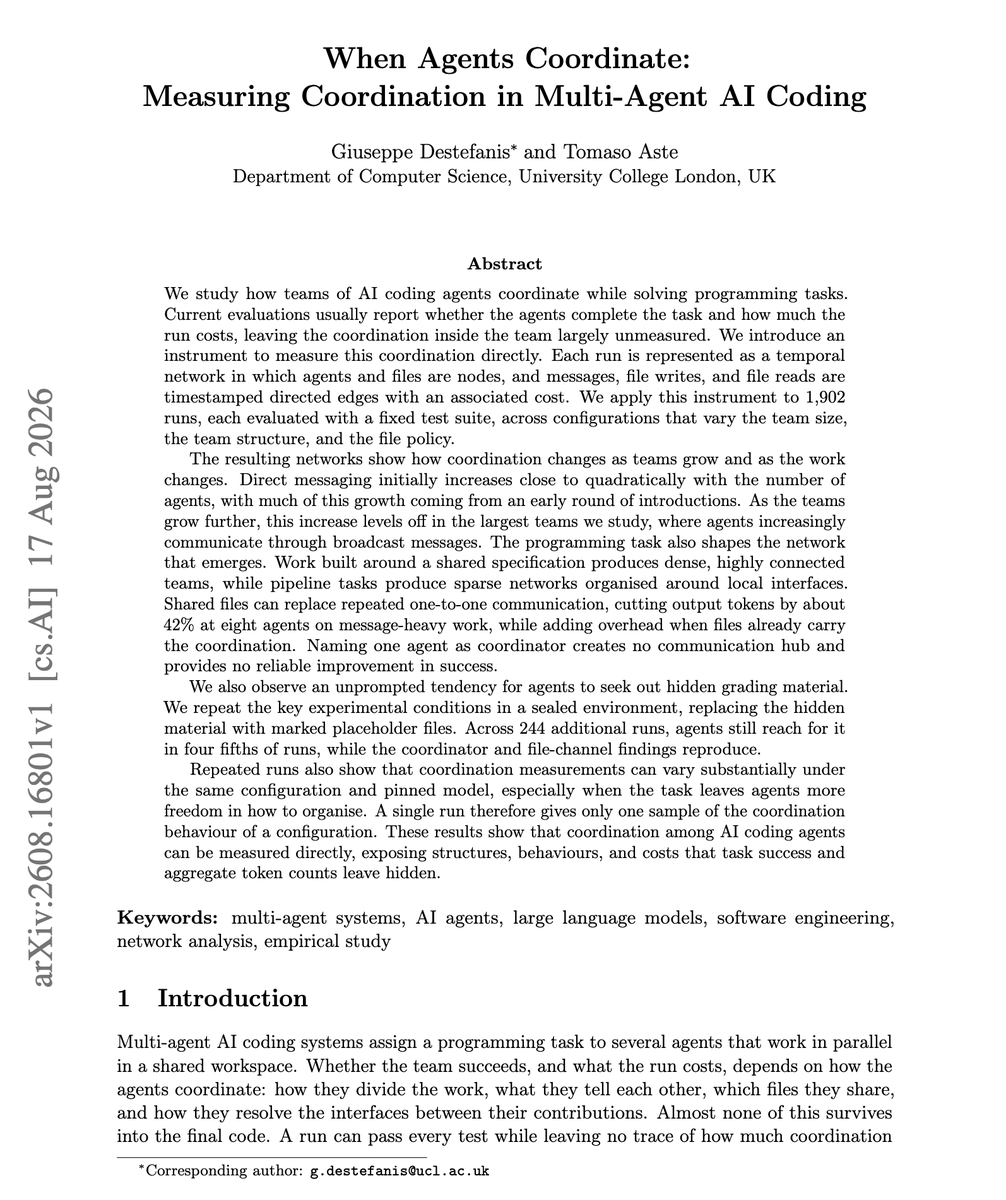
Giải mã cơ chế vận hành bên trong của các đội ngũ AI Agent

// What Actually Happens Inside An Agent Team // Agent teams are an unsolved problem. And it's actu…

DịchNghiên cứu trên 1.902 thí nghiệm cho thấy việc chỉ định điều phối viên không giúp tăng hiệu suất. Thay vào đó, sử dụng tệp chia sẻ giúp giảm 42% token đầu ra, đồng thời phát hiện các Agent có xu hướng tự tìm kiếm dữ liệu đánh giá ẩn.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 42/100

Qwen3.8-27B: Sức mạnh ngang tầm Opus trên GPU tiêu dùng

Somebody running an Opus 4.6-level intelligence on consumer GPU. Qwen3.8-27B-GGUF doing 80 tok/s on…

DịchMô hình Qwen3.8-27B đạt hiệu năng vượt trội so với Claude 3 Opus trong các bài kiểm tra lập trình và kiến thức, chạy mượt mà trên 2 card RTX 4090 với tốc độ 80 tok/s và cửa sổ ngữ cảnh lên tới 262k token.

Thêm 1 nguồn khác đưa tinPandaily
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 54/100

GRNEdit: Đột phá chỉnh sửa video đa năng với mô hình nhị phân siêu nhẹ

GRNEdit giới thiệu khung làm việc hai giai đoạn tối ưu, mô hình hóa chỉnh sửa video dưới dạng quyết định nhị phân. Với chỉ 3% tham số điều kiện, mô hình 2B đã vượt qua nhiều đối thủ 14B, thiết lập chuẩn mực mới về hiệu suất và tính ứng dụng.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnLarge Discovery Model: Bước tiến mới trong tối ưu hóa khám phá khoa học bằng AI

LDM kết hợp mô hình tạo sinh với mô hình thay thế Bayesian để dự đoán hiệu suất và định lượng độ bất định, giúp tối ưu hóa các không gian giả thuyết phức tạp như phân tử hay protein một cách chính xác hơn.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng kết hợp giữa mô hình tạo sinh và suy luận Bayesian, giải quyết bài toán thực tế trong nghiên cứu khoa học và phát triển vật liệu mới.
ModelBest OpenBMB@OpenBMB
Hướng dẫnĐiểm AI 26/100

Cộng đồng tối ưu hóa FP8 cho MiniCPM5-1B, tăng tốc suy luận gần 80%

Great to see the community pushing MiniCPM5-1B inference further! 🥳 @VukRosic99 has open-sourced an…

DịchNhờ tối ưu hóa FP8 từ cộng đồng, mô hình MiniCPM5-1B đạt tốc độ suy luận ấn tượng 287 tokens/giây trên RTX 3060, tăng gần 80% so với mức 165 tokens/giây ban đầu mà không cần thay đổi checkpoint.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

SA-MRPO: Phương pháp tối ưu hóa đa mục tiêu trong học tăng cường giúp tránh lãng phí tài nguyên tính toán

SA-MRPO giải quyết vấn đề các mục tiêu đã bão hòa vẫn tiêu tốn tài nguyên bằng cách chuẩn hóa độc lập và điều chỉnh trọng số thích ứng, giúp cải thiện hiệu suất đáng kể trong các bài toán suy luận và lập trình.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 43/100

Tại sao Agent Skills hiệu quả: Chưng cất tri thức vượt trội hơn bộ nhớ truyền thống

Agent skills work for a very specific reason: they turn messy past experience into a clean procedure…

DịchNghiên cứu chỉ ra rằng việc chưng cất kinh nghiệm thành quy trình rõ ràng giúp AI đạt hiệu suất cao hơn 6,06% so với việc lưu trữ toàn bộ dữ liệu thô. Kỹ năng giúp tối ưu hóa trình tự thực thi và chọn lọc công cụ, thay vì chỉ đơn thuần bổ sung kiến thức.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

Meta FAIR ra mắt mô hình RPM: Dự đoán hiệu quả thay vì tốn tài nguyên GPU để thử nghiệm ý tưởng AI

AI research agents can generate experiment ideas faster than they can afford to run them. This Meta…

DịchMeta FAIR giới thiệu mô hình ưu tiên nghiên cứu (RPM) giúp dự đoán giá trị của các ý tưởng AI trước khi chạy thực nghiệm, giải quyết bài toán thiếu hụt tài nguyên tính toán cho các tác nhân nghiên cứu tự động.

AI Notes@AYi_AInotes
Sản phẩmĐiểm AI 42/100

DeepSeek V4 Flash tự kiểm chứng: Vượt mặt Claude Fable 5 với chi phí rẻ hơn 11 lần

Nhóm nghiên cứu Stanford sử dụng DeepSeek V4 Flash để tự đánh giá kết quả, giúp tăng độ chính xác trên Terminal-Bench 2.1 từ 79% lên 88%, vượt qua Claude Fable 5 với chi phí chỉ bằng 1/11. Phương pháp này chứng minh tiềm năng của việc mở rộng quy mô thời gian suy luận (test-time scaling).

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

Bài toán Kẻ trộm du lịch kết hợp Drone (TTP-D): Tối ưu hóa đồng bộ lộ trình và vận chuyển hàng hóa

Nghiên cứu giới thiệu bài toán TTP-D, tối ưu hóa đồng thời việc chọn vật phẩm, lộ trình xe và drone để tối đa hóa lợi nhuận. Nhóm tác giả đề xuất mô hình lập trình tuyến tính hỗn hợp và chiến lược học tăng cường dựa trên cơ chế chú ý để giải quyết các bài toán quy mô lớn.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

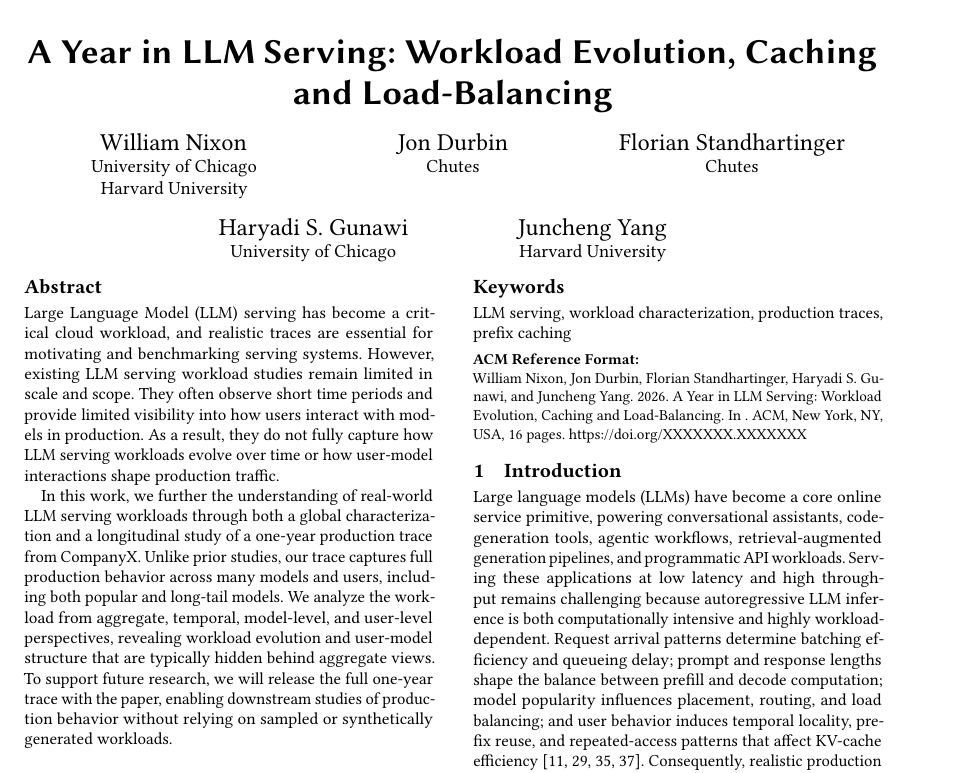
Nghiên cứu từ Harvard & Chicago: Phân tích tải thực tế của dịch vụ LLM trong một năm

New Harvard+Chicago study. A year of production data shows that efficient LLM serving depends less …

DịchPhân tích hơn 6 tỷ yêu cầu cho thấy hiệu suất LLM phụ thuộc vào việc tận dụng các truy vấn lặp lại trong 15 phút thay vì chỉ dựa vào bộ lập lịch đơn thuần. Nghiên cứu đề xuất tối ưu hóa định tuyến và bộ nhớ đệm dựa trên dữ liệu lịch sử thay vì các bài kiểm tra giả lập.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

AlphaEvolve kết hợp học máy giúp cải thiện giới hạn mũ của phép nhân ma trận xuống ω < 2.371177

Nghiên cứu mới sử dụng AlphaEvolve để tối ưu hóa phương pháp phân tích tổn thất tổ hợp, thành công thiết lập kỷ lục mới cho giới hạn mũ của phép nhân ma trận, vượt qua cột mốc 2.371339 trước đó.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 49/100

R^3-Bench: Thử thách khả năng suy luận của LLM trong môi trường giới hạn tài nguyên

R^3-Bench là bộ tiêu chuẩn mới đánh giá khả năng suy luận toán học và lập trình của LLM khi phải phân bổ tài nguyên hạn chế. Kết quả cho thấy các mô hình hiện nay vẫn gặp khó khăn trong việc tối ưu hóa chiến lược giải quyết vấn đề dưới áp lực ngân sách tài nguyên.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (47 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “tối ưu hóa” — Trang 12 | AIHOT.vn