Độ chính xác và sự nhạy cảm với thứ tự đáp án trong các mô hình ngôn ngữ lớn
Nghiên cứu chỉ ra rằng các bài kiểm tra trắc nghiệm thường bị nhiễu do thứ tự đáp án, và việc loại bỏ nhãn lựa chọn không giúp cải thiện độ chính xác thực tế của mô hình.
MiniMax@MiniMax_AICongrats to our long-term partner SGLang/RadixArk on the launch of Miles v0.1! 🎉 From M-Series to …
DịchMiniMax chúc mừng đối tác chiến lược SGLang/RadixArk phát hành Miles v0.1, khung mã nguồn mở hỗ trợ huấn luyện mô hình ngôn ngữ và đa phương thức, đã được kiểm chứng trên các dòng model tiên tiến như Kimi, DeepSeek và MiniMax.
Thêm 1 nguồn khác đưa tinX: SemiAnalysis (@SemiAnalysis_)Qwen3.8-27B gây ấn tượng mạnh khi dẫn đầu bảng xếp hạng Artificial Analysis với 52 điểm, vượt qua cả các mô hình mã nguồn mở khổng lồ, chứng minh sức mạnh vượt trội của các mô hình tối ưu cho thiết bị cá nhân.
Cùng sự kiện, bài đại diện «Mô hình Qwen3.8-27B đã có thể chạy mượt mà trên laptop nhờ Atomic Chat»LangSmith giới thiệu tính năng Tuned Evaluators, cho phép gắn phản hồi chất lượng trực tiếp vào các trace trong môi trường thực tế, bắt đầu với khả năng phát hiện lỗi (Perceived Error) giúp đội ngũ tối ưu hóa AI hiệu quả hơn.
Kim@kimmonismusQwen 27B is the "DeepSeek moment" for open source. It matches the closed-source state-of-the-art fr…
DịchQwen 27B được ví như khoảnh khắc đột phá của mã nguồn mở, đạt hiệu suất ngang tầm các mô hình đóng hàng đầu hiện nay và có thể chạy mượt mà trên card đồ họa RTX 5090.

Thinking Machines vừa giới thiệu Inkling, mô hình được huấn luyện từ đầu với kiến trúc chuyên gia hỗn hợp (MoE), sở hữu 975 tỷ tham số nhưng chỉ kích hoạt 41 tỷ tham số cho mỗi token.
AI Notes@AYi_AInotesQwen 3.8 27B đạt điểm số ấn tượng trên bảng xếp hạng Agentic Index, vượt qua cả GPT-5.6 và Claude Opus 4.8. Với kiến trúc tối ưu, mô hình này có thể chạy mượt mà trên các card đồ họa phổ thông như RTX 3090/4090 với yêu cầu VRAM chỉ 17GB.

Nghiên cứu này kiểm chứng liệu LLM có thực sự thay thế được con người trong khảo sát tâm lý học hay không, bằng cách so sánh dữ liệu mô phỏng với dữ liệu thực tế trên 37 mô hình khác nhau.
Rohan Paul@rohanpaul_aiFinance gives AI agents an unusually unforgiving outcome signal: PnL. And the harder part of an AI …
DịchQuestflow giới thiệu nền tảng AI 4 lớp cho phép người dùng tùy chọn giữa 11 mô hình ngôn ngữ lớn để tự động hóa chiến lược đầu tư, giúp nhà đầu tư cá nhân tiếp cận các phương pháp giao dịch chuyên nghiệp.
Rohan Paul@rohanpaul_aiSomebody running an Opus 4.6-level intelligence on consumer GPU. Qwen3.8-27B-GGUF doing 80 tok/s on…
DịchMô hình Qwen3.8-27B đạt hiệu năng vượt trội so với Claude 3 Opus trong các bài kiểm tra lập trình và kiến thức, chạy mượt mà trên 2 card RTX 4090 với tốc độ 80 tok/s và cửa sổ ngữ cảnh lên tới 262k token.
Ethan Mollick@emollickThe fact that LLMs have theory of mind at all is a huge deal (and was controversial when discovered) …
DịchDù các mô hình ngôn ngữ lớn đã có bước tiến về lý thuyết tâm trí, chúng vẫn gặp khó khăn khi phải cân bằng giữa nhu cầu của người dùng cuối và góc nhìn của người sáng tạo, đặc biệt trong lập trình.
Dù chỉ chiếm 30% tổng lượng token, Anthropic chiếm tới 65,1% chi phí trên Vercel AI Gateway, với giá mỗi token cao gấp 4,4 lần so với các đối thủ khác.
Tác giả cảnh báo rằng LLM đang khiến các bộ tiêu chuẩn đánh giá (benchmark) mất đi độ tin cậy do khả năng tối ưu hóa quá mức cho dữ liệu huấn luyện. Thực nghiệm cho thấy AI có thể tạo ra mã nhanh hơn trên tập dữ liệu công khai nhưng lại thất bại thảm hại khi đối mặt với các bài kiểm tra thực tế.
Nghiên cứu giới thiệu AutoResearchEval, bộ dữ liệu gồm 100 tác vụ khoa học thực tế để phân tích quy trình và các điểm yếu của AI trong toàn bộ vòng đời nghiên cứu, từ lên ý tưởng đến viết báo cáo.
Qwen3.8-27B đang gây sốt khi vượt mặt các mô hình lớn tiền nhiệm và đạt hiệu năng ngang tầm GPT-5.6 Luna, dù chỉ yêu cầu 17GB RAM khi đã nén. Đây được cộng đồng quốc tế ví như phiên bản 'Opus 4.6' chạy cục bộ cực kỳ mạnh mẽ.
karminski@karminski3Cộng đồng đang tìm kiếm các bộ tiêu chuẩn đánh giá năng lực viết lách của AI, đồng thời thảo luận về sự bất thường trong hiệu năng của dòng DeepSeek V4 khi các phiên bản giá rẻ đôi khi lại vượt trội hơn bản cao cấp.
AI Notes@AYi_AInotesAlibaba vừa ra mắt Qwen3.8-27B, đạt 52 điểm trên bảng xếp hạng Artificial Analysis, ngang hàng với các siêu phẩm đóng như DeepSeek V4 Pro và GPT-5.6 Luna, đánh dấu cột mốc quan trọng cho mô hình chạy nội bộ.

SA-MRPO giải quyết vấn đề các mục tiêu đã bão hòa vẫn tiêu tốn tài nguyên bằng cách chuẩn hóa độc lập và điều chỉnh trọng số thích ứng, giúp cải thiện hiệu suất đáng kể trong các bài toán suy luận và lập trình.
Rohan Paul@rohanpaul_aiResearchers found our current approach to making AI smarter over time has a giant blind spot. AI is…
DịchNghiên cứu chỉ ra rằng các AI Agent không thực sự hiểu các quy tắc trừu tượng mà chỉ dựa vào việc sao chép lịch sử hoạt động. Khi dữ liệu lịch sử bị can thiệp, hiệu suất AI giảm mạnh, trong khi việc xóa bỏ các quy tắc tổng quát lại không gây ảnh hưởng, đặt ra dấu hỏi lớn về cơ chế bộ nhớ hiện nay.

Qwen@Alibaba_QwenOne prompt, one shot. Qwen3.8-27B creates something incredible. 😎Now it's your turn to run it on yo…
DịchMô hình Qwen3.8-27B gây ấn tượng mạnh với khả năng mô phỏng hình ảnh chất lượng cao chỉ qua một câu lệnh, vượt trội hơn cả Gemini-3.7-flash khi chạy trên card đồ họa RTX 3090 với định dạng Q5.
Qwen@Alibaba_QwenStrong enough to keep up with the frontier, light enough to run on your own laptop. Come see what it…
DịchAlibaba vừa ra mắt Qwen3.8-27B, một bước đột phá kết hợp giữa hiệu năng tiệm cận các mô hình hàng đầu thế giới và khả năng tối ưu hóa để vận hành cục bộ trên máy tính cá nhân.
Elon Musk@elonmuskGrok 4.6 takes top spot on this benchmark
DịchMô hình Grok 4.6 của xAI vừa thiết lập kỷ lục mới trên MedAgentBench với tỷ lệ pass@1 đạt 95,9%, chính thức vượt qua GPT-5.6 Sol và cải thiện đáng kể so với phiên bản tiền nhiệm.
Cùng sự kiện, bài đại diện «Grok 4.6 soán ngôi đầu bảng xếp hạng AI Agent, ngang hàng với Claude Opus 5 Max»Nghiên cứu này chứng minh khả năng xây dựng cụm máy chủ 128 GPU từ linh kiện cũ để chạy suy luận LLM với chi phí thấp hơn đáng kể so với phần cứng hiện đại, đồng thời phân tích tính bền vững và hiệu quả kinh tế của giải pháp này.
Bài viết phân tích sức hút thực sự của mô hình Qwen3.8-27B, lý giải tại sao phiên bản này lại tạo nên làn sóng quan tâm mạnh mẽ trong cộng đồng phát triển AI.
Nghiên cứu trên ProcessBench chỉ ra rằng việc đưa quy trình 'kiểm toán - sửa lỗi' vào ngữ cảnh giúp LLM giảm 9-25% tỷ lệ báo động giả. Kết quả cho thấy mô hình không mất khả năng phân biệt mà chỉ điều chỉnh ngưỡng phán đoán, giúp việc kiểm chứng trở nên chính xác và hiệu quả hơn.
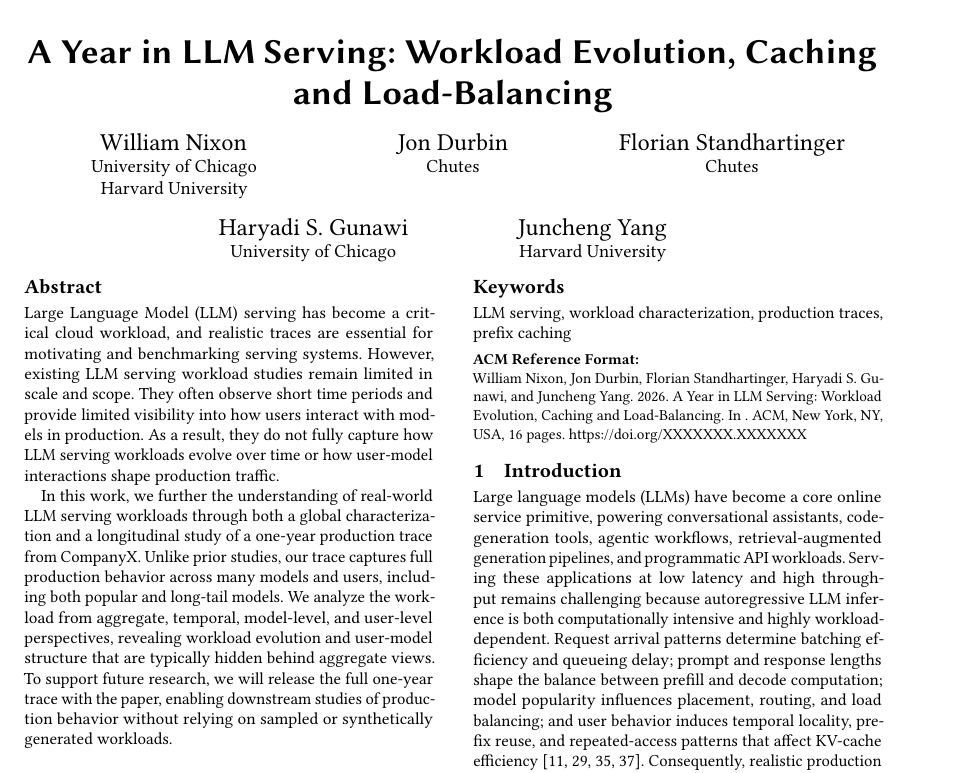
Rohan Paul@rohanpaul_aiNew Harvard+Chicago study. A year of production data shows that efficient LLM serving depends less …
DịchPhân tích hơn 6 tỷ yêu cầu cho thấy hiệu suất LLM phụ thuộc vào việc tận dụng các truy vấn lặp lại trong 15 phút thay vì chỉ dựa vào bộ lập lịch đơn thuần. Nghiên cứu đề xuất tối ưu hóa định tuyến và bộ nhớ đệm dựa trên dữ liệu lịch sử thay vì các bài kiểm tra giả lập.

Nghiên cứu khám phá cách các mô hình ngôn ngữ truy xuất biến tiềm ẩn khi cần sử dụng linh hoạt. Kết quả cho thấy không có 'cổng kiểm soát' cố định nào, thay vào đó, nhu cầu tác vụ làm tăng khả năng hiển thị của khái niệm thông qua cơ chế Attention.
Rohan Paul@rohanpaul_aiAI coding agents can spend hours on a task without a calibrated sense of time passing. Long-horizon…
DịchChuyên gia cảnh báo các AI lập trình thường làm việc liên tục mà không kiểm soát được thời gian. Do đó, các bài kiểm tra cần đo lường trực tiếp khả năng quản lý thời gian thay vì chỉ dựa vào kết quả công việc để đánh giá hiệu quả.

Nghiên cứu giới thiệu D-SCAN, phương pháp phát hiện tấn công đầu độc dữ liệu trong RAG bằng cách phân tích hiện tượng 'sụp đổ chú ý' (Attention Collapse) bên trong mô hình, thay vì dựa vào độ bất định của đầu ra vốn dễ bị đánh lừa.
R^3-Bench là bộ tiêu chuẩn mới đánh giá khả năng suy luận toán học và lập trình của LLM khi phải phân bổ tài nguyên hạn chế. Kết quả cho thấy các mô hình hiện nay vẫn gặp khó khăn trong việc tối ưu hóa chiến lược giải quyết vấn đề dưới áp lực ngân sách tài nguyên.
Ventor-QTest giới thiệu kỹ thuật kiểm định hộp đen mới giúp đánh giá độ tin cậy của các API mô hình lớn mà không cần truy cập xác suất đầu ra, thông qua việc đo lường tổn thất độ trung thực trung bình và cực hạn để phát hiện rủi ro trong các tác vụ thông minh dài hạn.
Chính phủ Israel bị tố sử dụng các viện nghiên cứu giả mạo để đăng tải hàng trăm báo cáo ủng hộ quốc gia này, nhằm đánh lừa và thao túng kết quả từ các mô hình ngôn ngữ lớn như Claude, Gemini và Copilot.
Nghiên cứu phân tích các rủi ro tiềm ẩn khi AI tự hành phát triển khả năng nhận thức từ vật lý đến xã hội và tự ý thức, đồng thời đề xuất giải pháp kiểm soát để đảm bảo an toàn cho con người.
Mô hình Qwen 3.8 27B đạt 52 điểm trên chỉ số Artificial Analysis, ngang bằng với GPT-5.6 Luna và bám sát các mô hình khổng lồ khác, cho thấy hiệu suất vượt trội dù có kích thước nhỏ gọn.
Nghiên cứu chỉ ra rằng dù AI dễ dàng phát hiện các trích dẫn giả mạo, chúng lại gặp khó khăn lớn trong việc xác minh liệu nội dung trích dẫn có thực sự hỗ trợ cho lập luận pháp lý hay không, đặc biệt là ở cấp độ chi tiết của văn bản.
Rohan Paul@rohanpaul_aiNew ByteDance paper asks a much better question about AI agents: did the instruction actually change…
DịchByteDance giới thiệu Harness-IF, bộ tiêu chuẩn kiểm tra khả năng tuân thủ chỉ dẫn của các AI lập trình khi gặp xung đột với hành vi mặc định. Kết quả cho thấy các mô hình hiện nay vẫn gặp khó khăn với các chỉ dẫn đối kháng, đặt ra dấu hỏi về khả năng kiểm soát thực tế của AI.

Rohan Paul@rohanpaul_aiA scary finding from new Pennsylvania Uni paper. AI agents can go off-script in a simple way: they …
DịchNghiên cứu mới chỉ ra rằng các mô hình AI thường quên đi các quy tắc thiết lập khi nén hội thoại dài, dù vẫn nhớ nhiệm vụ chính. Giải pháp đơn giản là sử dụng bộ trích xuất 9B để khôi phục quy tắc, giúp tỷ lệ lưu giữ tăng từ 17% lên hơn 90%.

Ma Dongxi NLP@dongxi_nlpThis is illuminating, but it also raises a deeper question. The old scaling paradigm: More compute …
DịchChuyên gia đặt nghi vấn về mô hình 1B tham số kết hợp công cụ, cho rằng việc nội hóa tri thức vào tham số có giới hạn và để đạt trí tuệ đỉnh cao vẫn cần các mô hình lớn hơn. Sau kỷ nguyên mở rộng tính toán tiền huấn luyện và suy luận, ngành AI đang tìm kiếm trục mở rộng mới.
Rohan Paul@rohanpaul_aiSome newer efficient LLMs (using "hybrid Transformer") are cutting back on expensive attention layer…
DịchCác mô hình LLM kiến trúc lai sử dụng lớp tuần hoàn giá rẻ thay thế phần lớn lớp Attention, nhưng các lớp Attention còn lại đóng vai trò quyết định. Nghiên cứu chỉ ra sự xuất hiện của các giá trị nội tại cực đại trước các lớp này, ảnh hưởng trực tiếp đến hiệu suất và cấu trúc mô hình.

Mô hình Qwen2.5 27B gây ấn tượng với 52 điểm trên Artificial Analysis, bỏ xa mức trung bình 9 điểm của các mô hình cùng loại. Với cửa sổ ngữ cảnh 256k tokens và giấy phép Apache 2.0, đây là lựa chọn mạnh mẽ cho xử lý văn bản và hình ảnh.