18/08

Thứ Ba · 40 tin
Rohan Paul@rohanpaul_ai
Sản phẩmĐiểm AI 34/100

Questflow ra mắt Financial Harness: Hệ sinh thái AI chuyên biệt cho giao dịch tài chính

Finance gives AI agents an unusually unforgiving outcome signal: PnL. And the harder part of an AI …

DịchQuestflow giới thiệu nền tảng AI 4 lớp cho phép người dùng tùy chọn giữa 11 mô hình ngôn ngữ lớn để tự động hóa chiến lược đầu tư, giúp nhà đầu tư cá nhân tiếp cận các phương pháp giao dịch chuyên nghiệp.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 42/100

Qwen3.8-27B: Sức mạnh ngang tầm Opus trên GPU tiêu dùng

Somebody running an Opus 4.6-level intelligence on consumer GPU. Qwen3.8-27B-GGUF doing 80 tok/s on…

DịchMô hình Qwen3.8-27B đạt hiệu năng vượt trội so với Claude 3 Opus trong các bài kiểm tra lập trình và kiến thức, chạy mượt mà trên 2 card RTX 4090 với tốc độ 80 tok/s và cửa sổ ngữ cảnh lên tới 262k token.

Thêm 1 nguồn khác đưa tinPandaily
Ethan Mollick@emollick
Hướng dẫnĐiểm AI 39/100

Hạn chế của AI trong việc thấu hiểu tâm lý: Khó phân biệt giữa người dùng và lập trình viên

The fact that LLMs have theory of mind at all is a huge deal (and was controversial when discovered) …

DịchDù các mô hình ngôn ngữ lớn đã có bước tiến về lý thuyết tâm trí, chúng vẫn gặp khó khăn khi phải cân bằng giữa nhu cầu của người dùng cuối và góc nhìn của người sáng tạo, đặc biệt trong lập trình.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 65/100

Ngày tàn của các bài kiểm tra năng lực AI: Khi LLM dễ dàng 'gian lận' điểm số

Tác giả cảnh báo rằng LLM đang khiến các bộ tiêu chuẩn đánh giá (benchmark) mất đi độ tin cậy do khả năng tối ưu hóa quá mức cho dữ liệu huấn luyện. Thực nghiệm cho thấy AI có thể tạo ra mã nhanh hơn trên tập dữ liệu công khai nhưng lại thất bại thảm hại khi đối mặt với các bài kiểm tra thực tế.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnTại sao các AI tự động nghiên cứu khoa học lại thất bại? Đánh giá toàn diện trên 100 tác vụ thực tế

Nghiên cứu giới thiệu AutoResearchEval, bộ dữ liệu gồm 100 tác vụ khoa học thực tế để phân tích quy trình và các điểm yếu của AI trong toàn bộ vòng đời nghiên cứu, từ lên ý tưởng đến viết báo cáo.


Vì sao đáng đọc: Nghiên cứu thực nghiệm quan trọng, giải quyết lỗ hổng trong việc đánh giá khả năng thực thi của AI agent trong các tác vụ khoa học phức tạp và thực tế.
Pandaily
Mô hìnhĐiểm AI 95/100

Tinh chọnAlibaba ra mắt Qwen3.8-27B: Mô hình mã nguồn mở mạnh ngang ngửa GPT-5.6, chạy mượt trên 17GB RAM

Qwen3.8-27B đang gây sốt khi vượt mặt các mô hình lớn tiền nhiệm và đạt hiệu năng ngang tầm GPT-5.6 Luna, dù chỉ yêu cầu 17GB RAM khi đã nén. Đây được cộng đồng quốc tế ví như phiên bản 'Opus 4.6' chạy cục bộ cực kỳ mạnh mẽ.


Vì sao đáng đọc: Tin tức quan trọng về bước tiến đột phá của mô hình mã nguồn mở, có tác động lớn đến cộng đồng lập trình viên và người dùng chạy AI cục bộ.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

SA-MRPO: Phương pháp tối ưu hóa đa mục tiêu trong học tăng cường giúp tránh lãng phí tài nguyên tính toán

SA-MRPO giải quyết vấn đề các mục tiêu đã bão hòa vẫn tiêu tốn tài nguyên bằng cách chuẩn hóa độc lập và điều chỉnh trọng số thích ứng, giúp cải thiện hiệu suất đáng kể trong các bài toán suy luận và lập trình.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 46/100

Nghiên cứu mới: AI Agent thực chất chỉ đang 'bắt chước' thay vì học hỏi từ kinh nghiệm

Researchers found our current approach to making AI smarter over time has a giant blind spot. AI is…

DịchNghiên cứu chỉ ra rằng các AI Agent không thực sự hiểu các quy tắc trừu tượng mà chỉ dựa vào việc sao chép lịch sử hoạt động. Khi dữ liệu lịch sử bị can thiệp, hiệu suất AI giảm mạnh, trong khi việc xóa bỏ các quy tắc tổng quát lại không gây ảnh hưởng, đặt ra dấu hỏi lớn về cơ chế bộ nhớ hiện nay.

Qwen@Alibaba_Qwen
Hướng dẫnĐiểm AI 26/100

Qwen3.8-27B: Hiệu năng ấn tượng khi chạy cục bộ trên laptop

One prompt, one shot. Qwen3.8-27B creates something incredible. 😎Now it's your turn to run it on yo…

DịchMô hình Qwen3.8-27B gây ấn tượng mạnh với khả năng mô phỏng hình ảnh chất lượng cao chỉ qua một câu lệnh, vượt trội hơn cả Gemini-3.7-flash khi chạy trên card đồ họa RTX 3090 với định dạng Q5.

Qwen@Alibaba_Qwen
Mô hìnhĐiểm AI 49/100

Qwen3.8-27B: Mô hình AI mạnh ngang GPT-5.6, chạy mượt ngay trên laptop cá nhân

Strong enough to keep up with the frontier, light enough to run on your own laptop. Come see what it…

DịchAlibaba vừa ra mắt Qwen3.8-27B, một bước đột phá kết hợp giữa hiệu năng tiệm cận các mô hình hàng đầu thế giới và khả năng tối ưu hóa để vận hành cục bộ trên máy tính cá nhân.

Elon Musk@elonmusk
Hướng dẫnĐiểm AI 40/100

Cùng sự kiệnGrok 4.6 soán ngôi đầu bảng MedAgentBench, vượt mặt GPT-5.6 Sol trong tác vụ y tế

Grok 4.6 takes top spot on this benchmark

DịchMô hình Grok 4.6 của xAI vừa thiết lập kỷ lục mới trên MedAgentBench với tỷ lệ pass@1 đạt 95,9%, chính thức vượt qua GPT-5.6 Sol và cải thiện đáng kể so với phiên bản tiền nhiệm.

Cùng sự kiện, bài đại diện «Grok 4.6 soán ngôi đầu bảng xếp hạng AI Agent, ngang hàng với Claude Opus 5 Max»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnDumpsterCluster: Tận dụng GPU cũ giá rẻ để chạy mô hình LLaMA-70B

Nghiên cứu này chứng minh khả năng xây dựng cụm máy chủ 128 GPU từ linh kiện cũ để chạy suy luận LLM với chi phí thấp hơn đáng kể so với phần cứng hiện đại, đồng thời phân tích tính bền vững và hiệu quả kinh tế của giải pháp này.


Vì sao đáng đọc: Chủ đề cực kỳ thực tế và thú vị về việc tái chế phần cứng cũ để tối ưu chi phí hạ tầng AI, một vấn đề đang được cộng đồng công nghệ quan tâm sâu sắc.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 55/100

Nghiên cứu mới: Quy trình 'Kiểm toán - Sửa lỗi' giúp giảm tỷ lệ báo động giả cho LLM

Nghiên cứu trên ProcessBench chỉ ra rằng việc đưa quy trình 'kiểm toán - sửa lỗi' vào ngữ cảnh giúp LLM giảm 9-25% tỷ lệ báo động giả. Kết quả cho thấy mô hình không mất khả năng phân biệt mà chỉ điều chỉnh ngưỡng phán đoán, giúp việc kiểm chứng trở nên chính xác và hiệu quả hơn.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

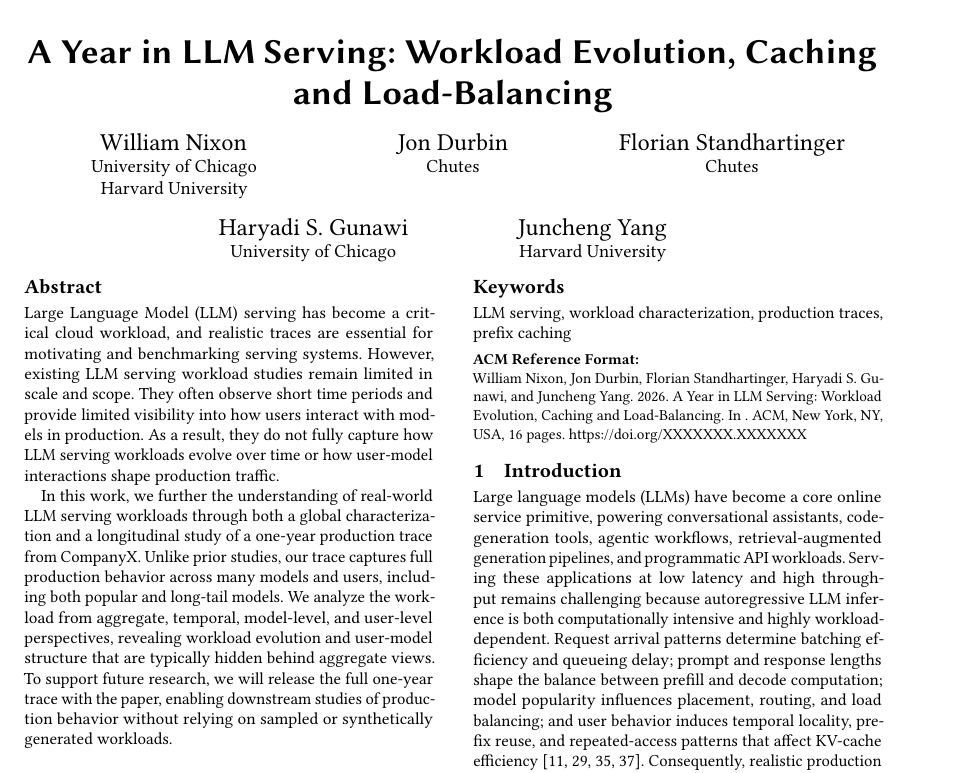
Nghiên cứu từ Harvard & Chicago: Phân tích tải thực tế của dịch vụ LLM trong một năm

New Harvard+Chicago study. A year of production data shows that efficient LLM serving depends less …

DịchPhân tích hơn 6 tỷ yêu cầu cho thấy hiệu suất LLM phụ thuộc vào việc tận dụng các truy vấn lặp lại trong 15 phút thay vì chỉ dựa vào bộ lập lịch đơn thuần. Nghiên cứu đề xuất tối ưu hóa định tuyến và bộ nhớ đệm dựa trên dữ liệu lịch sử thay vì các bài kiểm tra giả lập.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Cơ chế Attention và cách mô hình ngôn ngữ chuyển hóa biến tiềm ẩn thành ngôn ngữ

Nghiên cứu khám phá cách các mô hình ngôn ngữ truy xuất biến tiềm ẩn khi cần sử dụng linh hoạt. Kết quả cho thấy không có 'cổng kiểm soát' cố định nào, thay vào đó, nhu cầu tác vụ làm tăng khả năng hiển thị của khái niệm thông qua cơ chế Attention.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 40/100

AI lập trình thiếu cảm nhận thời gian: Cần thay đổi cách đánh giá hiệu suất

AI coding agents can spend hours on a task without a calibrated sense of time passing. Long-horizon…

DịchChuyên gia cảnh báo các AI lập trình thường làm việc liên tục mà không kiểm soát được thời gian. Do đó, các bài kiểm tra cần đo lường trực tiếp khả năng quản lý thời gian thay vì chỉ dựa vào kết quả công việc để đánh giá hiệu quả.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Khi ngữ cảnh phản chủ: Phát hiện tấn công đầu độc RAG qua hiện tượng sụp đổ chú ý

Nghiên cứu giới thiệu D-SCAN, phương pháp phát hiện tấn công đầu độc dữ liệu trong RAG bằng cách phân tích hiện tượng 'sụp đổ chú ý' (Attention Collapse) bên trong mô hình, thay vì dựa vào độ bất định của đầu ra vốn dễ bị đánh lừa.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 49/100

R^3-Bench: Thử thách khả năng suy luận của LLM trong môi trường giới hạn tài nguyên

R^3-Bench là bộ tiêu chuẩn mới đánh giá khả năng suy luận toán học và lập trình của LLM khi phải phân bổ tài nguyên hạn chế. Kết quả cho thấy các mô hình hiện nay vẫn gặp khó khăn trong việc tối ưu hóa chiến lược giải quyết vấn đề dưới áp lực ngân sách tài nguyên.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 54/100

Ventor-QTest: Phương pháp kiểm định bảo mật cho API mô hình ngôn ngữ lớn dựa trên mô hình đe dọa

Ventor-QTest giới thiệu kỹ thuật kiểm định hộp đen mới giúp đánh giá độ tin cậy của các API mô hình lớn mà không cần truy cập xác suất đầu ra, thông qua việc đo lường tổn thất độ trung thực trung bình và cực hạn để phát hiện rủi ro trong các tác vụ thông minh dài hạn.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnGiải mã rủi ro từ khả năng nhận thức của các hệ thống AI tự hành

Nghiên cứu phân tích các rủi ro tiềm ẩn khi AI tự hành phát triển khả năng nhận thức từ vật lý đến xã hội và tự ý thức, đồng thời đề xuất giải pháp kiểm soát để đảm bảo an toàn cho con người.


Vì sao đáng đọc: Chủ đề mang tính thời đại và cấp thiết về an toàn AI, cung cấp khung phân tích hệ thống cho một vấn đề phức tạp mà cộng đồng AI đang đặc biệt quan tâm.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

Harness-IF: ByteDance ra mắt chuẩn đánh giá khả năng tuân thủ chỉ dẫn của AI lập trình

New ByteDance paper asks a much better question about AI agents: did the instruction actually change…

DịchByteDance giới thiệu Harness-IF, bộ tiêu chuẩn kiểm tra khả năng tuân thủ chỉ dẫn của các AI lập trình khi gặp xung đột với hành vi mặc định. Kết quả cho thấy các mô hình hiện nay vẫn gặp khó khăn với các chỉ dẫn đối kháng, đặt ra dấu hỏi về khả năng kiểm soát thực tế của AI.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 47/100

Nghiên cứu từ UPenn: AI thường 'quên' quy tắc người dùng khi nén dữ liệu hội thoại dài

A scary finding from new Pennsylvania Uni paper. AI agents can go off-script in a simple way: they …

DịchNghiên cứu mới chỉ ra rằng các mô hình AI thường quên đi các quy tắc thiết lập khi nén hội thoại dài, dù vẫn nhớ nhiệm vụ chính. Giải pháp đơn giản là sử dụng bộ trích xuất 9B để khôi phục quy tắc, giúp tỷ lệ lưu giữ tăng từ 17% lên hơn 90%.

Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 41/100

Mô hình nhỏ kết hợp công cụ đã chạm trần: Đâu là hướng phát triển tiếp theo?

This is illuminating, but it also raises a deeper question. The old scaling paradigm: More compute …

DịchChuyên gia đặt nghi vấn về mô hình 1B tham số kết hợp công cụ, cho rằng việc nội hóa tri thức vào tham số có giới hạn và để đạt trí tuệ đỉnh cao vẫn cần các mô hình lớn hơn. Sau kỷ nguyên mở rộng tính toán tiền huấn luyện và suy luận, ngành AI đang tìm kiếm trục mở rộng mới.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 27/100

Hiện tượng kích hoạt cực đại trong LLM lai: Điểm nóng trước lớp Attention và sự ổn định giữa các tầng

Some newer efficient LLMs (using "hybrid Transformer") are cutting back on expensive attention layer…

DịchCác mô hình LLM kiến trúc lai sử dụng lớp tuần hoàn giá rẻ thay thế phần lớn lớp Attention, nhưng các lớp Attention còn lại đóng vai trò quyết định. Nghiên cứu chỉ ra sự xuất hiện của các giá trị nội tại cực đại trước các lớp này, ảnh hưởng trực tiếp đến hiệu suất và cấu trúc mô hình.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 58/100

Qwen2.5 27B đạt 52 điểm trên bảng xếp hạng Artificial Analysis, vượt xa các đối thủ cùng phân khúc

Mô hình Qwen2.5 27B gây ấn tượng với 52 điểm trên Artificial Analysis, bỏ xa mức trung bình 9 điểm của các mô hình cùng loại. Với cửa sổ ngữ cảnh 256k tokens và giấy phép Apache 2.0, đây là lựa chọn mạnh mẽ cho xử lý văn bản và hình ảnh.

Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 26/100

Xu hướng mới: Mô hình ngôn ngữ lớn (LLM) đang vượt mặt mô hình khuếch tán trong lập trình

It has been a bit surprising, to say the least, how powerful LLMs for code have turned out to be in …

DịchKhả năng lập trình vượt trội của LLM đang mở ra những tiềm năng mới, dự báo sẽ tiếp tục dẫn đầu và lấn lướt các mô hình khuếch tán trong tương lai gần.

Thariq@trq212
Hướng dẫnĐiểm AI 31/100

Mô hình ngôn ngữ lớn (LLM) có thể vượt trội hơn mô hình khuếch tán trong sáng tạo nghệ thuật

all of the recent proc gen art, video editing and 3d game demos recently have made me update towards…

DịchDựa trên các tiến bộ gần đây trong lập trình nghệ thuật và chỉnh sửa video, các mô hình LLM đang cho thấy tiềm năng sáng tạo vượt trội hơn so với các mô hình khuếch tán truyền thống.

Thêm 1 nguồn khác đưa tinX: Elvis Saravia (@omarsar0, DAIR.AI)

17/08

Thứ Hai · 21 tin
TechCrunch: AI
NgànhĐiểm AI 54/100

Cùng sự kiệnAmazon bị tố thu mua và hủy hoại sách quý để huấn luyện AI

Amazon đang bị cáo buộc thu mua hàng loạt sách hiếm, cắt bỏ gáy để quét dữ liệu phục vụ huấn luyện AI. Dù hãng khẳng định đây là hoạt động thương mại hợp pháp, hành động này gây tranh cãi lớn về việc tiêu hủy tài liệu văn hóa quý giá để tránh rủi ro 'sụp đổ mô hình'.

Cùng sự kiện, tinh chọn hiển thị «404 Media bóc trần chiêu trò: Amazon mua gom sách quý để huấn luyện AI rồi tiêu hủy»
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 42/100

Nghiên cứu mới: Cơ chế thực sự đằng sau kỹ năng của AI Agent

Interesting paper demystifying agent skills. If you maintain skills for your agent, this one is wor…

DịchNghiên cứu chỉ ra rằng kỹ năng của AI Agent chủ yếu dựa vào việc thực thi quy trình (65,7%) thay vì bổ sung kiến thức (4,5%). Khi số lượng kỹ năng tăng lên, độ chính xác giảm mạnh, cho thấy giới hạn của việc mở rộng kho kỹ năng trong các tác vụ phức tạp.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnKhuếch đại không đồng nghĩa với dự đoán chính xác: Hành vi suy luận trong các mô hình tư duy

Nghiên cứu chỉ ra rằng các mô hình tư duy hiện nay thường khuếch đại các hành vi như tự sửa lỗi nhưng lại bỏ qua những yếu tố thực sự quyết định độ chính xác. Việc hiểu rõ khoảng cách giữa 'biểu hiện suy luận' và 'hiệu quả thực tế' là chìa khóa để tối ưu hóa các mô hình AI thế hệ mới.


Vì sao đáng đọc: Nghiên cứu quan trọng thách thức cách chúng ta đánh giá các mô hình tư duy (thinking models), cung cấp thước đo mới để phân biệt giữa hình thức và bản chất suy luận.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnKiến trúc nhận thức mô-đun: Sự tương đồng bất ngờ giữa AI và não bộ con người

Nghiên cứu chỉ ra rằng các mô hình ngôn ngữ lớn (LLM) tự phát triển cấu trúc mô-đun tương tự não người, nơi các tác vụ khác nhau kích hoạt các nhóm neuron chuyên biệt riêng biệt.


Vì sao đáng đọc: Nghiên cứu đột phá kết nối khoa học thần kinh và AI, cung cấp cái nhìn sâu sắc về cách các mô hình ngôn ngữ thực sự vận hành bên trong.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (49 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “LLM” — Trang 27 | AIHOT.vn