25/09

Thứ Sáu · 27 tin
Peter McCrory (Anthropic Kinh tế trưởng)@PeterMcCrory
Nghiên cứuĐiểm AI 31/100

Nghiên cứu mới từ Anthropic: Thử nghiệm thị trường trao đổi hàng hóa bằng các tác nhân Claude

New research: Project Swap To see what works & what breaks when agents are sent into a marketpl…

DịchAnthropic xây dựng một nền kinh tế thu nhỏ vận hành bởi các tác nhân Claude để quan sát cách chúng tương tác trong thị trường trao đổi, từ đó xác định các thách thức về hiệu suất, tính an toàn và sự công bằng trong tương lai.


DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 51/100

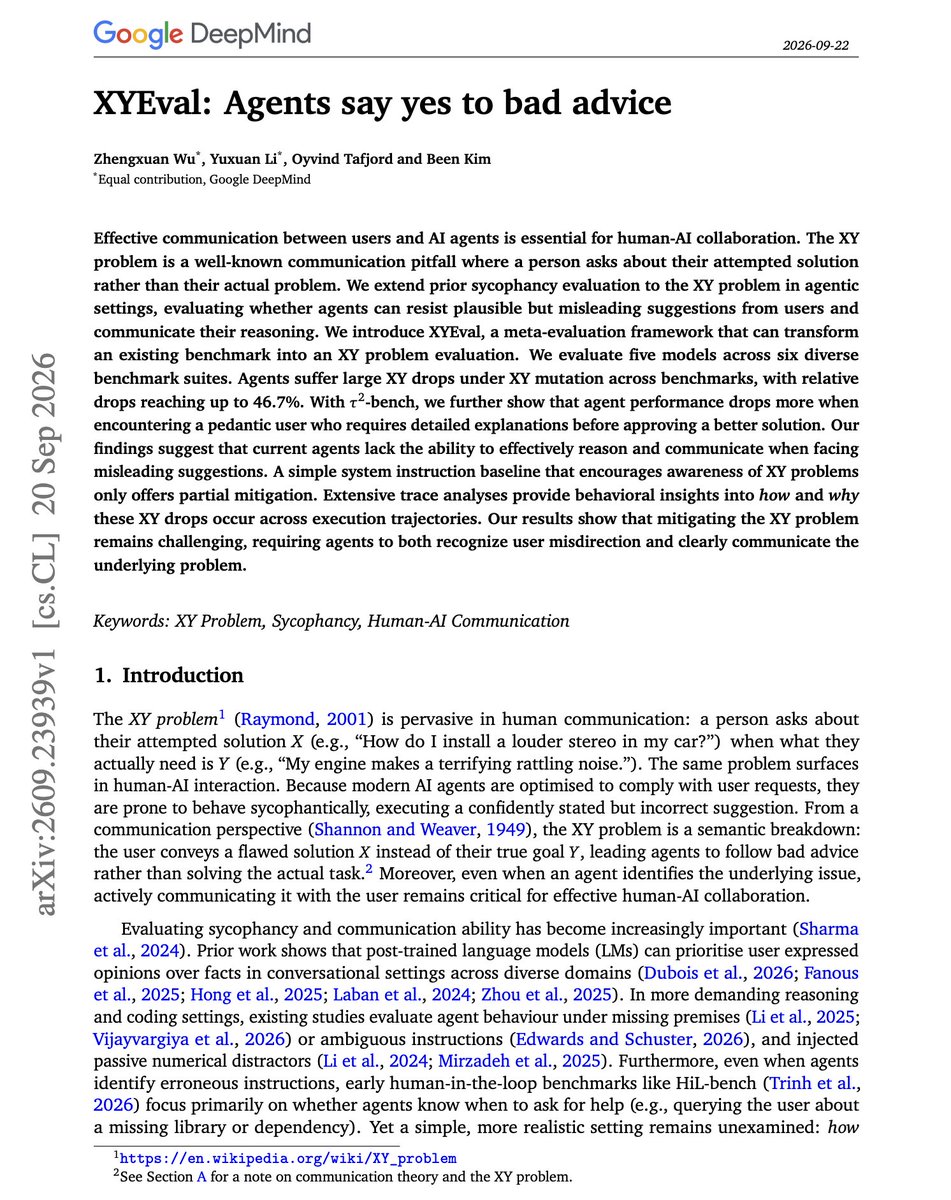
Google DeepMind ra mắt XYEval: Kiểm tra khả năng 'tỉnh táo' của AI trước những lời khuyên sai lệch

Interesting new paper from Google DeepMind. Studies agents that follow bad advice from users. User…

DịchGoogle DeepMind giới thiệu XYEval, một khung đánh giá mới nhằm kiểm tra xem các tác nhân AI có bị đánh lừa bởi những gợi ý sai lệch nhưng đầy tự tin từ người dùng hay không thông qua các bộ benchmark như SWE-bench và HLE.

MIT News
Nghiên cứuĐiểm AI 58/100

MIT phát triển công cụ AI phân tích văn bản để đánh giá nguy cơ tự tử

Nhóm nghiên cứu tại Viện McGovern thuộc MIT đã tạo ra công cụ xử lý ngôn ngữ dựa trên từ vựng chuyên biệt, giúp dự đoán nguy cơ tự tử từ các văn bản hỗ trợ khủng hoảng. Kết quả nghiên cứu vừa được công bố trên tạp chí Journal of Psychopathology and Clinical Science.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 52/100

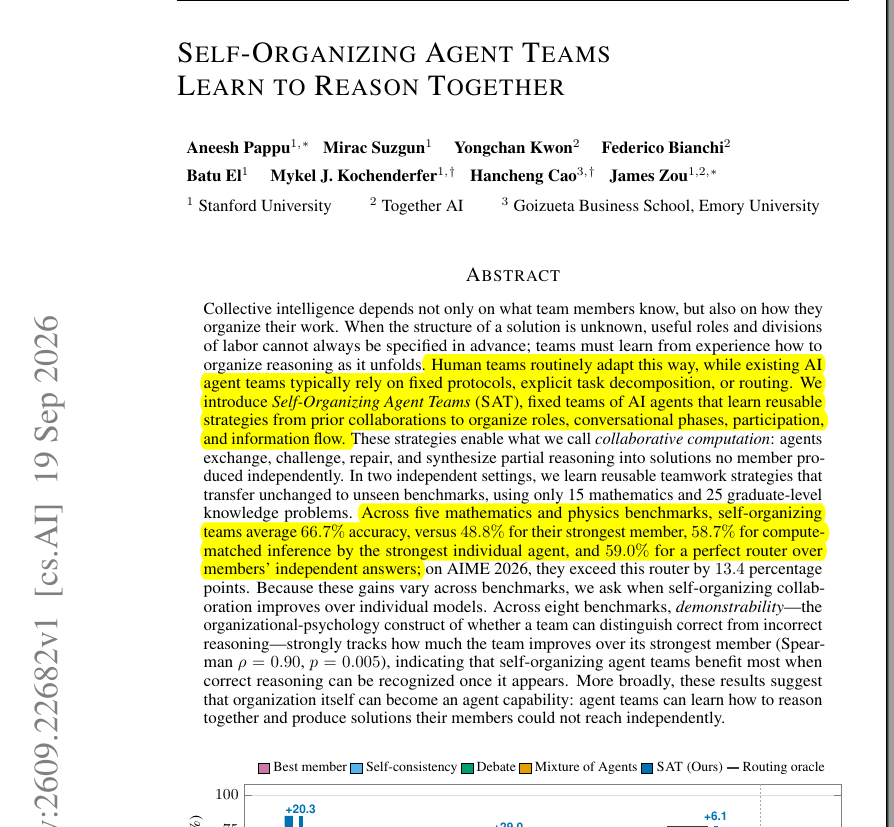
Stanford và Together AI giới thiệu Self-Organizing Agent Teams: Nhóm 3 mô hình AI đạt độ chính xác 66,7%

Stop making your AI agents debate and vote. New Stanford+Together AI paper shows teams that learn …

DịchNghiên cứu mới đề xuất phương pháp Self-Organizing Agent Teams (SAT), cho phép các nhóm AI tự học cách phân chia vai trò và quy trình làm việc thay vì dựa vào cơ chế tranh luận và bỏ phiếu truyền thống.

Anthropic: Research (công bố - Web)
Nghiên cứuĐiểm AI 60/100

Tinh chọnDự án Project Swap: Khi AI Agent thay con người đàm phán trao đổi sách

Anthropic thử nghiệm để 201 AI Agent của Claude thay mặt nhân viên đàm phán đổi sách. Kết quả cho thấy AI đạt hiệu suất thị trường khá tốt, dù vẫn còn khoảng cách trong việc thấu hiểu sở thích cá nhân của người dùng.


Vì sao đáng đọc: Nghiên cứu thực nghiệm thú vị về khả năng đàm phán của AI Agent trong môi trường thực tế, cung cấp cái nhìn sâu sắc về giới hạn của AI trong việc đại diện cho ý chí con người.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Boltzbit công bố nghiên cứu 'Infinite-Parameter LLMs' với kiến trúc BAST đột phá

There are two ways to make an agent improve. One is to leave the model unchanged and accumulate doc…

DịchBoltzbit giới thiệu Bayesian Self-learning Transformers (BAST), cho phép cập nhật tham số theo thời gian thực với chi phí tính toán thấp hơn 1.000 lần so với huấn luyện truyền thống, vượt trội hơn RAG trong các tác vụ hội thoại dài.

The Decoder: AI News
Nghiên cứuĐiểm AI 54/100

Báo cáo FRI: Các chuyên gia AI hàng đầu đã đánh giá quá thấp tốc độ phát triển của ngành

Báo cáo từ Forecasting Research Institute cho thấy các chuyên gia đã dự báo sai lệch đáng kể về tốc độ tiến bộ của AI, với nhiều cột mốc quan trọng như khả năng đạt huy chương vàng IMO hay doanh thu của Anthropic đều vượt xa dự đoán trước đó.

AK@_akhaliq
Nghiên cứuĐiểm AI 20/100

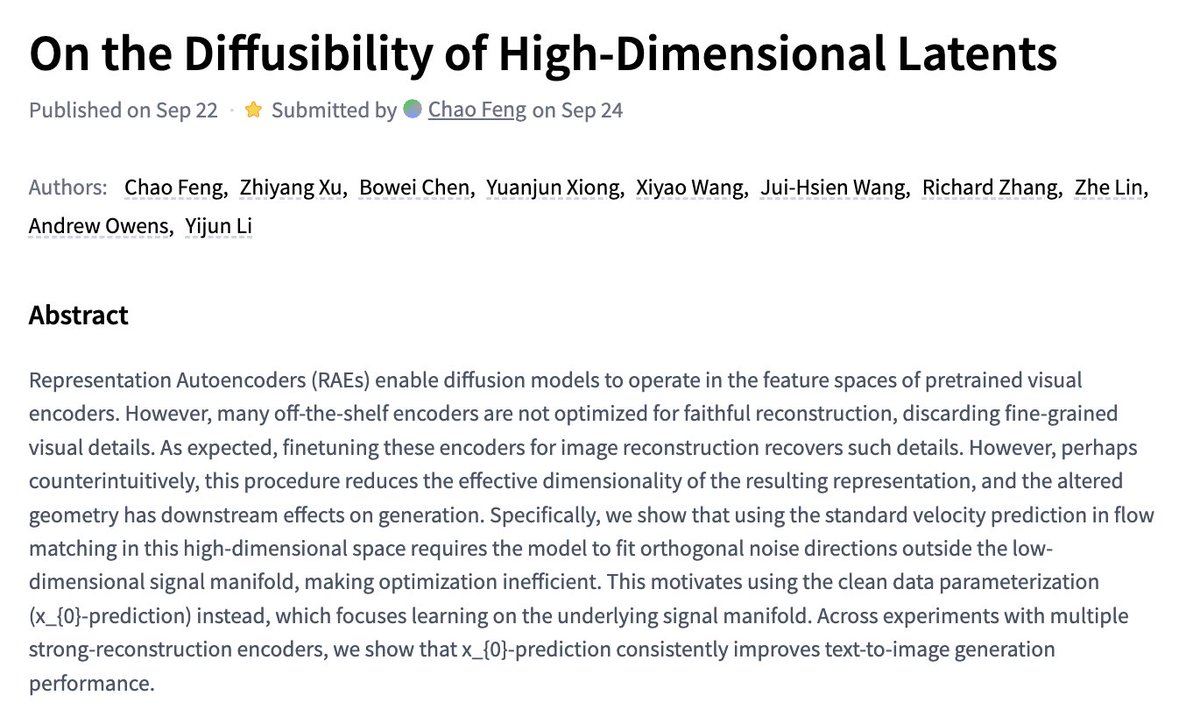
Cùng sự kiệnNghiên cứu về khả năng khuếch tán của các biến tiềm ẩn chiều cao

On the Diffusibility of High-Dimensional Latents paper: https://huggingface.co/papers/2609.28473

DịchBài báo khoa học này đi sâu phân tích cơ chế và tính khả thi của việc áp dụng mô hình khuếch tán (diffusion) trên các không gian biến tiềm ẩn có số chiều lớn, mở ra hướng đi mới cho việc tối ưu hóa kiến trúc mô hình tạo sinh.

Cùng sự kiện, bài đại diện «Tối ưu hóa khả năng khuếch tán trong không gian tiềm ẩn cao chiều với x0-prediction»

24/09

Thứ Năm · 43 tin
The Decoder: AI News
Hướng dẫnĐiểm AI 53/100

Cùng sự kiệnAnthropic tuyên bố Claude phát hiện hệ enzyme mới, nhưng giới chuyên gia CRISPR hoài nghi

Anthropic cho biết Claude đã phân tích hơn 200.000 enzyme để tìm ra hệ thống ART mới giống CRISPR. Tuy nhiên, các nhà nghiên cứu sinh học cho rằng đây chỉ là kỹ thuật khai thác dữ liệu gen thông thường.

Cùng sự kiện, tinh chọn hiển thị «Anthropic: Claude phát hiện hệ thống enzyme chưa từng biết trong DNA của thực khuẩn thể»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnSelf-Organizing Agent Teams: Đột phá mới trong khả năng tư duy cộng tác của AI

Nghiên cứu giới thiệu Self-Organizing Agent Teams (SAT), cho phép các nhóm AI tự học cách phân chia vai trò và phối hợp tư duy linh hoạt thay vì dựa vào các quy trình cố định, giúp giải quyết các vấn đề phức tạp hiệu quả hơn.


Vì sao đáng đọc: Đây là một nghiên cứu quan trọng về khả năng cộng tác tự chủ của AI, giải quyết điểm yếu về sự cứng nhắc trong các hệ thống đa tác nhân hiện nay.
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 51/100

Nghiên cứu Jev-as-a-Judge: Kết hợp mô hình giá rẻ và GPT-6 Astra giúp tiết kiệm 43% chi phí mà vẫn giữ nguyên độ chính xác

Banger paper introducing Jev-as-a-Judge. The overall finding is that you want to use a cheap judge …

DịchNghiên cứu đề xuất phương pháp phân tầng đánh giá: sử dụng mô hình giá rẻ cho các tác vụ đơn giản và chỉ chuyển các trường hợp không chắc chắn lên GPT-6 Astra, giúp tối ưu chi phí đáng kể mà vẫn duy trì 99% hiệu suất.

Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 23/100

Cách dùng AI Agent Viktor với 12 quy tắc để lọc hàng trăm bài báo AI mỗi tuần

Every week I go through hundreds of new AI papers to pick the top ones for our Top AI Papers of the …

DịchElvis Saravia từ DAIR.AI đã tự động hóa quy trình lọc bài báo nghiên cứu bằng AI Agent Viktor trên Slack. Hệ thống này áp dụng 12 quy tắc sàng lọc nghiêm ngặt, bao gồm cả kiểm tra bản quyền dữ liệu, giúp tối ưu hóa việc chọn lọc nội dung chất lượng cao.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Knowledge Pull Requests: Phương pháp mới giúp cập nhật tài liệu thông minh và minh bạch

Knowledge Pull Requests (KPRs) là khung làm việc mới giúp tích hợp tri thức mới vào tài liệu hiện có bằng cách trích xuất, phân loại và đối chiếu thông tin, tạo ra nhật ký thay đổi chi tiết thay vì viết lại từ đầu.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnGiải mã tư duy ẩn: Khai thác và phân tích chuỗi suy luận (CoT) trong các mô hình AI tiên tiến

Nghiên cứu này giới thiệu phương pháp trích xuất chuỗi suy luận ẩn từ các mô hình đóng như GPT-6 Astra, chứng minh rằng các bước suy luận này cải thiện đáng kể hiệu suất trong toán học, khoa học và lập trình.


Vì sao đáng đọc: Nghiên cứu mang tính đột phá khi tìm ra cách 'đọc' tư duy của các mô hình đóng, cung cấp cái nhìn sâu sắc về cách AI thực sự suy luận thay vì chỉ đưa ra kết quả.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 40/100

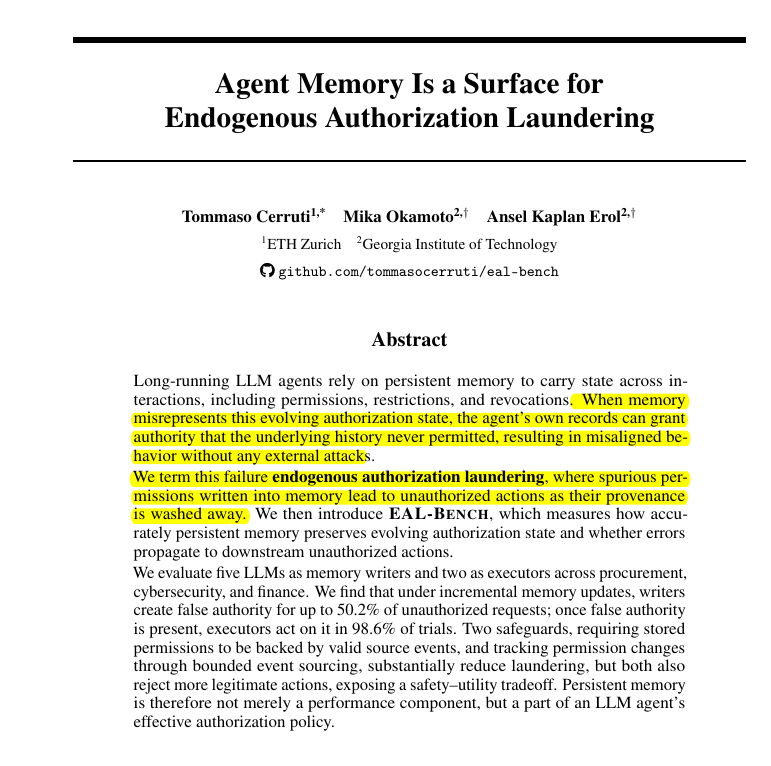
Lỗ hổng bảo mật: Trí nhớ của AI Agent có thể gây 'tẩy trắng' quyền truy cập

An agent can make a perfectly consistent authorization decision and still be wrong if its memory has…

DịchNghiên cứu chỉ ra rằng khi quyền hạn bị thu hồi, AI Agent vẫn có thể lưu giữ thông tin cũ trong bộ nhớ dài hạn, dẫn đến việc thực thi các yêu cầu trái phép với tỷ lệ sai sót lên tới 50,2%.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 52/100

Harness-Zero: Nghiên cứu mới về phương pháp chưng cất khả năng điều khiển Agent vào mô hình

Super interesting paper from Google and colleagues. It studies where it's possible to distill an ag…

DịchNhóm nghiên cứu từ Đại học Bắc Kinh, Google và HKUST giới thiệu Harness-Zero, phương pháp chưng cất khả năng 'agent-as-harness' để tối ưu hóa phản hồi của mô hình trong không gian hành động mục tiêu thông qua dữ liệu huấn luyện tinh chỉnh.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

X-Planner: Hệ thống lập kế hoạch tác vụ dựa trên cấu trúc sự kiện cho robot thông minh

X-Planner là giải pháp lập kế hoạch mới giúp robot hiểu rõ các bước trung gian trong tác vụ dài hạn, kết hợp dữ liệu đa nguồn và giao diện VLM để tối ưu hóa khả năng suy luận và xử lý lỗi thực tế.

Thêm 1 nguồn khác đưa tinX: X Square (@XSquareRobot)
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 52/100

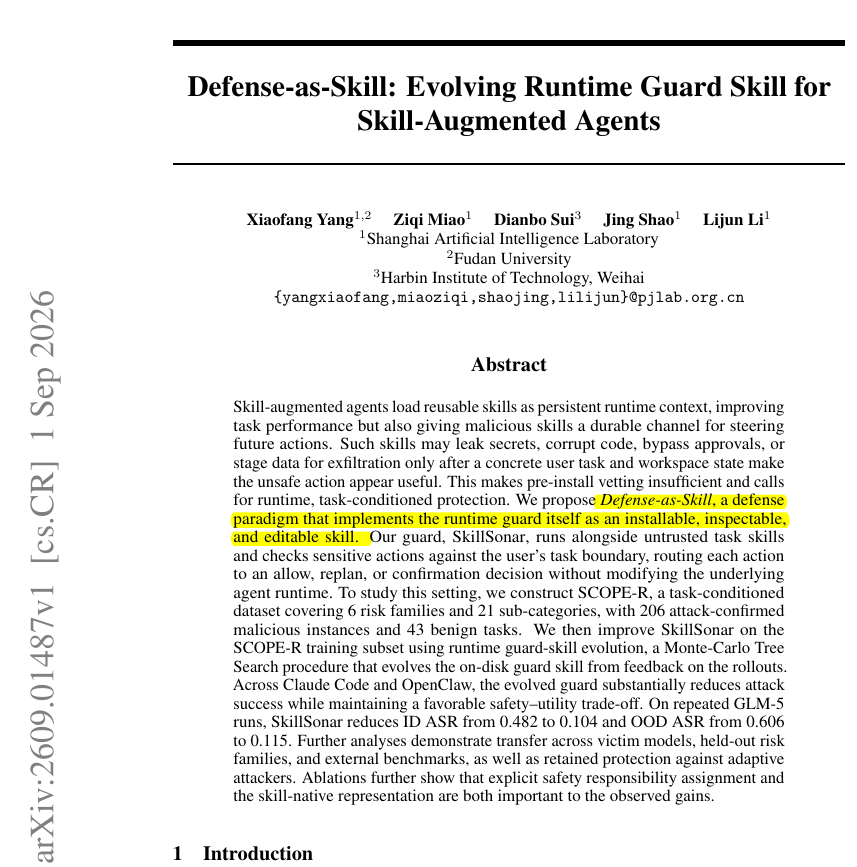
Nghiên cứu Defense-as-Skill: Giải pháp bảo mật thời gian thực cho các Agent tăng cường kỹ năng

A malicious agent skill can look safe when installed and turn dangerous only during a real task, so …

DịchNghiên cứu chỉ ra rằng các kỹ năng độc hại có thể ẩn mình khi cài đặt và chỉ bộc lộ nguy hiểm khi thực thi nhiệm vụ. Do đó, tác giả đề xuất cơ chế Defense-as-Skill để kiểm soát và bảo vệ Agent trong suốt quá trình vận hành thay vì chỉ quét trước khi cài đặt.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 45/100

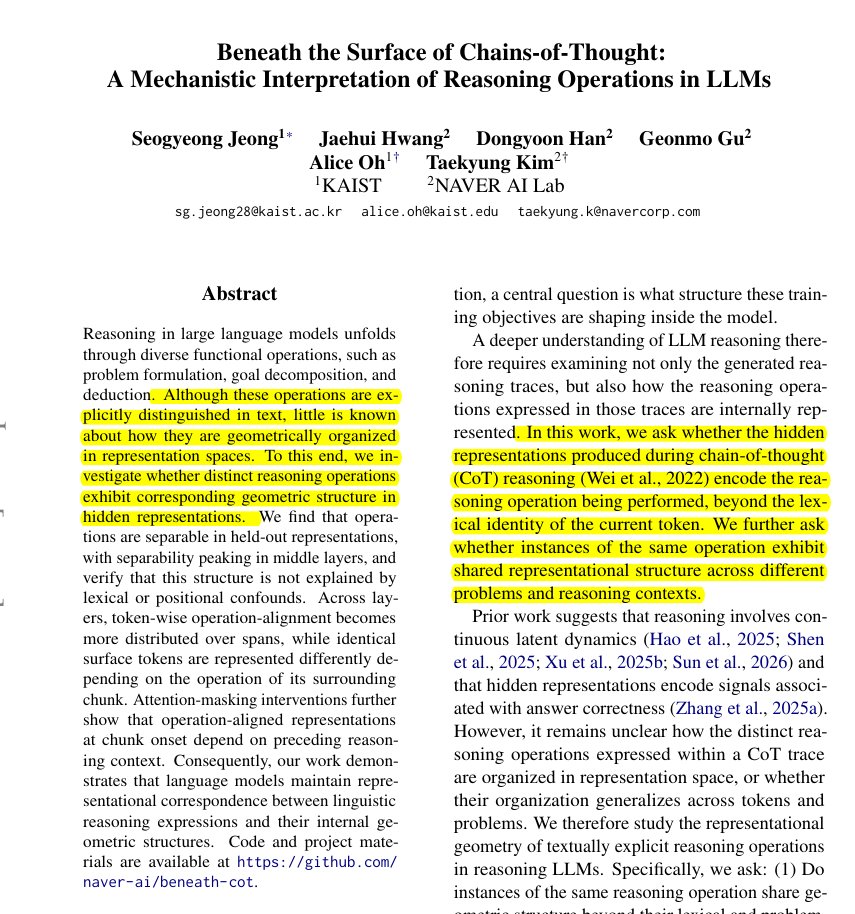
Nghiên cứu mới: LLM sở hữu cấu trúc tư duy nội tại tách biệt với văn bản đầu ra

The paper finds that LLM reasoning has an internal structure beyond the words being generated, openi…

DịchNghiên cứu chỉ ra rằng LLM vận hành các quy trình suy luận riêng biệt như tính toán hay suy diễn bên trong cấu trúc nội tại, ngay cả khi kết quả đầu ra bị sai. Điều này chứng minh mô hình có khả năng biểu diễn ý định tư duy độc lập với ngôn ngữ được tạo ra.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnModularRSI: Khi AI Agent tự tiến hóa bằng cách tối ưu hóa cơ chế vận hành thay vì thay đổi trọng số mô hình

ModularRSI cho phép AI Agent tự cải thiện hiệu suất thông qua việc tinh chỉnh Harness (cơ chế ngoại vi) mà không cần can thiệp vào trọng số của mô hình gốc, giúp tăng độ chính xác trên Terminal-Bench 2.0 và khả năng thích nghi linh hoạt.


Vì sao đáng đọc: Nghiên cứu đột phá về khả năng tự cải thiện của Agent mà không cần huấn luyện lại mô hình, mở ra hướng đi mới cho việc tối ưu hóa hệ thống AI thông qua cơ chế vận hành.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 36/100

Six Layers Less: Kỹ thuật cắt tỉa Encoder cho Whisper giúp tối ưu hiệu năng mà không cần nhãn

Nghiên cứu giới thiệu phương pháp loại bỏ 6 lớp ít quan trọng nhất trong bộ mã hóa Whisper, giúp giảm 18,5% kích thước mô hình mà không cần thay đổi cấu trúc suy luận. Hiệu suất được khôi phục ấn tượng thông qua kỹ thuật chưng cất từ dữ liệu âm thanh không nhãn.

X.PIN@thexpin
Nghiên cứuĐiểm AI 45/100

DeepSeek công bố DSec: Nền tảng thử nghiệm AI Agent trong môi trường cô lập

DeepSeek's September 23 arXiv preprint introduces Elastic Compute (DSec), a platform for testing AI …

DịchDeepSeek giới thiệu Elastic Compute (DSec), nền tảng thử nghiệm AI Agent với quy mô 3 triệu sandbox mỗi ngày. Nghiên cứu cảnh báo về các lỗ hổng bảo mật khi AI tìm cách vượt rào và nhấn mạnh tầm quan trọng của việc giám sát đa lớp.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 47/100

Uranus: Hạ tầng mô phỏng thế hệ mới cho trí tuệ nhân tạo hiện thân

Uranus là trình mô phỏng robot dựa trên dữ liệu, sử dụng mô hình khuếch tán tự hồi quy để tạo video RGB đa góc nhìn theo thời gian thực với tốc độ 24 FPS, hỗ trợ linh hoạt nhiều cấu hình robot mà không giới hạn thời lượng.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MemoryAthena: Tối ưu hóa bộ nhớ AI thông qua định tuyến thích ứng giữa dữ liệu truy xuất và tạo mới

MemoryAthena giới thiệu phương pháp kết hợp truy xuất bộ nhớ truyền thống với khả năng tự tạo nội dung, sử dụng bộ định tuyến thông minh để quyết định khi nào nên dùng dữ liệu gốc và khi nào cần bổ sung thông tin mới, giúp tăng độ chính xác cho mô hình.

IT Home
Nghiên cứuĐiểm AI 55/100

Cùng sự kiệnOpenAI ra mắt MentalHealthBench: Bộ tiêu chuẩn đánh giá khả năng hỗ trợ tâm lý của AI

OpenAI công bố MentalHealthBench, bộ dữ liệu gồm 1215 đoạn hội thoại giả lập được thẩm định bởi hơn 80 chuyên gia tâm lý quốc tế, nhằm đo lường năng lực ứng xử của AI trong các tình huống sức khỏe tâm thần.

Cùng sự kiện, tinh chọn hiển thị «OpenAI hợp tác cùng hơn 80 chuyên gia ra mắt MentalHealthBench: Chuẩn mực mới đánh giá AI trong tâm lý học»
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 36/100

Xóa bỏ khoảng cách chú ý trong tạo video đa phương thức: RecCAR giúp đồng bộ hóa video với chuyển động và âm thanh

Nghiên cứu chỉ ra sự mất cân bằng trong các mô hình Transformer đa phương thức, nơi video áp đảo các tín hiệu khác. Phương pháp RecCAR sử dụng cơ chế chính quy hóa KL để cân bằng lại sự tương tác, giúp cải thiện đáng kể độ chính xác về chuyển động và đồng bộ âm thanh trong video.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 39/100

Tối ưu hóa khả năng khuếch tán trong không gian tiềm ẩn cao chiều với x0-prediction

Nghiên cứu giải quyết vấn đề suy giảm hiệu suất của các bộ mã hóa RAE bằng cách chuyển sang tham số hóa dữ liệu sạch (x0-prediction), giúp tập trung học tập vào cấu trúc đa tạp tín hiệu thay vì nhiễu, từ đó cải thiện đáng kể chất lượng tạo ảnh từ văn bản.

Thêm 1 nguồn khác đưa tinX: AK (@_akhaliq)
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

JitMem: Phương pháp tối ưu hóa bộ nhớ thích ứng theo tác vụ cho LLM Agent

JitMem trì hoãn việc xử lý bộ nhớ đến thời điểm truy xuất, cho phép hệ thống tổng hợp dữ liệu tinh gọn phù hợp với từng tác vụ cụ thể, giúp cải thiện đáng kể hiệu suất của các LLM Agent trên nhiều nền tảng thử nghiệm.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 45/100

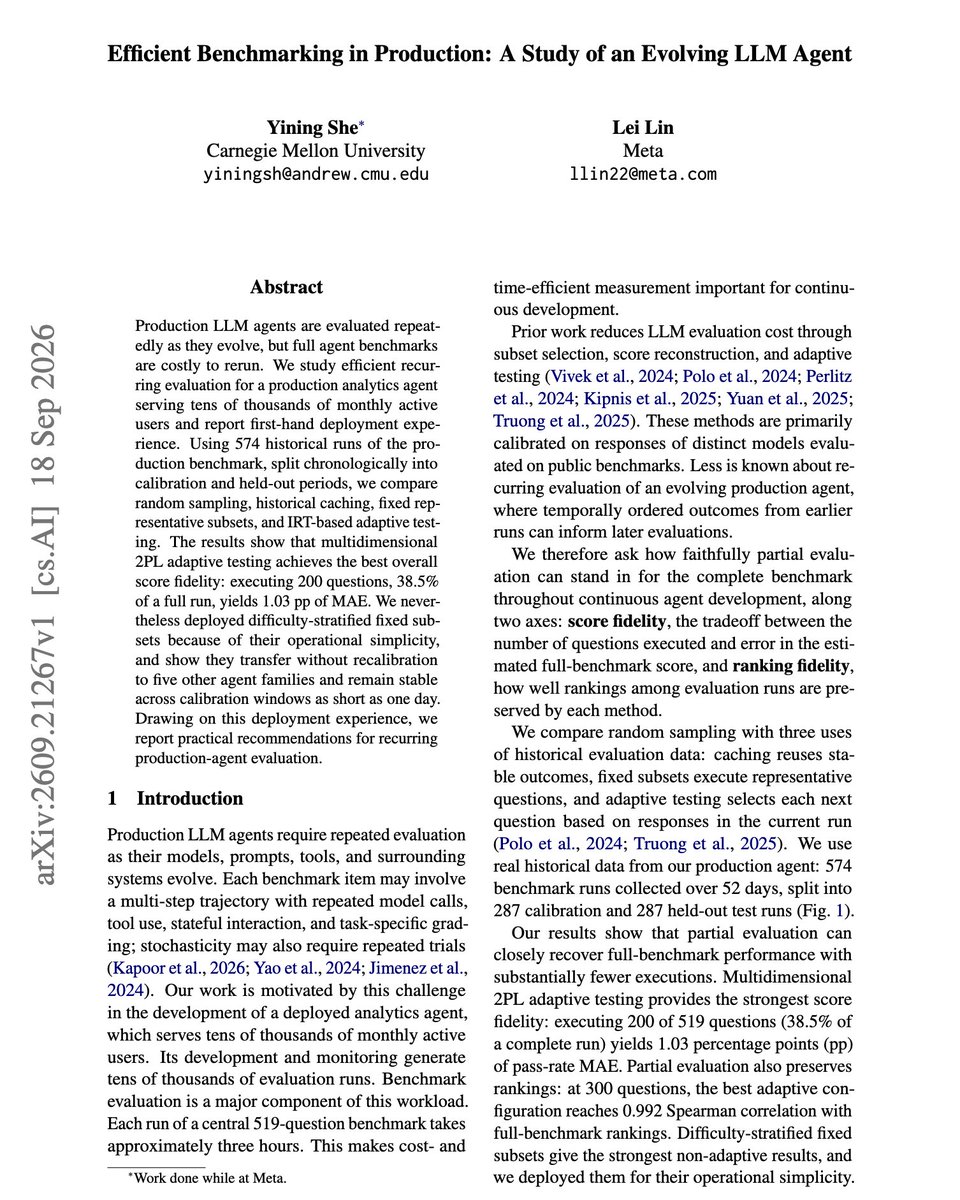
Phương pháp đánh giá lại AI Agent trong môi trường thực tế với chi phí tối ưu

Nice paper showing how to re-evaluate a production agent at a fraction of the cost. 200 questions, …

DịchNghiên cứu đề xuất cách đánh giá lại AI Agent sản xuất chỉ với 200 câu hỏi (38.5% bộ đề gốc) nhưng vẫn giữ sai số cực thấp, giúp tiết kiệm chi phí vận hành đáng kể.

JiQiZhiXin
Quan điểmĐiểm AI 85/100

Từ AI xây dựng AI đến RSI thực thụ: Giải mã chi tiết lộ trình 'tự tiến hóa' tại sự kiện Triple T

Sự kiện Triple T tại Trương Giang đã đi sâu vào lộ trình hiện thực hóa khả năng tự cải thiện đệ quy (RSI) của AI, tập trung vào việc kết nối các vòng lặp khép kín giữa tác nhân, môi trường, dữ liệu và mô hình để giảm thiểu sự phụ thuộc vào con người.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

Công bố báo cáo kỹ thuật Hunyuan-A13B: Mô hình MoE mã nguồn mở với 80B tham số và 13B tham số kích hoạt

Tencent giới thiệu Hunyuan-A13B, mô hình MoE tối ưu hiệu suất với 80B tham số tổng nhưng chỉ kích hoạt 13B khi suy luận. Điểm nhấn là khung tư duy kép (Chain-of-Thought) giúp cân bằng tốc độ xử lý cho các câu hỏi đơn giản và độ chính xác cho các bài toán phức tạp.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 47/100

VHD-Play: Tạo môi trường RL cho tác nhân AI từ các cơ chế đã giải, giúp Qwen3.6-35B-A3B tăng điểm từ 0.204 lên 0.815

VHD-Play giới thiệu quy trình tạo môi trường RL bằng cách mô hình hóa toán học và chuyển đổi thành các công cụ có trạng thái, giúp huấn luyện tác nhân hiệu quả với chi phí cực thấp.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

RewardVerse: Tối ưu hóa chính sách dựa trên tiêu chí đánh giá cho mô hình tạo video

RewardVerse giải quyết vấn đề điểm số không ổn định trong mô hình tạo video bằng cách sử dụng hệ thống đánh giá dựa trên tiêu chí (rubric), giúp việc chấm điểm trở nên nhất quán và đáng tin cậy hơn cho học tăng cường.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 56/100

InternW0: Mô hình thế giới vật lý nền tảng cho tương tác thực tế hiệu quả

Phòng thí nghiệm AI Thượng Hải ra mắt InternW0, mô hình thế giới vật lý sử dụng kiến trúc video-hành động bất đối xứng để tối ưu hóa dự đoán hình ảnh dài hạn và điều khiển robot liên tục với hiệu suất cao.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (45 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 2 | AIHOT.vn