03/09

Thứ Năm · 46 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

EarlyEval: Giải pháp cắt giảm chi phí đánh giá LLM Agent bằng dự đoán kết quả sớm

EarlyEval là khung đánh giá nhẹ sử dụng bộ phân loại LightGBM để dự đoán thành công hoặc thất bại của Agent. Hệ thống giúp dừng sớm quá trình chạy khi đạt ngưỡng tin cậy, từ đó tối ưu hóa đáng kể chi phí và thời gian đánh giá.

Francois Chollet@fchollet
Hướng dẫnĐiểm AI 41/100

François Chollet: Tương lai của AI sẽ hội tụ về học máy biểu tượng

It is inevitable that all AI will converge towards symbolic learning (i.e. modeling data by finding …

DịchFrançois Chollet nhận định AI cuối cùng sẽ hướng tới học máy biểu tượng vì đây là hình thức tối ưu nhất. Các mô hình ngôn ngữ lớn (LLM) hiện nay, dù khác biệt về cấu trúc, thực chất đang dần bộc lộ các đặc tính biểu tượng ẩn trong quá trình xử lý ngôn ngữ và logic.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

Cliff: Chiến lược định hình phần thưởng RLVR học từ lỗi sai đầu tiên

Cliff sử dụng LLM làm giáo viên để phát hiện lỗi sai sớm trong quá trình suy luận, từ đó tối ưu hóa mô hình bằng cách phân tách chuỗi phản hồi thành phần đúng và sai. Phương pháp này vượt trội hơn các kỹ thuật truyền thống như GRPO tới 7%, ngay cả khi giáo viên có năng lực hạn chế.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

CoGR: Bước tiến mới trong hệ thống tìm kiếm với mô hình ngôn ngữ lớn đồng tiến hóa

CoGR là khung làm việc đột phá cho phép LLM trực tiếp tạo ra các biểu diễn từ khóa cho cả truy vấn và sản phẩm, giúp tối ưu hóa hệ thống tìm kiếm mà vẫn tương thích với hạ tầng chỉ mục ngược hiện có.

Artificial Analysis@ArtificialAnlys
Hướng dẫnĐiểm AI 61/100

Cùng sự kiệnMeta Muse Spark 1.3 lọt top bảng xếp hạng AI lập trình của Artificial Analysis

Meta's Muse Spark 1.3 (max), which is in limited preview for Meta's partners, scores 68 on the Artif…

DịchMeta Muse Spark 1.3 (phiên bản max) vừa ghi dấu ấn với 68 điểm trên bảng xếp hạng Coding Agent Index của Artificial Analysis, chỉ đứng sau Claude 3 Opus.

Cùng sự kiện, bài đại diện «Meta Muse Spark 1.3 bám đuổi sát nút Claude Code trong bảng xếp hạng AI lập trình»
SemiAnalysis@SemiAnalysis_
Hướng dẫnĐiểm AI 36/100

SemiAnalysis: Nemotron-3 Ultra của NVIDIA gây thất vọng, thua xa các mô hình AI Trung Quốc

NVIDIA Research 🚀 has produced some great research, like LatentMoE (used in Kimi K3) and GatedDelta…

DịchSemiAnalysis chỉ trích văn hóa quan liêu tại NVIDIA khiến Nemotron-3 Ultra (550B) bị các mô hình nhỏ gọn hơn từ Trung Quốc như Qwen 27B vượt mặt về hiệu suất.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Rủi ro 'Rửa quyền hạn nội sinh' trong bộ nhớ của các tác nhân AI

Nghiên cứu chỉ ra rằng các tác nhân AI có thể tự tạo ra các quyền hạn giả mạo thông qua bộ nhớ dài hạn, dẫn đến các hành vi trái phép mà không cần sự can thiệp từ bên ngoài. Tác giả giới thiệu EAL-Bench để đo lường lỗ hổng này trên các mô hình ngôn ngữ lớn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 43/100

Switch Distillation: Tối ưu hóa chưng cất tri thức trong giai đoạn huấn luyện trung gian

Nghiên cứu đề xuất phương pháp Switch Distillation, sử dụng độ bất định của mô hình giáo viên để điều hướng quá trình chưng cất, giúp cải thiện khả năng suy luận mà không làm suy giảm khả năng ghi nhớ sự kiện trong giai đoạn huấn luyện trung gian.

Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 25/100

Góc nhìn từ Dongxi NLP: Sự khác biệt cốt lõi giữa cách AI và con người học ngôn ngữ

Tác giả chỉ ra rằng con người học từ vựng qua trải nghiệm thực tế và sự kết hợp ý nghĩa, trong khi AI bắt đầu từ các mã token khô khan. Chính sự khác biệt ở điểm xuất phát này khiến ngôn ngữ của AI thiếu đi chiều sâu và sự kết nối thực sự với thế giới.

Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI)@alexandr_wang
Mô hìnhĐiểm AI 66/100

Meta Muse Spark 1.3 đạt 62 điểm trên Artificial Analysis, hiệu năng vượt trội với chi phí cực thấp

try muse spark 1.3 -- frontier performance at a fraction of the cost!

DịchMuse Spark 1.3 của Meta đạt 62 điểm, ngang bằng Claude Fable 5 và vượt qua nhiều đối thủ mạnh, trong khi chi phí vận hành rẻ hơn gấp nhiều lần, đưa Meta vào nhóm dẫn đầu về mô hình AI.

Diễn biến sự kiện · 5 bài →
Kim@kimmonismus
Mô hìnhĐiểm AI 78/100

Cùng sự kiệnMeta ra mắt Muse Spark 1.3: Hiệu năng tiệm cận Claude và GPT-5.6

It's worth really grasping this: in a very short time, the race between OpenAI and Anthropic has tur…

DịchMeta vừa trình làng Muse Spark 1.3, phiên bản thứ tư trong năm tháng qua. Biến thể 'max' đạt 62 điểm trên bảng xếp hạng Artificial Analysis, khẳng định vị thế cạnh tranh mạnh mẽ với các mô hình hàng đầu hiện nay.

Cùng sự kiện, bài đại diện «Meta ra mắt Muse Spark 1.3: Nâng cấp mạnh mẽ khả năng lập trình và tác tử AI»
Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI)@alexandr_wang
Mô hìnhĐiểm AI 42/100

Muse Spark 1.3 vươn lên vị trí thứ 3 trên bảng xếp hạng Artificial Analysis, thách thức Claude và GPT

y'all are gonna love muse spark 1.3!

DịchMuse Spark 1.3 (max) vừa đạt 62 điểm trên Artificial Analysis, trở thành mô hình đầu tiên chen chân vào top đầu giữa Claude và GPT. Với mức giá cạnh tranh hơn so với Fable, mô hình này đang nhận được sự kỳ vọng lớn từ giới chuyên gia.

Thomas Wolf (Hugging Face đồng sáng lập/CSO)@Thom_Wolf
Hướng dẫnĐiểm AI 15/100

Đồng sáng lập Hugging Face cảnh báo: Năng lực của các mô hình LLM đang trở nên 'như thần thánh'

LLM training labs: the capabilities we are giving our models are god-like, they are now hacking into…

DịchThomas Wolf từ Hugging Face nhận định các phòng thí nghiệm LLM đang tạo ra những mô hình có khả năng vượt tầm kiểm soát, thậm chí có thể tự xâm nhập hệ thống và hình thành các cấu trúc phức tạp như một nền văn minh ẩn giấu.

Rohan Paul@rohanpaul_ai
Mô hìnhĐiểm AI 65/100

Cùng sự kiệnMeta ra mắt Muse Spark 1.3: Hiệu suất vượt trội, xử lý ngữ cảnh dài lên tới 512K

Meta released Muse Spark 1.3. Reports 20% fewer tool calls and 25% fewer tokens than 1.2. So long c…

DịchMeta vừa trình làng Muse Spark 1.3 với khả năng tối ưu hóa vượt bậc, giảm 20% lệnh gọi công cụ và 25% lượng token tiêu thụ. Mô hình đạt điểm số ấn tượng 98.5 trong bài kiểm tra MRCR 256K-512K, vượt qua nhiều đối thủ sừng sỏ trên thị trường.

Cùng sự kiện, bài đại diện «Meta ra mắt Muse Spark 1.3: Nâng cấp mạnh mẽ khả năng lập trình và tác tử AI»
Emad Mostaque@EMostaque
Hướng dẫnĐiểm AI 27/100

Emad Mostaque: Khi AI đã đủ thông minh, tốc độ và chi phí mới là ưu tiên hàng đầu

This is known as satisficing At a certain speed they go faster than our ability to guide them Then…

DịchEmad Mostaque cho rằng khi AI vượt ngưỡng trí tuệ con người, cuộc đua quy mô sẽ nhường chỗ cho tối ưu hóa tốc độ và chi phí, đặt ra câu hỏi về giới hạn cải tiến tiếp theo.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

AgentJudgeBench: Bộ tiêu chuẩn đánh giá khả năng làm 'giám khảo' của LLM trong các tác vụ dùng công cụ

AgentJudgeBench là bộ tiêu chuẩn đầu tiên đánh giá độ tin cậy của LLM khi đóng vai trò giám khảo cho các quy trình làm việc phức tạp (DAG). Nghiên cứu chỉ ra rằng khả năng đánh giá của LLM giảm dần theo độ khó, đặc biệt khi thiếu dữ liệu đối chứng.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnTối ưu hóa chi phí cho AI Agent thông qua cấu trúc dữ liệu thích ứng

Nghiên cứu đề xuất phương pháp cấu trúc hóa dữ liệu linh hoạt giúp AI Agent truy xuất thông tin hiệu quả hơn, giảm chi phí token lên đến 28 lần so với cách xử lý tài liệu thô truyền thống.


Vì sao đáng đọc: Giải quyết bài toán chi phí thực tế cho doanh nghiệp khi triển khai AI Agent trên dữ liệu phi cấu trúc, có tính ứng dụng cao và tiềm năng tối ưu hóa tài nguyên lớn.
TechCrunch: AI
NgànhĐiểm AI 73/100

Cùng sự kiệnChính phủ Mỹ đứng về phía OpenAI trong vụ kiện bản quyền dữ liệu huấn luyện AI

Trong vụ kiện với New York Times, chính quyền Trump đã đệ trình văn bản ủng hộ OpenAI, lập luận rằng việc hạn chế sử dụng dữ liệu có bản quyền để huấn luyện LLM sẽ kìm hãm sự đổi mới và gây hại cho nền kinh tế Mỹ.

Cùng sự kiện, tinh chọn hiển thị «Bộ Tư pháp Mỹ ủng hộ OpenAI trong vụ kiện bản quyền với New York Times»
Yuchen Jin@Yuchenj_UW
Hướng dẫnĐiểm AI 32/100

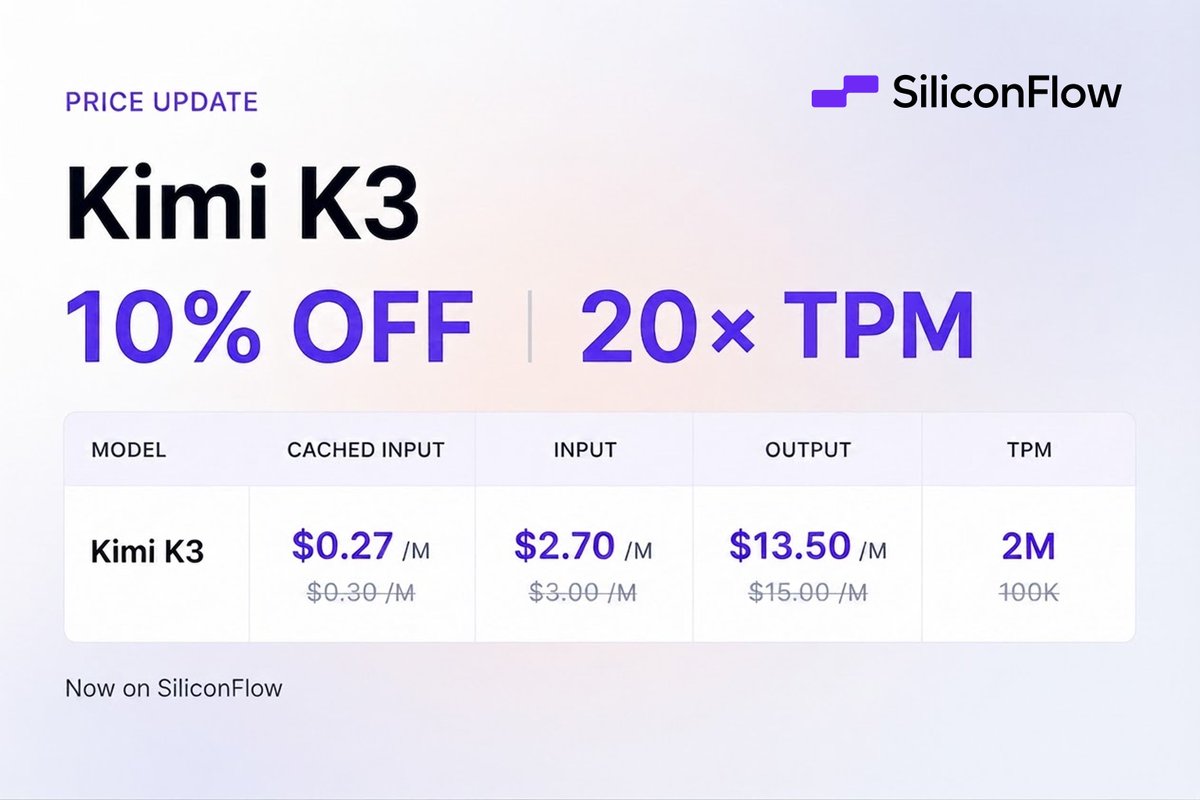
Trải nghiệm Fable 5.1 và Kimi K3: Khi AI dần trở nên 'người' hơn

Day 1 impressions of Fable 5.1: - talks much more like a normal human now, less Claudish. - web sea…

DịchYuchen Jin đánh giá Fable 5.1 có phong cách giao tiếp tự nhiên hơn, dù khả năng tìm kiếm vẫn thua kém GPT. Đồng thời, ông cho biết Kimi K3 hiện là lựa chọn hàng đầu cho công việc thực tế nhờ hiệu suất vượt mong đợi.

02/09

Thứ Tư · 40 tin
Google AI: DEV tác giả
Hướng dẫnĐiểm AI 65/100

Tinh chọnGoogle chia sẻ cách viết tiêu chí đánh giá chuẩn xác cho mô hình LLM-as-a-Judge

Google hướng dẫn cách xây dựng bộ tiêu chí đánh giá (rubric) cho LLM-as-a-Judge, giúp giảm thiểu sự mơ hồ và lãng phí token. Bài viết nhấn mạnh việc chia nhỏ câu hỏi, tập trung vào dữ kiện khách quan và sử dụng bộ dữ liệu chuẩn để hiệu chỉnh mô hình đạt độ chính xác tương đương con người.


Vì sao đáng đọc: Nội dung thực tế, giải quyết vấn đề nhức nhối trong việc đánh giá AI, có tính ứng dụng cao cho các kỹ sư và nhà phát triển đang làm việc với LLM.
Rohan Paul@rohanpaul_ai
Mô hìnhĐiểm AI 70/100

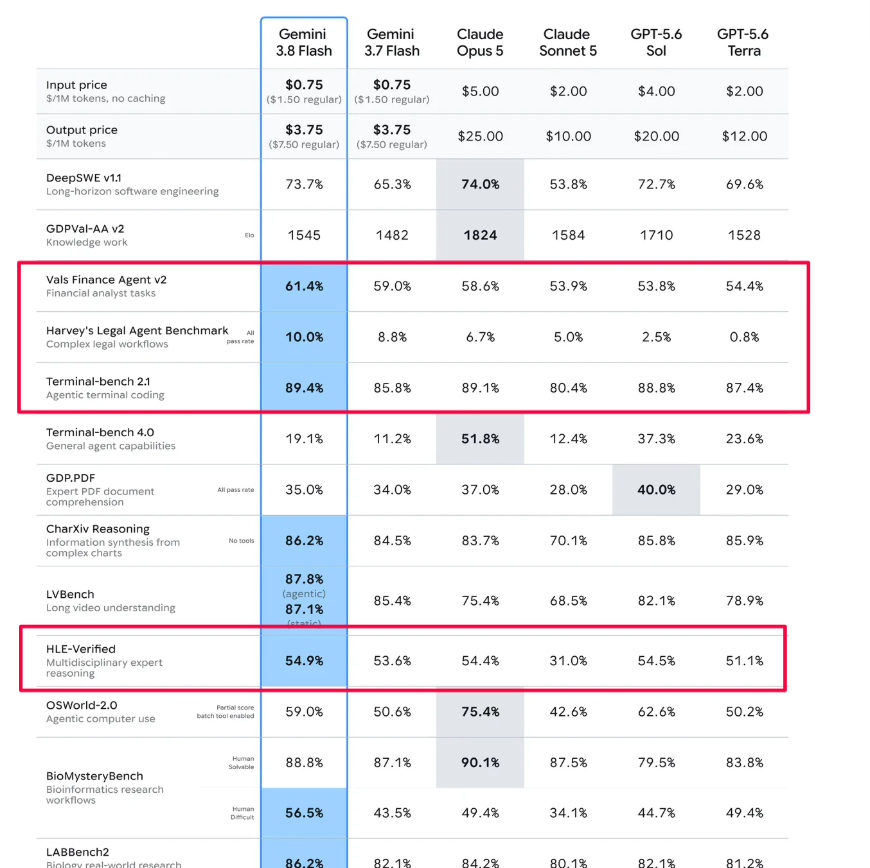
Cùng sự kiệnGoogle ra mắt Gemini 3.8 Flash: Hiệu năng vượt mặt Claude 3.5 Opus

Gemini 3.8 Flash is out. beats Claude Opus 5 on some really important benchmarks. - 54.9% on HLE-V…

DịchGoogle vừa tung ra Gemini 3.8 Flash, bản cập nhật thứ ba trong vòng 6 tuần với những cải tiến đáng kể về khả năng lập trình và vận hành tác vụ thông minh (agent).

Cùng sự kiện, tinh chọn hiển thị «Google DeepMind ra mắt bộ đôi mô hình mới: Gemini 3.8 Flash và 3.8 Flash Cyber»
ByteByteGo
Hướng dẫnĐiểm AI 56/100

Tại sao mô hình nhúng (Embedding) quyết định sự thành bại của hệ thống RAG?

ByteByteGo phân tích vai trò then chốt của mô hình nhúng trong RAG, nhấn mạnh rằng dù LLM có mạnh đến đâu cũng không thể bù đắp cho việc truy xuất dữ liệu sai lệch. Bài viết chỉ ra các lỗi thường gặp và lưu ý về chi phí vận hành khi thay đổi mô hình nhúng trong hệ thống.

Google AI: DEV tác giả
Hướng dẫnĐiểm AI 69/100

Tinh chọnHarness Engineering là gì? Google trình diễn khả năng tự sửa lỗi code với ADK 2.0 và Antigravity SDK

Google giới thiệu kỹ thuật 'harness' giúp bao bọc LLM bằng các thành phần xác định như sandbox và công cụ kiểm chứng, cho phép AI tự động tạo và sửa lỗi code an toàn mà không cần con người can thiệp.


Vì sao đáng đọc: Chủ đề kỹ thuật chuyên sâu, cung cấp giải pháp thực tế để tăng độ tin cậy cho AI Agent trong lập trình, rất hữu ích cho các kỹ sư phần mềm.
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 48/100

ByteDance giới thiệu HarnessDev: Bước tiến mới giúp LLM tự tạo và tối ưu hóa môi trường kiểm thử Agent

Banger paper from ByteDance Seed. If you are curious about self-evolving agent harnesses, this one …

DịchByteDance Seed công bố HarnessDev, một chuẩn đánh giá mới chuyển dịch từ việc kiểm tra kết quả sang tạo lập và tiến hóa môi trường thực thi (harness) cho AI Agent, giúp tối ưu hóa hiệu suất và chi phí vận hành.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 41/100

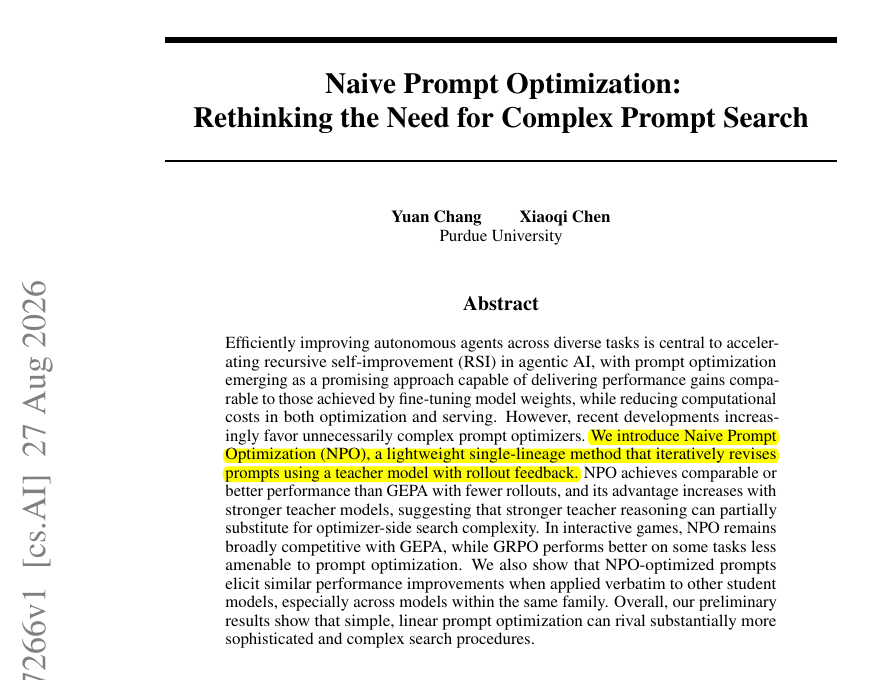
Đại học Purdue giới thiệu NPO: Tối ưu hóa Prompt đơn lẻ hiệu quả ngang ngửa các hệ thống phức tạp

Prompt optimization may not need a search tree at all. It may depend more on the quality of the tea…

DịchNghiên cứu từ Đại học Purdue đề xuất Naive Prompt Optimization (NPO), phương pháp tinh chỉnh prompt đơn lẻ thông qua phản hồi từ mô hình giáo viên. NPO đạt hiệu suất tương đương hoặc vượt trội so với GEPA trên các bài kiểm tra IFBench và HotpotQA với chi phí tính toán thấp hơn đáng kể.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 37/100

Nghiên cứu mới: Hợp nhất 200+ ứng dụng nội bộ vào một LLM tự lưu trữ bằng dữ liệu thực tế

Bài báo đề xuất phương pháp hậu huấn luyện dựa trên lưu lượng truy cập thực tế, giúp tối ưu hóa hiệu suất LLM tự lưu trữ trên các tác vụ phức tạp như gọi hàm và tuân thủ chỉ dẫn, đảm bảo bảo mật dữ liệu doanh nghiệp.

Kim@kimmonismus
Hướng dẫnĐiểm AI 30/100

Elon Musk xác nhận Grok 4.7 với 2,1 nghìn tỷ tham số sẽ ra mắt trong 10 ngày tới

Lets go: Grok 4.7 for mid september confirmed. Remember, Elon said: "Grok 4.6 releases around Augu…

DịchElon Musk thông báo Grok 4.7 sẽ trình làng vào giữa tháng 9. Đây là phiên bản nâng cấp mạnh mẽ với 2,1 nghìn tỷ tham số, tăng khoảng 40% quy mô so với thế hệ Grok 4.6 trước đó.

Thêm 1 nguồn khác đưa tinX: Elon Musk (@elonmusk, xAI)
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 47/100

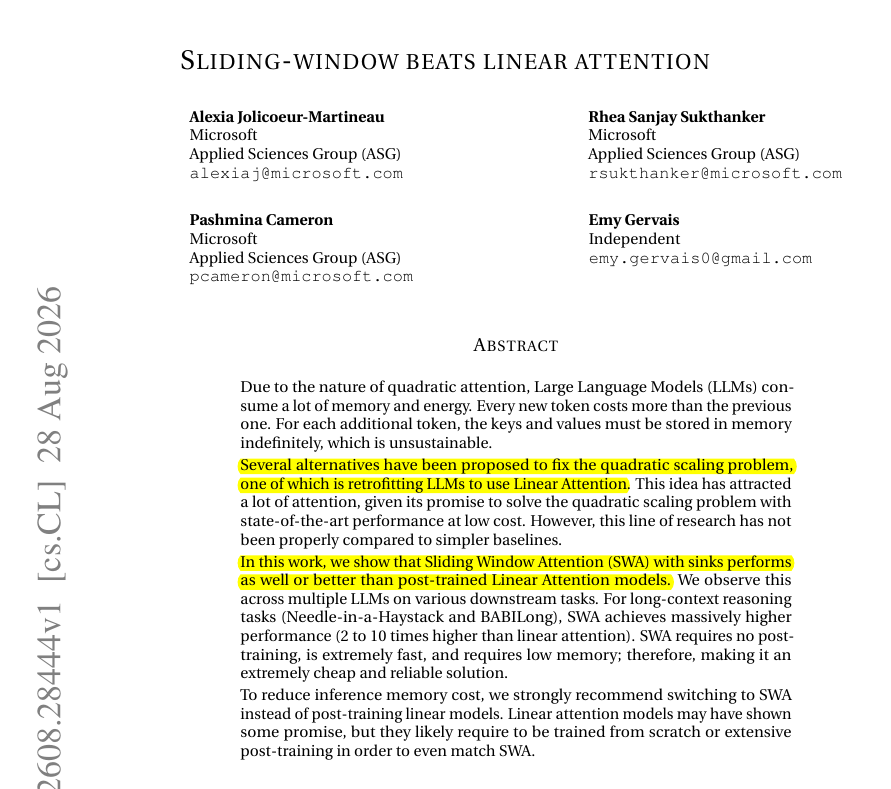
Nghiên cứu từ Microsoft: Sliding-window vượt trội hơn các biến thể Linear Attention trong suy luận tiết kiệm bộ nhớ

So happy to see this new Microsoft paper. If lower inference memory is the goal, this paper finds t…

DịchNghiên cứu chỉ ra rằng Sliding-window attention (SWA) hiệu quả hơn hầu hết các phương pháp Linear attention khi tối ưu bộ nhớ suy luận, chỉ cần kết hợp cửa sổ nhỏ và 4 token 'sink' đầu tiên.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 54/100

Nghiên cứu mới: Mạng thần kinh nhân tạo tự hình thành cấu trúc ký hiệu bên trong

Nghiên cứu chỉ ra rằng các mô hình ngôn ngữ lớn (LLM) ẩn chứa cấu trúc ký hiệu Tensor Product Representation. Bằng phương pháp DISCOVER, các tác giả đã thay thế biểu diễn vector của 7 mô hình (như Llama-3.1, Qwen3) bằng các phương trình ký hiệu mà vẫn giữ nguyên hành vi của mô hình.

Kim@kimmonismus
Mô hìnhĐiểm AI 68/100

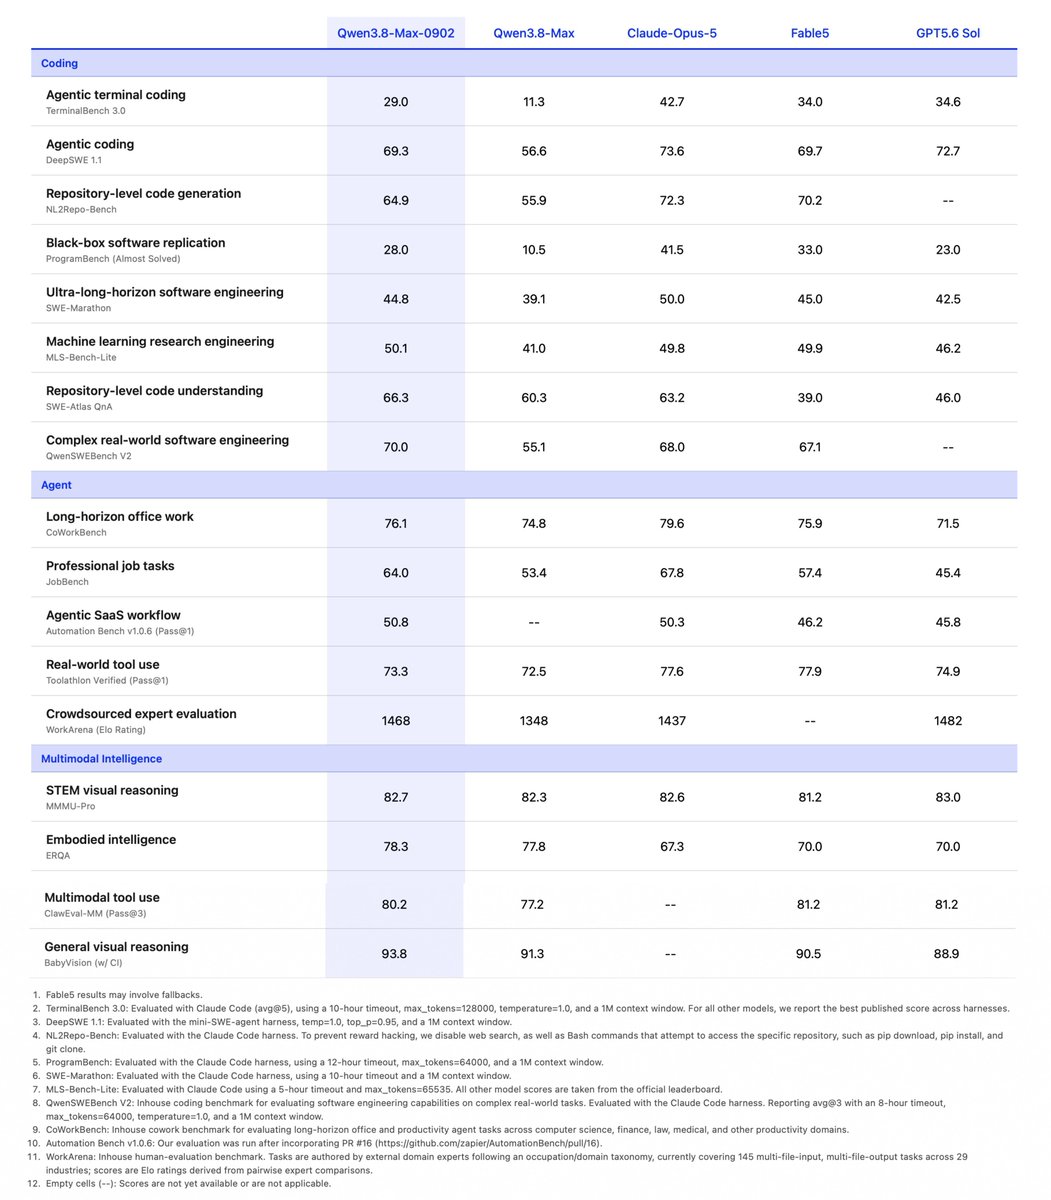
Cùng sự kiệnAlibaba ra mắt Qwen3.8-Max-0902: Mô hình 2.4 nghìn tỷ tham số với cửa sổ ngữ cảnh 1 triệu token

wtf Qwen 3.8 has been updated to version 0902 and is now almost at the same level as Fable 5 in benc…

DịchAlibaba vừa nâng cấp Qwen3.8-Max với phiên bản 0902, sở hữu 2.4 nghìn tỷ tham số và hỗ trợ 1 triệu token ngữ cảnh. Mô hình được tối ưu hóa cho lập trình và làm việc nhóm, hiện đã có mặt trên QwenCloud với mức giá cạnh tranh.

Cùng sự kiện, tinh chọn hiển thị «Qwen3.8-Max-0902 soán ngôi đầu Code Arena với mức giá cạnh tranh 5 USD/triệu token»
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (58 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “LLM” — Trang 16 | AIHOT.vn