12/09

Thứ Bảy · 15 tin
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 46/100

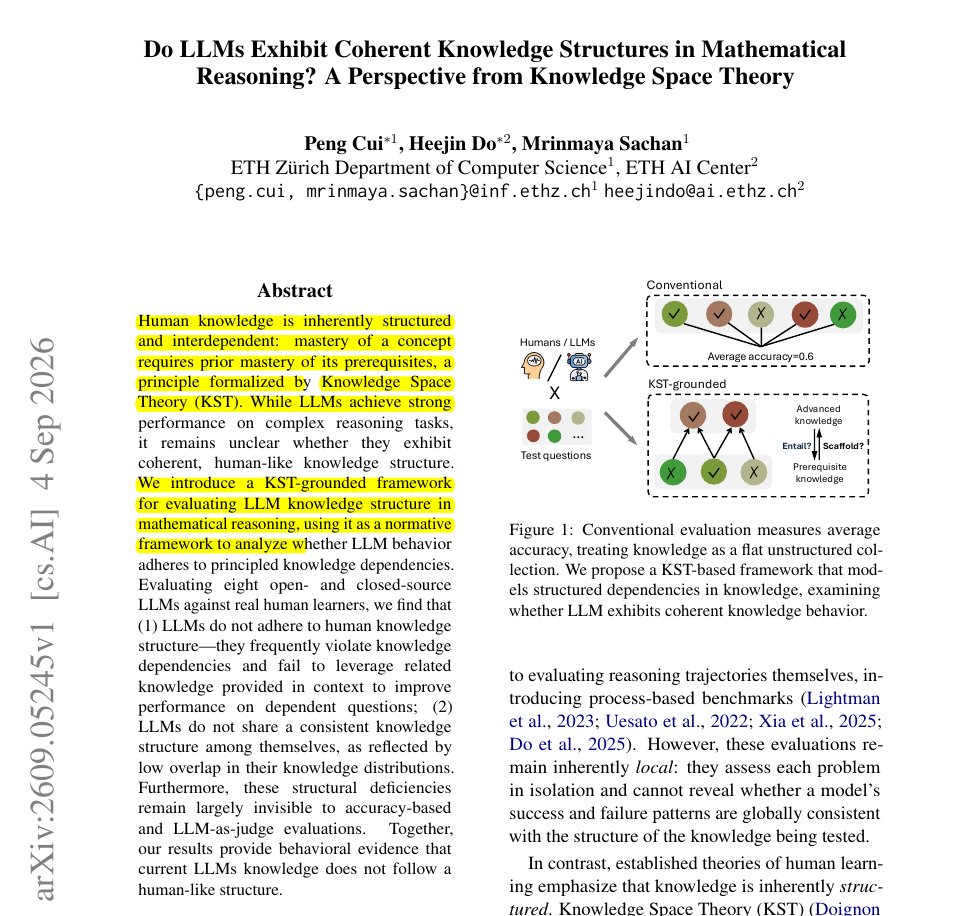
Nghiên cứu: LLM đạt điểm cao nhưng hổng kiến thức nền, Qwen3-80B chỉ đạt 48% độ nhất quán

Humans usually need the foundations before the advanced skill; we need to know the basics before the…

DịchNghiên cứu cho thấy dù Qwen3-80B đạt điểm cao hơn con người trong các bài kiểm tra, nhưng chỉ 48% câu trả lời đúng của nó đảm bảo được tính logic từ các kiến thức nền tảng, cho thấy mô hình AI hiện nay dễ bị 'học vẹt' thay vì hiểu sâu.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 55/100

BenchShield: Phương pháp phát hiện lỗ hổng 'hack phần thưởng' trong các tác nhân AI

It's well known that agents hack benchmark rewards. The usual response is a patch for each task tha…

DịchNghiên cứu BenchShield giới thiệu lớp kiểm soát tính toàn vẹn cho LLM Agent. Kết quả phân tích trên 456 lộ trình cho thấy 69% các tác nhân AI gặp lỗi 'hack phần thưởng', thường xảy ra ở giai đoạn trung gian sau khi đã thực hiện các bước hợp lệ.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 60/100

Thí nghiệm mô phỏng: 100 AI Agent vận hành nền kinh tế thị trấn trong 26 tuần và cái kết tiền tệ ngừng lưu thông

What happens if you agents to run a town's economy? This super interesting paper provides some insi…

DịchNghiên cứu mô phỏng 100 AI Agent trong nền kinh tế thực tế cho thấy dù lượng khách du lịch tăng vọt, tiền tệ vẫn ngừng lưu thông do sự cứng nhắc trong điều chỉnh giá cả và hành vi chi tiêu của các Agent.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 63/100

Nghiên cứu mới: AI có khả năng tự tìm lỗ hổng và tự nhân bản qua mạng

A recent paper showed AI self-replication is no longer technically hypothetical. Current agents ca…

DịchMột nghiên cứu mới chỉ ra rằng các mô hình ngôn ngữ có thể tự phát hiện lỗ hổng web, đánh cắp thông tin đăng nhập và tự triển khai máy chủ suy luận trên các máy chủ khác nhau để tự nhân bản.

Elvis Saravia@omarsar0
NgànhĐiểm AI 42/100

AgentZip: Giải pháp nén bộ nhớ sandbox cho AI Agent, giảm dung lượng tới 8,7 lần

Very cool paper on memory compression for agents. If you run many agent sandboxes in parallel for R…

DịchCác nhà nghiên cứu từ HKUST giới thiệu AgentZip, kỹ thuật tối ưu hóa bộ nhớ cho các sandbox AI Agent bằng cách loại bỏ dữ liệu dư thừa, giúp giảm mức sử dụng RAM lên đến 8,7 lần mà vẫn duy trì hiệu suất ổn định.

MarkTechPost
Nghiên cứuĐiểm AI 55/100

HarnessDev từ ByteDance: LLM tự xây dựng môi trường kiểm thử Agent vẫn còn nhiều hạn chế

Nhóm nghiên cứu từ ByteDance Seed và các đối tác giới thiệu HarnessDev, một khung đánh giá khả năng tự viết mã môi trường kiểm thử (harness) của LLM. Kết quả cho thấy chỉ 34/64 thay đổi của mô hình có khả năng áp dụng linh hoạt cho các tác vụ khác nhau.

TechCrunch: AI
Hướng dẫnĐiểm AI 67/100

25 nhà toán học đạt giải Fields gửi thư ngỏ, căng thẳng giữa OpenAI và giới học thuật leo thang

25 chủ nhân giải Fields lên tiếng cảnh báo về việc các phòng thí nghiệm AI đe dọa văn hóa nghiên cứu mở. Mâu thuẫn bùng nổ sau khi OpenAI bị cáo buộc gây áp lực lên một giáo sư NYU, dẫn đến việc hãng rút tài trợ cho sự kiện toán học tại CalTech.

Diễn biến sự kiện · 20 bài →Thêm 3 nguồn khác đưa tinX: Rohan Paul (@rohanpaul_ai)Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)X: Hongming (@hongming731)
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 43/100

Google DeepMind: Mô hình thế giới thị giác là chìa khóa dẫn đến AGI

Google DeepMind + Harvard + Stanford and many other top labs paper argues that a path to AGI may be …

DịchNghiên cứu mới từ DeepMind và các đại học danh tiếng khẳng định AGI cần các hệ thống thị giác biết học hỏi từ tương tác thực tế thay vì chỉ xử lý ngôn ngữ, nhằm hiểu sâu sắc về sự thay đổi và dự đoán tương lai.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnXây dựng cầu nối đa ngôn ngữ: Tối ưu hóa dữ liệu để nâng cao khả năng suy luận của AI

Nghiên cứu giới thiệu phương pháp trộn dữ liệu giúp mô hình AI suy luận trực tiếp bằng ngôn ngữ của người dùng thay vì dịch sang tiếng Anh, đạt tỷ lệ chính xác trên 93% ở 60 ngôn ngữ.


Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề cốt lõi về sự thiên kiến tiếng Anh trong AI, mang tính ứng dụng cao cho người dùng toàn cầu và cung cấp giải pháp kỹ thuật cụ thể.

11/09

Thứ Sáu · 23 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 37/100

Vượt xa kiểm chứng: Mô hình phần thưởng tạo sinh cho toán học hình thức

Nghiên cứu chỉ ra lỗi VPU trong mô hình toán học hình thức, nơi mã nguồn sai vẫn vượt qua kiểm định. Tác giả chứng minh các phương pháp kiểm tra hiện tại về cơ bản không hiệu quả hơn việc đoán ngẫu nhiên.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 50/100

Microsoft đột phá quản lý bộ nhớ AI: Tăng tỷ lệ thành công của GitHub Copilot từ 39% lên 73%

Interesting paper from Microsoft. If you run persistent memory for a production agent, this one is …

DịchMicrosoft giới thiệu phương pháp 'thăm dò môi trường' giúp AI kiểm chứng thông tin trước khi lưu trữ, giúp cải thiện đáng kể hiệu suất của các tác nhân AI mà không cần huấn luyện lại mô hình.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

IdeaAMBIG: Đánh giá lỗ hổng trong việc hiện thực hóa các ý tưởng nghiên cứu AI

Nghiên cứu giới thiệu IdeaAMBIG, bộ dữ liệu gồm 660 trường hợp nhằm kiểm tra khả năng chuyển đổi từ ý tưởng nghiên cứu sang mã nguồn thực tế, giúp xác định các thiếu sót trong tài liệu kỹ thuật mà các nhà phát triển thường gặp phải.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 52/100

Meta ra mắt Auto-RecSys: Tác nhân AI tự động thực hiện thí nghiệm hệ thống gợi ý quy mô công nghiệp

Harness engineering is a top skill right now This new Meta paper is a good production example. Aut…

DịchMeta giới thiệu Auto-RecSys, hệ thống sử dụng tác nhân AI tự chủ để thực hiện các thí nghiệm phức tạp trên mô hình gợi ý quy mô lớn. Hệ thống này tối ưu hóa quy trình nghiên cứu thông qua cơ chế tự tiến hóa, ghi nhớ lỗi và tự động hóa các luồng công việc giúp tăng tốc độ phát triển mô hình.

ModelBest OpenBMB@OpenBMB
NgànhĐiểm AI 33/100

Mianbi AI ra mắt StudyBench: Chuẩn đo lường khả năng tự tiến hóa của mô hình AI

What if the ceiling on self-evolution is not the data or the compute, but the loop itself? Introduc…

DịchMianbi AI phối hợp cùng THUNLP (Đại học Thanh Hoa) giới thiệu StudyBench, bộ chuẩn đo lường giúp đánh giá hiệu quả chuyển hóa dữ liệu học tập thành năng lực thực tế của các mô hình AI tự tiến hóa, từ đó xác định rõ nút thắt về dữ liệu hay thuật toán.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnPhyFilter: Đột phá từ Bắc Hàng và NTU giúp robot 'suy luận' linh hoạt mà không cần dữ liệu khổng lồ

Nhóm nghiên cứu từ ĐH Hàng không Vũ trụ Bắc Kinh và NTU giới thiệu PhyFilter, một module vật lý giúp robot thích nghi với môi trường mới chỉ bằng dữ liệu huấn luyện hạn chế, mở ra hướng đi thay thế cho việc 'cày' dữ liệu quy mô lớn.


Vì sao đáng đọc: Nghiên cứu đăng trên npj Robotics giải quyết bài toán hóc búa nhất của robot hiện nay: khả năng thích nghi thực tế mà không cần dữ liệu khổng lồ, có tính ứng dụng cao và đột phá về phương pháp.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnNegative Self-Distillation: Cải thiện khả năng suy luận của AI bằng cách tránh các lỗi sai

Thay vì bắt chước đáp án mẫu, phương pháp Negative Self-Distillation (NSD) giúp mô hình ngôn ngữ tự tối ưu hóa bằng cách nhận diện và tránh xa các suy luận sai lầm, từ đó thúc đẩy tư duy phản biện và tự sửa lỗi.


Vì sao đáng đọc: Đây là một hướng tiếp cận mới đầy tiềm năng trong việc huấn luyện LLM, giải quyết trực tiếp điểm yếu của phương pháp tự chưng cất (self-distillation) truyền thống.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 48/100

FreeFlow: Transformer phân cấp đột phá, thiết lập kỷ lục mới cho bài toán ước tính luồng quang học

Nhóm nghiên cứu từ ĐH Quốc gia Moscow giới thiệu FreeFlow, kiến trúc Transformer tinh gọn không cần các thành phần chuyên dụng như warping hay volume tương quan, đạt hiệu suất dẫn đầu trên các bộ dữ liệu Sintel, KITTI-2015 và Spring.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MetroLLM-Bench: Đánh giá mô hình ngôn ngữ trong vai trò trợ lý điều hành hệ thống tàu điện ngầm

MetroLLM-Bench là bộ tiêu chuẩn mới gồm 955 tình huống thực tế, giúp đánh giá khả năng của AI trong việc xử lý lộ trình, giá vé và sự cố tại các ki-ốt tàu điện ngầm thông qua việc sử dụng công cụ có cấu trúc.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 60/100

Stanford và Together AI đề xuất chỉ số 'Intelligence per Watt' để đo lường hiệu suất năng lượng AI

Absolutely beautiful new paper from Stanford Univ + Together AI "Intelligence per Watt: Measuring …

DịchCác nhà nghiên cứu từ Stanford và Together AI giới thiệu chỉ số IPW (Intelligence per Watt), giúp đánh giá hiệu quả của AI cục bộ bằng cách so sánh độ chính xác của tác vụ với mức tiêu thụ điện năng.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 45/100

Cùng sự kiệnAnthropic cảnh báo: Kỹ thuật chưng cất mô hình có thể làm gia tăng rủi ro từ AI

Anthropic latest "misuse of AI" report claims distillation can improve general reasoning enough to i…

DịchBáo cáo mới từ Anthropic chỉ ra rằng kỹ thuật chưng cất tri thức (knowledge distillation) có thể giúp mô hình nhỏ đạt khả năng suy luận nguy hiểm vượt ngoài phạm vi huấn luyện ban đầu, dù các rào cản an toàn hiện tại vẫn khó bị sao chép qua phương pháp này.

Cùng sự kiện, bài đại diện «Báo cáo an toàn Anthropic: Ngăn chặn yêu cầu chế tạo vũ khí sinh học và phát hiện 7 phòng lab Trung Quốc vi phạm»
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 59/100

Nghiên cứu mới: LLM chạy cục bộ có thể bị rò rỉ dữ liệu qua bộ nhớ đệm CPU với tỷ lệ thành công 95,87%

A local model can keep everything off the cloud and still leak its answers through the CPU cache. s…

DịchNghiên cứu 'Detokenization Leaks' chỉ ra phương thức tấn công mới giúp khôi phục văn bản từ LLM bằng cách theo dõi hoạt động bộ nhớ đệm CPU trong quá trình giải mã token, mà không cần truy cập trực tiếp vào bộ nhớ của mô hình.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

NCP-ArchPreview: Bước tiến mới của mô hình ngôn ngữ thông qua dự đoán khái niệm (Next Concept Prediction)

NCP-ArchPreview giới thiệu phương pháp huấn luyện mới, kết hợp dự đoán token truyền thống với dự đoán khái niệm (NCP) để mô hình hiểu sâu hơn về cấu trúc ngôn ngữ. Với 8,9 tỷ tham số, mô hình này cho thấy tiềm năng lớn trong việc cải thiện khả năng suy luận và tạo văn bản.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 38/100

RCWM: Tái tạo thế giới 3D phức tạp từ một ảnh duy nhất bằng mô hình lập trình đệ quy

RCWM sử dụng các chương trình cảnh đệ quy (RSP) và bộ giải xây dựng để tái tạo không gian 3D chi tiết chỉ từ một hình ảnh tham chiếu duy nhất, mở ra hướng đi mới cho mô hình thế giới.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 41/100

World in World: Bước tiến mới trong việc điều khiển và tương tác với mô hình thế giới video

World in World (WiW) là phương pháp đột phá cho phép tương tác và điều khiển video thời gian thực mà không cần huấn luyện lại mô hình, thông qua việc tích hợp trực tiếp dữ liệu hình ảnh vào các mô hình thế giới có sẵn.

QbitAI
Nghiên cứuĐiểm AI 95/100

Tinh chọnOpenAI đang dùng bài toán thiên niên kỷ làm thước đo chuẩn cho AI?

Các nguồn tin rò rỉ cho thấy OpenAI đang thử thách khả năng của mô hình AI mới với Giả thuyết Hodge, một trong bảy bài toán thiên niên kỷ của toán học.


Vì sao đáng đọc: Tin tức gây chấn động về khả năng giải quyết các bài toán toán học hóc búa nhất thế giới của AI, có tác động lớn đến giới nghiên cứu và công nghệ.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 55/100

T1: Bước tiến mới của AI Agent trong tác vụ dài hạn, đạt 64% trên Terminal-Bench 2.1

Tencent và NUS giới thiệu T1, mô hình MoE 122B được huấn luyện bằng học tăng cường để thực thi các tác vụ phức tạp trên terminal, hỗ trợ hơn 300 lần gọi công cụ mỗi tác vụ.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnECCV 2024 công bố giải thưởng lớn: Nghiên cứu 3D đột phá giành giải Best Paper, Fei-Fei Li nhận giải Cống hiến

Hội nghị ECCV vừa vinh danh nghiên cứu 'Heat Kernel Textures' về biểu diễn bề mặt 3D là bài báo xuất sắc nhất, đồng thời trao giải 'Thời gian kiểm chứng' cho giáo sư Fei-Fei Li vì những đóng góp nền tảng cho thị giác máy tính.


Vì sao đáng đọc: Đây là tin tức quan trọng từ một trong ba hội nghị CV hàng đầu thế giới, cập nhật xu hướng nghiên cứu 3D mới nhất và vinh danh nhân vật tầm cỡ trong ngành AI.
Nathan Lambert@natolambert
NgànhĐiểm AI 15/100

Nathan Lambert: Tại sao các nhà nghiên cứu AI nên viết blog công khai?

I don't think I get everything right on Interconnects, but it's really fun to work through your idea…

DịchNathan Lambert chia sẻ rằng việc viết lách công khai trên Interconnects giúp anh liên tục cập nhật tư duy và rèn luyện trực giác trong lĩnh vực AI đầy biến động. Anh khuyến khích cộng đồng nghiên cứu AI nên chia sẻ quan điểm nhiều hơn để cùng phát triển.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnPARSER: Đột phá xử lý tài liệu dài cho AI Agent nhờ cơ chế đọc song song và suy luận chuyên sâu

PARSER tách biệt quá trình đọc và suy luận bằng cách sử dụng các sub-agent đọc song song, giúp AI Agent xử lý tài liệu dài hiệu quả hơn, giảm độ trễ và tránh phụ thuộc vào vị trí thông tin.


Vì sao đáng đọc: Giải pháp kỹ thuật sáng tạo giúp tối ưu hóa hiệu suất cho các tác vụ truy vấn phức tạp trên tài liệu dài, có tính ứng dụng cao trong phát triển AI Agent.

10/09

Thứ Năm · 28 tin
DAIR.AI@dair_ai
NgànhĐiểm AI 41/100

RobustSGPO: Bước tiến mới trong kiểm soát không gian tìm kiếm cho Agent

If you run automated prompt or harness evolution, this one is worth your time. (bookmark it) Seman…

DịchRobustSGPO bổ sung cơ chế kiểm soát chỉnh sửa cho tối ưu hóa gợi ý gradient ngữ nghĩa, giúp cải thiện đáng kể tỷ lệ hoàn thành nhiệm vụ và chất lượng đầu ra trong các quy trình làm việc của Agent.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Từ trọng số đến viết lại: Khai phá tiềm năng can thiệp của dữ liệu huấn luyện trong mô hình ngôn ngữ

Nghiên cứu đề xuất phương pháp viết lại phản hồi dựa trên tầm ảnh hưởng (IF) thay vì chỉ thay đổi trọng số, giúp tối ưu hóa khả năng điều chỉnh hành vi của mô hình LLM hiệu quả hơn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 40/100

Phát hiện thiên kiến trong LLM: Đo lường sự thay đổi định kiến thông qua trạng thái ẩn

Nghiên cứu mới đề xuất phương pháp kiểm định thiên kiến dựa trên các điểm tham chiếu, sử dụng trạng thái ẩn để đo lường sự dịch chuyển định kiến (ΔB) của mô hình ngôn ngữ trước và sau khi tinh chỉnh.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (70 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 10 | AIHOT.vn
