12/09

Thứ Bảy · 4 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnXây dựng cầu nối đa ngôn ngữ: Tối ưu hóa dữ liệu để nâng cao khả năng suy luận của AI

Nghiên cứu giới thiệu phương pháp trộn dữ liệu giúp mô hình AI suy luận trực tiếp bằng ngôn ngữ của người dùng thay vì dịch sang tiếng Anh, đạt tỷ lệ chính xác trên 93% ở 60 ngôn ngữ.


Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề cốt lõi về sự thiên kiến tiếng Anh trong AI, mang tính ứng dụng cao cho người dùng toàn cầu và cung cấp giải pháp kỹ thuật cụ thể.

11/09

Thứ Sáu · 14 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 37/100

Vượt xa kiểm chứng: Mô hình phần thưởng tạo sinh cho toán học hình thức

Nghiên cứu chỉ ra lỗi VPU trong mô hình toán học hình thức, nơi mã nguồn sai vẫn vượt qua kiểm định. Tác giả chứng minh các phương pháp kiểm tra hiện tại về cơ bản không hiệu quả hơn việc đoán ngẫu nhiên.

Elvis Saravia@omarsar0
NgànhĐiểm AI 47/100

Sakana AI ra mắt Fugu Max và Fugu Ultra v2: Đột phá mới trong tối ưu hóa mô hình AI

I am extremely bullish on the Pareto frontier of collective intelligence. While everyone works on …

DịchSakana AI giới thiệu Fugu Max và Fugu Ultra v2, hai giải pháp tối ưu hóa giúp đạt hiệu suất đỉnh cao trong các tác vụ phức tạp với chi phí token cực thấp mà không cần phụ thuộc vào các mô hình ngoại lai.

OpenRouter@OpenRouter
Sản phẩmĐiểm AI 55/100

Mô hình Ling 3.0 Flash VL chính thức có mặt trên OpenRouter

Ling 3.0 Flash VL is live on OpenRouter, served by @novita_labs. A 124B MoE with 5.5B active params…

DịchLing 3.0 Flash VL, mô hình MoE 124B với khả năng xử lý hình ảnh và video chuyên sâu, đã được tích hợp lên OpenRouter thông qua Novita Labs. Người dùng hiện có thể trải nghiệm miễn phí các tính năng như suy luận hỗn hợp và gọi công cụ trực tiếp trên nền tảng.

IT Home
NgànhĐiểm AI 48/100

DeepSeek hủy bỏ kế hoạch khai tử API V4 Pro, tiếp tục duy trì dịch vụ

DeepSeek thông báo sẽ tiếp tục cung cấp API DeepSeek V4 Pro sau ngày 14/9 thay vì ngừng hoạt động như dự kiến trước đó, giữ nguyên mức giá cũ là 27 tệ/triệu token.

Diễn biến sự kiện · 8 bài →Thêm 3 nguồn khác đưa tinX: SiliconFlow (@SiliconFlowAI)X: Hongming (@hongming731)X: Tianyi Cui (@tianyi)
WeChat: Carl AI Watts
Hướng dẫnĐiểm AI 76/100

Đã có đại diệnTrải nghiệm thực tế DeepSeek V4.1 Flash: Giá rẻ bất ngờ, tích hợp thị giác, hiệu năng ấn tượng

DeepSeek V4.1 Flash giảm giá sâu tới 7 lần cho input cache và 2/3 cho output. Từ 14/9, mọi yêu cầu v4-pro sẽ tự động chuyển sang bản Flash với chi phí tối ưu hơn.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

NCP-ArchPreview: Bước tiến mới của mô hình ngôn ngữ thông qua dự đoán khái niệm (Next Concept Prediction)

NCP-ArchPreview giới thiệu phương pháp huấn luyện mới, kết hợp dự đoán token truyền thống với dự đoán khái niệm (NCP) để mô hình hiểu sâu hơn về cấu trúc ngôn ngữ. Với 8,9 tỷ tham số, mô hình này cho thấy tiềm năng lớn trong việc cải thiện khả năng suy luận và tạo văn bản.

Sakana AI: Blog (Web)
NgànhĐiểm AI 13/100

Cùng sự kiệnSakana AI ra mắt Fugu Max và Fugu Ultra v2: Đột phá trong tối ưu hóa hiệu suất mô hình

Sakana AI giới thiệu thế hệ mô hình Fugu mới, tập trung vào việc cân bằng tối ưu giữa hiệu suất và tài nguyên tính toán theo nguyên lý Pareto, mở ra khả năng ứng dụng linh hoạt hơn cho các tác vụ phức tạp.

Cùng sự kiện, bài đại diện «Sakana AI ra mắt Fugu Max và Fugu Ultra v2: Đột phá tối ưu chi phí cho điều phối đa mô hình»
Together AI Blog nghiên cứu và sản phẩm
Sản phẩmĐiểm AI 62/100

Tinh chọnTogether AI nâng cấp dịch vụ tinh chỉnh: Hỗ trợ mô hình mới và công cụ theo dõi thời gian thực

Together AI bổ sung hỗ trợ cho các dòng mô hình mới như GLM-5.3, Kimi K2.7 và Qwen 3.5, đồng thời tích hợp tính năng theo dõi thử nghiệm trực tiếp và kiểm soát dữ liệu chuyên sâu.


Vì sao đáng đọc: Cập nhật quan trọng cho cộng đồng phát triển AI, cung cấp công cụ thực tế giúp tối ưu hóa quy trình tinh chỉnh mô hình ngôn ngữ lớn.
Gabriel@gabriel1
Hướng dẫnĐiểm AI 59/100

Trải nghiệm thực tế: DeepSeek-V4.1-Flash trở thành trợ thủ đắc lực cho công việc tri thức

been running with deepseek as daily driver today for all my knowledge work it's extremely strong fo…

DịchDeepSeek-V4.1-Flash gây ấn tượng nhờ hiệu năng vượt trội, khả năng điều hướng trình duyệt xuất sắc và tốc độ xử lý nhanh. Đây là mô hình nhỏ gọn mới nhất của DeepSeek với khả năng hiểu hình ảnh gốc, tối ưu cho các tác vụ tự động hóa và công việc hàng ngày.

Artificial Analysis@ArtificialAnlys
Mô hìnhĐiểm AI 77/100

Cùng sự kiệnDeepSeek V4.1 Flash ra mắt: Vượt mặt bản Pro, thiết lập chuẩn mực mới cho dòng flagship

DeepSeek V4.1 Flash overtakes DeepSeek V4 Pro 0813 as DeepSeek's new flagship model with a score of …

DịchTheo đánh giá từ Artificial Analysis, DeepSeek V4.1 Flash đạt 40 điểm trên Intelligence Index, chính thức trở thành flagship mới của DeepSeek với cấu trúc 8B/16B và hỗ trợ cửa sổ ngữ cảnh lên tới 1 triệu token.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»

10/09

Thứ Năm · 21 tin
Elvis Saravia@omarsar0
Sản phẩmĐiểm AI 61/100

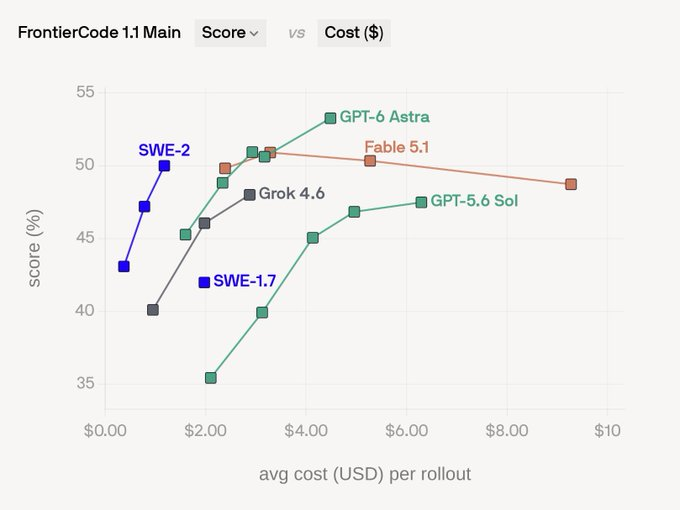
Cognition ra mắt SWE-2: Hiệu năng tiệm cận mô hình đầu bảng với chi phí giảm tới 70%

Just amazed by how specialized models keep pushing the Pareto frontier. Just watch that massive co…

DịchCognition vừa trình làng SWE-2, mô hình đạt điểm số ấn tượng trên FrontierCode 1.1 với chi phí vận hành thấp hơn 64-70% so với các đối thủ hàng đầu nhờ ứng dụng kỹ thuật học tăng cường (RL) quy mô lớn.

Elvis Saravia@omarsar0
Mô hìnhĐiểm AI 65/100

DeepSeek ra mắt DeepSeek-V4.1-Flash: Mô hình nhỏ gọn, hiệu năng vượt trội với trọng số mở

Another goated release by DeepSeek. Open weight, btw. Outperforms Opus 5 on key benchmarks, btw. L…

DịchDeepSeek vừa trình làng DeepSeek-V4.1-Flash, mô hình nhỏ nhất trong kiến trúc mới với khả năng hiểu thị giác nguyên bản, tối ưu tốc độ suy luận và chi phí, đồng thời vượt qua Opus 5 trên nhiều tiêu chuẩn quan trọng.

The Decoder: AI News
Mô hìnhĐiểm AI 79/100

Đã có đại diệnDeepSeek ra mắt V4.1-Flash: Đột phá giảm bộ nhớ KV cache cho AI Agent

DeepSeek vừa phát hành mô hình đa phương thức V4.1-Flash theo giấy phép MIT trên Hugging Face, tập trung tối ưu hóa chi phí xử lý ngữ cảnh dài và nén bộ nhớ KV cache cho các tác vụ AI Agent.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
IT Home
Mô hìnhĐiểm AI 58/100

Cùng sự kiệnDeepSeek V4.1 Flash chính thức cập bến hạ tầng Siêu máy tính Quốc gia

Mô hình MoE 552B tham số DeepSeek V4.1 Flash đã được tích hợp vào mạng lưới siêu máy tính quốc gia, cho phép người dùng truy cập API với hiệu suất vượt trội so với phiên bản Pro.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
Kim@kimmonismus
Mô hìnhĐiểm AI 78/100

Cùng sự kiệnDeepSeek ra mắt V4.1-Flash: Kiến trúc mới hỗ trợ thị giác và giảm giá sâu

Whats really exciting about DeepSeek 4.1 Flash its insane efficiency and pricing. It matches or be…

DịchDeepSeek trình làng V4.1-Flash với kiến trúc Causal Encoder-Decoder đột phá, tích hợp khả năng hiểu thị giác nguyên bản cùng hiệu suất tối ưu nhờ mô hình 552B MoE.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
ModelBest OpenBMB@OpenBMB
Mô hìnhĐiểm AI 56/100

Cùng sự kiệnMiniCPM5-2B của OpenBMB dẫn đầu bảng xếp hạng Hugging Face và công khai toàn bộ tài nguyên huấn luyện

🚀MiniCPM5-2B hits #1 on @huggingface Trending! 🏆 Huge thanks to the community for the incredible s…

DịchMô hình MiniCPM5-2B của OpenBMB vừa chiếm lĩnh vị trí số 1 trên bảng xếp hạng xu hướng Hugging Face và dẫn đầu nhóm mô hình dưới 4 tỷ tham số trên Artificial Analysis Intelligence Index.

Cùng sự kiện, bài đại diện «MiniCPM-2B của OpenBMB dẫn đầu bảng xếp hạng Hugging Face, thống trị phân khúc mô hình dưới 4B tham số»
Kim@kimmonismus
Mô hìnhĐiểm AI 79/100

Cùng sự kiệnDeepSeek ra mắt V4.1-Flash: Kiến trúc Causal Encoder-Decoder mới với khả năng hiểu thị giác

DeepSeek just released V4.1-Flash with a new architecture, six weeks after its July V4-Flash update….

DịchDeepSeek giới thiệu V4.1-Flash, mô hình MoE 552B tham số tối ưu hóa hiệu suất với kiến trúc mới, giúp giảm đáng kể yêu cầu bộ nhớ KV cache và chi phí API trong khi vẫn hỗ trợ xử lý hình ảnh trực tiếp.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
Thomas Wolf (Hugging Face đồng sáng lập/CSO)@Thom_Wolf
Mô hìnhĐiểm AI 73/100

Cùng sự kiệnDeepSeek-V4.1-Flash ra mắt: Bước tiến mới về tốc độ và khả năng thị giác

don't get distracted by all the hedging words in its name ("flash", minor version): seems like DeepS…

DịchDeepSeek vừa trình làng V4.1-Flash, mẫu model nhỏ gọn nhất trong kiến trúc mới với khả năng hiểu thị giác nguyên bản, tối ưu hóa cho tốc độ suy luận vượt trội và hiệu suất cao.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
WeChat: ModelBest (MiniCPM)
Mô hìnhĐiểm AI 53/100

MiniCPM5-2B của ModelBest dẫn đầu xu hướng Hugging Face, công khai trọng số và dữ liệu huấn luyện

Mô hình MiniCPM5-2B của ModelBest vừa chiếm lĩnh vị trí dẫn đầu trên Hugging Face Trending, đồng thời đạt điểm số ấn tượng 53.9 trên 34 tiêu chuẩn đánh giá, khẳng định vị thế số 1 thế giới trong phân khúc mô hình mở dưới 4B tham số.

Testing Catalog@testingcatalog
NgànhĐiểm AI 42/100

Cùng sự kiệnDeepSeek V4.1 Flash ra mắt với 552 tỷ tham số; Apple trình làng iPhone Duo màn hình gập

DAILY AI BRIEF 🗞 - Sept 10 APPLE 🔥: - iPhone Duo, first foldable. Starts at $1, 999. Ships Oct 23….

DịchDeepSeek giới thiệu mô hình V4.1 Flash hỗ trợ thị giác nguyên bản, trong khi Apple gây chú ý với iPhone Duo màn hình gập và dòng iPhone 18 Pro tích hợp chip A20 Pro tối ưu cho AI tại thiết bị.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
Deedy Das@deedydas
Hướng dẫnĐiểm AI 68/100

DeepSeek V4.1 Flash: 'Vua' mã nguồn mở mới vượt mặt GLM 5.3 và Kimi K3

DeepSeek might be the new king of open-source models. It obliterates GLM 5.3 and Kimi K3 on benchmar…

DịchNhà đầu tư Deedy Das đánh giá DeepSeek V4.1 Flash vượt trội hơn GLM 5.3 và Kimi K3 trong các bài kiểm tra, với chi phí rẻ hơn 4-10 lần. Đặc biệt, mô hình đạt 3471 điểm trên Codeforces, là lựa chọn tối ưu cho các startup phát triển sản phẩm lập trình.

Aravind Srinivas (Perplexity CEO)@AravSrinivas
Mô hìnhĐiểm AI 61/100

Cùng sự kiệnDeepSeek ra mắt DeepSeek-V4.1-Flash: Mô hình nhỏ gọn tích hợp khả năng thị giác máy tính

DeepSeek vừa giới thiệu DeepSeek-V4.1-Flash, mô hình nhỏ nhất trong kiến trúc mới với tốc độ suy luận vượt trội và khả năng hiểu hình ảnh trực tiếp, đạt kết quả ấn tượng trên nhiều bài kiểm tra kỹ thuật.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
DeepSeek@deepseek_ai
Mô hìnhĐiểm AI 56/100

Cùng sự kiệnDeepSeek ra mắt DeepSeek-V4.1-Flash: Model nhỏ gọn nhất với khả năng hiểu thị giác nguyên bản

🚀 Introducing DeepSeek-V4.1-Flash: smarter, faster, more efficient. 🔹 Introducing the smallest mo…

DịchDeepSeek vừa giới thiệu DeepSeek-V4.1-Flash, thành viên mới nhất trong dòng kiến trúc tối ưu hóa với kích thước nhỏ gọn, tích hợp sẵn khả năng xử lý và hiểu hình ảnh trực tiếp.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
IT Home
Mô hìnhĐiểm AI 86/100

Cùng sự kiệnDeepSeek ra mắt mô hình V4.1 Flash: Hiệu năng vượt trội bản Pro với chi phí API rẻ hơn

DeepSeek vừa trình làng V4.1 Flash, mô hình MoE 552 tỷ tham số với kiến trúc Causal-Encoder-Decoder mới, hỗ trợ đa phương thức và đạt kết quả benchmark ấn tượng hơn cả bản V4 Pro.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt V4.1-Flash: Mô hình đa phương thức nhỏ gọn với giá API siêu rẻ»
Tianyi Cui@tianyi
NgànhĐiểm AI 38/100

Cùng sự kiệnDeepSeek Harness v0.1.5 ra mắt: Tối ưu hóa sâu cho mô hình V4.1 Flash

Phiên bản DeepSeek Harness v0.1.5 mang đến sự tối ưu hóa chuyên sâu cho mô hình V4.1 Flash cùng tính năng thử nghiệm 'Agent Teams' với triết lý mọi thứ đều là plugin.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
IT Home
Mô hìnhĐiểm AI 67/100

Cùng sự kiệnDeepSeek ra mắt mô hình V4.1 Flash, lùi lịch ngừng hỗ trợ V4 Pro sang ngày 14/9

DeepSeek chính thức phát hành mô hình V4.1 Flash với cơ chế định giá mới. Dịch vụ V4 Pro sẽ được duy trì đến trưa ngày 14/9 trước khi chuyển hướng hoàn toàn sang V4.1 Flash.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt V4.1-Flash: Mô hình đa phương thức nhỏ gọn với giá API siêu rẻ»
Tang Jie@jietang
NgànhĐiểm AI 28/100

Giáo sư Đường Kiệt: Quy mô tối ưu của mô hình AI không chỉ nằm ở số lượng tham số

Are you sure? Finding the optimal model size is tricky: data volume, active parameter count, the num…

DịchGiáo sư Đường Kiệt nhận định việc xác định quy mô mô hình cần cân bằng giữa dữ liệu, chi phí suy luận và hiệu năng. Ông cũng tiết lộ các mô hình như Fable hay Kimi K3 có số lượng tham số thực tế thấp hơn nhiều so với các đồn đoán trước đó.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

DATPO: Tối ưu hóa chính sách dạng cây thích ứng độ khó để mở rộng khả năng suy luận trong RLVR

Nghiên cứu giới thiệu DATPO, phương pháp tối ưu hóa cấu trúc suy luận dạng cây giúp tăng cường độ đa dạng ngữ nghĩa và khả năng giải quyết vấn đề của các mô hình AI thông qua học tăng cường có thưởng (RLVR).

Charlie Holtz@charlieholtz
NgànhĐiểm AI 33/100

Ra mắt bộ chọn mô hình AI mới: Quản lý tác vụ thông minh như chơi Minecraft

We built a new model picker! It's like Minecraft inventory slots for your models. Create a roster…

DịchCông cụ mới cho phép bạn tạo danh sách các mô hình AI yêu thích với nhiều chế độ tốc độ và hiệu suất khác nhau, giúp chuyển đổi linh hoạt mà không cần dùng chuột.

Artificial Analysis@ArtificialAnlys
NgànhĐiểm AI 30/100

Ba mô hình AI mới thiết lập chuẩn mực mới về hiệu suất và chi phí

Last week the Intelligence Index vs Cost Pareto frontier moved out substantially. Claude Fable 5.1, …

DịchCác mô hình Claude Fable 5.1, Muse Spark 1.3 và GPT-6 Astra vừa tạo ra bước ngoặt lớn, tối ưu hóa đáng kể tỷ lệ giữa trí thông minh và chi phí vận hành trên thị trường.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 57/100

Thực nghiệm suy luận: Qwen3.8 đạt độ tương đồng 18,18% với GPT-5.5 Pro nhờ kỹ thuật tiền nạp

Tác giả sử dụng GPT-5.5 Pro làm mô hình giáo viên để thực hiện kỹ thuật tiền nạp (pre-filling) 1% dữ liệu suy luận vào Qwen3.8, kết quả cho thấy độ tương đồng câu trả lời tăng đáng kể trên 45 bài kiểm tra.

09/09

Thứ Tư · 20 tin
Cognition Mô hình / Devin Blog (Web)
Mô hìnhĐiểm AI 70/100

Tinh chọnCognition ra mắt mô hình lập trình SWE-2: Hiệu năng tiệm cận đỉnh cao với chi phí tối ưu

Cognition giới thiệu SWE-2, mô hình lập trình dựa trên Kimi K33, đạt 50% điểm số trên FrontierCode 1.1. Dù hiệu năng gần bằng Fable 5.1, SWE-2 giúp tiết kiệm tới 64% chi phí vận hành.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong việc tối ưu hóa chi phí cho các tác nhân AI lập trình, thu hút sự quan tâm lớn từ cộng đồng kỹ thuật và doanh nghiệp.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (55 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Mô hình ngôn ngữ” — Trang 6 | AIHOT.vn