21/09

Thứ Hai · 14 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Cal-OPD: Tối ưu hóa chưng cất mô hình thông qua hiệu chỉnh sai lệch giữa giáo viên và học sinh

Cal-OPD giải quyết vấn đề mô hình học sinh vô tình học phải các sai lệch nội tại của giáo viên trong quá trình chưng cất (distillation), bằng cách tách biệt và loại bỏ các nhiễu này để cải thiện khả năng suy luận.
AI Notes@AYi_AInotes
Quan điểmĐiểm AI 58/100

Giải mã Jev: Tại sao mô hình ra quyết định kiểu 'Strongly Typed' lại vượt trội hơn tạo văn bản dài?

Bài viết phân tích mô hình Jev, giải pháp thay thế việc tạo văn bản tự hồi quy tốn kém bằng cách chuyển đổi logic ra quyết định thành các trạng thái đầu vào và tùy chọn xác định, giúp tối ưu hóa chi phí và độ trễ.

20/09

Chủ Nhật · 2 tin
ModelBest OpenBMB@OpenBMB
Hướng dẫnĐiểm AI 32/100

Tối ưu hóa mô hình nhỏ: Quy trình chạy OpenClaw và Ollama hoàn toàn trên CPU

This is a really practical way to use a small local model. Also pretty impressive that the whole pip…

DịchKhám phá cách vận hành các mô hình AI nhỏ hiệu quả ngay trên máy tính cá nhân. Sự kết hợp giữa OpenClaw và Ollama cho phép chạy mượt mà chỉ bằng CPU, chứng minh rằng thiết kế luồng công việc thông minh có thể nâng cao đáng kể sức mạnh của các mô hình quy mô nhỏ.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 51/100

MIT và Sakana AI giới thiệu SIFT: Khung tìm kiếm cây giúp tối ưu chi phí cho AI tự lập trình

Recommend read. Love this new arc toward more affordable, more efficient self-improving coding agent…

DịchSIFT sử dụng LLM để đánh giá và chọn lọc các hướng phát triển tiềm năng trước khi thực thi, giúp giảm đáng kể chi phí vận hành cho các tác nhân AI tự cải tiến mã nguồn.

19/09

Thứ Bảy · 12 tin
Elvis Saravia@omarsar0
Sản phẩmĐiểm AI 32/100

Jev: Bước tiến mới trong việc tối ưu hóa trải nghiệm và hiệu suất cho AI Agent

Been integrating Jev into my custom harness. I couldn't be more excited about the results I am seei…

DịchElvis Saravia chia sẻ cách Jev giúp các AI Agent vượt qua rào cản về chi phí và độ trễ, mở ra khả năng ứng dụng trong quy trình làm việc phức tạp, kiểm soát luồng dữ liệu và tạo lập dữ liệu chất lượng cao.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 34/100

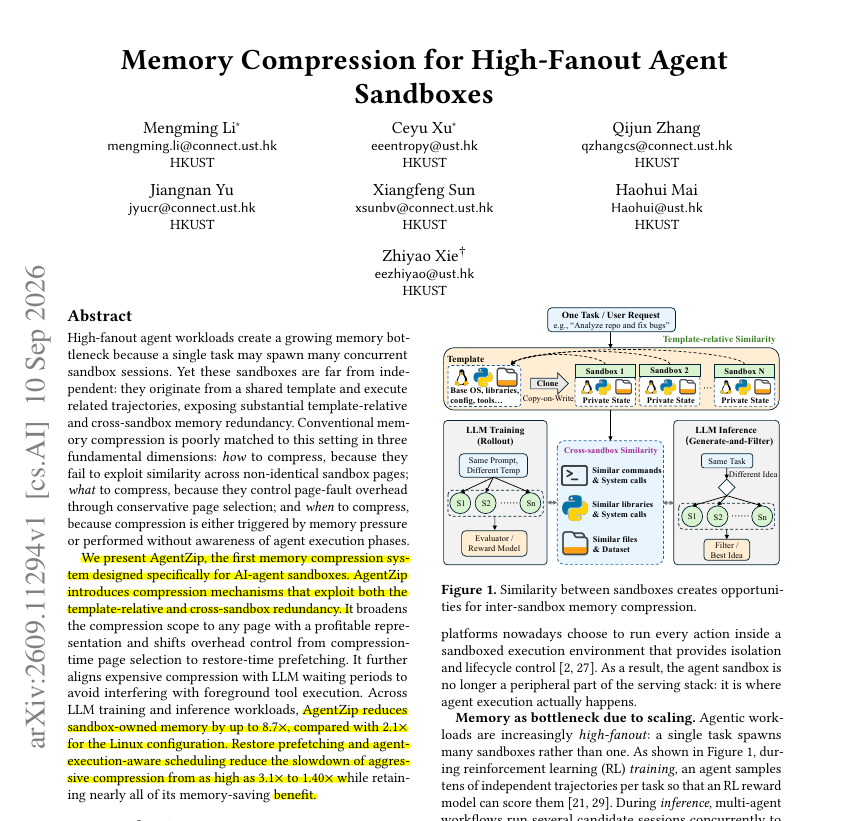
AgentZip: Giải pháp nén bộ nhớ dùng chung cho các tác nhân AI chạy song song

If 1 agent task launches many sandboxes, manage their memory together AgentZip shows that much of t…

DịchAgentZip tối ưu hóa hiệu suất bằng cách nén các dữ liệu trùng lặp trong bộ nhớ giữa các sandbox tác nhân AI. Công nghệ này giúp giảm tới 88,55% dung lượng bộ nhớ dư thừa khi chạy nhiều tác nhân từ cùng một khuôn mẫu, đặc biệt hiệu quả trong thời gian chờ phản hồi từ LLM.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 50/100

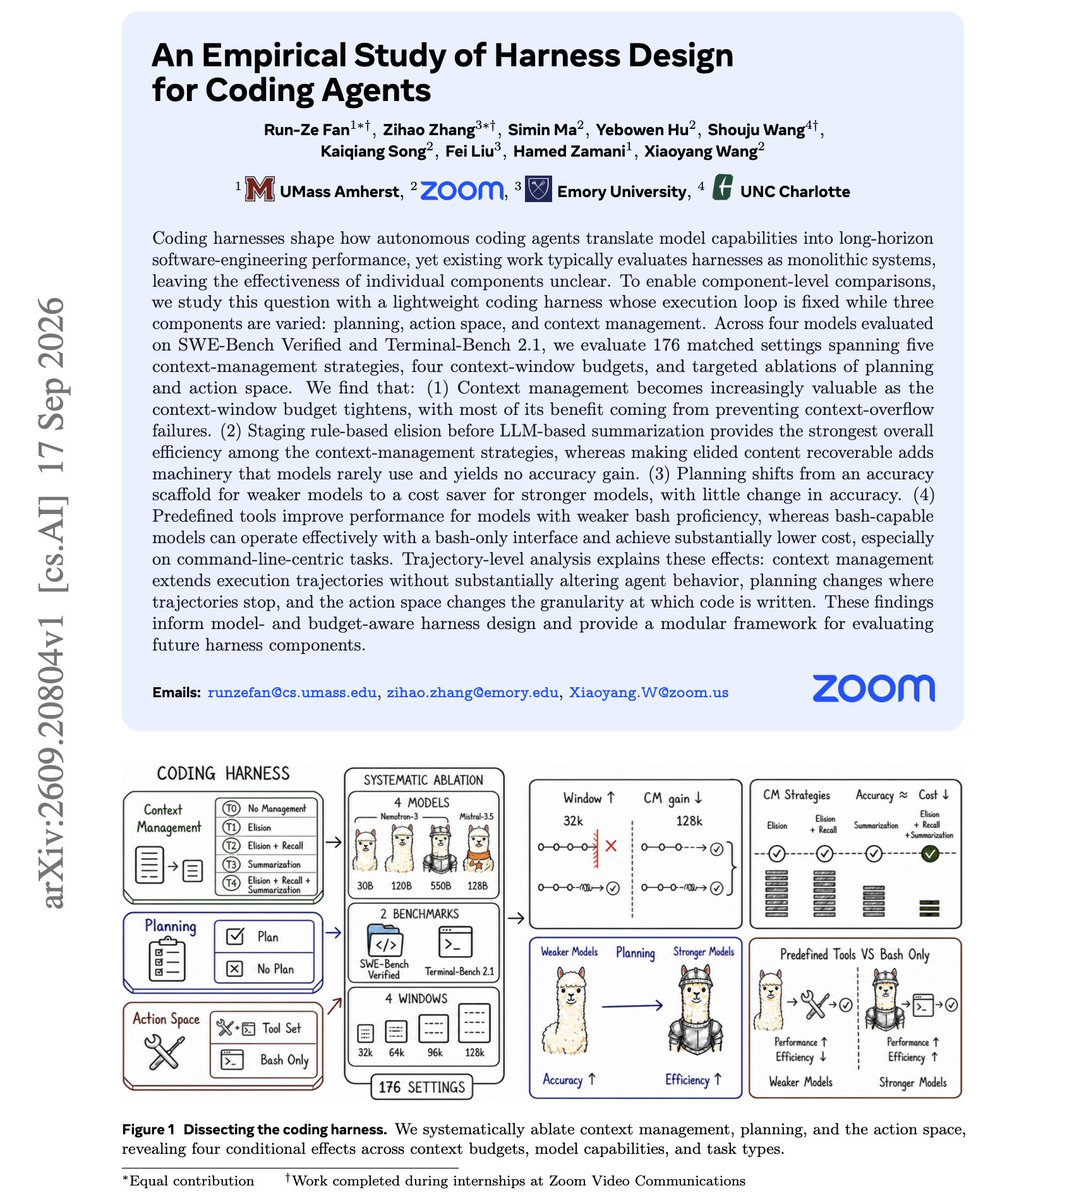
Nghiên cứu thực nghiệm từ Zoom: Tối ưu hóa thiết kế cho các tác nhân AI lập trình

Super interesting work from Zoom and colleagues. If you maintain a hand-built coding harness, there…

DịchĐội ngũ Zoom đã thực hiện thử nghiệm trên 176 cấu hình và 4 mô hình khác nhau, sử dụng SWE-Bench Verified và Terminal-Bench 2.1 để đánh giá tác động của việc lập kế hoạch, không gian hành động và quản lý ngữ cảnh đối với hiệu suất của các tác nhân AI lập trình.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 48/100

Cùng sự kiệnNVIDIA ra mắt SoL-Pi: Khung tác nhân tự tiến hóa giúp cắt giảm 50% lượng token

Build your own harness, folks. This is absolute banger paper from NVIDIA on self-evolving agent har…

DịchNVIDIA giới thiệu SoL-Pi, khung tác nhân tự tiến hóa sử dụng cơ chế sàng lọc qua nhiều môi trường, giúp giảm một nửa lượng token tiêu thụ mà vẫn duy trì hiệu suất tương đương các mô hình hàng đầu.

Cùng sự kiện, bài đại diện «NVIDIA và MIT ra mắt SoL-Pi: Tối ưu hóa Agent tự động giúp cắt giảm 50% lượng Token tiêu thụ»
Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 55/100

EvoSkill v2: Giúp AI tự nâng cấp kỹ năng mà không cần huấn luyện lại

Agents can self-improve without retraining. EvoSkill v2 achieves this with persistent agent skills….

DịchEvoSkill v2 cho phép các Agent tự học và lưu trữ kỹ năng mới vào tệp tin sau mỗi lần thất bại. Khi gặp tác vụ tương tự, Agent sẽ tự động tải các kỹ năng này để tối ưu hiệu suất mà không cần thay đổi trọng số mô hình.

18/09

Thứ Sáu · 17 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Không chỉ là số lượng: Chiến lược tạo ứng viên ảnh hưởng đến hiệu suất và năng lượng của LLM

Nghiên cứu chỉ ra rằng việc tăng số lượng phản hồi (N) giúp cải thiện khả năng suy luận của LLM, nhưng cách thức thực thi (batching) mới là yếu tố quyết định đến chi phí năng lượng và hiệu suất hệ thống.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnTPAMI 2026: PolaFormer++ nâng tầm cơ chế chú ý tuyến tính với tính toán phân cực và độ nhọn cấp kênh

PolaFormer++ cải tiến cơ chế chú ý tuyến tính bằng cách tối ưu hóa ánh xạ đặc trưng thông qua tính toán phân cực và độ nhọn cấp kênh, giúp đạt hiệu suất vượt trội trên nhiều tác vụ thị giác máy tính.


Vì sao đáng đọc: Nghiên cứu được đăng trên tạp chí uy tín TPAMI, giải quyết bài toán cốt lõi về hiệu suất của Transformer, có mã nguồn mở và tính ứng dụng cao trong xử lý dữ liệu lớn.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

Khi token kết thúc không đồng nhất: Giải mã hiện tượng 'phình' độ dài trong chưng cất chính sách trực tuyến

Nghiên cứu chỉ ra rằng sự lệch pha giữa token kết thúc (EOS) của mô hình giáo viên và học sinh trong chưng cất chính sách trực tuyến (OPD) khiến mô hình phản hồi quá dài hoặc cạn kiệt tài nguyên tính toán.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

RetireOPD: Phương pháp chưng cất chính sách tự động giải phóng cho tác nhân học tăng cường

RetireOPD giới thiệu cơ chế tự động loại bỏ giáo viên khi học sinh đạt ngưỡng hiệu suất, giúp tối ưu hóa quá trình huấn luyện tác nhân thông qua việc kết hợp học tăng cường và chưng cất chính sách.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 33/100

CMU và Oxford giới thiệu 'Looped Flows': Giúp mô hình nhỏ suy luận sâu hơn mà không cần kéo dài chuỗi tư duy

New Carnegie Mellon + Oxford Univ paper shows a model can "think longer" by repeatedly improving hid…

DịchCác nhà nghiên cứu đề xuất phương pháp 'Looped Flows', cho phép mô hình cải thiện trạng thái ẩn thay vì tạo thêm token dài dòng. Kỹ thuật này giúp các mô hình nhỏ đạt độ chính xác cao hơn thông qua các bước lặp suy luận, tối ưu hóa hiệu suất tính toán khi kiểm thử.

WeChat: Khazix
Hướng dẫnĐiểm AI 67/100

Tinh chọnTypeSafe AI ra mắt Jev: Mô hình chuyên biệt cho quyết định tần suất cao, nhanh gấp 200 lần

Jev là mô hình AI chuyên xử lý các quyết định logic thay vì tạo văn bản, giúp tăng tốc độ xử lý gấp 20-200 lần với chi phí cực thấp. Kết quả thực tế cho thấy Jev đạt hiệu suất vượt trội trong các tác vụ phân loại và sàng lọc dữ liệu song song.


Vì sao đáng đọc: Đây là hướng đi mới thú vị khi tối ưu hóa AI cho các tác vụ logic cụ thể thay vì chatbot, rất hữu ích cho các nhà phát triển cần hiệu năng cao và chi phí thấp.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 41/100

Mô hình ngôn ngữ tham số vô hạn: Tạo và điều chỉnh trọng số từ dữ liệu thời gian thực

Nghiên cứu giới thiệu Infinite-Parameter LLM, sử dụng siêu mạng để tạo trọng số từ dữ liệu thực tế thay vì lưu trữ cố định. Phương pháp này giúp mô hình liên tục cập nhật kiến thức vào trọng số, tối ưu hóa bộ nhớ và duy trì thông tin xuyên suốt các phiên hội thoại.

OpenAI Developers@OpenAIDevs
Sản phẩmĐiểm AI 30/100

Codex ra mắt bảng điều khiển phân tích mức sử dụng mới

Get more visibility into your usage. See how tasks, subagents, and individual chats contribute to y…

DịchNgười dùng hiện có thể theo dõi chi tiết mức tiêu thụ tài nguyên từ các tác vụ, tác nhân phụ và từng cuộc hội thoại, giúp tối ưu hóa quy trình làm việc hiệu quả hơn.

Anthropic@AnthropicAI
Hướng dẫnĐiểm AI 52/100

Anthropic tối ưu hóa 30+ mô hình sinh học mã nguồn mở, tăng tốc độ suy luận gấp 4 lần

Biologists use specialized open-source models for tasks like modeling the structure of molecular sys…

DịchAnthropic vừa công bố các kỹ thuật tối ưu hóa GPU giúp tăng tốc độ suy luận cho hơn 30 mô hình sinh học mã nguồn mở trong lĩnh vực thiết kế thuốc và dự đoán gen. Toàn bộ mã nguồn tối ưu đã được chia sẻ công khai để cộng đồng nghiên cứu ứng dụng.

Emad Mostaque@EMostaque
Mô hìnhĐiểm AI 56/100

Cactus ra mắt Needle 3: Mô hình nền tảng siêu nhẹ, chuyên biệt cho gọi hàm

Who need words any more Words are just human kludge AI don't need no words

DịchCactus Compute vừa trình làng Needle 3, mô hình nền tảng tự động hóa với dung lượng chỉ từ 8-29MB nhưng sở hữu khả năng gọi hàm thuần túy, được kỳ vọng cạnh tranh trực tiếp với DeepSeek V4 Flash.

Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 21/100

Khám phá 4 ứng dụng đột phá của mô hình Jev trong hệ thống AI Agent

Things to try with Jev right now: 1. LLM-as-a-Judge evaluation 2. Routing for agent harnesses harne…

DịchElvis Saravia từ DAIR.AI chia sẻ 4 hướng ứng dụng của Jev, từ đánh giá LLM đến điều phối agent thông minh. Trong đó, việc dùng Jev làm bộ định tuyến (router) cho các meta-harness đang mang lại hiệu quả chi phí vượt trội.

Aravind Srinivas (Perplexity CEO)@AravSrinivas
Sản phẩmĐiểm AI 38/100

Perplexity Computer ra mắt tính năng kiểm soát 'nỗ lực' (effort) cho AI

Computer is the best multi model harness for long horizon agentic workloads. It now has a few preset…

DịchPerplexity vừa bổ sung tùy chọn kiểm soát mức độ nỗ lực cho Computer, cho phép người dùng tùy chỉnh độ sâu và hiệu suất xử lý của mô hình AI. Tính năng này giúp tối ưu hóa các tác vụ phức tạp và hiện đã có mặt trên nền tảng web.

17/09

Thứ Năm · 18 tin
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 64/100

Zhipu AI tối ưu hạ tầng suy luận với GLM-5.3: Tăng tốc độ xử lý lên gấp 3 lần

A brilliant post from the GLM-5.3 team on RSI (recursive self-improvement). GLM-5.3 was already use…

DịchĐội ngũ Zhipu AI chia sẻ quy trình tối ưu hóa hạ tầng cho GLM-5.3-Flash, giúp đạt hiệu suất sản xuất chỉ trong hai tuần với tốc độ xử lý (throughput) tăng gấp 3 lần so với ban đầu.

Thêm 1 nguồn khác đưa tinX: Kim (@kimmonismus)
Kim@kimmonismus
Mô hìnhĐiểm AI 49/100

Cùng sự kiệnZhipu AI: GLM-5.3 tự tối ưu hóa hạ tầng suy luận, tăng gấp 3 lần hiệu suất

While the US is discussing a slowdown, China is currently putting full force into its RSI. Zai says…

DịchZhipu AI cho biết mô hình GLM-5.3 đã hỗ trợ kỹ sư tối ưu hóa hạ tầng suy luận, giúp tăng gấp 3 lần lưu lượng xử lý chỉ trong hai tuần nhờ quy trình phản hồi liên tục. Đây được xem là bước tiến quan trọng hướng tới khả năng tự cải tiến đệ quy của các thế hệ AI tương lai.

Cùng sự kiện, bài đại diện «Zhipu AI tối ưu hạ tầng suy luận với GLM-5.3: Tăng tốc độ xử lý lên gấp 3 lần»
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (49 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Tối ưu hóa” — Trang 3 | AIHOT.vn