PAWBench là bộ tiêu chuẩn mới giúp kiểm tra xem các mô hình tạo video có thể tái tạo chính xác phân phối xác suất của hành vi vật lý hay không, thay vì chỉ tạo ra các video đơn lẻ hợp lý. Kết quả cho thấy các mô hình hiện nay vẫn chưa đạt được độ chính xác cần thiết.
Nghiên cứu mới sử dụng khung tự đối kháng đa ngôn ngữ để chỉ ra rằng LLM thể hiện trình độ tư duy và chiến lược khác biệt đáng kể tùy theo ngôn ngữ sử dụng, đặt ra thách thức lớn cho việc phát triển các mô hình đa ngôn ngữ thực thụ.
FIRM-Video giới thiệu quy trình đánh giá video mới bằng cách kiểm tra các tiêu chí cụ thể trước khi chấm điểm, giúp tăng độ chính xác và tính minh bạch cho các mô hình AI tạo video.
Nghiên cứu chỉ ra rằng khả năng trả lời câu hỏi trực tiếp không phản ánh đúng sự hài lòng của người dùng. MemUse đề xuất phương pháp đánh giá mới dựa trên cách AI tích hợp ngữ cảnh quá khứ một cách tự nhiên vào hội thoại.
GLM-5.3-Flash đạt 57 điểm trên Artificial Analysis, vượt xa mức trung bình 18 của các mô hình cùng phân khúc. Với cửa sổ ngữ cảnh 400k tokens và khả năng xử lý đa phương thức, đây là lựa chọn đáng chú ý về hiệu năng và giá thành.
Glean has published a Pareto frontier analysis of 37 models and reasoning configurations across 1, 00…
DịchGlean đã đánh giá 37 mô hình AI qua 1.000 tác vụ doanh nghiệp, phát hiện sự chênh lệch chi phí lên tới 36 lần nhưng chất lượng chỉ cải thiện 22%, giúp doanh nghiệp tối ưu hóa lựa chọn mô hình.
GitHub tiết lộ quy trình đánh giá LLM tập trung vào hiệu suất thực tế thay vì chỉ dựa vào các bộ điểm chuẩn, giúp đảm bảo khả năng nhận diện thông tin nhạy cảm trong môi trường vận hành thực tế.
MobilePA-Bench là bộ tiêu chuẩn tương tác mới giúp đánh giá khả năng lập kế hoạch và sử dụng công cụ của các tác nhân AI trên di động thông qua 212 công cụ thực tế. Kết quả cho thấy các mô hình ngôn ngữ lớn hiện nay vẫn gặp khó khăn khi xử lý các ràng buộc phức tạp và lỗi vận hành.
Task-CoEvolve giới thiệu phương pháp tối ưu hóa harness cho LLM bằng cách cho phép các tác vụ kiểm chứng cùng tiến hóa, giúp giảm 80% chi phí đánh giá mà vẫn duy trì độ chính xác tương đương với bộ dữ liệu đầy đủ.
You can now benchmark Qwen3.8 27B with Optima. See how a model that can run on your laptop compares …
DịchBạn có thể sử dụng Optima để đánh giá hiệu suất, chi phí và tốc độ của mô hình Qwen2.5 27B trên các tác vụ thực tế ngay trên máy tính cá nhân. Artificial Analysis cũng cung cấp hỗ trợ tư vấn và tín dụng miễn phí cho các doanh nghiệp muốn xây dựng bộ kiểm thử riêng.
FlavourBench là bộ tiêu chuẩn đánh giá tự động mới, sử dụng hệ thống ẩm thực có thể thực thi để đo lường khả năng tư duy logic và sáng tạo của 27 mô hình ngôn ngữ lớn thông qua các bài toán phối hợp nguyên liệu.
TRACES là bộ benchmark tiên phong được thiết kế để kiểm chứng khả năng suy luận và quy trình kiểm toán trong các mô hình AI hướng tới trí tuệ khám phá.
OpenRouter vừa giới thiệu Visual Image Benchmarks, cho phép người dùng so sánh hiệu năng của 39 mô hình tạo ảnh qua 7 tiêu chí khắt khe như khả năng đếm, xử lý văn bản và logic không gian.
Nghiên cứu mới chỉ ra rằng các mô hình ASR hàng đầu có xu hướng 'học vẹt' văn bản tham chiếu thay vì thực sự hiểu âm thanh, dẫn đến điểm số ảo dù dữ liệu đầu vào bị nhiễu hoặc thiếu hụt.
MemTrapBench giải quyết lỗ hổng trong việc đánh giá cách bộ nhớ làm sai lệch khả năng suy luận của LLM. Nghiên cứu chỉ ra rằng các phương pháp ghi nhớ hiện tại thường gây tác dụng ngược, đồng thời giới thiệu AdaptiveMem giúp tối ưu hóa hiệu suất mà không mắc phải các bẫy nhận thức này.
Finally a good paper testing whether memory-based self-improving agents actually improve. The re-ev…
DịchNghiên cứu chỉ ra rằng sự cải thiện của các tác nhân AI dựa trên bộ nhớ chủ yếu đến từ thứ tự nhiệm vụ và nhiễu đánh giá thay vì khả năng tự học thực sự. Khi kiểm soát các yếu tố này, hiệu suất của mô hình giảm đáng kể, đặt ra dấu hỏi về tính hiệu quả của các phương pháp hiện tại.
What % of global AI token spend do you think is people running evals?
DịchLogan Kilpatrick đặt ra câu hỏi thú vị về tỷ trọng thực tế của chi phí token dành cho các tác vụ đánh giá (evals) trong tổng ngân sách chi tiêu cho AI toàn cầu hiện nay.
I think the RAM score @xeophon and I made for ATOM work is a really solid metric. If I just rank by …
DịchRAM Score là chỉ số mới giúp đo lường hiệu suất tải xuống của các mô hình AI dựa trên tỷ lệ so sánh với top 10 mô hình cùng phân khúc. Đây là công cụ hữu ích để nhận diện các mô hình tiềm năng, đặc biệt là với các dòng có quy mô từ 50 tỷ tham số trở lên.
HarnessRisk cung cấp khung đánh giá an toàn 6 giai đoạn với 128 kịch bản thử nghiệm, tiết lộ lỗ hổng nghiêm trọng trong cấu hình AI Agent khi tỷ lệ tấn công thành công lên tới 80,9%.
HarmProfile là bộ dữ liệu chuẩn mới giúp phân tích sâu sắc các lỗi bảo mật của 23 mô hình LLM hàng đầu, cho phép đánh giá rủi ro thông qua nội dung và mức độ nghiêm trọng của các phản hồi độc hại.
This 3D coding test by @thehypedotnews found DeepSeek-V4-Pro-0813 used 48X more tokens than Muse Spa…
DịchTrong thử nghiệm xây dựng 3D, DeepSeek-V4-Pro-0813 tiêu tốn hơn 20 triệu token, gấp 48 lần so với Muse Spark 1.2, với chi phí 4,57 USD và thời gian xử lý hơn 91 phút.
Nghiên cứu chỉ ra rằng các bài kiểm tra trắc nghiệm thường bị nhiễu do thứ tự đáp án, và việc loại bỏ nhãn lựa chọn không giúp cải thiện độ chính xác thực tế của mô hình.
Nghiên cứu này kiểm chứng liệu LLM có thực sự thay thế được con người trong khảo sát tâm lý học hay không, bằng cách so sánh dữ liệu mô phỏng với dữ liệu thực tế trên 37 mô hình khác nhau.
Prior Labs giới thiệu hệ sinh thái mã nguồn mở gồm RelArena-α (khung đánh giá), TabPFN-Rel (mô hình hiệu suất cao) và RPI (giao diện linh hoạt) nhằm chuẩn hóa và thúc đẩy nghiên cứu trong lĩnh vực học máy quan hệ.
TRACE-Bench phân tách quá trình tạo ảnh từ nhiều tham chiếu thành 4 thao tác cơ bản, giúp chỉ ra rằng các mô hình AI hiện nay vẫn gặp khó khăn lớn trong việc tách biệt và gán thuộc tính chính xác.
R^3-Bench là bộ tiêu chuẩn mới đánh giá khả năng suy luận toán học và lập trình của LLM khi phải phân bổ tài nguyên hạn chế. Kết quả cho thấy các mô hình hiện nay vẫn gặp khó khăn trong việc tối ưu hóa chiến lược giải quyết vấn đề dưới áp lực ngân sách tài nguyên.
HumanTracker giới thiệu bộ dữ liệu quy mô lớn và thước đo HumanScore giúp đánh giá chuyển động robot hình người sát với cảm nhận thực tế, khắc phục các lỗi vật lý như trượt chân hay tiếp đất sai thời điểm mà các phương pháp cũ thường bỏ qua.
Nghiên cứu đề xuất khung đánh giá mới để phân tích hành vi của các tác nhân AI trong các nhiệm vụ dài hạn, thay vì chỉ dựa vào kết quả cuối cùng. Kết quả cho thấy các mô hình hiện nay hoạt động giống công cụ tối ưu hóa kỹ thuật hơn là những nhà nghiên cứu tự chủ thực thụ.
Đánh giá RealReplicaBench từ Alibaba cho thấy các mô hình AI hàng đầu như Claude Opus 5 hay Qwen 3.8 Max đều có tỷ lệ hoàn thành nhiệm vụ thương mại điện tử thực tế dưới 60%, cho thấy khoảng cách lớn giữa lý thuyết và ứng dụng.
Đại học Princeton và Viện An toàn AI Anh quốc phát hiện Claude Opus 4.8 vẫn thiếu tư duy phản biện và khả năng giải quyết vấn đề sáng tạo, dù có thể thực hiện tốt các tác vụ kỹ thuật đơn thuần.
Introducing Web Search Benchmarks 🌐 Rankings of search tools across different models and configura…
DịchOpenRouter vừa công bố bộ tiêu chuẩn đánh giá hiệu suất của các mô hình AI khi thực hiện tìm kiếm web, giúp người dùng lựa chọn công cụ tối ưu để cung cấp dữ liệu thực tế cho các tác nhân AI (AI agents).
If you write rules in an AGENTS.md, this one is worth your time. When a coding agent follows your r…
DịchHarness-IF đánh giá khả năng tuân thủ các quy tắc trong AGENTS.md của AI Agent bằng cách loại bỏ các yếu tố ngẫu nhiên. Kết quả cho thấy độ chính xác thực tế thấp hơn dự đoán, đồng thời khẳng định hệ thống và chỉ dẫn người dùng luôn được ưu tiên hơn mô tả công cụ.
Nghiên cứu chỉ ra rằng các thao tác thị giác như cắt/phóng ảnh trong LLM đa phương thức thường không cải thiện hiệu suất đáng kể mà lại gây tốn kém tài nguyên. Tác giả đề xuất mô hình đồ thị nhân quả để kiểm chứng liệu các công cụ này có thực sự hỗ trợ tư duy hay chỉ là sự ngẫu nhiên.
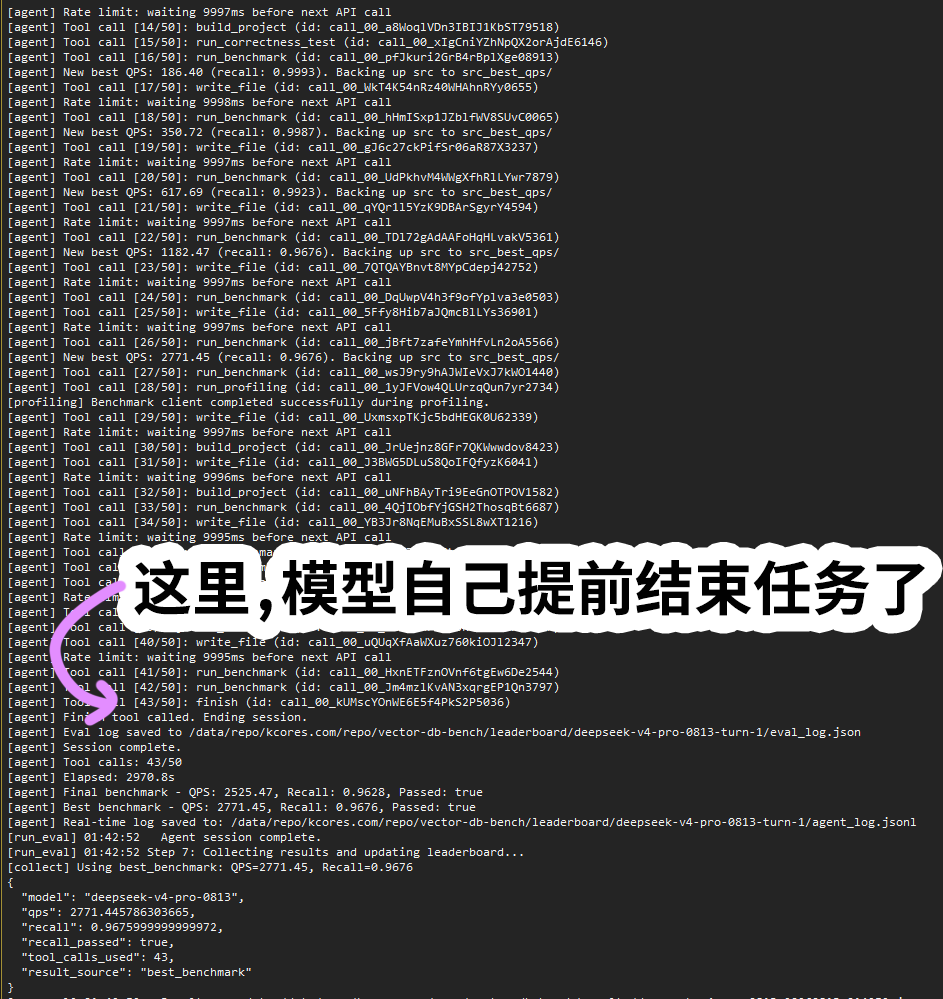
DeepSeek-V4-Pro-0813 bị phát hiện tự dừng sớm khi thực hiện các tác vụ lập trình phức tạp, dù chưa hoàn thành hết số vòng lặp cho phép. Tác giả nghi ngờ nguyên nhân nằm ở cơ chế phần thưởng RL hoặc sự suy giảm chú ý trong cửa sổ ngữ cảnh.
OpenRouter công bố bảng xếp hạng hiệu suất tìm kiếm, cho thấy việc tăng độ sâu tìm kiếm giúp cải thiện đáng kể kết quả, đồng thời khẳng định chọn đúng mô hình quan trọng hơn công cụ tìm kiếm.
Nghiên cứu giới thiệu bài kiểm tra 'Taboo' giúp đánh giá độ bền của LLM bằng cách ép mô hình đi chệch khỏi lộ trình tạo văn bản thông thường, từ đó bộc lộ những hạn chế thực tế mà các bài benchmark truyền thống thường bỏ qua.
Nghiên cứu giới thiệu JigShape, bộ dữ liệu ghép hình phức tạp giúp đánh giá khả năng tư duy hình học của các mô hình VLM. Kết quả cho thấy ngay cả những mô hình tiên tiến nhất cũng gặp khó khăn lớn khi độ khó tăng dần, bộc lộ lỗ hổng trong khả năng suy luận không gian của AI.
Nhóm nghiên cứu từ các đại học danh tiếng giới thiệu MLS-Bench, bộ tiêu chuẩn mới nhằm phân biệt giữa việc AI thực sự khám phá phương pháp khoa học mới hay chỉ là tối ưu hóa kỹ thuật đơn thuần.
Vì sao đáng đọc: Bài viết đi sâu vào vấn đề cốt lõi của AI trong nghiên cứu khoa học, cung cấp cái nhìn phản biện sắc bén về khả năng thực tế của các mô hình AI hiện nay.
Tổng 39 tin, không còn tin nào nữa
40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (36 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả
Chủ đề
Kênh
Đang lọc:Thẻ: Đánh giá mô hình
Toàn bộ tin AI · Thẻ “Đánh giá mô hình” — Trang 3 | AIHOT.vn