03/09

Thứ Năm · 2 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

Cliff: Chiến lược định hình phần thưởng RLVR học từ lỗi sai đầu tiên

Cliff sử dụng LLM làm giáo viên để phát hiện lỗi sai sớm trong quá trình suy luận, từ đó tối ưu hóa mô hình bằng cách phân tách chuỗi phản hồi thành phần đúng và sai. Phương pháp này vượt trội hơn các kỹ thuật truyền thống như GRPO tới 7%, ngay cả khi giáo viên có năng lực hạn chế.

02/09

Thứ Tư · 5 tin
Google AI for Developers@googleaidevs
Mô hìnhĐiểm AI 44/100

Google ra mắt Gemini 3.8 Flash: Bước tiến mới về khả năng suy luận phức tạp

Gemini 3.8 Flash is hardwired for complex reasoning. ⚙️ To test its skills, we built an interactive…

DịchGoogle vừa giới thiệu Gemini 3.8 Flash, phiên bản được tối ưu hóa cho các tác vụ suy luận chuyên sâu. Điểm nhấn là khả năng xử lý dữ liệu phức tạp, minh chứng qua việc tự động phân tách và trực quan hóa các thành phần phần cứng 3D trên Google AI Studio.

Thêm 2 nguồn khác đưa tinJiqizhixinThe Verge: AI
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 47/100

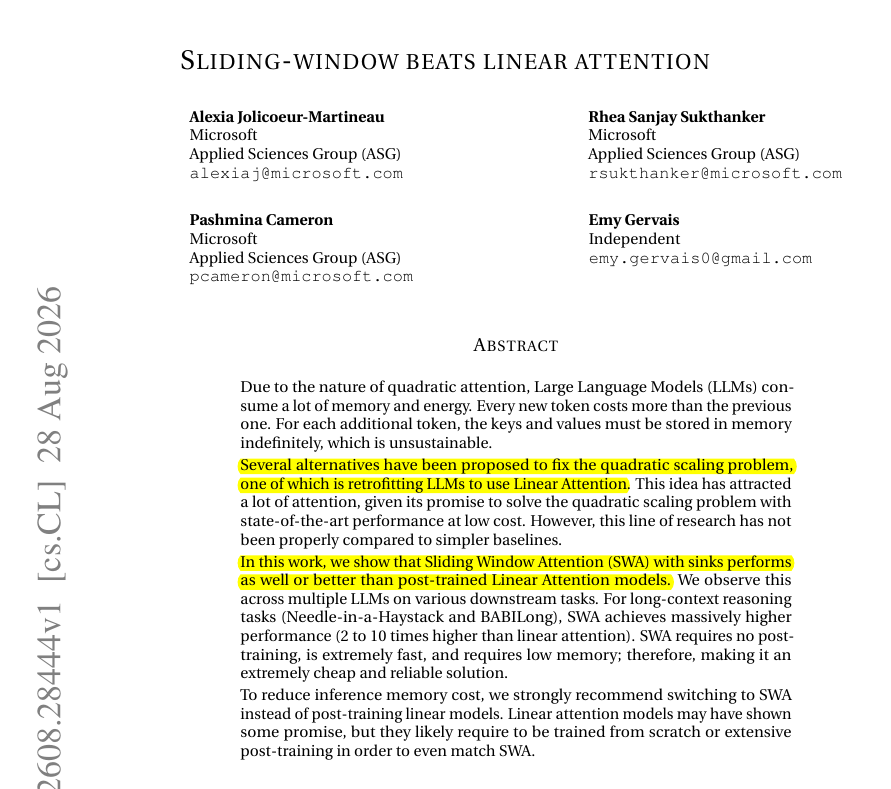
Nghiên cứu từ Microsoft: Sliding-window vượt trội hơn các biến thể Linear Attention trong suy luận tiết kiệm bộ nhớ

So happy to see this new Microsoft paper. If lower inference memory is the goal, this paper finds t…

DịchNghiên cứu chỉ ra rằng Sliding-window attention (SWA) hiệu quả hơn hầu hết các phương pháp Linear attention khi tối ưu bộ nhớ suy luận, chỉ cần kết hợp cửa sổ nhỏ và 4 token 'sink' đầu tiên.

Noam Brown@polynoamial
NgànhĐiểm AI 40/100

Noam Brown xác nhận Jakub Pachocki là Giám đốc Khoa học tại OpenAI

Jakub is chief scientist at @OpenAI

DịchNoam Brown xác nhận Jakub Pachocki giữ vị trí Giám đốc Khoa học tại OpenAI. Đồng thời, OpenAI chia sẻ về kỹ thuật suy luận chuỗi (chain-of-thought) trong các mô hình hiện tại, khẳng định đây là trọng tâm nghiên cứu dù vẫn còn nhiều thách thức về tính ổn định.

Emad Mostaque@EMostaque
Hướng dẫnĐiểm AI 46/100

Emad Mostaque cảnh báo về phương pháp suy luận mới trên OpenAI Astra gây khó kiểm soát

I see a lot of my TL freaking out about this Here is the reality: Frontier models will one shot ju…

DịchEmad Mostaque cho rằng phương pháp 'recurrent depth' trên Astra giúp tối ưu hiệu suất nhưng lại che giấu quá trình tư duy của AI, khiến việc giám sát trở nên bất khả thi khi tốc độ xử lý đạt ngưỡng 10.000 tokens/giây.

Thêm 1 nguồn khác đưa tinTechCrunch: AI

01/09

Thứ Ba · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Độ trung thực của chuỗi suy luận (CoT) phụ thuộc vào cách AI tiếp nhận gợi ý ưu tiên

Nghiên cứu giới thiệu FACE-Eval để kiểm tra khả năng suy luận trung thực của 15 mô hình AI. Kết quả cho thấy các mô hình dễ bị ảnh hưởng bởi dữ liệu từ công cụ hơn là tin nhắn người dùng, dù chúng không luôn thừa nhận điều đó trong chuỗi suy luận.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 43/100

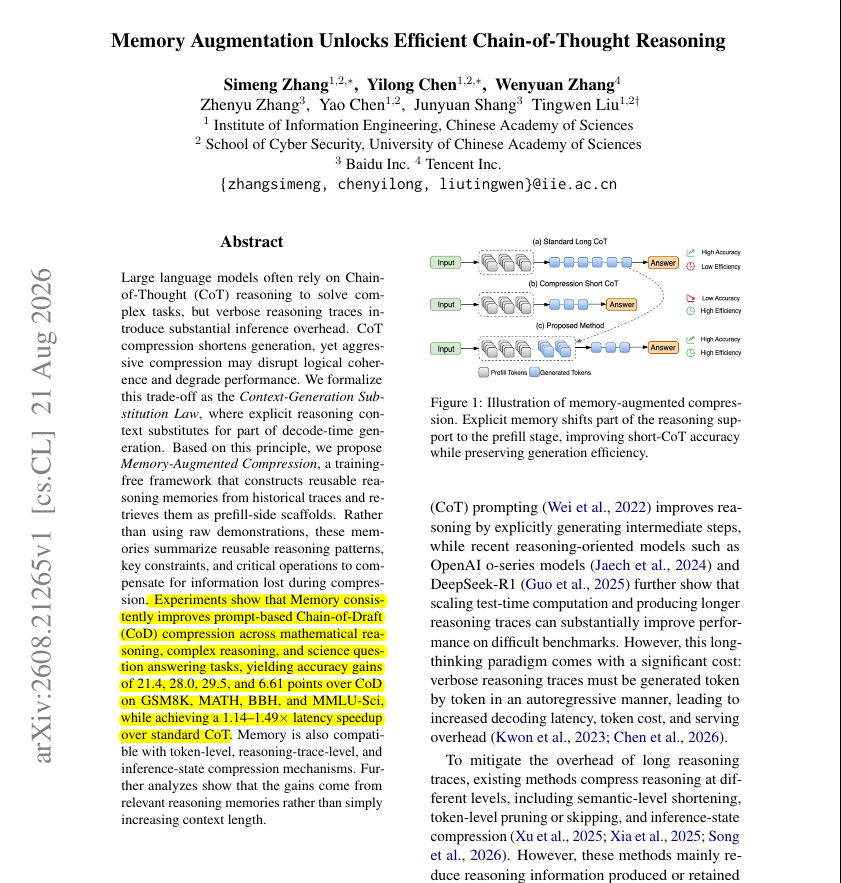
Nén tăng cường bộ nhớ: Tối ưu hóa chi phí suy luận chuỗi tư duy (CoT) bằng cách tái sử dụng suy luận

This paper shows a different way to make chain-of-thought cheaper: move reusable reasoning from gene…

DịchPhương pháp này chuyển đổi các bước suy luận từ giai đoạn tạo văn bản sang phần gợi ý (prompt), giúp giảm chi phí tính toán cho chuỗi tư duy mà không cần huấn luyện lại mô hình.

31/08

Thứ Hai · 1 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 46/100

CritICL: Tối ưu hóa suy luận cho mô hình lớn bằng cách học từ lỗi sai của mô hình nhỏ

Small models fail the same way big models do, so this paper shows you can collect a cheap model's mi…

DịchCritICL tận dụng các lỗi sai phổ biến từ mô hình nhỏ để tạo lời nhắc (prompt) thông minh cho mô hình lớn. Phương pháp này giúp mô hình lớn suy luận chính xác ngay từ lần thử đầu tiên thay vì phải lặp lại nhiều lần, giúp tiết kiệm tài nguyên đáng kể.

28/08

Thứ Sáu · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

CaRGo-T: Cải thiện khả năng hiểu hài hước đa phương thức bằng đồ thị suy luận nhân quả

CaRGo-T là khung suy luận mới sử dụng cấu trúc đồ thị để biểu diễn các mối quan hệ nhân quả và ngữ cảnh phức tạp trong nội dung hài hước, giúp các mô hình thị giác-ngôn ngữ hiểu sâu sắc hơn thay vì chỉ suy luận tuyến tính.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Giải mã chiến lược tiến hóa (ES) trong suy luận LLM: Vượt trội hơn GRPO về khả năng tư duy

Nghiên cứu chỉ ra rằng chiến lược tiến hóa (ES) giúp tối ưu hóa suy luận LLM hiệu quả hơn GRPO, tránh được hiện tượng suy giảm entropy và cải thiện đáng kể tỷ lệ thành công (Pass@K) nhờ các cập nhật trọng số chọn lọc.

27/08

Thứ Năm · 1 tin

26/08

Thứ Tư · 1 tin

25/08

Thứ Ba · 6 tin
Testing Catalog@testingcatalog
Sản phẩmĐiểm AI 39/100

Cùng sự kiệnOpenAI công bố hiệu năng ấn tượng của chip suy luận tự phát triển Jalapeño

OpenAI announced initial performance results of their own Jalapeño chip for AI inference. > 1.5-…

DịchOpenAI vừa hé lộ kết quả thử nghiệm chip Jalapeño, cho thấy khả năng tối ưu hóa vượt trội với hiệu suất trên mỗi watt tăng tới 1,9 lần và độ trễ giảm đáng kể so với các giải pháp hiện tại.

Cùng sự kiện, bài đại diện «OpenAI ra mắt chip suy luận tự phát triển Jalapeño: Đột phá về tốc độ và hiệu suất năng lượng»
Greg Brockman@gdb
Sản phẩmĐiểm AI 41/100

Cùng sự kiệnOpenAI công bố hiệu năng chip suy luận tự phát triển Jalapeño

inference numbers published for jalapeno, team did an amazing job https://openai.com/index/jalapeno-...

DịchOpenAI vừa hé lộ chip Jalapeño với khả năng tối ưu hóa vượt trội về tốc độ và năng lượng cho các mô hình lớn như GPT-OSS, DeepSeek R1 và Kimi K2. Được thiết kế với sự hỗ trợ của AI chỉ trong 9 tháng, chip dự kiến triển khai cuối năm nay.

Cùng sự kiện, bài đại diện «OpenAI ra mắt chip suy luận tự phát triển Jalapeño: Đột phá về tốc độ và hiệu suất năng lượng»
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

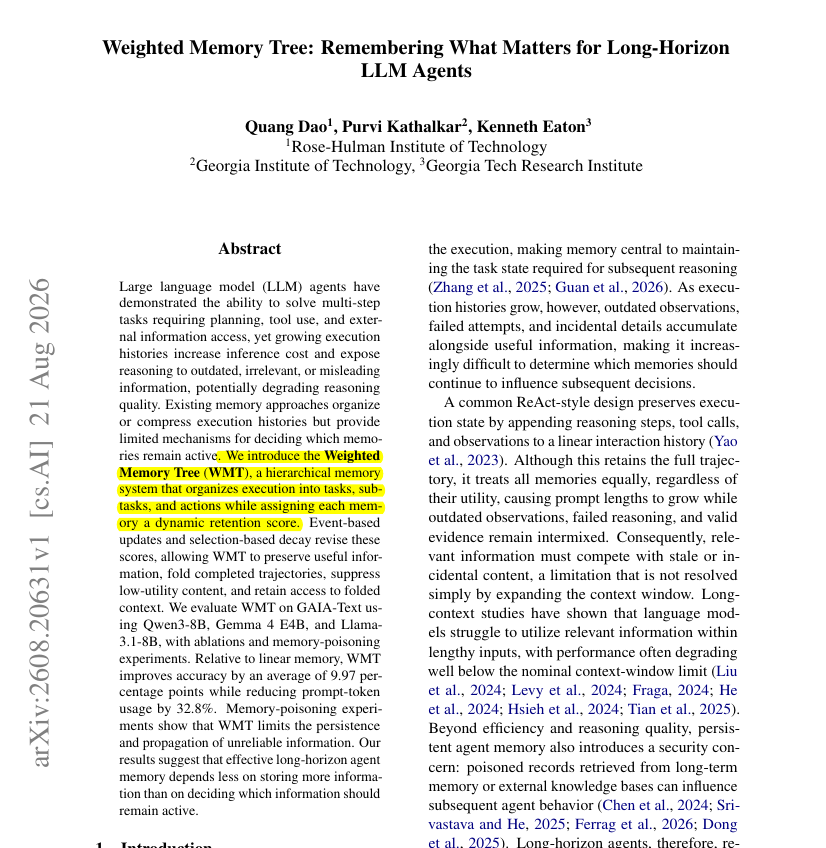
Weighted Memory Tree: Giải pháp tối ưu hóa suy luận cho AI Agent trong các tác vụ dài

Giving an agent a memory hierarchy is not what makes it reason better over long tasks. What helps is…

DịchNghiên cứu giới thiệu Weighted Memory Tree, phương pháp gán trọng số và giảm dần độ ưu tiên cho các ký ức thay vì xếp chồng dữ liệu, giúp AI Agent cải thiện độ chính xác và tiết kiệm chi phí token khi xử lý các tác vụ phức tạp.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Vượt xa bắt chước: Tối ưu hóa chưng cất mô hình ngôn ngữ dựa trên tiến trình suy luận

Nghiên cứu đề xuất phương pháp R2-OPD giúp lọc phản hồi từ giáo viên trong quá trình chưng cất mô hình, đảm bảo việc học tập tập trung vào tiến trình suy luận thực tế thay vì chỉ bắt chước đầu ra của giáo viên.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

DeepMind giới thiệu kỹ thuật 'Recirculation': Tối ưu hóa suy luận LLM mà không cần huấn luyện lại

New Google DeepMind paper shows, a transformer's shallow layers never see what its deeper layers hav…

DịchDeepMind đề xuất phương pháp 'Recirculation' bằng cách đưa các kích hoạt tầng sâu vào tầng nông trong quá trình suy luận, giúp giảm đáng kể độ bối rối (perplexity) của mô hình Gemma3 trên ngữ cảnh dài mà không cần thay đổi trọng số hay huấn luyện lại.

Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 36/100

sPTC: Kỹ thuật tăng tốc suy luận cho AI Agent thông qua gọi công cụ dự đoán

Recommended reading and a really cool idea. There are a lot of interesting harness designs that ar…

DịchCông nghệ sPTC giúp tối ưu hóa hiệu suất AI Agent bằng cách dự đoán và xếp hàng các lệnh gọi công cụ song song với quá trình tạo token, giúp giảm đáng kể độ trễ. Phương pháp này hiện mang lại mức tăng tốc từ 1 đến 1.2 lần, mở ra hướng đi mới cho việc tối ưu hóa hệ thống AI.

24/08

Thứ Hai · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Vượt xa độ chính xác: Đánh giá và căn chỉnh hành vi phản hồi của mô hình MLLM tư duy hỗn hợp

Nghiên cứu giới thiệu PatternEval, bộ tiêu chuẩn chẩn đoán mới nhằm đảm bảo tính nhất quán trong hành vi phản hồi giữa chế độ tư duy sâu và suy luận nhanh của các mô hình MLLM, giúp khắc phục các lỗi logic và định dạng thường gặp.

23/08

Chủ Nhật · 1 tin

22/08

Thứ Bảy · 1 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 35/100

Tối ưu hóa truy vấn: Thiết lập hàm mục tiêu cho ngữ cảnh của AI Agent

What a fascinating paper on AI agents. A lot of the issues we see with AI agents today revolve arou…

DịchNghiên cứu mới đề xuất phương pháp 'Đặt câu hỏi tối ưu' giúp AI Agent giảm thiểu ảo giác và chi phí bằng cách coi việc thu thập ngữ cảnh là quá trình suy luận chủ động, cho phép đo lường hiệu suất thực tế so với mức tối ưu lý thuyết.

21/08

Thứ Sáu · 5 tin
Artificial Analysis@ArtificialAnlys
Sản phẩmĐiểm AI 53/100

Bảng xếp hạng MLCR-AA: Claude Fable 5 dẫn đầu về khả năng suy luận y tế

Announcing MLCR-AA, our leaderboard for Wisedocs' MLCR (Medical Long Context Reasoning) benchmark fo…

DịchArtificial Analysis vừa công bố bảng xếp hạng MLCR-AA cho các mô hình AI trong lĩnh vực y tế. Claude Fable 5 xuất sắc giành vị trí quán quân với 64,4%, trong khi phần lớn các mô hình khác đạt kết quả dưới 15%.

Qwen@Alibaba_Qwen
Hướng dẫnĐiểm AI 28/100

Qwen2.5-27B cập nhật công thức tối ưu mới trên SGLang

Fresh recipes just dropped! ⚡ NVFP4 + DFlash2 for Qwen3.8-27B now in the SGLang cookbook. Thanks for…

DịchQwen2.5-27B vừa bổ sung hỗ trợ NVFP4 và DFlash2 vào cookbook của SGLang, giúp tăng tốc độ suy luận hiệu quả hơn. Đây là bản cập nhật đáng chú ý cho cộng đồng phát triển ứng dụng LLM.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 57/100

MemTrapBench: Bộ tiêu chuẩn mới đánh giá 'bẫy nhận thức' trong trí nhớ của LLM

MemTrapBench giải quyết lỗ hổng trong việc đánh giá cách bộ nhớ làm sai lệch khả năng suy luận của LLM. Nghiên cứu chỉ ra rằng các phương pháp ghi nhớ hiện tại thường gây tác dụng ngược, đồng thời giới thiệu AdaptiveMem giúp tối ưu hóa hiệu suất mà không mắc phải các bẫy nhận thức này.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

HOTFIXR: Tối ưu hóa dữ liệu tổng hợp đa ngôn ngữ giúp LLM thông minh hơn

Nghiên cứu giới thiệu khung làm việc HOTFIXR giúp cải thiện khả năng suy luận đa ngôn ngữ của LLM bằng cách tạo dữ liệu tổng hợp có độ khó tối ưu, khắc phục sự chênh lệch hiệu suất giữa các ngôn ngữ mà không làm giảm chất lượng phản hồi.

Hugging Face: Blog
Mô hìnhĐiểm AI 61/100

Tinh chọnHugging Face ra mắt dòng mô hình DSpark: Tăng tốc suy luận lên đến 3,18 lần

Hugging Face giới thiệu các mô hình dự đoán DSpark cho dòng LFM2.5, giúp tăng tốc độ xử lý trên GPU lên 3,18 lần và thiết bị đầu cuối lên 2,87 lần mà không làm giảm chất lượng đầu ra. Công nghệ này đã hỗ trợ mã nguồn mở cho llama.cpp và SGLang.

Thêm 1 nguồn khác đưa tinMarkTechPost

Vì sao đáng đọc: Đây là bước tiến kỹ thuật quan trọng giúp tối ưu hóa hiệu suất mô hình nhỏ, có tính ứng dụng cao cho cộng đồng phát triển AI và triển khai thực tế.

20/08

Thứ Năm · 1 tin

19/08

Thứ Tư · 2 tin

18/08

Thứ Ba · 2 tin
Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 41/100

Mô hình nhỏ kết hợp công cụ đã chạm trần: Đâu là hướng phát triển tiếp theo?

This is illuminating, but it also raises a deeper question. The old scaling paradigm: More compute …

DịchChuyên gia đặt nghi vấn về mô hình 1B tham số kết hợp công cụ, cho rằng việc nội hóa tri thức vào tham số có giới hạn và để đạt trí tuệ đỉnh cao vẫn cần các mô hình lớn hơn. Sau kỷ nguyên mở rộng tính toán tiền huấn luyện và suy luận, ngành AI đang tìm kiếm trục mở rộng mới.

17/08

Thứ Hai · 4 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnKhuếch đại không đồng nghĩa với dự đoán chính xác: Hành vi suy luận trong các mô hình tư duy

Nghiên cứu chỉ ra rằng các mô hình tư duy hiện nay thường khuếch đại các hành vi như tự sửa lỗi nhưng lại bỏ qua những yếu tố thực sự quyết định độ chính xác. Việc hiểu rõ khoảng cách giữa 'biểu hiện suy luận' và 'hiệu quả thực tế' là chìa khóa để tối ưu hóa các mô hình AI thế hệ mới.


Vì sao đáng đọc: Nghiên cứu quan trọng thách thức cách chúng ta đánh giá các mô hình tư duy (thinking models), cung cấp thước đo mới để phân biệt giữa hình thức và bản chất suy luận.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SimpleOPD: Phương pháp chưng cất mô hình tối ưu cho suy luận ngữ cảnh dài

SimpleOPD giải quyết các thách thức khi chuyển giao khả năng suy luận từ mô hình ngữ cảnh dài sang mô hình ngữ cảnh ngắn, thông qua việc đồng bộ hóa không gian văn bản và tối ưu hóa quá trình huấn luyện để tránh lỗi độ dài và mất ổn định.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 67/100

AI đang cố tình 'ngu' đi: Đánh đổi kiến thức thế giới để lấy khả năng suy luận

Các mô hình AI hiện đại đang ưu tiên khả năng suy luận thay vì lưu trữ kiến thức. Điều này giúp GLM-5.2 đạt điểm số ấn tượng trong các bài kiểm tra toán học, nhưng lại khiến các mô hình nhỏ như Qwen3.5 9B dễ gặp ảo giác hơn khi truy vấn thông tin thực tế.

15/08

Thứ Bảy · 1 tin

14/08

Thứ Sáu · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Hybrid-Policy Self-Editing: Phương pháp mới giúp LLM cập nhật kiến thức linh hoạt và có tính suy luận

Nghiên cứu giới thiệu phương pháp Hybrid-Policy Self-Editing giúp LLM không chỉ ghi nhớ thông tin mới mà còn có thể suy luận và trả lời các câu hỏi phức tạp dựa trên kiến thức đã cập nhật, khắc phục hạn chế của các kỹ thuật chỉnh sửa kiến thức hiện nay.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (59 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “suy luận” — Trang 2 | AIHOT.vn