17/09

Thứ Năm · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 75/100

Ánh mắt như bằng chứng của sự đồng thuận: Phân tích so sánh qua MapTask và MUNDEX

Nghiên cứu phân tích cách ánh mắt phản ánh sự hiểu biết chung trong các nhiệm vụ hợp tác. Kết quả cho thấy khi người tham gia đạt được sự đồng thuận, ánh mắt tập trung nhiều hơn vào nhiệm vụ và ít hướng về đối phương hơn.

16/09

Thứ Tư · 3 tin
ModelBest OpenBMB@OpenBMB
Mô hìnhĐiểm AI 34/100

Gander: Trợ lý AI đa phương thức thế hệ mới từ MiniCPM-o 4.5

🤖 What if an AI agent could keep seeing, listening, talking, and working - all at the same time? D…

DịchGander là trợ lý AI đột phá tích hợp khả năng nghe nhìn liên tục và phản hồi thời gian thực, cho phép thực hiện các tác vụ phức tạp mà không cần tách biệt giữa giao tiếp giọng nói và hành động.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Sự trỗi dậy hội tụ của khả năng học trong ngữ cảnh (ICL) trên đa phương thức

Nghiên cứu chứng minh rằng khả năng học trong ngữ cảnh (ICL) không chỉ giới hạn ở ngôn ngữ mà còn xuất hiện đồng nhất trên sáu phương thức khác nhau, củng cố giả thuyết về sự hội tụ trong cách các mô hình AI tiếp nhận và xử lý quy luật trừu tượng.

Hongming@hongming731
NgànhĐiểm AI 47/100

Cùng sự kiệnJensen Huang bàn về an toàn AI; Gemini 3.8 Live ra mắt tính năng đa phương thức thời gian thực

Jensen Huang đề xuất kiểm soát an toàn AI thông qua kỹ thuật, bao gồm phân tích nguyên nhân gốc rễ và giám sát liên tục. Cùng lúc đó, Gemini 3.8 Live chính thức ra mắt với khả năng xử lý đa phương thức thời gian thực.

Cùng sự kiện, tinh chọn hiển thị «Google DeepMind ra mắt Gemini 3.8 Live và bản Extended Thinking: Đột phá mới cho trợ lý giọng nói»

15/09

Thứ Ba · 4 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnRealtime-Venus: Hệ thống tương tác song công thời gian thực với cơ chế ủy quyền bất đồng bộ

Realtime-Venus là hệ thống tương tác đa phương thức sử dụng mô hình 9B, cho phép duy trì hội thoại liên tục trong khi thực hiện các tác vụ phức tạp ở chế độ nền nhờ cơ chế ủy quyền bất đồng bộ.

Thêm 1 nguồn khác đưa tinAnt Group inclusionAI: GitHub kho mã mới

Vì sao đáng đọc: Bước tiến quan trọng trong việc tối ưu hóa trải nghiệm hội thoại thời gian thực, giải quyết được bài toán xử lý đa nhiệm mà không làm gián đoạn tương tác của người dùng.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 40/100

BVB: Dùng Blender tái tạo video để kiểm chứng khả năng hiểu hình ảnh của AI

BVB (Blender-VideoBench) là bộ tiêu chuẩn mới yêu cầu AI tái tạo video thực thành hoạt cảnh Blender. Kết quả cho thấy dù mô hình có thể mô phỏng hình ảnh tốt, chúng vẫn gặp khó khăn lớn trong việc duy trì tính chính xác của các sự kiện theo thời gian.

14/09

Thứ Hai · 2 tin
SenseTime@SenseTime_AI
NgànhĐiểm AI 23/100

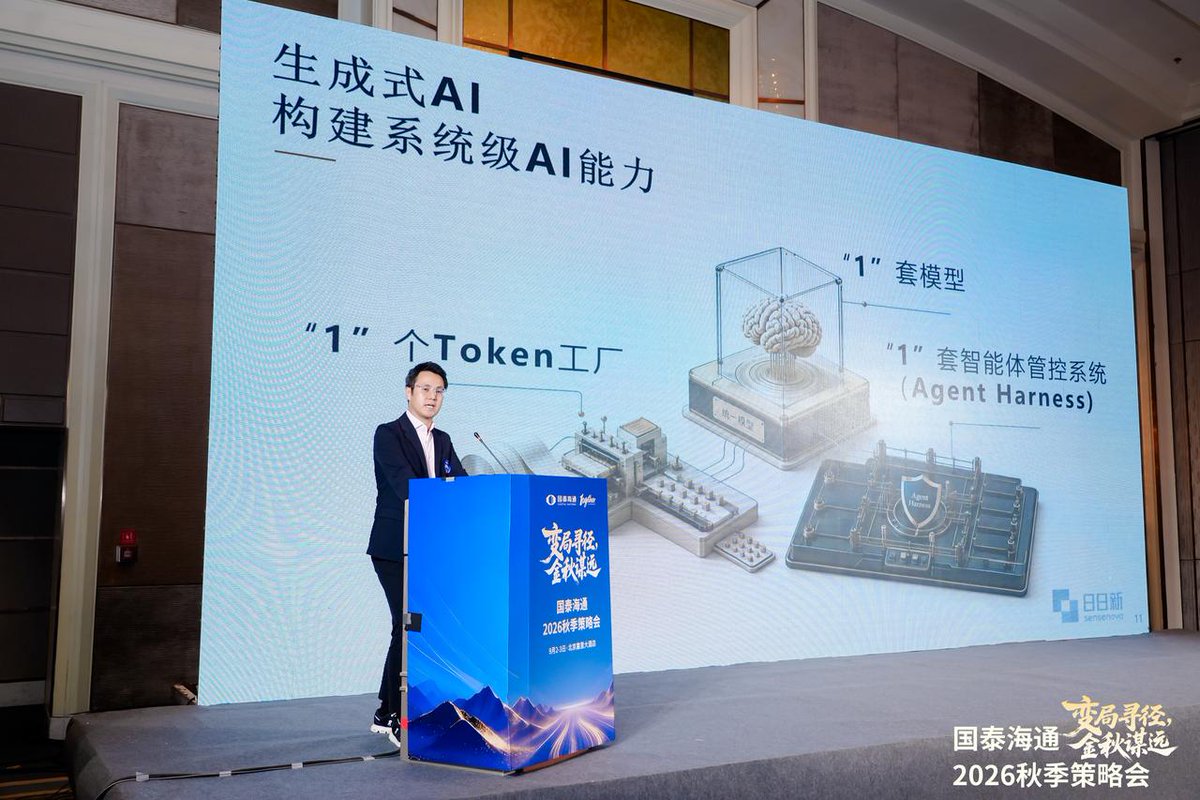
SenseTime đề xuất 3 bước ngoặt định hình lại tương lai ngành AI

Capturing AI's Next Wave: From Model Intelligence to Ag…

DịchTại hội nghị chiến lược mùa thu 2026, SenseTime đã vạch ra ba thay đổi cốt lõi trong ngành AI: chuyển dịch từ đơn phương thức sang đa phương thức, từ tiêu thụ token sang tập trung vào kết quả nhiệm vụ, và từ mô hình đơn lẻ sang hệ thống toàn diện.

12/09

Thứ Bảy · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Giải mã Image Tokenizer: Ngôn ngữ thị giác trong các mô hình đa phương thức hợp nhất

Nghiên cứu này đề xuất phương pháp đánh giá mới cho Image Tokenizer thông qua việc theo dõi tổn thất (loss) trong quá trình huấn luyện đa phương thức, giúp hiểu rõ cách các token thị giác và văn bản tương tác để tối ưu hóa hiệu suất mô hình.

Artificial Analysis@ArtificialAnlys
Mô hìnhĐiểm AI 63/100

Ant Group ra mắt mô hình đa phương thức mã nguồn mở Ling-3.0-flash-VL

Ling-3.0-flash-VL, Ant Group's new flash tier open weights model, scores 25 on the Artificial Analys…

DịchAnt Group vừa công bố mô hình suy luận đa phương thức Ling-3.0-flash-VL với mã nguồn mở, đạt 25 điểm trên bảng xếp hạng Artificial Analysis nhờ hiệu suất tối ưu giữa trí tuệ và tham số hoạt động.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Think Before You Link: Cải thiện liên kết thực thể đa ngôn ngữ bằng suy luận và truy xuất

Nghiên cứu chỉ ra rằng các hệ thống liên kết thực thể thường thất bại với các thực thể hiếm. Tác giả đề xuất khung làm việc không cần huấn luyện, sử dụng mô hình ngôn ngữ-hình ảnh để suy luận và truy xuất dữ liệu từ Wikipedia nhằm cải thiện độ chính xác.

11/09

Thứ Sáu · 2 tin
OpenRouter@OpenRouter
Sản phẩmĐiểm AI 55/100

Mô hình Ling 3.0 Flash VL chính thức có mặt trên OpenRouter

Ling 3.0 Flash VL is live on OpenRouter, served by @novita_labs. A 124B MoE with 5.5B active params…

DịchLing 3.0 Flash VL, mô hình MoE 124B với khả năng xử lý hình ảnh và video chuyên sâu, đã được tích hợp lên OpenRouter thông qua Novita Labs. Người dùng hiện có thể trải nghiệm miễn phí các tính năng như suy luận hỗn hợp và gọi công cụ trực tiếp trên nền tảng.

10/09

Thứ Năm · 7 tin
Tencent WorkBuddy@WorkBuddy_AI
Mô hìnhĐiểm AI 69/100

Đã có đại diệnWorkBuddy tích hợp DeepSeek V4.1-Flash, cho phép dùng thử miễn phí 2 tuần

Now live on WorkBuddy ⚡ DeepSeek V4.1-Flash, free to try for 2 weeks.

DịchNền tảng WorkBuddy vừa cập nhật mô hình DeepSeek V4.1-Flash với khả năng xử lý đa phương thức nguyên bản, người dùng có thể trải nghiệm miễn phí trong vòng 14 ngày.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
X.PIN@thexpin
Mô hìnhĐiểm AI 58/100

Cùng sự kiệnDeepSeek hợp nhất các chế độ, chuẩn bị ra mắt V4.1 Flash và khai tử V4 Pro

DeepSeek has unified its Fast, Expert and Image Recognition modes, removing the standalone Expert op…

DịchDeepSeek tích hợp các chế độ chuyên gia và nhận diện hình ảnh vào một mô hình duy nhất, dự kiến ra mắt V4.1 Flash vào ngày 10/9 và ngừng hỗ trợ V4 Pro từ ngày 14/9.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
IT Home
Mô hìnhĐiểm AI 86/100

Cùng sự kiệnDeepSeek ra mắt mô hình V4.1 Flash: Hiệu năng vượt trội bản Pro với chi phí API rẻ hơn

DeepSeek vừa trình làng V4.1 Flash, mô hình MoE 552 tỷ tham số với kiến trúc Causal-Encoder-Decoder mới, hỗ trợ đa phương thức và đạt kết quả benchmark ấn tượng hơn cả bản V4 Pro.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt V4.1-Flash: Mô hình đa phương thức nhỏ gọn với giá API siêu rẻ»
DeepSeek: Nhật ký cập nhật API
Mô hìnhĐiểm AI 79/100

Tinh chọnDeepSeek ra mắt V4.1-Flash: Mô hình đa phương thức nhỏ gọn với giá API siêu rẻ

DeepSeek vừa trình làng V4.1-Flash, phiên bản nhỏ nhất trong dòng kiến trúc mới với khả năng hiểu hình ảnh vượt trội và hiệu suất ấn tượng trên các bài kiểm tra chuyên sâu, đi kèm chính sách giảm giá API.

Diễn biến sự kiện · 4 bài →Thêm 2 nguồn khác đưa tinIT HomeWeChat: DeepSeek

Vì sao đáng đọc: Đây là bản cập nhật quan trọng từ một đơn vị dẫn đầu thị trường, mang lại giá trị thực tế cho người dùng thông qua việc tối ưu hóa hiệu năng và chi phí.
WeChat: DeepSeek
Mô hìnhĐiểm AI 85/100

Cùng sự kiệnDeepSeek ra mắt V4.1 Flash: Mô hình đa phương thức 552B MoE, mã nguồn mở và giảm giá API

DeepSeek trình làng V4.1 Flash, mô hình MoE 552 tỷ tham số với cấu trúc Causal-Encoder-Decoder mới, hỗ trợ đa phương thức và vượt trội hơn cả bản Pro trong các bài kiểm tra hiệu năng.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt V4.1-Flash: Mô hình đa phương thức nhỏ gọn với giá API siêu rẻ»
Ant Ling@AntLingAGI
Mô hìnhĐiểm AI 52/100

Ant Ling-3.0-flash-VL ra mắt trên Hugging Face, cho phép trải nghiệm miễn phí 14 ngày

Now you can play with the VL model of Ling on Hugging Face with our day0 partner @novita_labs

DịchAnt Ling-3.0-flash-VL, mô hình đa phương thức 124B tham số với khả năng hiểu hình ảnh và video chuyên sâu, đã chính thức có mặt trên nền tảng Novita thông qua Hugging Face với ưu đãi dùng thử miễn phí 14 ngày.

Ant Ling@AntLingAGI
Mô hìnhĐiểm AI 51/100

Cùng sự kiệnAnt Ling ra mắt mô hình đa phương thức Ling-3.0-flash-VL, miễn phí 14 ngày trên Novita

Thanks to our day0 partner @novita_labs for the continued support, this time with the "eyes" of the …

DịchAnt Ling vừa trình làng mô hình đa phương thức Ling-3.0-flash-VL, đồng thời hợp tác với Novita để cung cấp trải nghiệm miễn phí trong 14 ngày cho người dùng.

Cùng sự kiện, bài đại diện «Ant Group ra mắt mô hình đa phương thức Ling-3.0-flash-VL với khả năng phản hồi thị giác»

09/09

Thứ Tư · 6 tin
Alibaba Cloud@alibaba_cloud
NgànhĐiểm AI 46/100

Alibaba Cloud ra mắt Qwen3.8-Max: Mô hình 2.4T tham số với khả năng đa phương thức mạnh mẽ

Stop renting intelligence. Power your coding & multi-agent workflows with Alibaba Qwen3.8-Max's 2.4T…

DịchAlibaba Cloud chính thức phát hành Qwen3.8-Max, mô hình 2.4T tham số hỗ trợ cửa sổ ngữ cảnh 1M token và khả năng đa phương thức gốc, tối ưu cho lập trình và tác vụ đa tác nhân. Người dùng có thể nhận 70 triệu token miễn phí trên Qwen Cloud và Model Studio ngay hôm nay.

Thêm 1 nguồn khác đưa tinPandaily
Ant Ling@AntLingAGI
Mô hìnhĐiểm AI 54/100

Cùng sự kiệnAnt Group ra mắt mô hình đa phương thức Ling-3.0-flash-VL với cửa sổ ngữ cảnh 1 triệu token

Thanks @sgl_project community! The Ling series finally have eyes and we appreciate our day0 partners…

DịchAnt Group vừa trình làng Ling-3.0-flash-VL, mô hình MoE hỗ trợ hiểu hình ảnh và video chuyên sâu với cửa sổ ngữ cảnh lên tới 1 triệu token, đồng thời được SGLang hỗ trợ ngay từ ngày đầu ra mắt.

Cùng sự kiện, bài đại diện «Ant Group ra mắt mô hình đa phương thức Ling-3.0-flash-VL với khả năng phản hồi thị giác»
Alibaba Cloud@alibaba_cloud
NgànhĐiểm AI 46/100

QwenWork ra mắt tính năng sáng tạo đa phương thức: Từ ảnh sản phẩm đến video marketing trong một bước

🎬 Multimodal creation is now live on QwenWork. Drop in a few product images and tell QwenWork what …

DịchQwenWork vừa tích hợp khả năng đa phương thức, cho phép người dùng biến hình ảnh sản phẩm thành video quảng cáo, poster và nhạc nền chỉ trong một lần hội thoại mà không cần chuyển đổi công cụ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

CVRR: Ép mô hình AI suy luận hình ảnh thông qua trạng thái ẩn thay vì văn bản

Nghiên cứu giới thiệu Causal Visual Recurrent Reasoning (CVRR), phương pháp buộc mô hình AI phải sử dụng các trạng thái ẩn để suy luận hình ảnh thay vì dựa vào các chuỗi suy nghĩ văn bản, giúp tăng độ chính xác và tính minh bạch trong xử lý đa phương thức.

08/09

Thứ Ba · 4 tin
Ant Ling@AntLingAGI
Mô hìnhĐiểm AI 51/100

Cùng sự kiệnAnt Group ra mắt mô hình đa phương thức mã nguồn mở Ling-3.0-flash-VL

Today, we're open-sourcing Ling-3.0-flash-VL in BF16 and FP8. FP4 and INT4 are coming soon. Beyond …

DịchAnt Group vừa công bố mã nguồn mở Ling-3.0-flash-VL, mô hình đa phương thức mạnh mẽ có khả năng hiểu sâu về hình ảnh, video, tài liệu và giao diện người dùng, đồng thời hỗ trợ suy luận và sử dụng công cụ chuyên sâu.

Cùng sự kiện, bài đại diện «Ant Group ra mắt Ling-3.0-flash-VL: Mô hình đa phương thức mã nguồn mở mạnh mẽ»
IT Home
Mô hìnhĐiểm AI 57/100

DeepSeek V4.1 Flash ra mắt bản thử nghiệm: Cấu trúc mới, hỗ trợ đa phương thức nguyên bản

DeepSeek vừa khởi động thử nghiệm phiên bản V4.1 Flash với kiến trúc mô hình cải tiến, mang lại khả năng xử lý đa phương thức mạnh mẽ hơn cùng tốc độ vượt trội và chi phí tối ưu.

Thêm 6 nguồn khác đưa tinX: X.PIN (@thexpin)X: Gabriel (@gabriel1)PandailyTechNodeX: Kim (@kimmonismus)Jiqizhixin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnĐội ngũ Nhan Thủy Thành ra mắt VoiceMem: Kiến trúc 'Song não' đột phá cho tương lai AI tương tác thời gian thực

VoiceMem giới thiệu hệ thống bộ nhớ đa phương thức giúp AI không chỉ hiểu ngữ cảnh mà còn ghi nhớ cảm xúc và âm thanh, biến trợ lý ảo thành người bạn đồng hành thực thụ thay vì chỉ là công cụ vô tri.


Vì sao đáng đọc: Đây là bước tiến quan trọng giải quyết điểm yếu 'mất trí nhớ' của các mô hình AI hiện nay. Công nghệ có tính ứng dụng cao, mã nguồn mở và đã được tích hợp vào Qwen Audio Agent.

07/09

Thứ Hai · 4 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnTFO: Biến mô hình thị giác-ngôn ngữ (VLM) thành hệ thống hiểu âm thanh mà không cần huấn luyện lại

TFO là giải pháp plug-and-play cho phép tích hợp khả năng hiểu âm thanh vào các mô hình VLM đóng băng mà không cần thay đổi kiến trúc hay huấn luyện lại, giúp bảo toàn nguyên vẹn năng lực suy luận thị giác ban đầu.


Vì sao đáng đọc: Giải pháp đột phá giúp tiết kiệm chi phí tính toán đáng kể khi tích hợp đa phương thức, giải quyết trực tiếp vấn đề 'quên lãng' năng lực cũ của các mô hình VLM hiện nay.

06/09

Chủ Nhật · 1 tin

04/09

Thứ Sáu · 3 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 39/100

Ra mắt Last Translation Benchmark: Bộ tiêu chuẩn đánh giá giới hạn của AI dịch thuật đa phương thức

Last Translation Benchmark sử dụng các mẫu dữ liệu đa phương thức (văn bản, hình ảnh, âm thanh, video) được con người kiểm duyệt khắt khe để thử thách và tìm ra điểm yếu của các mô hình dịch thuật AI hiện nay.

IT Home
Mô hìnhĐiểm AI 62/100

WeChat công bố mã nguồn mở mô hình đa phương thức WeMM-Embedding với 3 phiên bản 2B/4B/9B

WeChat vừa ra mắt mô hình đa phương thức WeMM-Embedding hỗ trợ xử lý văn bản, hình ảnh và video. Phiên bản 9B hiện đang dẫn đầu bảng xếp hạng MMEB-v2 và đã được ứng dụng thực tế trong hệ thống gợi ý của WeChat với hơn 1 tỷ lượt gọi mỗi ngày.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (67 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Đa phương thức” — Trang 2 | AIHOT.vn