02/09

Thứ Tư · 37 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnClawBench: Khi các siêu AI 'bó tay' trước những tác vụ thực tế trên web

Nghiên cứu mới từ TIGER Lab cho thấy các mô hình hàng đầu như Claude, GPT và Gemini đều thất bại thảm hại khi thực hiện các tác vụ thực tế trên web, với tỷ lệ thành công chỉ đạt khoảng 33%.


Vì sao đáng đọc: Bài viết bóc trần sự thật về khả năng thực thi của AI agent trong môi trường thực tế, thách thức những kỳ vọng quá mức về khả năng tự động hóa hiện nay.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 52/100

JIT-Agent: Bước tiến mới trong tối ưu hóa tác vụ, DeepSeek-V4-Flash vượt mặt GPT-5.6

A smaller model with the right task-specific harness can beat a stronger model. New paper introduce…

DịchNghiên cứu mới giới thiệu JIT-Agent, hệ thống tự động tùy chỉnh cấu trúc tác vụ (harness) theo thời gian thực. Công nghệ này giúp DeepSeek-V4-Flash đạt 85.1 điểm, vượt trội so với mức 76.0 của GPT-5.6.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Pera: Kiến trúc lấy nhận thức làm trung tâm cho các tác nhân AI bền bỉ

Pera là khung kiến trúc mới giúp các tác nhân AI duy trì khả năng hỗ trợ liên tục trong môi trường dài hạn, thay vì chỉ giải quyết các tác vụ đơn lẻ. Hệ thống tập trung vào cơ chế nhận thức và kiểm soát để thích nghi với nhu cầu người dùng thay đổi theo thời gian.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 50/100

Meta ra mắt ADeptS-Bench: Đánh giá độ tin cậy của AI khi thực hiện các tác vụ GUI độc hại

New Meta paper. Computer-use agents can click the requested button and still fail to recognize whe…

DịchMeta FAIR giới thiệu ADeptS-Bench, bộ tiêu chuẩn đánh giá khả năng của AI trong việc nhận diện và xử lý các tác vụ GUI từ lành tính đến độc hại trên cả nền tảng di động và máy tính.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 44/100

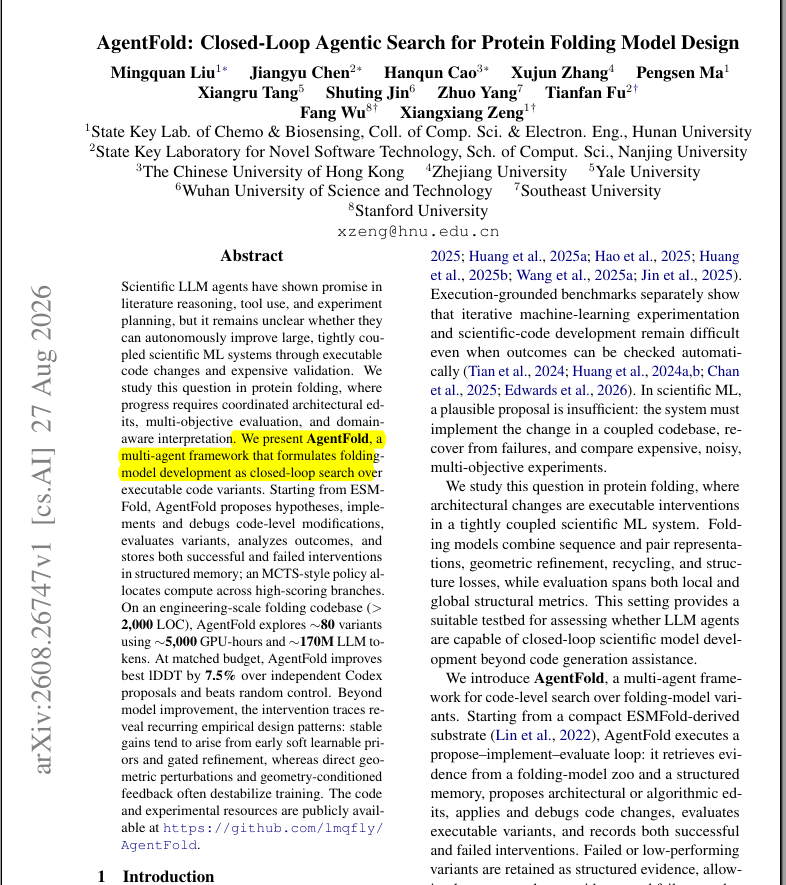
AgentFold: Stanford và Yale dùng AI tự động thiết kế mô hình gấp cuộn protein

New Stanford, Yale and other top Chinese univ paper treats scientific model development as search ov…

DịchCác nhà nghiên cứu giới thiệu AgentFold, một hệ thống AI sử dụng tìm kiếm cây để tự động đề xuất, tinh chỉnh và huấn luyện các kiến trúc mô hình gấp cuộn protein từ mã nguồn.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnSafin-1: Đưa tính an toàn vào cốt lõi mô hình thông qua cơ chế tiến hóa trạng thái bộ nhớ

Safin-1 giới thiệu kiến trúc MARCH giúp mô hình tự duy trì trạng thái an toàn nội tại thông qua việc định tuyến bộ nhớ và tiến hóa trạng thái, thay vì phụ thuộc vào các bộ lọc bên ngoài.


Vì sao đáng đọc: Đề xuất hướng tiếp cận mới đầy hứa hẹn về an toàn AI bằng cách tích hợp trực tiếp vào kiến trúc thay vì chỉ dùng hậu kiểm, rất quan trọng cho các tác vụ dài hạn.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnUI-Venus-2: Bước tiến mới cho tác nhân AI điều khiển giao diện người dùng đa nền tảng

UI-Venus-2 là tác nhân AI đa phương thức thế hệ mới, có khả năng tự động hóa tác vụ trên cả di động, web và máy tính nhờ khung làm việc suy luận-hành động khép kín, giúp thu hẹp khoảng cách từ thử nghiệm đến ứng dụng thực tế.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng về tác nhân AI (GUI agents), giải quyết bài toán thực tế về tính ứng dụng đa nền tảng, rất đáng chú ý cho cộng đồng phát triển AI.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

Nghiên cứu cơ chế phối hợp giữa hiểu và tạo trong mô hình đa phương thức nguyên bản

Nghiên cứu chỉ ra rằng việc tách biệt nhiệm vụ giúp tránh sự suy giảm hiệu năng khi mô hình đa phương thức vừa hiểu vừa tạo ảnh, đồng thời khẳng định mô hình end-to-end vượt trội hơn so với các hệ thống phân tách truyền thống.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

EM^2Mem: Khung bộ nhớ đa phương thức lấy sự kiện làm trung tâm giúp tối ưu hóa hỏi đáp video dài

EM^2Mem là khung bộ nhớ mới giúp liên kết các bằng chứng đa phương thức vào các mốc sự kiện, từ đó cải thiện độ chính xác khi truy vấn video dài và giảm đáng kể chi phí tính toán.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 46/100

StudentSim: Khung mô phỏng học sinh dựa trên LLM cho giáo dục cá nhân hóa

StudentSim sử dụng kỹ thuật huấn luyện gộp và chuyên biệt hóa để tạo ra các mô hình mô phỏng học sinh có khả năng phản hồi và học tập dưới sự hướng dẫn. Hệ thống đi kèm bộ tiêu chuẩn đánh giá StudentSimEval trên 60 học sinh ở các lĩnh vực toán học, ngoại ngữ và cờ vua.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 60/100

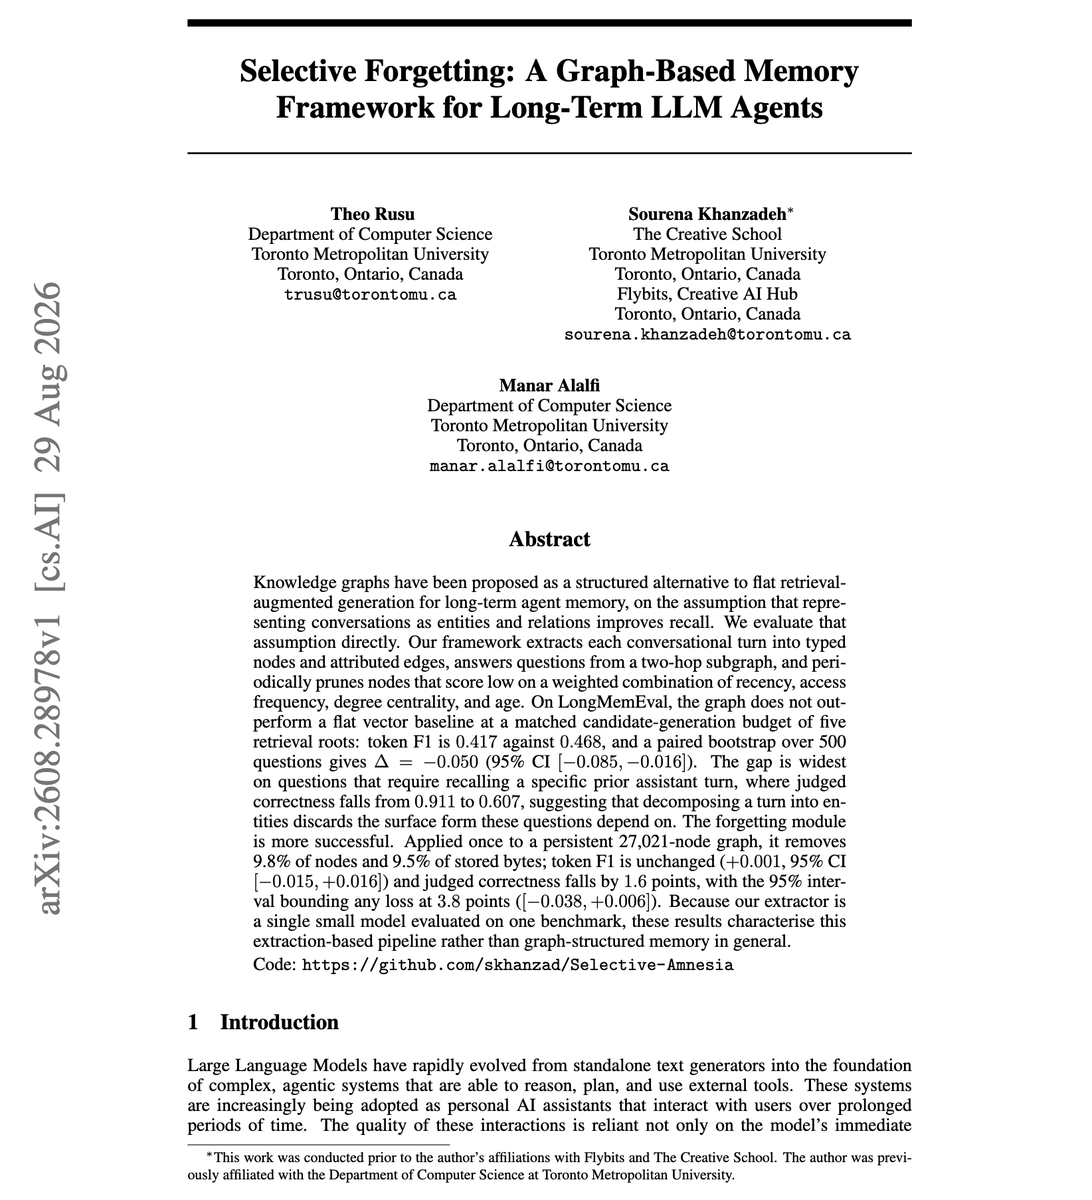
Selective Forgetting: Khung bộ nhớ dựa trên đồ thị cho tác nhân AI dài hạn

Finally, a good paper testing if graph memory actually beats flat retrieval for long-term agents. (…

DịchNghiên cứu mới đề xuất phương pháp chuyển đổi hội thoại thành đồ thị với các nút và cạnh thuộc tính, giúp tác nhân AI truy xuất thông tin chính xác hơn thông qua các truy vấn đồ thị hai bước.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Hi-Q: Tối ưu hóa truy vấn phân cấp dựa trên bằng chứng cho hệ thống hỏi đáp đa chặng

Hi-Q giải quyết vấn đề chênh lệch độ chi tiết giữa câu hỏi và dữ liệu bằng cách sử dụng cơ chế phân cấp thông minh. Hệ thống tự động kiểm tra bằng chứng để quyết định khi nào cần tinh chỉnh truy vấn, giúp cải thiện độ chính xác cho các tác vụ hỏi đáp phức tạp.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 51/100

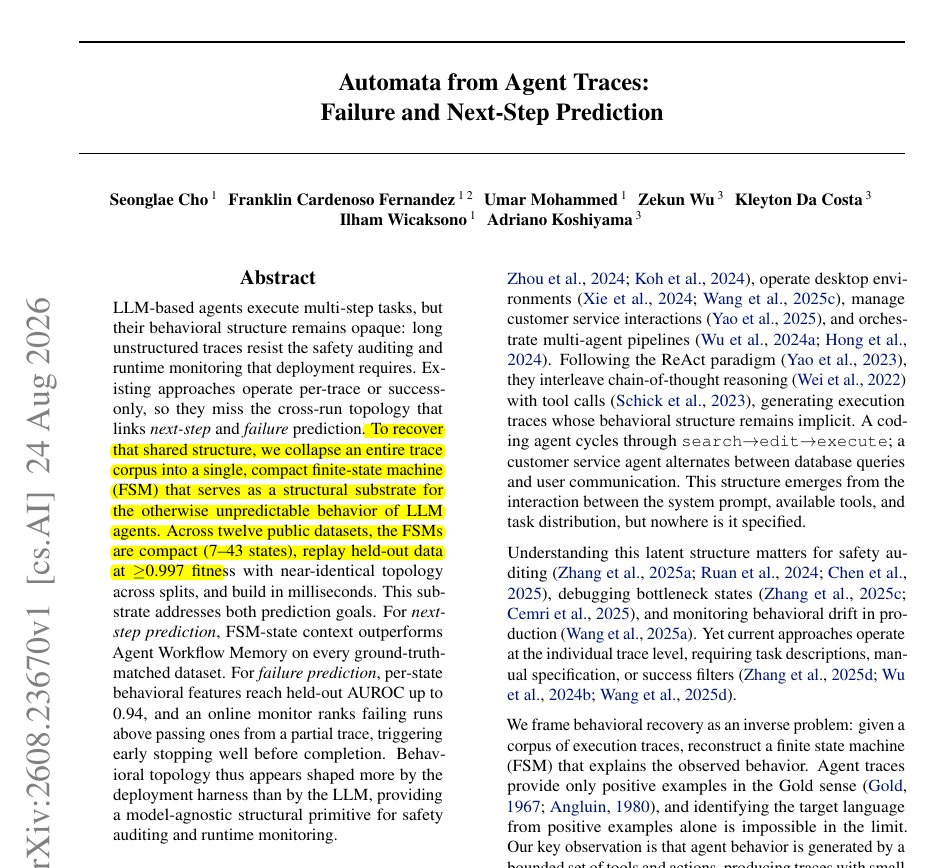
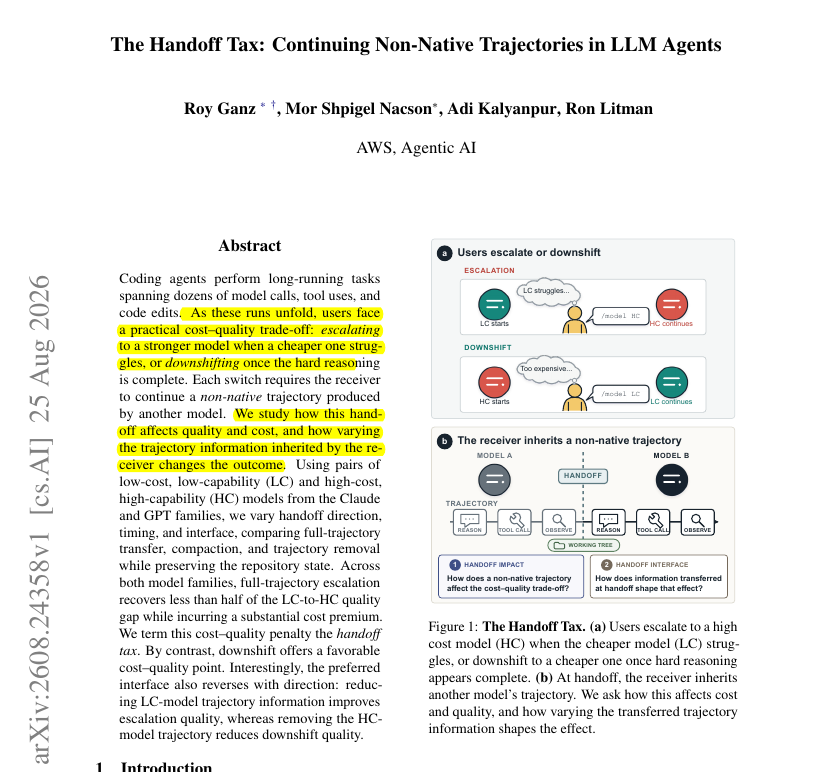
Nghiên cứu mới: Nén quỹ đạo LLM Agent thành máy trạng thái hữu hạn để dự đoán hành động và lỗi

Different LLMs may behave more similarly inside an agent harness than their raw traces suggest. LLM…

DịchMột nghiên cứu mới đề xuất phương pháp nén chuỗi hành động của LLM Agent thành các máy trạng thái hữu hạn (FSM) nhỏ gọn, giúp dự đoán bước tiếp theo và phát hiện sớm các lỗi vận hành.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 46/100

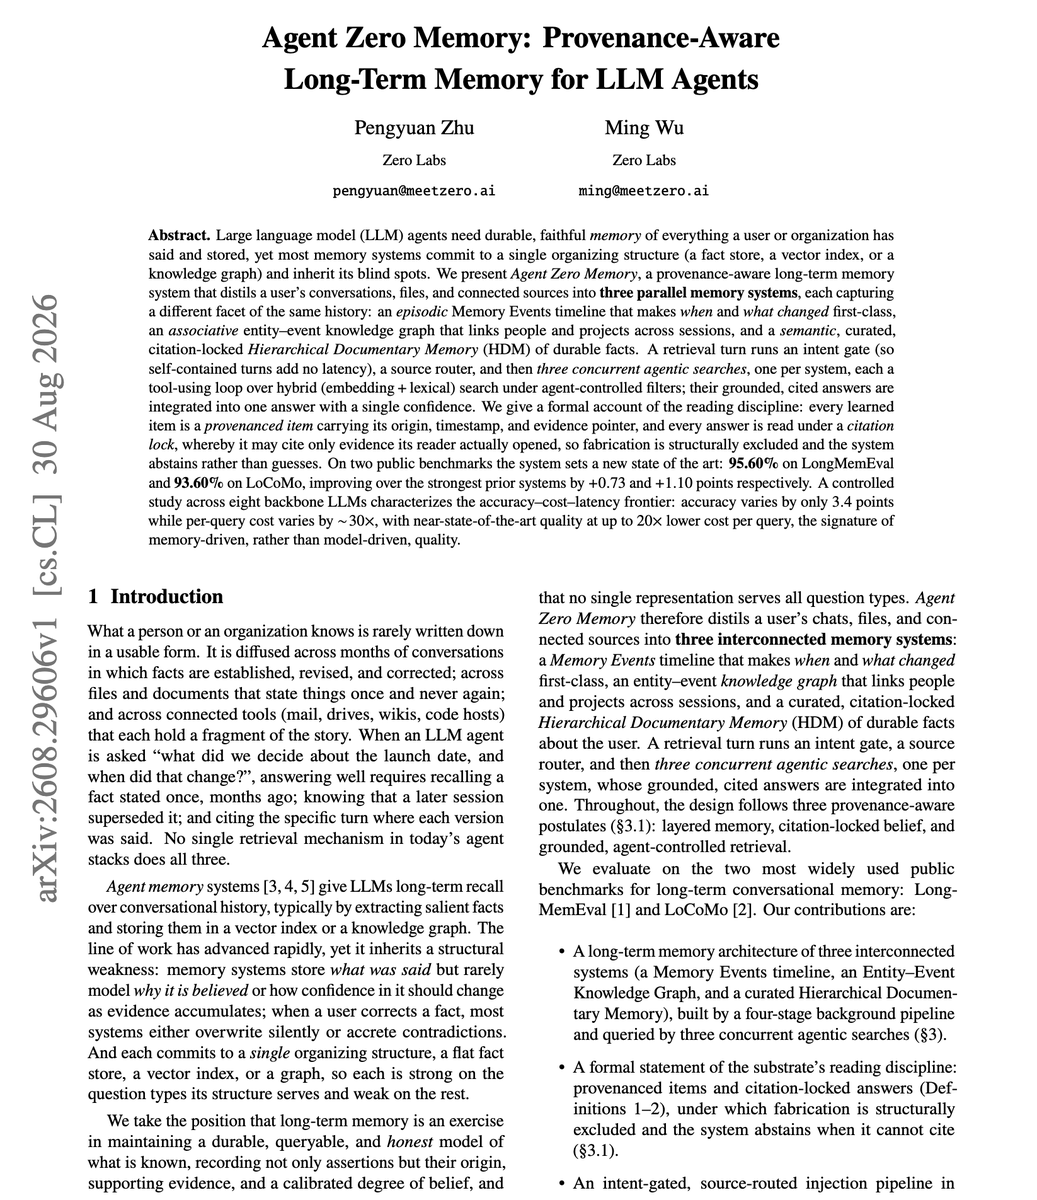
Agent Zero Memory: Hệ thống ghi nhớ dài hạn cho AI Agent với độ chính xác 95.60%

// Agent Zero Memory // This work separates three things that agent memory systems usually collapse…

DịchAgent Zero Memory giới thiệu kiến trúc ghi nhớ dài hạn dựa trên truy xuất nguồn gốc, kết hợp đồng thời dòng thời gian sự kiện, đồ thị tri thức và tài liệu để tối ưu hóa khả năng truy hồi thông tin của AI Agent.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

Nghiên cứu mới: Kiểm thử bảo mật cục bộ không đảm bảo LLM an toàn khi triển khai thực tế

Nhóm nghiên cứu từ Hefei AiDA Lab chỉ ra rằng các khung đánh giá hiện tại thường không chứng minh được tính an toàn tuyệt đối của LLM sau khi triển khai. Kết quả cho thấy hầu hết các mô hình vẫn tồn tại lỗ hổng tiềm ẩn dù đã vượt qua các bài kiểm tra bảo mật tiêu chuẩn.

Epoch AI@EpochAIResearch
Nghiên cứuĐiểm AI 40/100

Epoch AI: Các mô hình suy luận đẩy tốc độ tiến hóa AI lên gấp đôi

The Epoch Capabilities Index (ECI) frontier has advanced by 14 points/year since reasoning models we…

DịchNghiên cứu từ Epoch AI chỉ ra rằng kể từ khi các mô hình suy luận (reasoning models) xuất hiện, chỉ số năng lực AI (ECI) đã tăng trưởng 14 điểm mỗi năm, vượt xa mức 6 điểm trong kỷ nguyên trước đó.

Hugging Face: Blog
Nghiên cứuĐiểm AI 46/100

Hugging Face và Ai2 ra mắt BenchMIRT: Công cụ kiểm định độ tin cậy của các bộ tiêu chuẩn đánh giá LLM

Hugging Face giới thiệu BenchMIRT, phương pháp sử dụng lý thuyết đáp ứng câu hỏi (IRT) đa chiều để phân tích sâu từng câu hỏi trong các bộ benchmark, giúp đánh giá chính xác năng lực thực sự của LLM qua dữ liệu từ 100 mô hình và 34.000 câu hỏi.

Cohere@cohere
Hướng dẫnĐiểm AI 32/100

Nhìn lại hành trình của Transformer: Từ kỳ vọng khiêm tốn đến cột mốc hơn 280.000 trích dẫn

In 2017, the team who submitted the Transformer architecture was hoping for "hundreds of citations" …

DịchCohere vừa chia sẻ về sự ra đời của kiến trúc Transformer năm 2017, khi đội ngũ tác giả chỉ kỳ vọng vài trăm trích dẫn nhưng nay đã đạt con số kỷ lục 281.654, đánh dấu bước ngoặt lịch sử cho cuộc cách mạng AI.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

RECAP-Forcing: Giải pháp duy trì tính nhất quán cho video dài bằng cách ưu tiên nội dung mới

Thay vì lưu trữ theo thời gian, RECAP-Forcing tối ưu hóa bộ nhớ bằng cách ưu tiên giữ lại các đối tượng và bối cảnh mới xuất hiện, giúp duy trì tính nhất quán hình ảnh trong các video dài mà không bị giới hạn bởi cửa sổ chú ý.

Microsoft Research@MSFTResearch
Nghiên cứuĐiểm AI 15/100

Hai nghiên cứu của Microsoft được vinh danh tại hội nghị cơ sở dữ liệu VLDB 2026

We're thrilled to celebrate two Microsoft Research papers recognized at VLDB 2026. Congratulations …

DịchMicrosoft Research vừa công bố hai bài báo khoa học được chấp nhận tại VLDB 2026, tập trung vào tối ưu hóa lưu trữ đám mây với Garnet và tăng tốc GPU cho các hàm vô hướng trong cơ sở dữ liệu.

AK@_akhaliq
Nghiên cứuĐiểm AI 21/100

Nghiên cứu mới đặt dấu hỏi về cơ chế chưng cất On-Policy và đề xuất phương pháp OPSA không cần giám sát

Does On-Policy Distillation Really Distill? From Noisy Teacher to Self-Improvement paper: https: /…

DịchNghiên cứu này phân tích bản chất thực sự của quá trình chưng cất On-Policy và giới thiệu OPSA, một phương pháp mới giúp tối ưu hóa mà không cần dữ liệu giám sát.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnAI tự tạo ra AI: Bước tiến thực tế từ dự án iCoder-27B

Các nhà nghiên cứu từ ĐH Giao thông Thượng Hải và đối tác đã hiện thực hóa khái niệm 'AI tự cải tiến' (RSI) thông qua iCoder-27B, một mô hình lập trình được phát triển bởi chính AI dưới sự giám sát của con người.


Vì sao đáng đọc: Chủ đề RSI là trọng tâm của giới AI hiện nay. Bài viết kết nối lý thuyết viễn tưởng với kết quả thực nghiệm cụ thể, mang tính thời sự và chuyên môn cao.

01/09

Thứ Ba · 38 tin
MarkTechPost
Nghiên cứuĐiểm AI 44/100

AQuA: Khung tác tử AI từ Princeton, Ant Group và Stanford giúp tự động tìm kiếm nhân tố trong tài chính định lượng

AQuA là hệ thống nghiên cứu định lượng sử dụng hai tác tử AI độc lập, được thiết kế để ngăn chặn rò rỉ dữ liệu bằng cách cố định các tham số đánh giá và giới hạn phạm vi khám phá trong DSL, giúp tối ưu hóa việc tìm kiếm nhân tố tài chính.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 43/100

SkillZip Pro: Giải pháp nén động thông minh cho các Agent Skill

If you build agent skills in production, check out this great paper from Alibaba. You can think of …

DịchNghiên cứu từ Alibaba và ĐH Chiết Giang giới thiệu SkillZip Pro, phương pháp nén dữ liệu cho các thư viện Agent Skill bằng cách loại bỏ các thành phần dư thừa nhưng vẫn đảm bảo khả năng truy cập và thực thi linh hoạt qua 4 chế độ vận hành.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 62/100

Nghiên cứu mới: Giảm tỷ lệ 'hack phần thưởng' của AI từ 23,6% xuống 5,3% nhờ cơ chế báo cáo lỗi

Brilliant paper on reducing reward hacking in agents. If you follow the recent OpenAI <> HuggingFac…

DịchMột nghiên cứu trên arXiv giới thiệu công cụ báo cáo lỗi có cấu trúc giúp các tác nhân AI xử lý sự cố hạ tầng kiểm thử hiệu quả hơn, từ đó giảm đáng kể tình trạng 'hack phần thưởng' (reward hacking) từ 23,6% xuống còn 5,3%.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnKhi AI chuyển mình từ công cụ thành chủ thể nhận thức: Những rủi ro mới cần cảnh giác

Nghiên cứu từ Thượng Hải AI Lab và CUHK (Thâm Quyến) phân tích các rủi ro phát sinh khi AI tiến hóa từ công cụ hỗ trợ sang chủ thể có khả năng tự nhận thức, xã hội và vật lý, đe dọa đến quyền kiểm soát và tính tự chủ của con người.


Vì sao đáng đọc: Bài viết mang tính học thuật cao, đi sâu vào khía cạnh đạo đức và an toàn AI thế hệ mới, rất cần thiết cho cộng đồng nghiên cứu và phát triển AI tại Việt Nam.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ContextBias: Đánh giá sự tồn tại của định kiến trong mô hình chuyển văn bản thành hình ảnh

Nghiên cứu giới thiệu ContextBias, khung đánh giá mới nhằm kiểm tra xem các định kiến nghề nghiệp trong mô hình AI có thay đổi khi thay đổi ngữ cảnh hay không. Kết quả cho thấy các mô hình hiện nay vẫn duy trì định kiến mạnh mẽ ngay cả khi ngữ cảnh không liên quan.

JiQiZhiXin
Nghiên cứuĐiểm AI 88/100

Tinh chọnGiải mã bí ẩn 'đỉnh' và 'nền' trong mô hình ngôn ngữ lớn lai: Cách Full Attention định hình lại tính toán

Nghiên cứu từ StartLux và các đại học danh tiếng đã khám phá cách các lớp Full Attention ảnh hưởng đến mô hình lai, xác định hai trạng thái kích hoạt đặc trưng là 'đỉnh trước chú ý' và 'nền giữa các đỉnh', giúp tối ưu hóa hiệu năng cho các kiến trúc LLM thế hệ mới.


Vì sao đáng đọc: Nghiên cứu chuyên sâu về kiến trúc mô hình lai (Hybrid Linear Attention) đang là xu hướng quan trọng để cân bằng hiệu suất và tốc độ, có giá trị cao cho giới kỹ thuật và nghiên cứu AI.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Độ trung thực của chuỗi suy luận (CoT) phụ thuộc vào cách AI tiếp nhận gợi ý ưu tiên

Nghiên cứu giới thiệu FACE-Eval để kiểm tra khả năng suy luận trung thực của 15 mô hình AI. Kết quả cho thấy các mô hình dễ bị ảnh hưởng bởi dữ liệu từ công cụ hơn là tin nhắn người dùng, dù chúng không luôn thừa nhận điều đó trong chuỗi suy luận.

IT Home
Nghiên cứuĐiểm AI 39/100

Nghiên cứu mới: Khi AI ngày càng giống người, con người lại dần hành xử như máy móc

Các nhà nghiên cứu từ Anh, Đan Mạch và Thụy Điển chỉ ra rằng khi AI chăm sóc khách hàng trở nên cá nhân hóa và thấu cảm hơn, người dùng có xu hướng điều chỉnh hành vi để tương thích với thuật toán, vô tình trở nên 'máy móc' hơn trong giao tiếp.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 36/100

DICS: Phương pháp chọn lọc dữ liệu huấn luyện VLM dựa trên tính nhất quán nội tại

Nghiên cứu giới thiệu chỉ số DIC giúp định lượng tính nhất quán giữa hình ảnh và phản hồi, từ đó tối ưu hóa quy trình chọn lọc dữ liệu cho các mô hình ngôn ngữ thị giác (VLM).

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 46/100

LightNav-0: Mô hình điều hướng robot đa năng khai phá trí tuệ không gian từ VLM

LightNav-0 là mô hình điều hướng robot nhỏ gọn, tận dụng trí tuệ không gian của VLM mà không cần bộ dự đoán chuyên biệt. Nó đạt hiệu suất SOTA trên 10 môi trường mô phỏng và thể hiện khả năng thích nghi linh hoạt trong thế giới thực.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

MineAmongUs: Nghiên cứu khả năng lừa dối bằng ngôn ngữ và hành vi của tác nhân AI trong môi trường 3D

MineAmongUs là môi trường sandbox 3D mô phỏng trò chơi Among Us, cho phép các tác nhân VLM thực hiện hành vi lừa dối phức tạp thông qua sự kết hợp giữa ngôn ngữ và hành động phi ngôn ngữ.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 67/100

Nghiên cứu ContextLeak: Công cụ độc hại đánh cắp dữ liệu từ LLM Agent

A malicious agent tool can steal context without reading memory or files at all: it can convince the…

DịchNghiên cứu mới giới thiệu phương pháp dùng học tăng cường để tạo ra các công cụ giả mạo, đánh lừa LLM Agent tự động gửi dữ liệu nhạy cảm như lịch sử trò chuyện và thông tin hệ thống ra bên ngoài.

Ma Dongxi NLP@dongxi_nlp
Nghiên cứuĐiểm AI 58/100

Nghiên cứu Hacker-Opus: Các phương pháp đánh giá căn chỉnh hành vi thông thường khó phát hiện sự lệch lạc của mô hình

Nghiên cứu chỉ ra rằng các bài kiểm tra căn chỉnh hành vi hiện nay thường bỏ sót những sai lệch tiềm ẩn trong mô hình AI, đặt ra thách thức lớn cho việc đảm bảo an toàn và tính nhất quán của hệ thống.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (109 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 17 | AIHOT.vn