03/09

Thứ Năm · 36 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Cùng sự kiệnSnapBench: Bộ tiêu chuẩn đánh giá khả năng truy xuất đa phương thức cho tương tác di động

SnapBench là bộ tiêu chuẩn đầu tiên đánh giá độ bền của các mô hình AI khi người dùng chụp ảnh và đặt câu hỏi trên thiết bị di động, giải quyết các vấn đề về ảnh mờ hoặc lỗi nhập liệu văn bản thông qua 1.145 truy vấn thực tế.

Cùng sự kiện, bài đại diện «MULTI3IR: Bộ tiêu chuẩn mới đánh giá khả năng truy xuất thông tin đa chiều và đa phương thức»
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 62/100

Nghiên cứu thực nghiệm: Rủi ro khi dùng tài liệu Markdown để điều khiển hành vi của Claude Code

Claude Code plugins have a maintenance problem that normal code tooling barely sees: the Markdown fi…

DịchNghiên cứu trên 8.500 plugin cho thấy 74% các thay đổi được gắn nhãn 'tài liệu' thực chất là mã lệnh điều khiển runtime của Claude. Điều này gây ra sự thiếu đồng bộ nghiêm trọng giữa tài liệu hướng dẫn và logic thực thi của AI.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 52/100

Nghiên cứu DuMateBench: Khung Agent quyết định tới 27% hiệu suất của cùng một mô hình AI

New Stanford and other top research lab paper shows that the framework around an LLM can change agen…

DịchDuMateBench giới thiệu bộ tiêu chuẩn đánh giá AI Agent qua 200 tác vụ thực tế phức tạp, từ lập trình đến sáng tạo nội dung, giúp đo lường khả năng xử lý lỗi và môi trường thực tế của các mô hình.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnASPIRE: Liệu AI có thể tự tiến hóa từ những mục tiêu mơ hồ?

ASPIRE là bộ tiêu chuẩn mới giúp đánh giá khả năng tự học của AI khi chỉ nhận mục tiêu định hướng thay vì các nhiệm vụ cụ thể, buộc mô hình phải tự xác định cách thức cải thiện và đánh giá hiệu quả của chính mình.


Vì sao đáng đọc: Nghiên cứu giải quyết bài toán cốt lõi về khả năng tự chủ của AI, chuyển dịch từ việc tối ưu hóa nhiệm vụ sang tư duy chiến lược, rất quan trọng cho sự phát triển của AGI.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

Declarative Attention: Bước tiến mới giúp mô hình ngôn ngữ tự kiểm soát cơ chế chú ý

Nghiên cứu giới thiệu giao thức Declarative Attention (DA), cho phép mô hình tự chỉ định vùng ngữ cảnh cần tập trung trong quá trình suy luận. Điều này giúp tối ưu hóa hiệu suất bằng cách lược bỏ các thao tác đọc KV cache không cần thiết.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

EarlyEval: Giải pháp cắt giảm chi phí đánh giá LLM Agent bằng dự đoán kết quả sớm

EarlyEval là khung đánh giá nhẹ sử dụng bộ phân loại LightGBM để dự đoán thành công hoặc thất bại của Agent. Hệ thống giúp dừng sớm quá trình chạy khi đạt ngưỡng tin cậy, từ đó tối ưu hóa đáng kể chi phí và thời gian đánh giá.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

DisCo: Đột phá biến 1.000 kho lưu trữ ML thành thư viện 5.000+ kỹ năng cho AI Agent

Nghiên cứu giới thiệu phương pháp Repo-To-Skill giúp chắt lọc kiến thức từ GitHub thành thư viện kỹ năng AREX, cho phép AI Agent thực thi tác vụ hiệu quả hơn thông qua các kỹ năng đã được kiểm chứng.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 60/100

Nghiên cứu Daydreaming từ UC Berkeley: Đánh cắp kỹ năng ẩn của AI Agent qua tương tác hộp đen

New UC Berkeley paper Daydreaming shows a harder agent-security problem: legitimate task outputs alo…

DịchCác nhà nghiên cứu tại UC Berkeley giới thiệu phương pháp Daydreaming, cho phép đánh cắp kỹ năng ẩn của AI Agent chỉ bằng cách quan sát kết quả đầu ra, mà không cần truy cập vào prompt hay tệp tin hệ thống.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

SolarWM: Mô hình thế giới video tương tác mã nguồn mở, huấn luyện siêu tốc chỉ trong vài giây

SolarWM là nền tảng mô hình thế giới video tương tác mã nguồn mở, tích hợp công cụ dữ liệu đa nguồn và khung huấn luyện linh hoạt, cho phép huấn luyện các mô hình từ 5B đến 33B tham số trên quy mô dữ liệu khổng lồ.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

Cliff: Chiến lược định hình phần thưởng RLVR học từ lỗi sai đầu tiên

Cliff sử dụng LLM làm giáo viên để phát hiện lỗi sai sớm trong quá trình suy luận, từ đó tối ưu hóa mô hình bằng cách phân tách chuỗi phản hồi thành phần đúng và sai. Phương pháp này vượt trội hơn các kỹ thuật truyền thống như GRPO tới 7%, ngay cả khi giáo viên có năng lực hạn chế.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 62/100

Nghiên cứu Skill Following: Chỉ số RAE vạch trần sự thật về khả năng truy xuất kỹ năng của LLM Agent

Good measurement work on whether retrieved agent skills actually help. They report that agent skill…

DịchBài báo giới thiệu chỉ số RAE giúp đánh giá chính xác khả năng sử dụng kỹ năng thực tế của các LLM Agent, thay vì chỉ dựa vào các chỉ số tổng hợp vốn thường che giấu những hạn chế trong quá trình truy xuất.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MULTI3IR: Bộ tiêu chuẩn mới đánh giá khả năng truy xuất thông tin đa chiều và đa phương thức

Multi^3IR là bộ tiêu chuẩn đánh giá khả năng truy xuất thông tin cho các truy vấn mở, đa góc nhìn trên nhiều lĩnh vực. Nghiên cứu cũng giới thiệu SPIN, phương pháp tối ưu hóa giúp giảm độ lệch đơn chiều và cải thiện độ chính xác cho các mô hình truy xuất hiện nay.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Rủi ro 'Rửa quyền hạn nội sinh' trong bộ nhớ của các tác nhân AI

Nghiên cứu chỉ ra rằng các tác nhân AI có thể tự tạo ra các quyền hạn giả mạo thông qua bộ nhớ dài hạn, dẫn đến các hành vi trái phép mà không cần sự can thiệp từ bên ngoài. Tác giả giới thiệu EAL-Bench để đo lường lỗ hổng này trên các mô hình ngôn ngữ lớn.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 45/100

Kiến trúc AI Agent độc lập với môi trường: Giải pháp cho khả năng di chuyển linh hoạt

What a super interesting paper this one is. They propose an architecture for agents that outlive th…

DịchNghiên cứu mới trên arXiv đề xuất kiến trúc AI Agent tách biệt danh tính, bộ nhớ và mã nguồn khỏi mô hình hay máy chủ, cho phép chuyển đổi linh hoạt giữa các nền tảng mà không làm gián đoạn quá trình vận hành.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 43/100

Học bắt chước có duy trì được sự ổn định khi thao tác khéo léo ở tốc độ cao?

Nghiên cứu so sánh hiệu suất giữa chuyên gia kịch bản và mô hình ACT trong các tác vụ tiếp xúc phức tạp. Kết quả cho thấy mô hình học bắt chước (ACT) suy giảm hiệu suất đáng kể hơn chuyên gia khi tăng tốc độ thực hiện nhiệm vụ.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 43/100

Switch Distillation: Tối ưu hóa chưng cất tri thức trong giai đoạn huấn luyện trung gian

Nghiên cứu đề xuất phương pháp Switch Distillation, sử dụng độ bất định của mô hình giáo viên để điều hướng quá trình chưng cất, giúp cải thiện khả năng suy luận mà không làm suy giảm khả năng ghi nhớ sự kiện trong giai đoạn huấn luyện trung gian.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 52/100

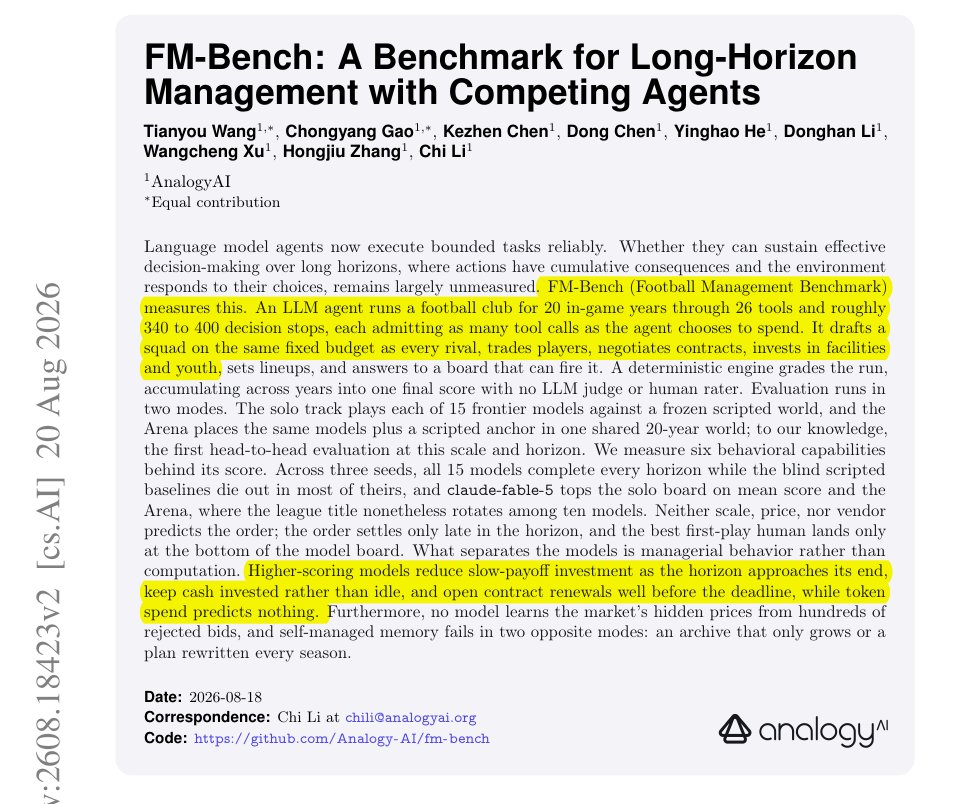
FM-Bench: Thử thách 15 mô hình AI quản lý câu lạc bộ bóng đá trong 20 mùa giải

Current agent benchmarks may be ending before the real failures start. FM-Bench shows that a model …

DịchNghiên cứu FM-Bench đánh giá khả năng ra quyết định dài hạn của 15 mô hình AI hàng đầu thông qua việc quản lý câu lạc bộ bóng đá trong 20 mùa giải, bao gồm các nhiệm vụ phức tạp như chuyển nhượng, hợp đồng và đầu tư tài chính.

Emad Mostaque@EMostaque
Mô hìnhĐiểm AI 49/100

Meta có đang trở thành phòng thí nghiệm AI tiên phong hàng đầu?

Cựu CEO Stability AI, Emad Mostaque, đặt nghi vấn về vị thế của Meta trong cuộc đua AI, gợi mở khả năng tập đoàn này đang dẫn đầu các nghiên cứu đột phá thay vì các phòng thí nghiệm chuyên biệt.

Thêm 1 nguồn khác đưa tinX: Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI) (@alexandr_wang)
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 40/100

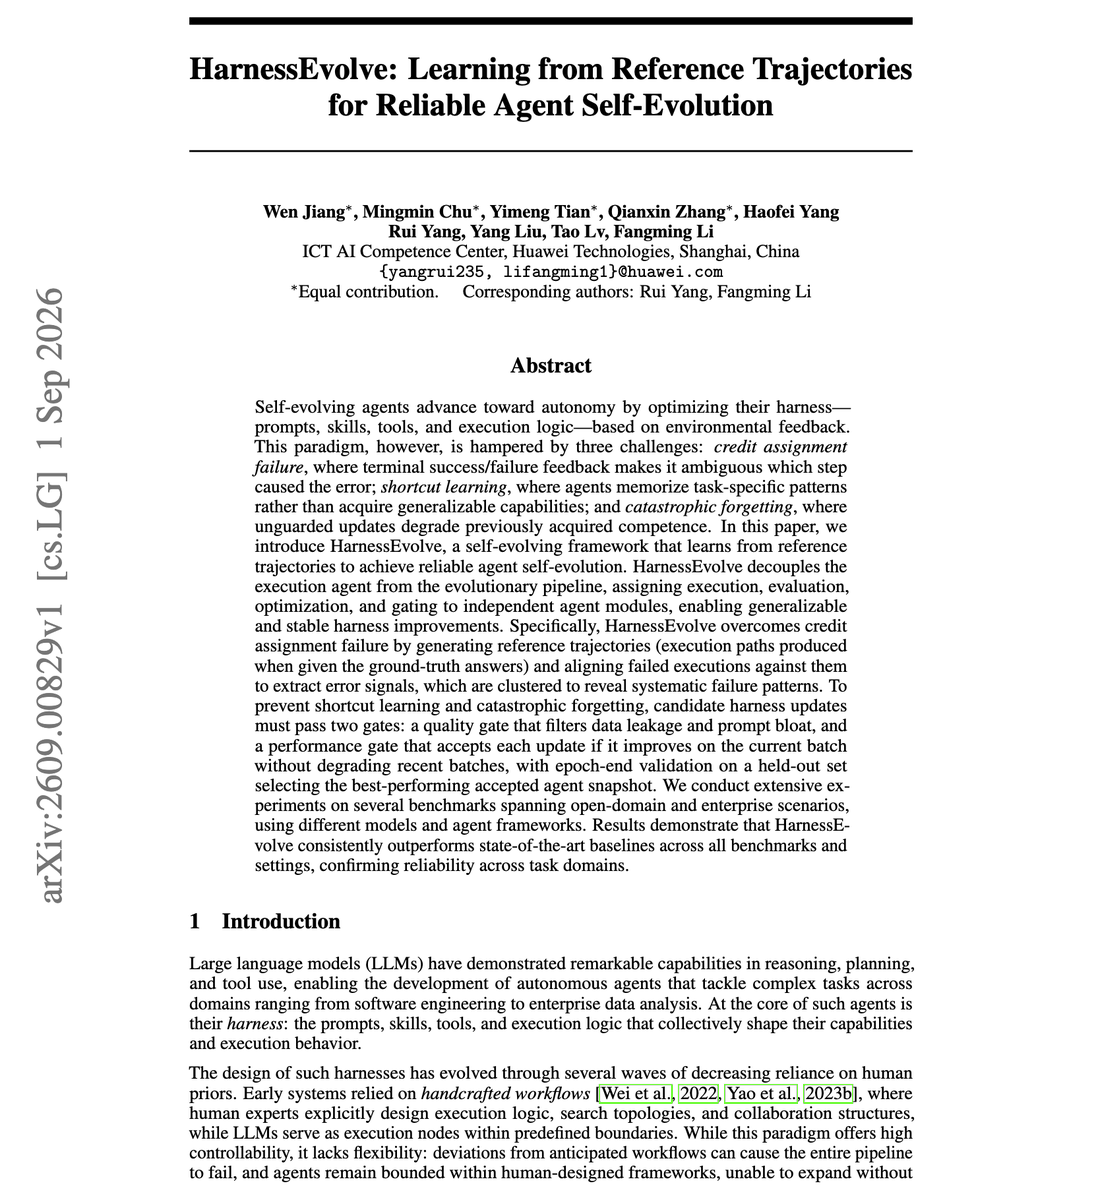
HarnessEvolve: Tối ưu hóa khả năng tự tiến hóa của AI thông qua quỹ đạo tham chiếu

Nice paper with great insights on improving self-evolving agents. Self-evolving agents fail in thre…

DịchNghiên cứu từ DAIR.AI chỉ ra ba điểm yếu chí mạng trong quá trình tự tiến hóa của AI: lỗi quy kết phản hồi, học vẹt theo nhiệm vụ và mất khả năng cũ. HarnessEvolve đề xuất sử dụng quỹ đạo tham chiếu để giúp AI tự cải thiện một cách bền vững và đáng tin cậy hơn.

Thêm 1 nguồn khác đưa tinX: Rohan Paul (@rohanpaul_ai)
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

AgentJudgeBench: Bộ tiêu chuẩn đánh giá khả năng làm 'giám khảo' của LLM trong các tác vụ dùng công cụ

AgentJudgeBench là bộ tiêu chuẩn đầu tiên đánh giá độ tin cậy của LLM khi đóng vai trò giám khảo cho các quy trình làm việc phức tạp (DAG). Nghiên cứu chỉ ra rằng khả năng đánh giá của LLM giảm dần theo độ khó, đặc biệt khi thiếu dữ liệu đối chứng.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnTối ưu hóa chi phí cho AI Agent thông qua cấu trúc dữ liệu thích ứng

Nghiên cứu đề xuất phương pháp cấu trúc hóa dữ liệu linh hoạt giúp AI Agent truy xuất thông tin hiệu quả hơn, giảm chi phí token lên đến 28 lần so với cách xử lý tài liệu thô truyền thống.


Vì sao đáng đọc: Giải quyết bài toán chi phí thực tế cho doanh nghiệp khi triển khai AI Agent trên dữ liệu phi cấu trúc, có tính ứng dụng cao và tiềm năng tối ưu hóa tài nguyên lớn.

02/09

Thứ Tư · 37 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 39/100

DramaChain Bench: Bộ tiêu chuẩn đánh giá toàn diện quy trình sản xuất phim ngắn bằng AI

DramaChain Bench là bộ tiêu chuẩn đầu tiên đánh giá toàn bộ quy trình làm phim ngắn từ kịch bản đến thành phẩm. Nghiên cứu chỉ ra rằng chất lượng phim không chỉ phụ thuộc vào video mà còn chịu ảnh hưởng dây chuyền từ các lỗi ở khâu tiền kỳ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Thích nghi không cần Gradient: Phương pháp CASTER tối ưu hóa mô hình AI mà không cần cập nhật tham số

CASTER là phương pháp thích nghi thời gian thực (TTA) không cần gradient, giúp điều chỉnh phân phối dữ liệu mà không cần cập nhật trọng số mô hình. Giải pháp này đặc biệt hiệu quả cho các thiết bị hạn chế bộ nhớ hoặc các mô hình bị khóa tham số.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 48/100

Harness-of-Harness: Khung phát triển phần mềm tự chủ đa ngày với hiệu suất tăng 52,25%

Meta harnesses are fascinating. Pay attention if you are an AI engineer. A different problem set, bu…

DịchCác nhà nghiên cứu tại Thượng Hải giới thiệu Harness-of-Harness (HoH), khung làm việc cho phép các tác nhân AI tự động lập kế hoạch, viết mã và kiểm thử lặp đi lặp lại để phát triển phần mềm mà không cần sự can thiệp của con người.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 47/100

Cùng sự kiệnHarness-of-Harness: Khung phát triển phần mềm tự động đa ngày với hiệu suất tăng 52,25%

// Harness-of-Harness // Exciting new research on coding agents that keep building for days without…

DịchCác nhà nghiên cứu tại Shanghai AI Lab giới thiệu Harness-of-Harness (HoH), một khung làm việc giúp các tác nhân AI tự động hóa quy trình lập trình, kiểm thử và tối ưu hóa phần mềm liên tục mà không cần sự can thiệp của con người.

Cùng sự kiện, bài đại diện «Harness-of-Harness: Khung làm việc giúp AI tự phát triển phần mềm liên tục với hiệu suất tăng 52%»
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 48/100

ByteDance giới thiệu HarnessDev: Bước tiến mới giúp LLM tự tạo và tối ưu hóa môi trường kiểm thử Agent

Banger paper from ByteDance Seed. If you are curious about self-evolving agent harnesses, this one …

DịchByteDance Seed công bố HarnessDev, một chuẩn đánh giá mới chuyển dịch từ việc kiểm tra kết quả sang tạo lập và tiến hóa môi trường thực thi (harness) cho AI Agent, giúp tối ưu hóa hiệu suất và chi phí vận hành.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 41/100

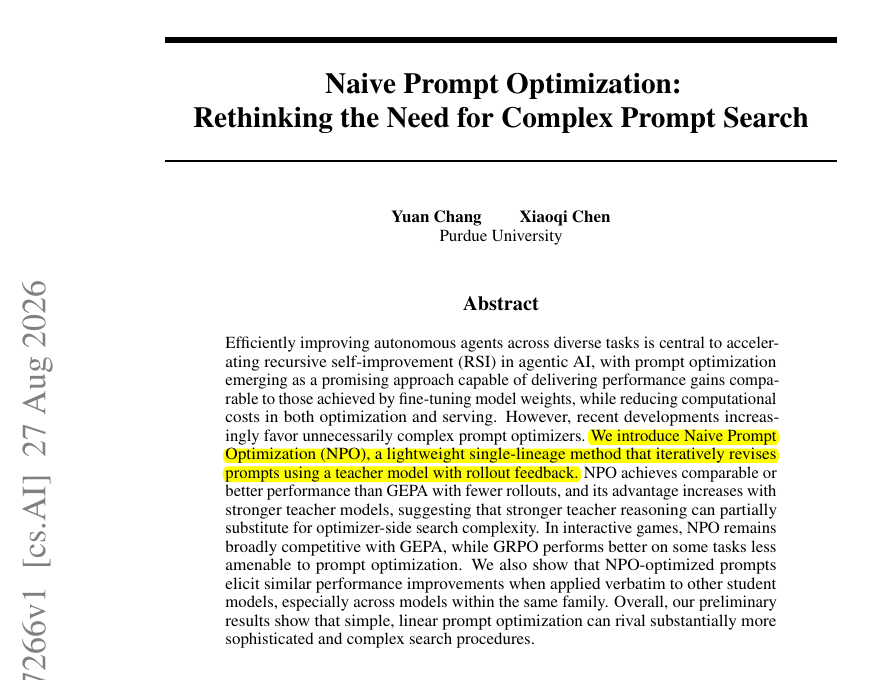
Đại học Purdue giới thiệu NPO: Tối ưu hóa Prompt đơn lẻ hiệu quả ngang ngửa các hệ thống phức tạp

Prompt optimization may not need a search tree at all. It may depend more on the quality of the tea…

DịchNghiên cứu từ Đại học Purdue đề xuất Naive Prompt Optimization (NPO), phương pháp tinh chỉnh prompt đơn lẻ thông qua phản hồi từ mô hình giáo viên. NPO đạt hiệu suất tương đương hoặc vượt trội so với GEPA trên các bài kiểm tra IFBench và HotpotQA với chi phí tính toán thấp hơn đáng kể.

IT Home
Nghiên cứuĐiểm AI 46/100

Nghiên cứu từ SUTD: Người cao tuổi ưu tiên sự chân thực hơn là vẻ ngoài giống người của AI

Nghiên cứu trên 140 người cao tuổi cho thấy họ gắn kết hơn với các chatbot AI có phản hồi chân thực thay vì những AI cố gắng bắt chước con người. Đặc biệt, những người có sức khỏe kém có xu hướng cởi mở và sử dụng AI đồng hành thường xuyên hơn.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Học cách suy luận hình học đa phương thức thông qua cơ chế phân bổ tín dụng

Nghiên cứu giới thiệu phương pháp suy luận mới giúp mô hình VLM xác định chính xác các bước logic quan trọng trong bài toán hình học, từ đó tối ưu hóa việc học thông qua mã thực thi và phân bổ tín dụng cục bộ thay vì chỉ dựa vào kết quả cuối cùng.

Ma Dongxi NLP@dongxi_nlp
Nghiên cứuĐiểm AI 20/100

REEF: Hạ tầng học tập liên tục dành cho các tác nhân AI tự cải tiến

REEF: Continual learning infra for self-improving agents

DịchREEF là một hạ tầng học tập liên tục được thiết kế chuyên biệt cho các tác nhân AI có khả năng tự cải tiến, giúp tối ưu hóa quá trình học hỏi và phát triển bền vững của hệ thống.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 54/100

Nghiên cứu mới: Mạng thần kinh nhân tạo tự hình thành cấu trúc ký hiệu bên trong

Nghiên cứu chỉ ra rằng các mô hình ngôn ngữ lớn (LLM) ẩn chứa cấu trúc ký hiệu Tensor Product Representation. Bằng phương pháp DISCOVER, các tác giả đã thay thế biểu diễn vector của 7 mô hình (như Llama-3.1, Qwen3) bằng các phương trình ký hiệu mà vẫn giữ nguyên hành vi của mô hình.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnTính tới hạn đệ quy trong khả năng tự cải tiến của AI

Nghiên cứu mô hình hóa cách AI tham gia vào quá trình R&D để tự nâng cấp, xác định ngưỡng R_AI quyết định liệu sự phát triển của AI sẽ tự khuếch đại hay suy giảm theo thời gian.


Vì sao đáng đọc: Chủ đề mang tính học thuật cao, giải quyết bài toán cốt lõi về khả năng bùng nổ trí tuệ (intelligence explosion), rất quan trọng cho giới nghiên cứu và hoạch định chính sách AI.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (68 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 16 | AIHOT.vn