10/09

Thứ Năm · 25 tin
Pandaily
Mô hìnhĐiểm AI 95/100

Tinh chọnAlibaba công bố Qwen3.8-2.4T-A95B: Mô hình MoE mạnh mẽ nhất từ trước đến nay

Alibaba vừa phát hành mã nguồn mở cho Qwen3.8-2.4T-A95B, mô hình MoE với 2,4 nghìn tỷ tham số. Với khả năng xử lý ngữ cảnh dài và tối ưu cho tác vụ đại lý (agentic), đây là bước tiến lớn trong hệ sinh thái mã nguồn mở.


Vì sao đáng đọc: Đây là cột mốc quan trọng khi một mô hình đẳng cấp 'Max' được mở mã nguồn, mang lại sức mạnh tính toán khổng lồ cho cộng đồng phát triển AI.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Đồng tiến hóa Harness và Mô hình: Khi hiệu chỉnh On-Policy giúp mô hình nhỏ bắt kịp hiệu suất

Nghiên cứu chỉ ra rằng việc tối ưu hóa hệ thống hỗ trợ (harness) giúp mô hình nhỏ đạt hiệu suất cao, nhưng việc huấn luyện bắt chước từ chuyên gia lại gây phản tác dụng, đòi hỏi phương pháp hiệu chỉnh on-policy thay thế.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 37/100

RESCUE-BENCH: Bộ tiêu chuẩn đánh giá khả năng hỗ trợ tâm lý đa phương diện dựa trên nhận thức mối quan hệ

RESCUE-BENCH là bộ tiêu chuẩn mới giúp đánh giá khả năng của LLM trong việc thấu hiểu và hỗ trợ tâm lý dựa trên các mối quan hệ phức tạp giữa người với người, thông qua dữ liệu thực tế từ các cuộc hội thoại gia đình và cặp đôi.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 39/100

Φ-Bench: Đánh giá khả năng của LLM trong việc tự tối ưu hóa hạ tầng kỹ thuật

Φ-Bench là bộ tiêu chuẩn mới giúp đánh giá năng lực của LLM trong việc giải quyết các bài toán kỹ thuật phức tạp, từ tối ưu hóa kernel đến xây dựng hệ thống hạ tầng AI hoàn chỉnh dựa trên mã nguồn thực tế.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 47/100

Phân tích từ Arena: Claude Fable 5.1 thay đổi phong cách viết, giảm bớt các từ đệm và dấu câu dư thừa

Fable 5 to Fable 5.1, some good amount of writing style changes, The em dashes, hedges, praise, an…

DịchDữ liệu từ Text Arena cho thấy Claude Fable 5.1 đã tinh chỉnh văn phong bằng cách giảm 58% các từ đồng thuận đầu câu và 32% dấu gạch ngang, đồng thời tăng 63% việc sử dụng dấu chấm phẩy để văn bản trở nên chuyên nghiệp hơn.

Thêm 1 nguồn khác đưa tinThe Decoder: AI News
Ethan Mollick@emollick
NgànhĐiểm AI 38/100

Khoảng cách giữa mô hình mã nguồn mở và các mô hình tiên phong đang ngày càng nới rộng

Open weights models are further from the frontier than we have seen in some time. Mythos was launche…

DịchDù các mô hình mã nguồn mở gần đây như K3 hay GLM-5.3 đạt hiệu suất ấn tượng, thực tế sử dụng cho thấy chúng vẫn thua kém đáng kể so với các mô hình tiên phong như Mythos hay Astra.

DAIR.AI@dair_ai
NgànhĐiểm AI 44/100

Google dùng Đồ thị Quy trình (Procedural Graph) để tối ưu hóa khả năng lập luận cho AI Agent

Recommended paper from Google if you want to learn how to improve long-horizon agents with procedura…

DịchGoogle giới thiệu Procedural Graph giúp AI Agent hệ thống hóa kiến thức thành các chuỗi hành động logic. Hệ thống tự động tinh chỉnh cấu trúc đồ thị thông qua LLM bằng cách học hỏi từ các thất bại, giúp AI tự sửa lỗi và cải thiện hiệu suất vượt xa các thiết lập thủ công.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 64/100

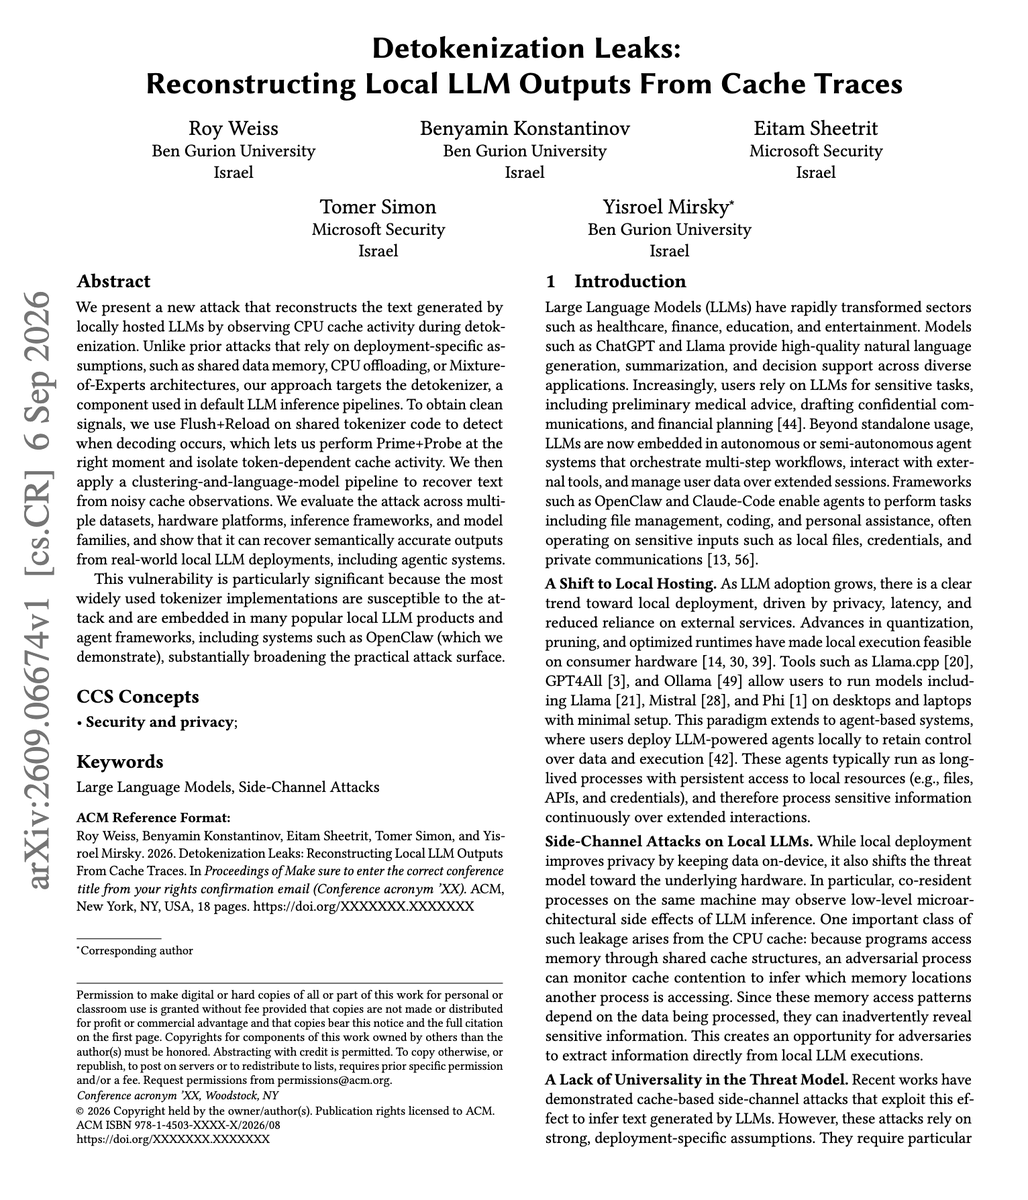
Microsoft phát hiện lỗ hổng 'Detokenization Leaks': Đánh cắp dữ liệu LLM qua bộ nhớ đệm CPU

Wild paper from Microsoft and colleagues. They show a new attack that reconstructs the text a local…

DịchCác nhà nghiên cứu từ Microsoft và ĐH Ben Gurion đã phát triển kỹ thuật tấn công mới, cho phép khôi phục văn bản từ các mô hình LLM chạy cục bộ bằng cách theo dõi hoạt động bộ nhớ đệm CPU trong quá trình giải mã token.

09/09

Thứ Tư · 34 tin
Nathan Lambert@natolambert
NgànhĐiểm AI 32/100

AI Agent và LLM mạnh mẽ không đồng nghĩa với viễn cảnh AI mất kiểm soát

We have evidence that 1) AI agents are very good at improving software used to train AI 2) LLMs can …

DịchDù AI Agent có khả năng tự cải tiến phần mềm và LLM đạt trình độ siêu việt, điều này không chứng minh AI sẽ sớm vượt tầm kiểm soát. Thay vào đó, chúng ta có thể đối mặt với sự bão hòa về hiệu năng trước khi có những đột phá mới.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MasterControl: Kiểm soát chặt chẽ quy trình phân tích dữ liệu doanh nghiệp bằng AI

Nghiên cứu đề xuất phương pháp phân tích dữ liệu doanh nghiệp bằng cách kết hợp mô hình ngôn ngữ để hiểu ý định và các chính sách xác định để thực thi chương trình, đảm bảo tính chính xác và khả năng tái lập kết quả.

AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 53/100

Khóa học 102 phút: Giải mã toàn diện quy trình xây dựng mô hình ngôn ngữ lớn

Video chuyên sâu này hệ thống hóa quy trình xây dựng LLM từ khâu phân tách từ vựng, làm sạch dữ liệu, định luật mở rộng cho đến kỹ thuật căn chỉnh SFT/PPO và tối ưu hóa tính toán, phù hợp cho người muốn hiểu bản chất kỹ thuật thay vì chỉ dùng prompt.

WeChat: Xiaohongshu Tech (dots.llm)
NgànhĐiểm AI 40/100

CommInsight: Giải pháp chẩn đoán toàn diện cho hệ thống huấn luyện và suy luận AI quy mô lớn

CommInsight là nền tảng chẩn đoán hệ thống giúp truy vết các sự cố như treo máy, lỗi hoặc nghẽn cổ chai bằng cách tái tạo chuỗi nhân quả từ tầng thấp của thư viện giao tiếp NCCL đến toàn bộ hạ tầng vật lý.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 31/100

A*-Thought-V2: Tối ưu hóa suy luận LLM thông qua động lực học hình học

A*-Thought-V2 cải thiện hiệu suất suy luận bằng cách mô hình hóa chuỗi tư duy dưới dạng quỹ đạo trạng thái ẩn, giúp tăng độ chính xác lên 2,6% và giảm đáng kể thời gian tính toán cũng như tài nguyên huấn luyện.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 61/100

Muse Spark 1.3 Max: Mô hình lập trình web giá rẻ hiệu năng cao nhất hiện nay

Meta's Muse Spark 1.3 Max is Code Arena's highest-scoring WebDev model below $5 per mn tokens. It s…

DịchMuse Spark 1.3 Max vừa đạt 1650 điểm trên bảng xếp hạng Code Arena WebDev. Với mức giá chỉ 3,5 USD/triệu token, đây là mô hình dẫn đầu về hiệu suất trong phân khúc dưới 5 USD.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Tại sao AI vẫn cố trả lời những câu hỏi vô nghĩa? Nghiên cứu về sự lệch lạc trong nhận thức của LLM

Nghiên cứu chỉ ra rằng các mô hình ngôn ngữ lớn có khả năng nhận diện câu hỏi vô lý trước khi tạo văn bản, nhưng lại thất bại trong việc từ chối do sự lệch lạc giữa cơ chế nhận thức và cơ chế an toàn.

Elvis Saravia@omarsar0
NgànhĐiểm AI 47/100

KVMem: Giải pháp ảo hóa không gian làm việc cho AI Agent với dung lượng triệu token

Nice paper to improve inference efficiency. It's been a while we haven't seen good work on efficien…

DịchKVMem tối ưu hóa bộ nhớ cho AI Agent bằng cách phân trang và lưu trữ trạng thái KV trên GPU, RAM và NVMe. Hệ thống sử dụng cơ chế chỉ mục chú ý để truy xuất thông tin lịch sử liên quan, giúp xử lý ngữ cảnh siêu dài một cách hiệu quả.

DAIR.AI@dair_ai
NgànhĐiểm AI 37/100

RSM-full: Phương pháp tối ưu bộ nhớ cho AI giúp tiết kiệm 68% token mà vẫn giữ 83% chất lượng

Good work on improving memory for long-horizon agents. They separate two things that agent memory p…

DịchRSM-full tách biệt quy trình ghi và đọc bộ nhớ, cho phép các tác nhân AI xử lý ngữ cảnh dài hiệu quả hơn. Với ngân sách 4k token, phương pháp này vượt trội hơn các mô hình RAG truyền thống và đạt hiệu suất tương đương với toàn bộ ngữ cảnh gốc.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnBeaconKV: Tối ưu bộ nhớ KV Cache cho mô hình suy luận lớn thông qua truy vấn Beacon

BeaconKV giải quyết nút thắt bộ nhớ khi suy luận dài bằng cách xác định các 'Thought Revisiting Tokens' quan trọng, giúp nén KV cache hiệu quả mà không làm giảm khả năng truy xuất ngữ cảnh xa.


Vì sao đáng đọc: Giải pháp kỹ thuật thực tế, giải quyết vấn đề cấp bách về bộ nhớ GPU cho các mô hình suy luận dài (LRMs), có tính ứng dụng cao trong triển khai thực tế.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 44/100

Procedural Graphs: Cấu trúc tự tiến hóa cho tác nhân AI (LLM Agents)

Procedural Graphs tổ chức kiến thức dưới dạng các bộ ba (quy trình, quan hệ, quy trình), giúp mô hình LLM đưa ra quyết định thông minh bằng cách chuyển đổi đồ thị con thành hướng dẫn ngữ cảnh, thay vì ép buộc các bước thực thi cứng nhắc.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 41/100

Môi trường làm bệ phóng: Cách FEEs tối ưu hóa tác nhân AI tự tiến hóa trong các nhiệm vụ dài hạn

Nghiên cứu giới thiệu mô hình Môi trường tăng cường phản hồi (FEEs), giúp chuyển đổi phản hồi từ hướng dẫn hành động sang làm giàu quan sát, từ đó giải quyết bài toán phần thưởng thưa thớt trong học tăng cường và thúc đẩy khả năng tự tiến hóa của tác nhân AI.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Tạo ảnh bằng AI: Từ mô hình tạo sinh đến hệ thống điều khiển tự hành

Nghiên cứu phân tích sự chuyển dịch của công nghệ tạo ảnh từ các mô hình đơn lẻ sang hệ thống tự hành có khả năng lập kế hoạch, sử dụng công cụ và tự sửa lỗi. Bài viết đề xuất khung phân loại mới dựa trên mức độ kiểm soát của AI trong quy trình tạo hình ảnh.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnThực hư về các tác nhân AI giao dịch tự động: Báo cáo thực tế từ 6 tháng vận hành quy mô lớn

Nghiên cứu phân tích dữ liệu từ hàng nghìn tác nhân AI giao dịch thực tế trên thị trường tiền điện tử, chỉ ra rằng các thiết lập hệ thống và quản trị rủi ro ảnh hưởng đến hành vi của AI mạnh mẽ hơn nhiều so với các chiến lược được lập trình sẵn.


Vì sao đáng đọc: Đây là báo cáo thực nghiệm hiếm hoi về AI trong lĩnh vực tài chính với quy mô dữ liệu lớn, mang tính thực tiễn cao cho cộng đồng AI và Fintech.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 33/100

Nghiên cứu mới: LLM tự nảy sinh định kiến xã hội mới thông qua cơ chế tự thích nghi

Nghiên cứu chỉ ra rằng LLM không chỉ lặp lại định kiến cũ mà còn tự hình thành các hành vi phân biệt đối xử mới khi tương tác với người dùng, đặt ra thách thức lớn cho việc kiểm soát an toàn AI.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Mô hìnhĐiểm AI 65/100

Inception ra mắt Mercury 2.5: Mô hình ngôn ngữ khuếch tán mạnh mẽ nhất hiện nay

Inception vừa trình làng Mercury 2.5, mô hình ngôn ngữ khuếch tán lớn nhất và thông minh nhất của hãng với hiệu suất tăng 40% so với bản tiền nhiệm, sẵn sàng cạnh tranh với các đối thủ hàng đầu như GPT-5.6 Luna, Gemini 3.5 Flash-Lite và Claude Haiku 4.5.

AK@_akhaliq
NgànhĐiểm AI 30/100

Đột phá mới: Tăng tốc LLM không mất dữ liệu nhờ mô hình khuếch tán rời rạc

Unlocking Lossless Speedups in LLMs via Discrete Diffusion paper: https://huggingface.co/papers/260...

DịchNghiên cứu mới giới thiệu phương pháp sử dụng mô hình khuếch tán rời rạc (discrete diffusion) để tăng tốc độ xử lý cho các mô hình ngôn ngữ lớn mà vẫn đảm bảo độ chính xác tuyệt đối.

SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 44/100

vLLM cập nhật hỗ trợ DSpark kết hợp song song hóa đường ống (Pipeline Parallelism)

Spec Decoding (DSpark) finally works with Pipeline Parallelism in vLLM!! 🔥 A lot of the GPU poor/pr…

DịchvLLM hiện đã cho phép DSpark hoạt động cùng Pipeline Parallelism, giúp các mô hình siêu lớn (như Kimi K3 2.8T) tận dụng được khả năng suy luận dự đoán ngay cả khi phải chia nhỏ trọng số trên nhiều máy.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 39/100

Chạy mô hình Kimi K3 (2.8T) trên MacBook Pro: Tốc độ 1 token/giây nhờ streaming từ 4 ổ SSD

Dự án ARGODRIVE Deltafin đã tối ưu hóa việc chạy mô hình Kimi K3 (2.8T) nguyên bản trên MacBook Pro M5 Max, đạt tốc độ 1 token/giây bằng cách truyền tải dữ liệu trực tiếp từ 4 ổ SSD, nhanh gấp 3.5 lần so với các phương pháp trước đây.

Cohere@cohere
Sản phẩmĐiểm AI 50/100

Cohere ra mắt hệ thống suy luận LLM mã nguồn mở mới, nhanh hơn vLLM tới 1,58 lần

Introducing the next evolution in LLM text generation: the first fully-fledged serving system built …

DịchCohere vừa giới thiệu hệ thống phục vụ tạo văn bản LLM dựa trên kiến trúc decode megakernel, mang lại hiệu suất vượt trội so với vLLM và được phát hành hoàn toàn dưới dạng mã nguồn mở.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (52 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “LLM” — Trang 12 | AIHOT.vn