The Verge thử nghiệm tính năng Apple Intelligence for Home trên iOS 27, so sánh khả năng nhận diện khuôn mặt, mô tả bằng văn bản và tìm kiếm video với các đối thủ Ring và Google Nest.
Sau khi chứng kiến cộng đồng ca ngợi Opus 5.5, một người dùng vốn trung thành với GPT đã không thể chịu nổi sự kém thông minh của GPT-6 trong dịp Trung thu và quyết định chuyển sang sử dụng Claude.
The team behind AI/ML API tested the new Claude Opus 5.5 against GPT-6 Sol. These tests involved ge…
DịchCác thử nghiệm tạo prompt cho cảnh 3D cho thấy Claude Opus 5.5 mang lại chất lượng hình ảnh chi tiết hơn, dù chi phí cao gấp gần 13 lần so với GPT-6 Sol.
Very interesting experiments by @thehypedotnews gpt-6 sol vs grok 4.7 vs gpt-6 astra vs muse spark…
DịchThử nghiệm tạo file HTML cho bối cảnh Star Wars cho thấy GPT-6 Sol dẫn đầu về tốc độ (nhanh gấp đôi), trong khi Muse Spark 1.3 tối ưu nhất về chi phí. Tất cả các mô hình đều hoàn thành tốt nhiệm vụ với tổng chi phí thấp.
MarkTechPost thực hiện bài kiểm tra thực tế trên 7 nền tảng nhân bản giọng nói hàng đầu, đánh giá dựa trên độ chân thực, quy trình xác thực quyền sở hữu và chi phí vận hành cho mỗi 1 triệu ký tự.
Claude not having an image generator is a gap in agentic projects that involve knowledge work. It is…
DịchViệc thiếu trình tạo ảnh khiến Claude mất lợi thế cạnh tranh so với Google và OpenAI trong các tác vụ văn phòng như thiết kế slide hay biểu đồ, dù khả năng lập trình của nó rất mạnh.
OpenRouter đã thử nghiệm 20 mô hình tạo ảnh với cùng một câu lệnh, cho thấy sự chênh lệch chi phí lên tới 22 lần, dao động từ 0,006 USD đến 0,134 USD mỗi ảnh.
We compared the top model from each family by net improvement score and median cost per task. Family…
DịchArena đánh giá các dòng mô hình hàng đầu dựa trên điểm số cải thiện và chi phí mỗi tác vụ. Kết quả cho thấy GPT-6 Astra và Claude Fable 5.1 mang lại hiệu suất vượt trội nhưng đi kèm mức giá cao hơn đáng kể so với các phiên bản khác cùng dòng.
Alexandr Wang, nhà sáng lập Scale AI, chia sẻ góc nhìn chuyên sâu về sự khác biệt và hiệu năng giữa hai mô hình AI hàng đầu hiện nay là Muse Spark 1.3 Max và GPT-6 Astra.
Simon Willison thử nghiệm khả năng tạo hình SVG 'bồ nông đạp xe' trên GPT-6 Astra với các cấp độ suy luận khác nhau, đồng thời đối chiếu kết quả với các phiên bản GPT-5.6 để đánh giá sự khác biệt về hiệu năng.
GPT Astra just beat Claude Fable 5.1 on this test by AI/ML API (@aimlapi). Astra used 33% fewer …
DịchThử nghiệm thực tế trên 4 kịch bản cho thấy GPT-6 Astra vượt trội hơn Claude Fable 5.1 về khả năng tối ưu hóa token khi tạo file HTML độc lập mà không cần chỉnh sửa.
Okay, everyone is talking about AI video models right now, but honestly, most of the "comparisons" o…
DịchBài kiểm tra thực tế với cùng thông số cho thấy HappyHorse 1.1 vượt trội về tính nhất quán giữa các khung hình, giúp tối ưu thời gian sản xuất cho quảng cáo và thương mại điện tử so với Kling 3.0.
DịchTheo dữ liệu từ Artificial Analysis, Grok 4.6 (High) đã vượt qua GPT-6 Astra (Max) ở các chỉ số quan trọng như khả năng tác vụ, độ chính xác và giảm thiểu ảo giác. Phiên bản Grok 4.7 dự kiến sẽ sớm được ra mắt.
Martian has released AI Frontier, an interactive dashboard that measures how 44 LLMs compare on qual…
DịchAI Frontier là bảng điều khiển tương tác cho phép người dùng đánh giá 44 LLM dựa trên chất lượng thực tế, chi phí vận hành và tính nhất quán khi xử lý cùng một tác vụ, giúp tối ưu hóa việc lựa chọn mô hình cho doanh nghiệp.
DịchNhà sáng lập Scale AI chia sẻ bài kiểm tra cho thấy Muse Spark 1.3 hoàn thành tác vụ chỉ trong 1 phút với chi phí gần như bằng 0, trong khi Fable 5.1 mất tới 70 phút và tốn 13 USD cho cùng một yêu cầu.
Looking solely at benchmarks and considering the price-performance ratio, Fable 5.1 represents a sig…
DịchFable 5.1 cho thấy hiệu suất vượt trội so với Sol 5.6 Max trong các bài kiểm tra Cursor Bench với mức giá cạnh tranh hơn. Đây là bản nâng cấp đáng chú ý về chỉ số AI, hứa hẹn mang lại trải nghiệm tối ưu và ít lỗi hơn cho người dùng.
Kết quả thử nghiệm từ Together AI cho thấy GPT-5.6 Sol vượt trội ở khả năng giải quyết vấn đề đơn lẻ, nhưng DeepSeek V4 Pro lại chiếm ưu thế về độ ổn định khi cho phép thử lại nhiều lần.
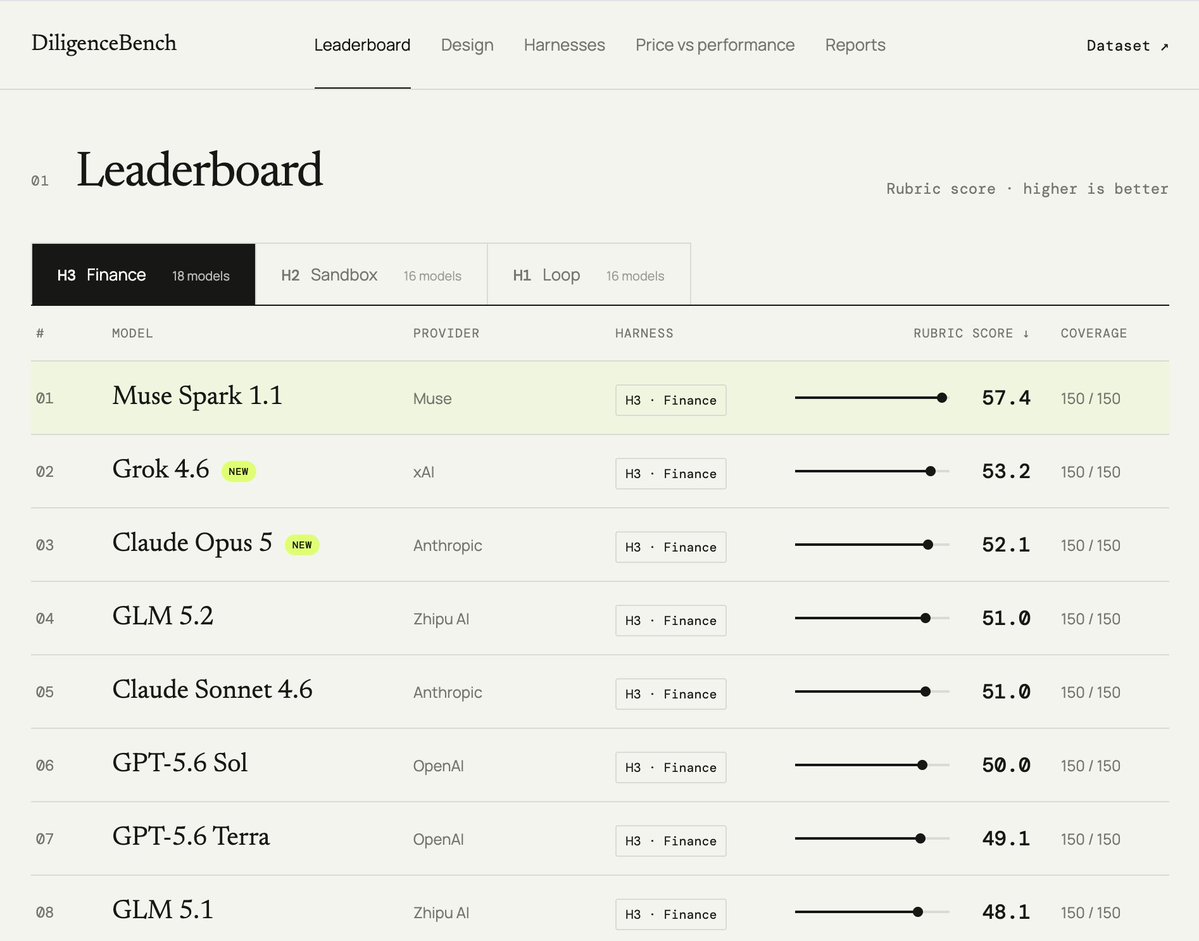
Grok 4.6 is a great cost-effective model for deep financial research. It's #2 on DiligenceBench wi…
DịchGrok 4.6 ghi điểm ấn tượng trong bài kiểm tra tài chính DiligenceBench, đạt hiệu suất tương đương Claude Opus 5 nhưng với chi phí vận hành tối ưu hơn.
DịchNgười dùng mạng xã hội đang xôn xao khi Grok 4.6 được đánh giá cao hơn ChatGPT, làm dấy lên những thảo luận về sự thông minh của các mô hình AI hiện nay.
Netlify hiện đã tích hợp OpenRouter, cho phép người dùng tùy chọn bất kỳ mô hình AI nào. Bài viết thực hiện kiểm chứng 11 model khác nhau với cùng một câu lệnh để so sánh hiệu suất thực tế.
Kimi K3 (Max) leads DeepSeek-V4-Pro (Max) by 67 Arena points, but DeepSeek is roughly 6.9x cheaper o…
DịchTrong bảng xếp hạng Code Arena: WebDev, Kimi K3 đạt 1674 điểm, nhỉnh hơn mức 1607 điểm của DeepSeek-V4-Pro. Tuy nhiên, DeepSeek lại sở hữu lợi thế cực lớn về chi phí khi rẻ hơn từ 7 đến 17 lần so với đối thủ.
Blended cost per 1M tokens across 26 commercial LLMs, ordered low to high.
DịchPhân tích 26 LLM cho thấy Grok 4.6 đạt chỉ số thông minh 61 điểm, gần bằng Claude Fable 5 Max nhưng tiết kiệm tới 80-88% chi phí token, trở thành lựa chọn tối ưu nhất về kinh tế.
Qua thử nghiệm với 114 câu lệnh, Grok 4.6 vượt trội nhờ khả năng phân tích dữ liệu thiên văn chuẩn xác và khai thác cấu trúc ẩn sau vấn đề, dù đôi khi còn quá sa đà vào các diễn giải trừu tượng.