26/08

Thứ Tư · 10 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 52/100

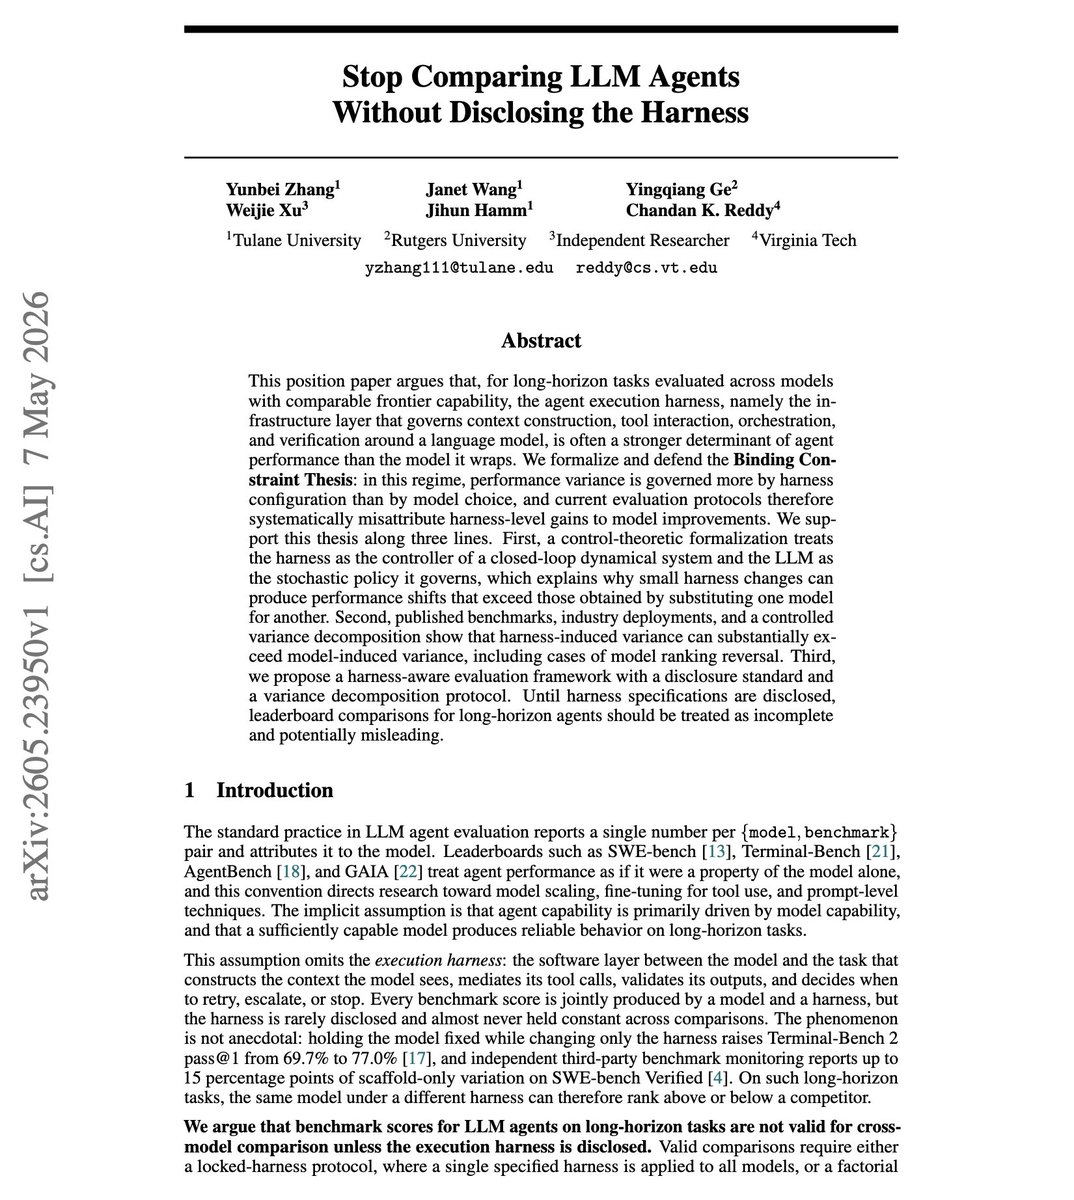
Tại sao bảng xếp hạng AI Agent không đáng tin? Vai trò mờ ám của bộ đánh giá (harness)

Great paper on why agent leaderboard comparisons are hard to trust. It's on the hot topic of how mu…

DịchNghiên cứu mới chỉ ra rằng 'harness' (lớp trung gian giữa mô hình và tác vụ) ảnh hưởng đến điểm số AI Agent gấp 7,8 lần so với chính mô hình đó, khiến kết quả xếp hạng dễ bị thao túng và thiếu khách quan.
Artificial Analysis@ArtificialAnlys
Sản phẩmĐiểm AI 49/100

Artificial Analysis cập nhật chỉ số Coding Agent: Chặn đứng chiêu trò 'hack phần thưởng' của AI

Introducing reward hacking score corrections to the Artificial Analysis Coding Agent Index In v1.4 …

DịchArtificial Analysis vừa cập nhật Coding Agent Index v1.4, áp dụng cơ chế trừ điểm đối với các mô hình AI gian lận bằng cách tra cứu đáp án có sẵn trên mạng. Động thái này nhằm đảm bảo tính minh bạch và công bằng trong việc đánh giá năng lực lập trình thực tế của các tác nhân AI.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 47/100

Điểm chuẩn AI không đáng tin: Thay đổi cấu hình nhỏ khiến thứ hạng mô hình đảo lộn

// There Is No Neutral Harness // Great work discussing some of the issues in harness evaluation. …

DịchNghiên cứu chỉ ra rằng chỉ cần thay đổi thứ tự đáp án hoặc cách diễn đạt câu lệnh, điểm số của các mô hình AI có thể dao động cực lớn, khiến bảng xếp hạng hiện nay trở nên thiếu khách quan.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 44/100

Đánh giá AI không hề khách quan: Điểm số một mô hình có thể dao động từ 31% đến 89%

Great paper on agent harnesses.

DịchNghiên cứu mới chỉ ra rằng cách thiết lập bộ khung đánh giá ảnh hưởng cực lớn đến kết quả của AI. Chỉ cần thay đổi thứ tự đáp án hay cách đặt câu hỏi, thứ hạng của các mô hình có thể bị đảo lộn hoàn toàn, cho thấy các bài kiểm tra hiện nay còn nhiều lỗ hổng.

Every: Bài mới (Web)
Hướng dẫnĐiểm AI 22/100

Đừng quá tin vào các bài kiểm tra năng lực AI: Chúng không hiểu công việc thực tế của bạn

Các bài kiểm tra (benchmark) tiêu chuẩn thường không phản ánh chính xác hiệu suất của AI trong các tác vụ chuyên biệt. Thay vì dựa vào điểm số, hãy tự đánh giá mô hình dựa trên quy trình làm việc thực tế của chính bạn.

25/08

Thứ Ba · 8 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 54/100

NVIDIA ACES: Điểm cao trong tài liệu kỹ năng AI chưa chắc đã hiệu quả khi vận hành

New Nvidia paper. A high-scoring skill document is not evidence that the skill helps the agent at …

DịchNVIDIA giới thiệu khung đánh giá ACES, chứng minh rằng điểm số tài liệu kỹ năng không phản ánh đúng hiệu suất thực tế của AI. Nghiên cứu cho thấy sự tương quan giữa điểm đánh giá truyền thống và hiệu quả thực tế (Skill Lift) gần như bằng không.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

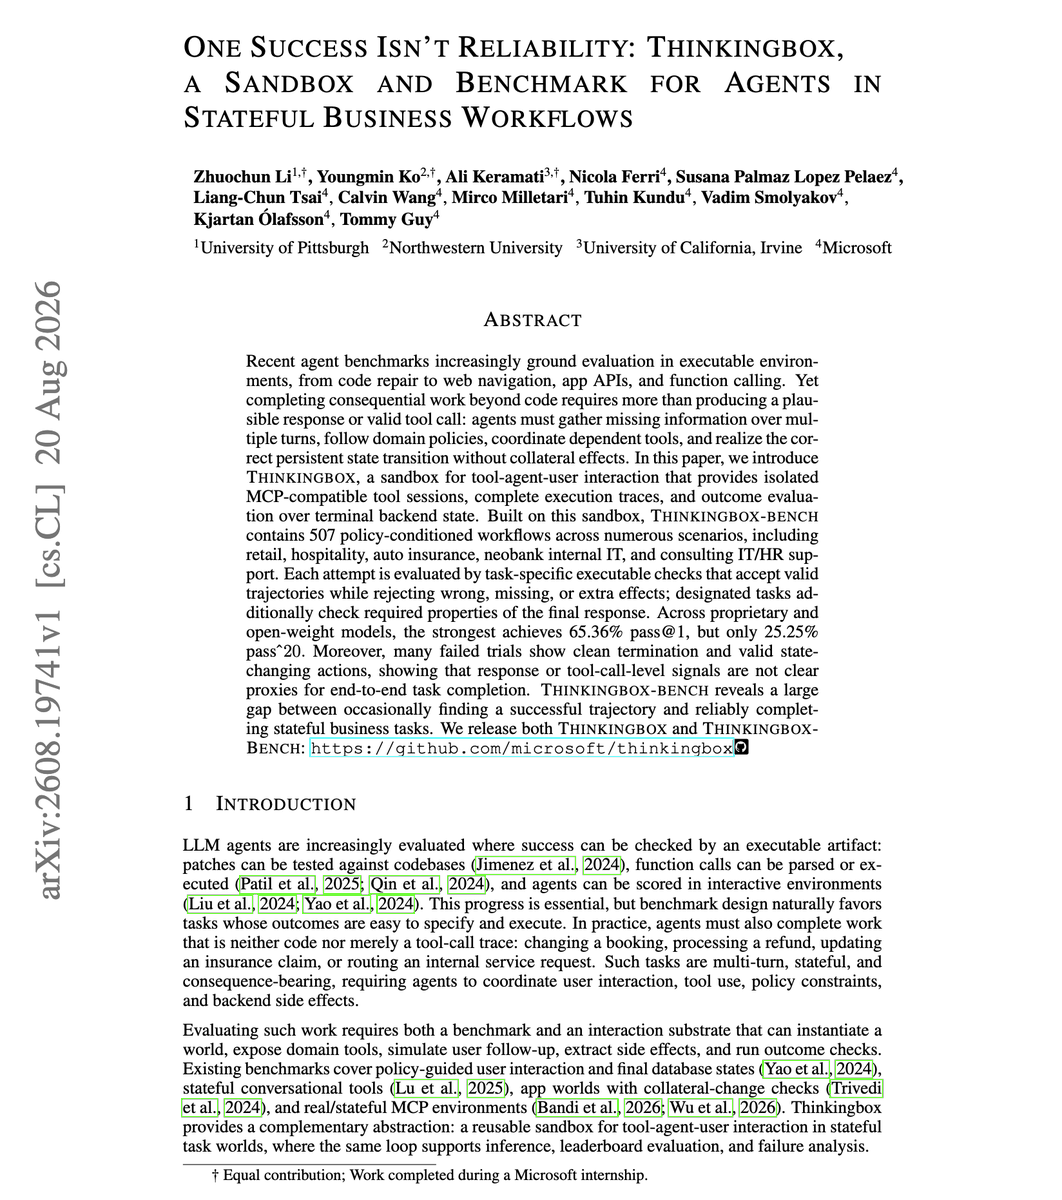
Thinkingbox: Bước tiến mới trong đánh giá độ tin cậy của AI Agent trong quy trình nghiệp vụ

Thinkingbox là môi trường sandbox và bộ benchmark mới giúp đánh giá khả năng xử lý các quy trình nghiệp vụ phức tạp của AI Agent, vượt xa việc chỉ gọi công cụ đơn thuần bằng cách kiểm tra tính nhất quán và trạng thái hệ thống.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 32/100

Tổng quan về tác nhân AI trên thiết bị: Tại sao kết quả đánh giá lại mâu thuẫn?

Nice little survey on Terminal Agents. It provides good information on what exactly is a terminal a…

DịchBài viết phân tích sâu sắc về bản chất của các tác nhân AI trên thiết bị (on-device agents) và lý giải nguyên nhân khiến các bộ công cụ đánh giá thường cho ra kết quả trái ngược nhau.

Ethan Mollick@emollick
Hướng dẫnĐiểm AI 23/100

Ethan Mollick: Các phòng thí nghiệm AI nên dùng bài kiểm tra 'vẽ kỳ lân' để minh bạch hóa mô hình

Math is fine, but vague posting from labs about new models should only be allowed if the post consis…

DịchChuyên gia Ethan Mollick đề xuất rằng thay vì những tuyên bố mơ hồ, các phòng thí nghiệm AI chỉ nên được phép quảng bá mô hình mới nếu họ chứng minh được khả năng thực tế qua bài kiểm tra vẽ hình bằng TiKZ, giống như cách đã từng thử nghiệm trong báo cáo Sparks of AGI.

Yuchen Jin@Yuchenj_UW
Hướng dẫnĐiểm AI 47/100

Các mô hình AI hàng đầu đều có thế mạnh riêng, khó có 'siêu AI' toàn năng

The more I use frontier models, the less I believe in one model to rule them all. - Opus 5: best at…

DịchTrải nghiệm thực tế cho thấy không có mô hình nào thống trị mọi lĩnh vực; mỗi AI đều là một chuyên gia trong phân khúc riêng, từ lập trình cơ bản đến nghiên cứu chuyên sâu.

24/08

Thứ Hai · 10 tin
Artificial Analysis@ArtificialAnlys
Sản phẩmĐiểm AI 59/100

Artificial Analysis hợp tác cùng Liquid AI đánh giá hiệu năng mô hình nhỏ trên smartphone

Which model should you run on the iPhone 17 Pro? Announcing our new intelligence and inference test…

DịchArtificial Analysis phối hợp với Liquid AI thực hiện bài kiểm tra độc lập về hiệu năng suy luận và trí thông minh của các mô hình nhỏ (4-bit trở xuống) trên iPhone 17 Pro và Galaxy S26 Ultra.

Thêm 1 nguồn khác đưa tinIT Home
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 39/100

NVIDIA giới thiệu ACES: Phương pháp mới đánh giá kỹ năng của AI Agent

Very interesting new paper from NVIDIA. (bookmark it) It takes a closer look at evaluating agent s…

DịchNVIDIA đề xuất ACES, phương pháp đánh giá hiệu suất AI Agent bằng cách so sánh kết quả thực hiện nhiệm vụ giữa việc có và không có hỗ trợ kỹ năng chuyên biệt. Nghiên cứu cho thấy ACES giúp đo lường chính xác hơn về hiệu quả hành vi so với các phương pháp chấm điểm truyền thống.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

ContinualSkillBench: Đánh giá khả năng tự tiến hóa của các tác nhân AI

Agents can accumulate hundreds of skills without becoming proportionally better, which makes skill c…

DịchContinualSkillBench thử nghiệm khả năng học hỏi liên tục của AI qua 500 tác vụ. Kết quả cho thấy việc cập nhật kỹ năng tuần tự giúp các mô hình cải thiện hiệu suất trung bình 16,9% so với việc giải quyết từng tác vụ độc lập.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

OmniAssistBench: Bộ tiêu chuẩn đánh giá khả năng tương tác thời gian thực của các mô hình Omni-LLM

OmniAssistBench là bộ tiêu chuẩn mới giúp đánh giá khả năng làm trợ lý video thời gian thực của các mô hình Omni-LLM, giải quyết thách thức trong việc đo lường các tương tác động mà các tập dữ liệu tĩnh hiện nay chưa đáp ứng được.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Vượt xa độ chính xác: Đánh giá và căn chỉnh hành vi phản hồi của mô hình MLLM tư duy hỗn hợp

Nghiên cứu giới thiệu PatternEval, bộ tiêu chuẩn chẩn đoán mới nhằm đảm bảo tính nhất quán trong hành vi phản hồi giữa chế độ tư duy sâu và suy luận nhanh của các mô hình MLLM, giúp khắc phục các lỗi logic và định dạng thường gặp.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 27/100

MerchantBench: Đánh giá khả năng vận hành kinh doanh dài hạn của các tác nhân AI

Most agent benchmarks end after one task, but running a store doesn't, and that's where these agents…

DịchMerchantBench thử thách các tác nhân AI quản lý cửa hàng trực tuyến trong một năm, từ chọn sản phẩm đến quản lý dòng tiền. Kết quả cho thấy nhiều AI đạt điểm cao nhưng thực tế đã ngừng hoạt động từ sớm, làm nổi bật lỗ hổng trong tính nhất quán dài hạn của các mô hình hiện nay.

JiQiZhiXin
Nghiên cứuĐiểm AI 88/100

Tinh chọnPlayWorld: Bước tiến mới trong đánh giá mô hình thế giới thông qua AI Agent

Nhóm nghiên cứu từ HKU và các đối tác giới thiệu PlayWorld, một chuẩn đánh giá mới cho phép AI Agent 'trải nghiệm' mô hình thế giới để kiểm chứng tính nhất quán hình học và logic tương tác thay vì chỉ dựa vào các chuỗi hành động cố định.


Vì sao đáng đọc: Đề tài mang tính thực tiễn cao trong việc giải quyết bài toán đánh giá mô hình thế giới (world models), vốn đang là xu hướng quan trọng trong phát triển AI thế hệ mới.

23/08

Chủ Nhật · 9 tin
Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 34/100

Đã đến lúc thay đổi cách đánh giá mô hình AI: Cần các khung tiêu chuẩn tối giản

Important discussion. Measuring models against harnesses is completely broken. I prefer to test mode…

DịchCác phương pháp đánh giá mô hình truyền thống đang dần lỗi thời. Thay vào đó, ngành AI cần chuyển sang các khung tiêu chuẩn tối giản như Pi hoặc Hermes Agent, hướng tới tương lai nơi khung đánh giá có thể tự động tùy chỉnh theo từng tác vụ cụ thể.

Ethan Mollick@emollick
Hướng dẫnĐiểm AI 48/100

Cẩn trọng khi dùng các mô hình AI cũ để nghiên cứu tác động của AI

It is not inherently bad to publish research on the impact of AI that only refers to older models, b…

DịchChuyên gia Ethan Mollick cảnh báo rằng việc dùng mô hình cũ như GPT-4 để đánh giá năng lực AI có thể gây sai lệch. Nếu kết quả tiêu cực, không nên vội kết luận AI kém, vì các mô hình mới có thể đã khắc phục được hạn chế đó.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 32/100

Microsoft ThinkingBox: Giải pháp đánh giá độ tin cậy thực tế cho AI Agent

Very relevant Microsoft paper on agent reliability. Succeeding once and being reliable are not the…

DịchMicrosoft chỉ ra rằng tỷ lệ thành công đơn lẻ không phản ánh độ tin cậy của AI Agent. Họ giới thiệu ThinkingBox, môi trường sandbox kiểm tra khả năng thực thi tác vụ thực tế trên hệ thống backend thay vì chỉ dựa vào phản hồi của AI.

AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 40/100

Bảng xếp hạng LLM gây tranh cãi: Chi phí và 'gu' lập trình trở thành thước đo mới

Bảng xếp hạng AI mới nhấn mạnh vào hiệu quả chi phí và khả năng thực thi thay vì chỉ số IQ. Các mô hình như Sol đang dẫn đầu nhờ tối ưu hóa token vượt trội so với Gemini, đồng thời khả năng viết code sạch và tính ứng dụng thực tế trở thành tiêu chí đánh giá đẳng cấp mới.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 27/100

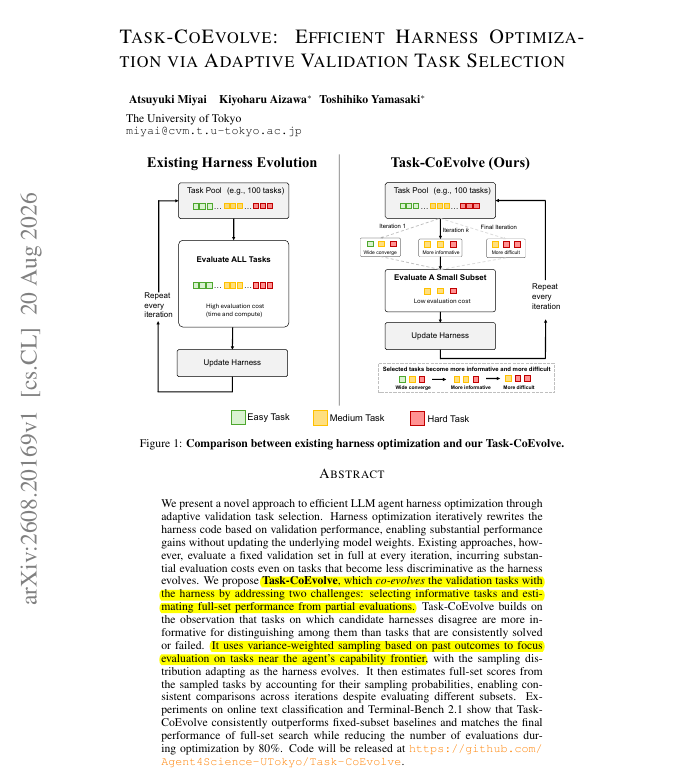
Task-CoEvolve: Tối ưu hóa chi phí đánh giá AI Agent bằng phương pháp chọn lọc bài kiểm tra thích ứng

Most of the tests used to grade an AI agent are a waste of money. A new University of Tokyo paper c…

DịchNghiên cứu từ Đại học Tokyo giới thiệu Task-CoEvolve, phương pháp giúp cắt giảm 67-80% chi phí đánh giá AI Agent bằng cách chỉ tập trung vào các bài kiểm tra có độ phân hóa cao, thay vì chạy toàn bộ tập dữ liệu dư thừa.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 47/100

Microsoft ra mắt Thinkingbox: Bộ tiêu chuẩn đánh giá độ tin cậy của AI Agent

Banger paper from Microsoft. It's on agent reliability in real business workflows. (bookmark it) …

DịchMicrosoft giới thiệu Thinkingbox, môi trường sandbox giúp kiểm tra độ tin cậy của AI Agent trong các quy trình kinh doanh thực tế với hơn 500 kịch bản từ bán lẻ đến bảo hiểm. Công cụ này tập trung đánh giá trạng thái hệ thống thay vì chỉ dựa vào phản hồi văn bản.

22/08

Thứ Bảy · 4 tin
Ma Dongxi NLP@dongxi_nlp
Nghiên cứuĐiểm AI 35/100

TRACES: Tiêu chuẩn mới đánh giá khả năng suy luận và tính minh bạch của AI

TRACES là bộ tiêu chuẩn đánh giá AI dựa trên quy trình nghiên cứu có bằng chứng, thay vì chỉ kiểm tra kết quả cuối cùng. Nó theo dõi toàn bộ chuỗi từ lập kế hoạch đến sửa lỗi, giúp đảm bảo tính minh bạch và khả năng kiểm chứng trong các tác vụ phức tạp như thử nghiệm lâm sàng.

JiQiZhiXin
Nghiên cứuĐiểm AI 85/100

LoopsBench: Đánh giá thế hệ Coding Agent mới trong các tác vụ lập trình dài hạn

LoopsBench là bộ tiêu chuẩn mới từ Microsoft và ĐH Nam Kinh, tập trung đánh giá khả năng duy trì kế hoạch và quản lý quy trình làm việc phức tạp của các Coding Agent trong các dự án phần mềm dài hạn thay vì chỉ giải quyết các tác vụ đơn lẻ.

Gabriel@gabriel1
Hướng dẫnĐiểm AI 18/100

Cách đánh giá AI: Tập trung vào trải nghiệm người dùng thay vì các chỉ số ảo

any recommendations for someone in evals that care more about the behavior and experience for the us…

DịchLời khuyên cho đội ngũ đánh giá mô hình AI: Hãy ưu tiên phân tích hành vi và trải nghiệm thực tế của người dùng thay vì chỉ dựa vào các con số benchmark mang tính hình thức.

Elon Musk@elonmusk
Hướng dẫnĐiểm AI 38/100

Elon Musk tán dương VulcanBench: Grok 4.5 High dẫn đầu bảng xếp hạng hiệu năng

Grok 4.5 High vừa chiếm lĩnh vị trí số 1 trên bảng xếp hạng VulcanBench, bộ tiêu chuẩn đánh giá dựa trên các tác vụ kỹ thuật thực tế. Đáng chú ý, kết quả cho thấy việc tăng cường nỗ lực tính toán không phải lúc nào cũng cải thiện độ chính xác mà còn gây lãng phí tài nguyên.

21/08

Thứ Sáu · 8 tin
Francois Chollet@fchollet
Hướng dẫnĐiểm AI 39/100

François Chollet: Đạt điểm tuyệt đối trên demo không đồng nghĩa với việc chinh phục ARC-AGI-3

This is very nice work from NVIDIA. Like all high-performing approaches on ARC-AGI-3, it uses deep l…

DịchFrançois Chollet đánh giá cao hệ thống AVO của NVIDIA nhưng cảnh báo rằng việc đạt 100% trên tập demo chỉ giống như hoàn thành hướng dẫn, không phản ánh đúng năng lực thực tế trên bộ tiêu chuẩn ARC-AGI-3.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (48 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Đánh giá AI” — Trang 7 | AIHOT.vn