29/08

Thứ Bảy · 4 tin
Dex Horthy (HumanLayer)@dexhorthy
NgànhĐiểm AI 16/100

Gerred: Chuyên gia hàng đầu thế giới về dịch vụ suy luận AI quy mô lớn

Gerred is probably top 10 in the world at serving inference at massive scale on thousands of gpus - …

DịchĐược đánh giá nằm trong top 10 thế giới, Gerred sở hữu năng lực vận hành dịch vụ suy luận trên hàng nghìn GPU, trở thành điểm đến lý tưởng cho các kỹ sư AI.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 25/100

CEO Cerebras giải mã lý do chip wafer nhanh gấp 2.500 lần GPU trong suy luận AI

Andrew Feldman, co-founder and CEO of Cerebras gives the best explanation of why Cerebras' wafer-sca…

DịchCEO Andrew Feldman giải thích rằng nhờ lưu trữ trọng số mô hình trực tiếp trên SRAM của chip wafer thay vì bộ nhớ HBM như GPU, Cerebras đã loại bỏ nút thắt cổ chai khi truyền dữ liệu, giúp tăng tốc độ suy luận lên gấp 2.500 lần.

28/08

Thứ Sáu · 1 tin
SemiAnalysis@SemiAnalysis_
Sản phẩmĐiểm AI 38/100

NVIDIA ra mắt mã nguồn mở srt-slurm: Đơn giản hóa triển khai suy luận AI trên cụm máy chủ

Most production inference services run on Kubernetes, where declarative configuration helps coordina…

DịchNVIDIA vừa công bố srt-slurm, công cụ mã nguồn mở giúp tự động hóa việc triển khai và quản lý các hệ thống suy luận AI trên cụm Slurm thông qua cấu hình YAML, hỗ trợ tối ưu hóa tài nguyên GPU và các kiến trúc suy luận phức tạp.

27/08

Thứ Năm · 1 tin
JiQiZhiXin
Mô hìnhĐiểm AI 92/100

Tinh chọnHọc tập truyền cảm hứng: Chuyển đổi nhận thức của AI từ ngoại vi sang nội sinh

Thay vì phụ thuộc vào các khung công cụ bên ngoài, phương pháp 'Inspirational Learning' giúp AI tự học hỏi từ kinh nghiệm cũ, áp dụng tư duy tương tự để giải quyết vấn đề mới một cách thông minh và tự chủ hơn.


Vì sao đáng đọc: Bài viết đề xuất hướng đi đột phá trong việc tối ưu hóa suy luận của LLM, chuyển từ việc dựa dẫm vào công cụ sang tự nội sinh hóa tri thức, rất có giá trị cho giới nghiên cứu AI.

26/08

Thứ Tư · 3 tin
Aravind Srinivas (Perplexity CEO)@AravSrinivas
Hướng dẫnĐiểm AI 40/100

CEO Perplexity hé lộ tương lai của các tác nhân AI: Suy luận liên tục ngay trên thiết bị

A background process that continually ingests context from every single connector (or app), performs…

DịchCEO Aravind Srinivas dự đoán tương lai của AI là các tác nhân chạy ngầm, liên tục thu thập dữ liệu và thực hiện suy luận đa bước ngay trên phần cứng của người dùng.

25/08

Thứ Ba · 5 tin
TechCrunch: AI
Sản phẩmĐiểm AI 52/100

Cùng sự kiệnChip AI Jalapeño của OpenAI: Hiệu suất suy luận vượt mặt Nvidia Blackwell

OpenAI công bố chip Jalapeño hợp tác cùng Broadcom, đạt hiệu suất suy luận vượt trội so với Nvidia Blackwell trong các bài kiểm tra thực tế. Dự kiến chip sẽ bắt đầu triển khai quy mô nhỏ vào cuối năm 2026.

Cùng sự kiện, bài đại diện «OpenAI ra mắt chip suy luận tự phát triển Jalapeño: Đột phá về tốc độ và hiệu suất năng lượng»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

TileMix: Tăng tốc suy luận LLM thông qua kỹ thuật định tuyến độ chính xác theo ô

TileMix là kỹ thuật mới giúp tối ưu hóa tính toán self-attention trong LLM bằng cách chia ma trận thành các ô và linh hoạt điều phối độ chính xác (FP16 hoặc INT8) cho từng nhóm ô, giúp giảm tải bộ nhớ mà vẫn duy trì hiệu suất phần cứng.

Artificial Analysis@ArtificialAnlys
Hướng dẫnĐiểm AI 49/100

NVIDIA Groq 3 LPX thiết lập kỷ lục tốc độ suy luận cho Gemma 4 31B

Artificial Analysis has measured 3, 431 tokens/s on Gemma 4 31B via a private demonstration endpoint …

DịchArtificial Analysis ghi nhận NVIDIA Groq 3 LPX đạt tốc độ suy luận ấn tượng 3.431 tokens/giây cho mô hình Gemma 4 31B, duy trì hiệu suất ổn định ngay cả với ngữ cảnh 100k.

24/08

Thứ Hai · 3 tin
SemiAnalysis@SemiAnalysis_
Nghiên cứuĐiểm AI 64/100

Benchmark AgentX: Liệu 'hào sâu' CUDA có giữ vững vị thế trong suy luận AI Agent?

AgentX - InferenceXv3: Does CUDA Moat Hold up in Agentic Inferencing? $3 Million USD dataset open s…

DịchAgentX giới thiệu bộ dữ liệu 3 triệu USD với ngữ cảnh 1 triệu token, tối ưu hóa KVCache cho AI Agent đạt hiệu suất trên 95% trên các nền tảng phần cứng mạnh mẽ như GB300 và MI355.

23/08

Chủ Nhật · 2 tin
opencode@opencode
NgànhĐiểm AI 27/100

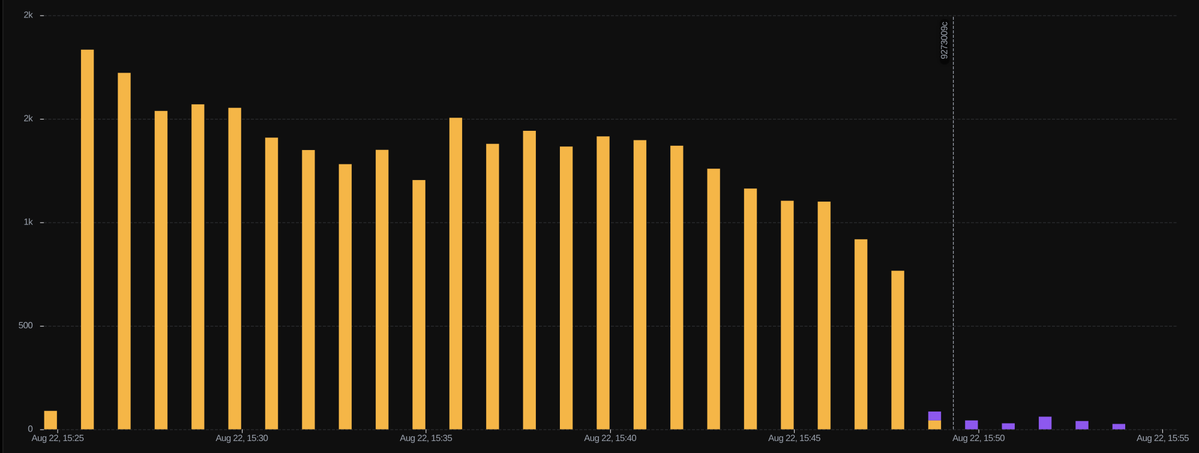
OpenCode khắc phục sự cố, tỷ lệ lỗi giảm về gần bằng 0

errors are back down down to near zero after some more optimizations + allocating more resources th…

DịchSau khi tối ưu hóa và nhận được sự hỗ trợ kịp thời từ Cloudflare, OpenCode đã khắc phục thành công các lỗi hệ thống. Đội ngũ phát triển cũng hứa hẹn sẽ sớm chia sẻ những thách thức đặc thù trong việc vận hành các mô hình suy luận AI.

JiQiZhiXin
Nghiên cứuĐiểm AI 95/100

Tinh chọnĐột phá: Chạy DeepSeek V4-Flash 'full lực' trên một card RTX 5090 với FreeToken

Nhóm nghiên cứu từ Berkeley và MIT vừa ra mắt FreeToken, hệ thống suy luận tối ưu cho phép chạy các mô hình MoE khổng lồ trên phần cứng tiêu dùng với tốc độ cực nhanh, xóa bỏ rào cản về hạ tầng máy chủ.


Vì sao đáng đọc: Đây là bước tiến lớn trong việc dân chủ hóa AI, cho phép người dùng cá nhân chạy các mô hình khủng mà không cần cụm máy chủ đắt đỏ. Công nghệ thực tế, có mã nguồn mở và ứng dụng cao.

22/08

Thứ Bảy · 3 tin
opencode@opencode
Sản phẩmĐiểm AI 23/100

OpenCode khắc phục sự cố suy giảm hiệu năng trên dịch vụ suy luận

we just deployed a fix that was causing a small percentage of requests to our inference service to d…

DịchOpenCode vừa triển khai bản cập nhật nhằm khắc phục tình trạng phản hồi chậm ở một số yêu cầu suy luận, giúp cải thiện tốc độ xử lý cho người dùng.

Ant Ling@AntLingAGI
Mô hìnhĐiểm AI 59/100

Ant Group ra mắt mô hình dự đoán Ling-3.0-flash-dspark mã nguồn mở

Today we are open sourcing Ling-3.0-flash-dspark, a DSpark draft model built specifically for Ling-3…

DịchAnt Group vừa công bố mã nguồn mở Ling-3.0-flash-dspark, mô hình dự đoán (draft model) tối ưu cho Ling-3.0-flash. Trên hệ thống 4 GPU NVIDIA Blackwell, mô hình đạt tốc độ ấn tượng 1.120 tok/s với độ trễ cực thấp, giúp tăng tốc đáng kể hiệu suất suy luận.

20/08

Thứ Năm · 4 tin
Kim@kimmonismus
Sản phẩmĐiểm AI 41/100

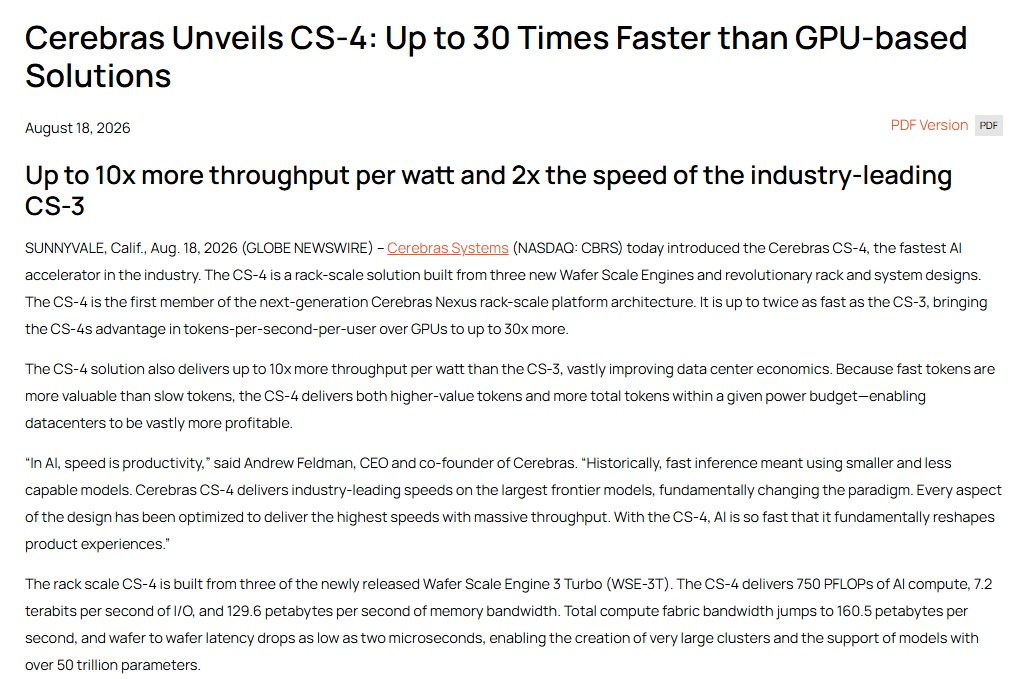
Cerebras CS-4 ra mắt: Đột phá hiệu năng suy luận AI gấp đôi nhờ tối ưu phần cứng

This is seriously impressive: Cerebras just unveiled CS-4, and nearly doubled its AI inference perfo…

DịchCerebras CS-4 tối ưu hóa hệ thống tản nhiệt và nguồn điện để tăng gấp đôi tốc độ xung nhịp, đạt hiệu năng suy luận vượt trội gấp 30 lần so với hệ thống GPU truyền thống trên mô hình GPT-OSS-120B.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Co-RL: Đột phá khả năng suy luận không cần giám sát nhờ đa dạng hóa tác nhân trong học tăng cường

Co-RL là khung học tăng cường đa tác nhân mới, cho phép các mô hình tự tối ưu hóa thông qua tín hiệu phần thưởng lẫn nhau mà không cần nhãn. Việc tăng cường tính đa dạng của nhóm giúp giảm lỗi phản hồi và cải thiện đáng kể hiệu suất trên các tác vụ văn bản và đa phương thức.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

Nghiên cứu mới: Rủi ro từ AI Agent gia tăng theo năng lực suy luận

AI agents can threaten human agency and autonomy long before consciousness becomes relevant, simply …

DịchNghiên cứu từ Thượng Hải AI Lab và ĐH Thanh Hoa cảnh báo AI Agent có thể đe dọa quyền tự chủ của con người ngay cả khi chưa có ý thức, với các rủi ro chuyển dịch từ thao túng hành vi sang chống lại sự kiểm soát khi năng lực suy luận đạt đến cấp độ cao hơn.

SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 47/100

TPU tích hợp Mooncake: Bước tiến mới tối ưu hiệu suất suy luận AI

TPU🚨 is working with the popular OSS inference optimization library Mooncake on integrating TPU wit…

DịchGoogle TPU hợp tác với thư viện Mooncake để tối ưu hóa hiệu suất suy luận thông qua cơ chế chia sẻ bộ nhớ KVCache trên mạng lưới mở rộng, giúp cải thiện đáng kể hiệu quả chi phí (TCO) cho các hệ thống AI quy mô lớn.

19/08

Thứ Tư · 3 tin
Yuchen Jin@Yuchenj_UW
Sản phẩmĐiểm AI 25/100

DFlash 2: Bước tiến đột phá giúp tăng tốc suy luận AI cục bộ

DFlash 2 is very cool! Speculative decoding is such a cool technology. I'm waiting for the day we …

DịchDFlash 2 từ Z Lab và Inco AI mang đến công nghệ giải mã suy đoán (speculative decoding) mạnh mẽ, giúp tăng tốc độ xử lý mô hình AI lên gấp 4,6 lần mà vẫn giữ nguyên độ chính xác, đạt 70 tok/s trên MacBook Pro M5 Max.

18/08

Thứ Ba · 2 tin
ModelBest OpenBMB@OpenBMB
Hướng dẫnĐiểm AI 26/100

Cộng đồng tối ưu hóa FP8 cho MiniCPM5-1B, tăng tốc suy luận gần 80%

Great to see the community pushing MiniCPM5-1B inference further! 🥳 @VukRosic99 has open-sourced an…

DịchNhờ tối ưu hóa FP8 từ cộng đồng, mô hình MiniCPM5-1B đạt tốc độ suy luận ấn tượng 287 tokens/giây trên RTX 3060, tăng gần 80% so với mức 165 tokens/giây ban đầu mà không cần thay đổi checkpoint.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 49/100

R^3-Bench: Thử thách khả năng suy luận của LLM trong môi trường giới hạn tài nguyên

R^3-Bench là bộ tiêu chuẩn mới đánh giá khả năng suy luận toán học và lập trình của LLM khi phải phân bổ tài nguyên hạn chế. Kết quả cho thấy các mô hình hiện nay vẫn gặp khó khăn trong việc tối ưu hóa chiến lược giải quyết vấn đề dưới áp lực ngân sách tài nguyên.

17/08

Thứ Hai · 2 tin

16/08

Chủ Nhật · 2 tin
JiQiZhiXin
Mô hìnhĐiểm AI 92/100

Tinh chọnBản thuyết trình bị giáo sư MIT chê là 'vô nghĩa' 5 năm trước đã tiên tri chính xác về OpenAI o1 và o3

Nghiên cứu của Giambattista Parascandolo từ năm 2020 về 'suy luận mở' và tối ưu hóa tính toán thời gian thực đã đặt nền móng cho tư duy cốt lõi của các mô hình o1, o3 hiện nay, dù từng bị giới học thuật bác bỏ.


Vì sao đáng đọc: Câu chuyện mang tính thời sự cao, kết nối lịch sử nghiên cứu với các đột phá hiện tại của OpenAI, tạo góc nhìn sâu sắc về sự phát triển của AI.

15/08

Thứ Bảy · 2 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Microsoft: Thay thế suy luận tốn kém bằng 'kỹ năng chưng cất' để tối ưu chi phí

What if you could pay the reasoning cost once, then reuse what the model learned across future tasks…

DịchMicrosoft đề xuất phương pháp chuyển đổi các mô hình suy luận đắt đỏ thành bộ quy tắc nhỏ gọn. Bằng cách trích xuất kinh nghiệm từ các lần chạy trước, phương pháp này giúp giảm tới 4,5 lần lượng token đầu ra mà vẫn duy trì hiệu suất vượt trội trên các tác vụ thông minh.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

Nghiên cứu Qwen2.5: Lấy mẫu lặp lại hiệu quả hơn tự phản tư trong suy luận toán học

If you're spending extra tokens making an LLM critique itself, this paper says a simpler move can be…

DịchNghiên cứu trên các mô hình Qwen2.5 cho thấy việc lấy mẫu lặp lại và chọn đáp án đa số mang lại hiệu quả cao hơn các phương pháp tự phản tư phức tạp khi cùng giới hạn số lượng token.

14/08

Thứ Sáu · 3 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnPhyAI: Bước đột phá với runtime thống nhất cho Physical AI từ thiết bị đầu cuối đến đám mây

Các trường đại học hàng đầu Trung Quốc vừa giới thiệu PhyAI, runtime đầu tiên giúp tối ưu hóa hiệu suất suy luận cho robot trong mọi môi trường từ thiết bị biên đến đám mây, giải quyết triệt để vấn đề độ trễ và khả năng mở rộng.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng giải quyết bài toán thực tế trong triển khai (Embodied AI), có mã nguồn mở và kết quả thực nghiệm ấn tượng, rất có giá trị cho cộng đồng kỹ thuật.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnBiết khi nào nên dừng: Huấn luyện LLM từ chối các suy luận vô nghĩa

Nghiên cứu giới thiệu phương pháp CaRL giúp LLM nhận diện giới hạn năng lực của chính mình, từ đó từ chối trả lời thay vì đưa ra các suy luận sai lệch nhưng nghe có vẻ thuyết phục.


Vì sao đáng đọc: Giải quyết vấn đề 'ảo tưởng' (hallucination) và suy luận sai của LLM bằng cách huấn luyện mô hình biết thừa nhận giới hạn, một bước tiến quan trọng cho độ tin cậy của AI.
Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 30/100

SSI có thể đang phát triển mô hình với 'không gian làm việc' tự tối ưu hóa

I began to like the word "Workspace". It is the internal area where a model holds, evaluates, and …

DịchChuyên gia Ma Dongxi cho rằng SSI đang xây dựng mô hình có khả năng tự đánh giá và tinh chỉnh suy nghĩ trong một 'không gian làm việc' nội bộ trước khi đưa ra câu trả lời, tương tự như cơ chế tối ưu hóa không gian ẩn dựa trên giá trị.

12/08

Thứ Tư · 4 tin
ModelBest OpenBMB@OpenBMB
Nghiên cứuĐiểm AI 56/100

CheckRLM: Khung RAG từ Đại học Thanh Hoa giúp sửa lỗi thực tế theo thời gian thực

Reasoning models think longer, but longer chains bury more factual mistakes-and one wrong fact early…

DịchCheckRLM là khung RAG mới từ ĐH Thanh Hoa giúp phát hiện và sửa lỗi thực tế ngay trong quá trình suy luận thay vì hậu kiểm. Giải pháp này đạt hiệu suất vượt trội trên các bộ dữ liệu khó như MuSiQue với tốc độ nhanh và tiết kiệm token hơn so với các mô hình hiện nay.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (54 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Suy luận AI” — Trang 3 | AIHOT.vn