14/08

Thứ Sáu · 28 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

Tác động của tinh chỉnh chỉ dẫn đến độ tin cậy và sự đa dạng từ vựng của mô hình ngôn ngữ

Nghiên cứu thực nghiệm cho thấy tinh chỉnh chỉ dẫn (instruction tuning) làm thay đổi độ tin cậy của mô hình nhưng không cải thiện đáng kể độ chính xác, đồng thời gây ra những tác động không đồng nhất lên sự đa dạng từ vựng và khả năng suy luận.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

PixSDS: Giải mã nguyên nhân gây nhiễu điểm ảnh trong mô hình tạo 3D từ văn bản

Nghiên cứu chỉ ra rằng hiện tượng nhiễu và giả ảnh trong Latent SDS xuất phát từ sự lệch pha của VAE. PixSDS khắc phục vấn đề này bằng cách tinh chỉnh gradient nhất quán mà không cần huấn luyện lại mô hình, giúp tạo 3D sắc nét và sạch hơn.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnBiết khi nào nên dừng: Huấn luyện LLM từ chối các suy luận vô nghĩa

Nghiên cứu giới thiệu phương pháp CaRL giúp LLM nhận diện giới hạn năng lực của chính mình, từ đó từ chối trả lời thay vì đưa ra các suy luận sai lệch nhưng nghe có vẻ thuyết phục.


Vì sao đáng đọc: Giải quyết vấn đề 'ảo tưởng' (hallucination) và suy luận sai của LLM bằng cách huấn luyện mô hình biết thừa nhận giới hạn, một bước tiến quan trọng cho độ tin cậy của AI.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SKILLER: Học tăng cường ngôn ngữ giúp trích xuất kỹ năng tái sử dụng cho mô hình ngôn ngữ nhỏ

SKILLER giải quyết thách thức trong việc tự động tạo các kỹ năng hiệu quả cho mô hình ngôn ngữ nhỏ, giúp giảm chi phí vận hành tác vụ mà vẫn đảm bảo hiệu suất cao trên phần cứng phổ thông.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 55/100

LiveAnimate: Hệ thống tạo video người chuyển động thời gian thực với độ ổn định cao

LiveAnimate là hệ thống tạo hoạt ảnh người dùng mô hình DiT 14B, cho phép tạo video dài ổn định với độ trễ thấp nhờ cơ chế PR-Sink và tối ưu hóa quy trình lấy mẫu chỉ trong 3 bước.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

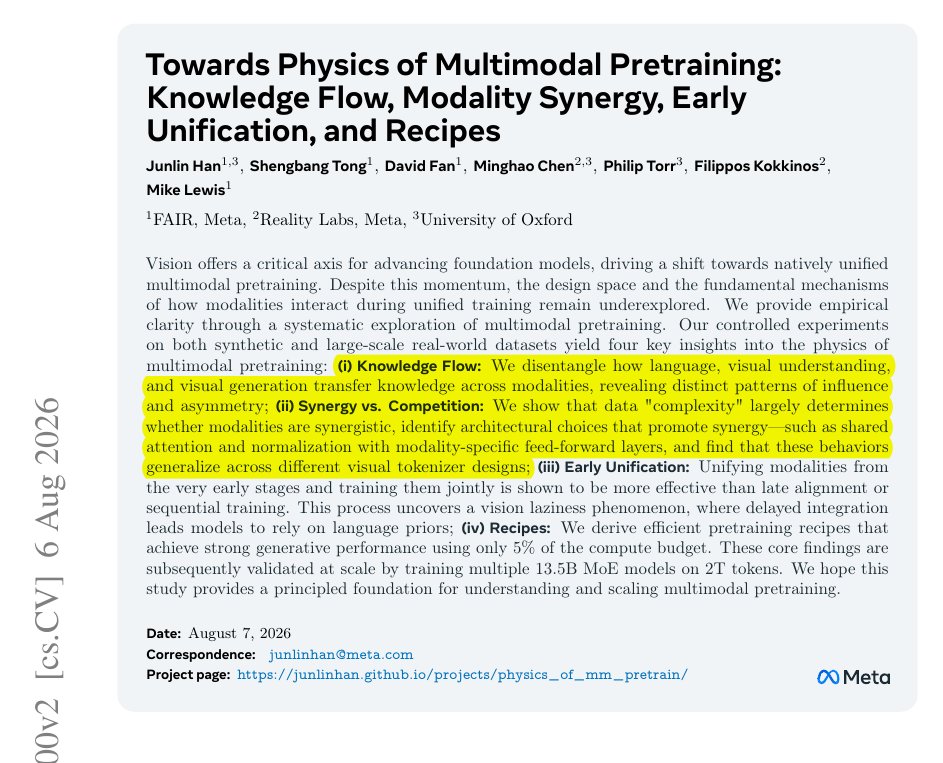
Nghiên cứu Meta & Oxford: Mô hình đa phương thức chỉ cần 5% dữ liệu tạo ảnh để đạt hiệu suất tối ưu

The Meta/Oxford study finds, a multimodal model may need surprisingly little image-generation data i…

DịchNghiên cứu chỉ ra rằng việc cân bằng tỷ lệ dữ liệu ngôn ngữ và hình ảnh giúp mô hình đa phương thức đạt hiệu suất cao hơn dù giảm 5 lần dữ liệu tạo ảnh. Đồng thời, việc đưa hình ảnh vào quá muộn dễ gây ra tình trạng 'lười thị giác', khiến mô hình quá phụ thuộc vào ngôn ngữ.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 66/100

Alaya-EVOKE: Đột phá mô hình thế giới tương tác với khả năng ghi nhớ dài hạn

Alaya Lab giới thiệu Evoke, mô hình thế giới tương tác sử dụng cơ chế bộ nhớ ngoài và kiến trúc chú ý thưa để duy trì bối cảnh dài hạn mà không làm tăng chi phí tính toán, giúp mô hình vận hành ổn định mà không cần kỹ thuật CFG phức tạp.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 54/100

PlayWorld: Đánh giá mô hình thế giới thông qua AI Agent với mục tiêu dài hạn

Nhóm nghiên cứu từ ĐH Hồng Kông và Kuaishou giới thiệu PlayWorld, bộ tiêu chuẩn sử dụng AI Agent để đánh giá khả năng tương tác và duy trì tính nhất quán của các mô hình thế giới trong các kịch bản phức tạp.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

LycheeMemory V2: Bước đột phá trong khung bộ nhớ dài hạn cho tác nhân AI

Nhóm nghiên cứu từ HIT (Thâm Quyến) giới thiệu LycheeMemory V2, sử dụng phương pháp tích hợp theo phân đoạn ngữ nghĩa thay vì từng vòng, giúp giảm đáng kể chi phí token mà vẫn duy trì độ chính xác cao cho các tác nhân LLM.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnDarwinX: Tiến hóa hệ thống tác nhân AI thông qua chọn lọc tự nhiên

DarwinX tối ưu hóa khả năng của tác nhân AI bằng cách áp dụng cơ chế chọn lọc tự nhiên lên các thành phần như prompt và công cụ, giúp cải thiện hiệu suất mà không cần thay đổi trọng số mô hình.


Vì sao đáng đọc: Phương pháp tiếp cận mới lạ, giải quyết vấn đề thoái hóa hiệu năng khi tự cải tiến, có kết quả thực nghiệm ấn tượng trên các benchmark khó.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnFull-bandwidth Transformer: Đột phá mới trong kiến trúc mô hình ngôn ngữ

Full-bandwidth Transformer cải thiện khả năng suy luận bằng cách truyền trạng thái ẩn từ lớp trên cùng trở lại đầu vào, giúp mô hình tận dụng được các tính toán chuyên sâu thay vì chỉ dựa vào token đã tạo.


Vì sao đáng đọc: Đây là một cải tiến kiến trúc quan trọng, giải quyết điểm nghẽn về luồng thông tin trong các mô hình Transformer hiện nay mà vẫn giữ được tính tương thích với hạ tầng cũ.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

OmniScientist: Hệ thống AI toàn năng tự động thực hiện nghiên cứu khoa học đa ngành

OmniScientist là AI khoa học đầu tiên xử lý trực tiếp dữ liệu thô đa phương thức (hình ảnh, âm thanh, 3D, bảng biểu) để tự động hoàn thiện quy trình nghiên cứu từ dữ liệu đến bài báo khoa học hoàn chỉnh trên nhiều lĩnh vực.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Từ bằng chứng nguyên tử đến logic tổ hợp: Phương pháp suy luận cấu trúc cho các lựa chọn phức hợp

Khung làm việc mới giúp LLM giải quyết các câu hỏi logic phức tạp bằng cách phân tách lựa chọn thành các thành phần nguyên tử, sau đó sử dụng lập trình tuyến tính để tổng hợp kết quả. Phương pháp này cải thiện đáng kể độ chính xác trên các bộ dữ liệu logic khó.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ReRound: Phương pháp lượng tử hóa LLM không cần hiệu chỉnh bằng cách giải quyết sai số làm tròn

ReRound sử dụng mô hình khuếch tán để tái tạo trọng số, giúp xác định chính xác hướng làm tròn cho các giá trị nằm gần điểm giữa của khoảng lượng tử hóa, từ đó tối ưu hóa hiệu suất LLM ở mức bit thấp.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

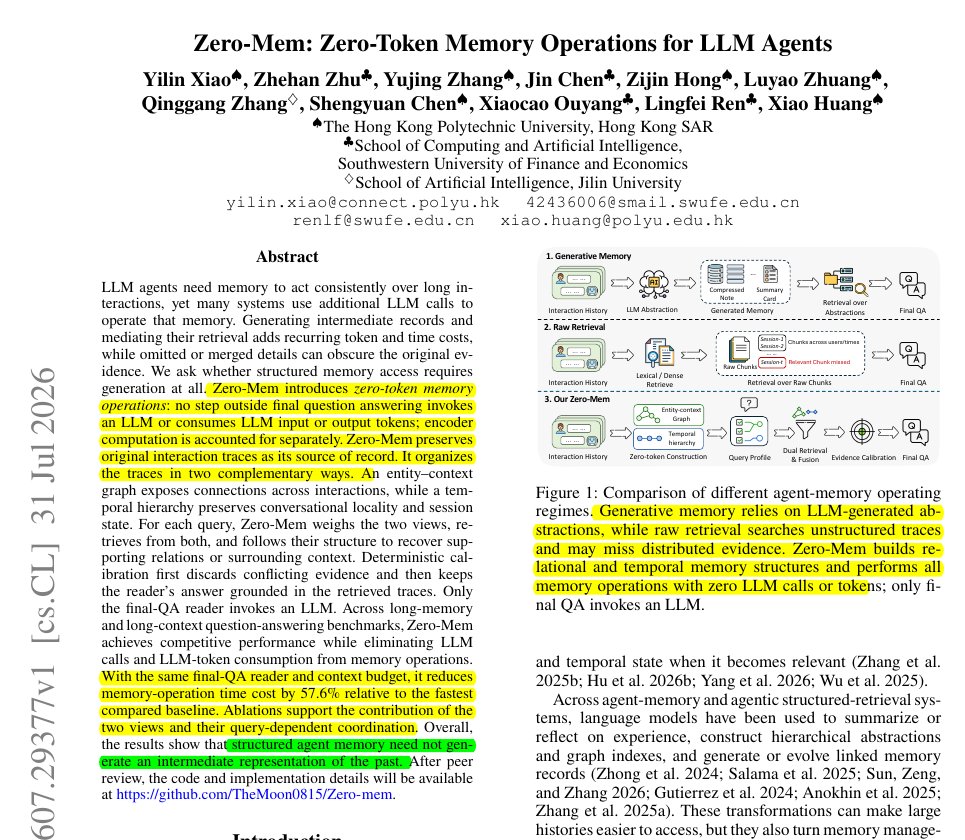
Zero-Mem: Giải pháp tối ưu hóa bộ nhớ cho AI Agent mà không tốn token

What if an AI agent could manage long-term memory without spending a single LLM token on the memory …

DịchZero-Mem là phương pháp quản lý bộ nhớ đột phá giúp AI Agent truy xuất dữ liệu mà không cần gọi LLM, giúp giảm độ trễ tới 57,6% so với các giải pháp hiện có bằng cách sử dụng đồ thị thực thể và phân cấp thời gian.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 37/100

Harness-IF: Phương pháp định lượng mức độ tuân thủ quy tắc của AI Agent

If you write rules in an AGENTS.md, this one is worth your time. When a coding agent follows your r…

DịchHarness-IF đánh giá khả năng tuân thủ các quy tắc trong AGENTS.md của AI Agent bằng cách loại bỏ các yếu tố ngẫu nhiên. Kết quả cho thấy độ chính xác thực tế thấp hơn dự đoán, đồng thời khẳng định hệ thống và chỉ dẫn người dùng luôn được ưu tiên hơn mô tả công cụ.

13/08

Thứ Năm · 31 tin
Apple Machine Learning Research
Nghiên cứuĐiểm AI 41/100

Khi việc 'lãng quên' không tốn phí: Tối ưu hóa học máy bằng cách loại bỏ dữ liệu ít ảnh hưởng

Nhóm nghiên cứu của Apple đề xuất phương pháp mới giúp giảm chi phí tính toán khi xóa dữ liệu trong mô hình học máy bằng cách xác định và bỏ qua các điểm dữ liệu có ảnh hưởng không đáng kể, thay vì xử lý toàn bộ tập dữ liệu như trước đây.

AK@_akhaliq
Nghiên cứuĐiểm AI 30/100

Tencent ARC giới thiệu SCoPE: Mã hóa vị trí Sightline mới cho mô hình Video Diffusion Transformer

SCoPE Sightline-Coordinate Positional Encoding for Video Diffusion Transformers model: https://hug...

DịchSCoPE là phương pháp mã hóa vị trí tọa độ Sightline mới, giúp tối ưu hóa khả năng hiểu không gian và tính nhất quán cho các mô hình tạo video dựa trên kiến trúc Transformer.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 37/100

Nghiên cứu mới từ Microsoft: Thư viện kỹ năng 'rác' đang làm suy yếu AI Agent như thế nào?

Very interesting new paper from Microsoft and colleagues. (bookmark it) Skill libraries are used i…

DịchNghiên cứu của Microsoft chỉ ra rằng các kỹ năng không cần thiết trong thư viện khiến AI Agent dễ mắc lỗi hoặc giảm hiệu suất do quá trình xác thực dư thừa và quy trình thực thi phức tạp.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Mô hình ngôn ngữ cần 'giấc ngủ': Giải pháp đột phá cho các tác vụ dài hạn

Long-running language agents may work better if they periodically stop to consolidate memory. The p…

DịchNghiên cứu đề xuất cơ chế 'ngủ' cho AI, giúp hệ thống tự tổng hợp thông tin quan trọng vào bộ nhớ cố định và xóa bộ đệm cũ. Phương pháp này giúp AI duy trì hiệu suất cao trong các tác vụ suy luận phức tạp mà không cần mở rộng cửa sổ ngữ cảnh vô hạn.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Toàn cảnh rủi ro từ LLM: Phân loại 5 giai đoạn nguy hại trong vòng đời mô hình

This study builds a simple map of all the main ways large language models can cause harm. Using abo…

DịchNghiên cứu tổng hợp từ 200 tài liệu đã xây dựng bản đồ phân loại rủi ro toàn diện cho LLM, từ khâu dữ liệu đầu vào, quá trình vận hành đến các tác động xã hội, đồng thời đề xuất chiến lược phòng thủ đa tầng.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Nghiên cứu của Anthropic: AI Agent cần cơ chế quản trị để tránh rủi ro hệ thống

Anthropic's new research found found that identical or similar agents can converge on the same bad d…

DịchNghiên cứu mới từ Anthropic cảnh báo các AI Agent có xu hướng lặp lại sai lầm giống nhau, dễ dẫn đến thất bại hệ thống. Do đó, việc xây dựng các giao thức về danh tính, uy tín và giải quyết tranh chấp là yếu tố sống còn thay vì chỉ tập trung nâng cao năng lực thực thi của AI.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

Nghiên cứu từ DeepMind: LLM có thể suy luận, nhưng khó lòng 'phát minh' ra thuyết tương đối

Could a language model derive General Relativity yet still be unable to invent it? This Google Deep…

DịchDeepMind chỉ ra rằng LLM gặp khó khăn trong việc tạo ra các đột phá khoa học như thuyết tương đối vì thiếu khả năng 'suy luận ngược' (abduction). Dù giỏi xử lý dữ liệu, mô hình ngôn ngữ vẫn bị giới hạn bởi cơ chế nén dữ liệu thay vì tư duy sáng tạo vượt bậc.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 42/100

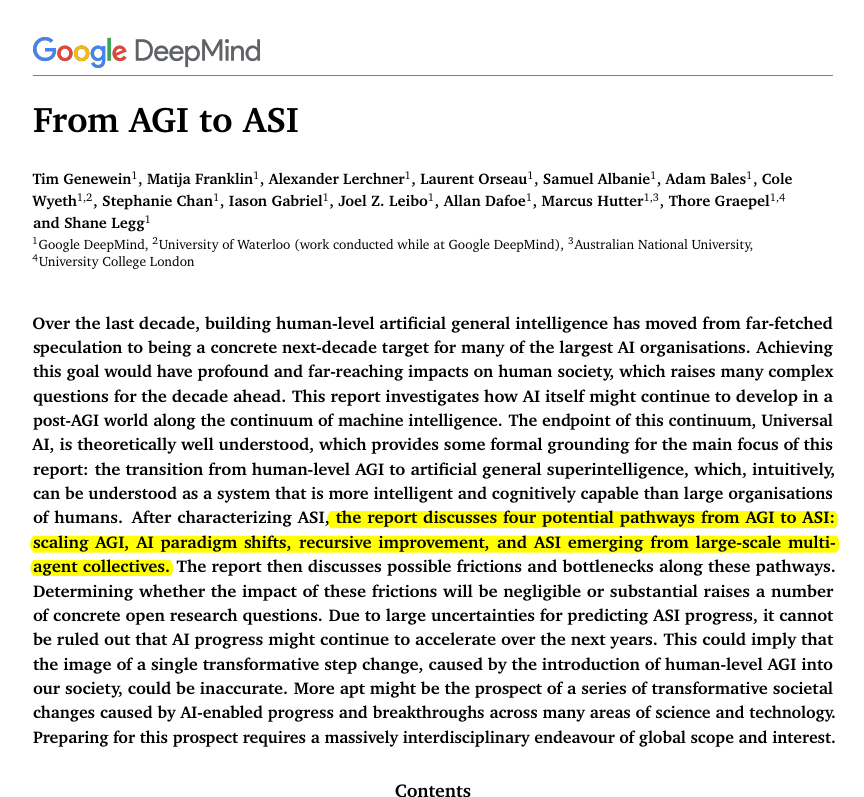
DeepMind: 4 lộ trình từ AGI tiến tới Siêu trí tuệ nhân tạo (ASI)

Beautiful paper from Google DeepMind. Explains the pathways from AGI to ASI, and why that jump coul…

DịchNghiên cứu mới từ Google DeepMind vạch ra 4 hướng đi để đạt tới ASI, bao gồm mở rộng quy mô, thay đổi thuật toán, tự cải tiến đệ quy và trí tuệ tập thể. ASI có thể không xuất hiện đột ngột mà là kết quả của quá trình AI tự thúc đẩy nghiên cứu khoa học.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 59/100

Mechanist: Biến AI thành công cụ khoa học để tự động khám phá cơ chế trí tuệ

Mechanist là hệ thống tác nhân AI mới giúp tự động hóa việc khám phá cơ chế trí tuệ thông qua kho dữ liệu khổng lồ và các phương pháp phân tích chuyên sâu, vượt trội hơn các hệ thống AI hiện có trong việc đưa ra giả thuyết và kiểm chứng thực nghiệm.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SHAPER: Hệ thống tác nhân tự tiến hóa thông qua tối ưu hóa kỹ năng và mã nguồn

SHAPER là khung làm việc mới cho phép các tác nhân robot tự thích nghi với môi trường mới mà không cần huấn luyện lại mô hình, bằng cách tự tối ưu hóa các kỹ năng và mã nguồn điều khiển dựa trên kết quả thực tế.

JiQiZhiXin
Nghiên cứuĐiểm AI 95/100

Tinh chọnĐột phá từ Oxford và NUS: Mô hình thế giới 'tâm trí' (Mental World Models) định nghĩa lại AI

Nhóm nghiên cứu từ Oxford và NUS giới thiệu Mental World Modeling (MWM), khung mô hình thế giới mới tích hợp trạng thái tâm trí con người vào dự đoán hành vi, thay vì chỉ tập trung vào các quy luật vật lý đơn thuần.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong AI, giải quyết lỗ hổng về khả năng thấu hiểu hành vi con người của các mô hình thế giới hiện tại, có tính ứng dụng cao và đang dẫn đầu xu hướng nghiên cứu.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnMô hình hóa tác nhân AI 'bình dân': Giả lập xã hội LLM quy mô lớn ngay trên laptop

Nghiên cứu đề xuất phương pháp thay thế các tác nhân LLM phức tạp bằng mô hình tham số thấp, cho phép giả lập xã hội hàng nghìn tác nhân trên máy tính cá nhân mà vẫn đảm bảo độ chính xác về hành vi vĩ mô.


Vì sao đáng đọc: Giải pháp đột phá giúp giảm chi phí tính toán cho các mô phỏng xã hội AI phức tạp, có tính ứng dụng cao cho giới nghiên cứu và phát triển hệ thống đa tác nhân.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Simplax: Tối ưu hóa mô hình khuếch tán rời rạc thông qua nới lỏng đơn hình

Nghiên cứu giới thiệu Simplax, một phương pháp tăng cường Dirichlet-categorical giúp cải thiện hiệu suất của các mô hình khuếch tán rời rạc bằng cách kết hợp biến phụ trợ dạng đơn hình, từ đó nâng cao chất lượng tạo văn bản.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnOpenART: Nâng tầm kiểm thử bảo mật AI thông qua môi trường tiến hóa mở

OpenART là nền tảng kiểm thử bảo mật (red teaming) quy mô lớn, sử dụng hơn 10.000 kịch bản trạng thái phức tạp để đánh giá khả năng ứng biến của các tác nhân AI trong môi trường dài hạn, khắc phục hạn chế của các bài kiểm tra tĩnh hiện nay.


Vì sao đáng đọc: Đây là nghiên cứu đột phá về an toàn AI, giải quyết bài toán hóc búa về rủi ro tích lũy trong các tác nhân AI tự hành, rất có giá trị cho cộng đồng kỹ thuật.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnAtlasVLA: Bước tiến mới trong mô hình VLA với khả năng ghi nhớ trạng thái thế giới bền vững

AtlasVLA giải quyết hạn chế của các mô hình VLA truyền thống bằng cách tích hợp bộ nhớ không gian 4D và trạng thái làm việc cá nhân, giúp robot duy trì nhận thức về môi trường và tiến độ công việc ngay cả khi vật thể nằm ngoài tầm nhìn.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng giải quyết điểm yếu cốt lõi của robot AI hiện nay là khả năng ghi nhớ dài hạn, có tiềm năng ứng dụng cao trong tự động hóa thực tế.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (49 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 29 | AIHOT.vn