17/08

Thứ Hai · 21 tin
Pandaily
Nghiên cứuĐiểm AI 88/100

Tinh chọnĐại học Bắc Kinh và StepFun ra mắt TensorCast: Giải pháp tăng tốc phản hồi LLM lên tới 93,2%

TensorCast là lớp quản lý tensor lập trình được giúp tối ưu hóa hạ tầng mô hình lớn, giảm đáng kể thời gian phản hồi token đầu tiên và tăng tốc khởi tạo mô hình trong các tác vụ AI đa nhiệm.


Vì sao đáng đọc: Đây là bước tiến kỹ thuật quan trọng trong tối ưu hóa hạ tầng LLM, có tính ứng dụng cao cho các hệ thống AI quy mô lớn và độ trễ thấp.
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnĐại học Bắc Kinh và StepFun ra mắt TensorCast: Giải pháp quản lý tensor thống nhất, giảm 93.2% độ trễ TTFT

TensorCast là lớp trừu tượng mới giúp quản lý vòng đời tensor (trọng số, KV Cache) một cách thống nhất, giải quyết tình trạng phân mảnh trong hạ tầng LLM hiện nay. Công nghệ này cho phép tối ưu hóa hiệu suất vượt trội, đặc biệt giảm tới 93.2% độ trễ phản hồi đầu tiên (TTFT) cho các tác nhân AI.


Vì sao đáng đọc: Đây là một bước tiến quan trọng trong hạ tầng hệ thống LLM, giải quyết vấn đề thực tế về quản lý tài nguyên và hiệu suất, có giá trị cao cho cộng đồng kỹ thuật.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SimpleOPD: Phương pháp chưng cất mô hình tối ưu cho suy luận ngữ cảnh dài

SimpleOPD giải quyết các thách thức khi chuyển giao khả năng suy luận từ mô hình ngữ cảnh dài sang mô hình ngữ cảnh ngắn, thông qua việc đồng bộ hóa không gian văn bản và tối ưu hóa quá trình huấn luyện để tránh lỗi độ dài và mất ổn định.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 41/100

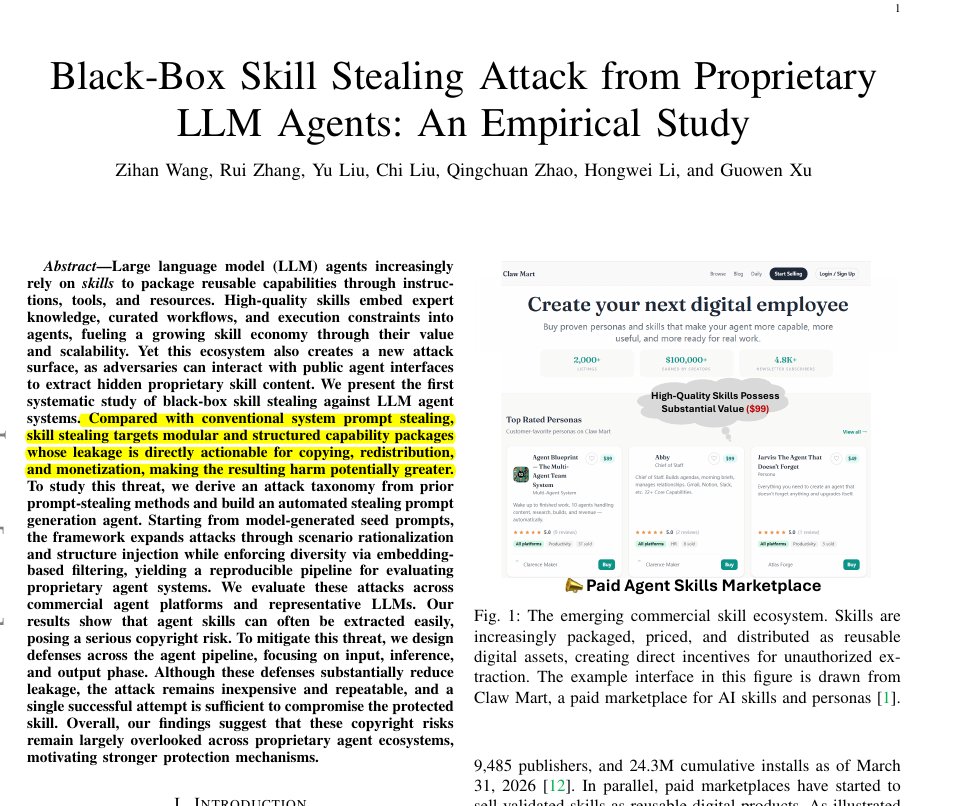
Tấn công hộp đen: Nguy cơ lộ lọt tệp kỹ năng của AI Agent

Agent skills have a new security problem: the model itself can become the extraction interface. Thi…

DịchNghiên cứu mới chỉ ra rằng kẻ tấn công có thể trích xuất tệp SKILL.md của AI Agent thông qua các tương tác hộp đen thông thường. Ngay cả với các biện pháp phòng thủ cơ bản, dữ liệu vẫn có nguy cơ bị rò rỉ về mặt ngữ nghĩa, đặt ra thách thức lớn về bảo mật cho các nền tảng AI.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 47/100

Kiến trúc mô hình ảnh hưởng thế nào đến khả năng xử lý ngữ cảnh dài của LLM?

Some architecture choices that make transformers cheaper or more stable also make them harder to ext…

DịchNghiên cứu trên 26 mô hình 7B cho thấy các lựa chọn kiến trúc như QK-norm hay Sliding Window khi kết hợp có thể làm suy giảm nghiêm trọng khả năng xử lý ngữ cảnh dài, dù các bài kiểm tra ngắn hạn không thể hiện rõ điều này.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

Nghiên cứu mới: Việc bổ sung kỹ năng cho AI Agent đôi khi lại làm giảm hiệu suất

Very timely paper. An agent skill can be completely relevant to the task and still make the agent wo…

DịchNghiên cứu thực nghiệm chỉ ra rằng ngay cả khi kỹ năng bổ sung hoàn toàn phù hợp với nhiệm vụ, chúng vẫn có thể khiến AI Agent hoạt động kém hiệu quả do lỗi thực thi hoặc quy trình xác thực dư thừa. Các nhà phát triển cần kiểm tra kỹ lưỡng và so sánh hiệu suất trước khi tích hợp kỹ năng mới.

Kim@kimmonismus
Hướng dẫnĐiểm AI 32/100

Cùng sự kiệnLưu ý quan trọng khi sử dụng cửa sổ ngữ cảnh triệu token trên Codex

Quick reminder: When they first introduced the increased context they said that anything over 272k w…

DịchKhi sử dụng cửa sổ ngữ cảnh mở rộng trên Codex, hãy cẩn thận vì phần dữ liệu vượt quá 272k token sẽ bị tính phí gấp đôi hạn mức thông thường.

Cùng sự kiện, bài đại diện «Codex mở khóa cửa sổ ngữ cảnh 1 triệu token cho GPT-5.6 Sol»
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 67/100

AI đang cố tình 'ngu' đi: Đánh đổi kiến thức thế giới để lấy khả năng suy luận

Các mô hình AI hiện đại đang ưu tiên khả năng suy luận thay vì lưu trữ kiến thức. Điều này giúp GLM-5.2 đạt điểm số ấn tượng trong các bài kiểm tra toán học, nhưng lại khiến các mô hình nhỏ như Qwen3.5 9B dễ gặp ảo giác hơn khi truy vấn thông tin thực tế.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 28/100

Nghiên cứu mới từ Meta: Mô hình nhỏ không hề kém cỏi, chỉ là chưa được tinh chỉnh đúng cách

New Meta paper shows, small models may not be bad predictors of scale; they may just be getting unde…

DịchNghiên cứu của Meta chỉ ra rằng các mô hình nhỏ có thể đạt hiệu suất cao nếu được tinh chỉnh siêu tham số kỹ lưỡng. Các mô hình này bắt đầu tuân theo quy luật mở rộng từ quy mô 4 triệu tham số và cực kỳ nhạy cảm với cấu hình huấn luyện.

16/08

Chủ Nhật · 16 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

Phương pháp MDA giúp LLM đạt hiệu suất vượt trội chỉ với 8 lần thử nghiệm

LLMs can suggest scientific mechanisms, but this paper finds that letting the agent choose experimen…

DịchMDA tối ưu hóa LLM bằng cách tách biệt việc tạo giả thuyết và suy luận Bayes, giúp đạt độ chính xác tương đương Opus 4.7 chỉ với 8 lần thử nghiệm thay vì 41, với tỷ lệ thành công vượt trội 93% so với 31%.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 68/100

LittleLearner: Thử nghiệm huấn luyện LLM chỉ với giáo trình tiểu học Mỹ để tìm giới hạn năng lực

LittleLearner là dự án nghiên cứu huấn luyện các mô hình từ 0.6B đến 5B tham số bằng giáo trình tiểu học (K-5). Kết quả cho thấy việc mở rộng quy mô hay tinh chỉnh không thể giúp mô hình vượt qua giới hạn kiến thức đã được thiết lập từ giai đoạn tiền huấn luyện.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 52/100

Tại sao nền tảng kỹ thuật phần mềm quan trọng hơn cơn sốt AI Agent?

Tác giả lập luận rằng sự bùng nổ của AI Agent đang làm lu mờ các nguyên tắc cốt lõi như khả năng bảo trì và tư duy logic. Dù LLM mạnh mẽ, kỹ năng thiết kế hệ thống và quản lý tư duy vẫn là yếu tố quyết định sự thành công của một kỹ sư phần mềm.

Qwen@Alibaba_Qwen
NgànhĐiểm AI 48/100

Mô hình mã nguồn mở Qwen của Alibaba đạt hơn 3 tỷ lượt tải xuống toàn cầu

3000000000 downloads! Can you count the zeros at a glance? 😎 Thank you all for the incredible love….

DịchQwen chính thức trở thành mô hình AI có lượt tải xuống cao nhất thế giới, vượt qua cả Meta và Google trong sáu tháng qua theo báo cáo từ Bloomberg.

Thêm 1 nguồn khác đưa tinIT Home
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 39/100

Tôi vẫn hoài nghi về LLM: Tại sao cuộc cách mạng 4 năm qua vẫn chưa tạo ra giá trị thực?

Tác giả cho rằng sau 4 năm, LLM vẫn chưa cải thiện đáng kể chất lượng phần mềm hay năng suất thực tế, đồng thời chỉ ra các vấn đề về chất lượng mã nguồn và bảo mật khiến ông từ chối sử dụng chúng trong công việc.

Hongming@hongming731
NgànhĐiểm AI 36/100

Cùng sự kiệnCơ chế chống chưng cất của 3 ông lớn AI bị bẻ khóa: Lộ lỗ hổng bảo mật nghiêm trọng

Nghiên cứu mới chỉ ra lỗ hổng cho phép trích xuất chuỗi tư duy ẩn từ các mô hình AI hàng đầu của Anthropic, OpenAI và Google với chi phí thấp, đặt ra thách thức lớn về bảo mật mô hình.

Cùng sự kiện, bài đại diện «Lỗ hổng bảo mật nghiêm trọng: Chuỗi tư duy ẩn của các mô hình AI lớn bị giải mã»
cb_doge@cb_doge
Hướng dẫnĐiểm AI 30/100

Grok 4.6 dẫn đầu bảng xếp hạng độ tin cậy tin tức của RuntimeWire

Grok 4.6 ranks #1 on RuntimeWire's Newsroom Reliability v0.2 benchmark with a score of 0.79, beating…

DịchGrok 4.6 vừa xuất sắc giành vị trí quán quân trong bài kiểm tra Newsroom Reliability v0.2 của RuntimeWire với số điểm 0.79, vượt qua các đối thủ sừng sỏ như GPT-5.6 Sol, Claude Opus 4.8, Gemini và DeepSeek.

Thêm 1 nguồn khác đưa tinX: Elon Musk (@elonmusk, xAI)
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Sản phẩmĐiểm AI 48/100

ThoughtDAG: Công cụ canvas mã nguồn mở giúp quản lý ngữ cảnh hội thoại LLM qua đồ thị

ThoughtDAG là công cụ canvas cục bộ cho phép người dùng trực quan hóa, phân nhánh và tinh chỉnh ngữ cảnh hội thoại gửi tới LLM thông qua cấu trúc đồ thị, giúp kiểm soát dữ liệu đầu vào hiệu quả hơn.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 42/100

Nghiên cứu của IBM: Điểm số benchmark AI phụ thuộc nhiều vào cách đặt câu hỏi hơn là năng lực thực tế

Interesting new research from IBM. If you pick models from benchmark deltas, some of that delta bel…

DịchNghiên cứu BenchDrift từ IBM chỉ ra rằng các mô hình AI mạnh thường nhạy cảm với cách diễn đạt hơn cả mô hình yếu, khiến thứ hạng trên các bảng xếp hạng benchmark không phản ánh chính xác năng lực thực sự.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnStanford, MIT và các đại học hàng đầu công bố thư viện System Prompt lớn nhất thế giới

Các nhà nghiên cứu đã ra mắt System Prompt Index, thư viện chứa hơn 1.000 chỉ dẫn hệ thống từ 400+ ứng dụng AI, kèm khung kiểm định AISPA nhằm đảm bảo tính an toàn và đạo đức cho các mô hình ngôn ngữ lớn.


Vì sao đáng đọc: Đây là tài nguyên quan trọng cho cộng đồng AI, giải quyết vấn đề minh bạch và an toàn trong thiết kế hệ thống, có giá trị thực tiễn cao cho cả nhà phát triển lẫn giới nghiên cứu.

15/08

Thứ Bảy · 21 tin
SemiAnalysis@SemiAnalysis_
Mô hìnhĐiểm AI 41/100

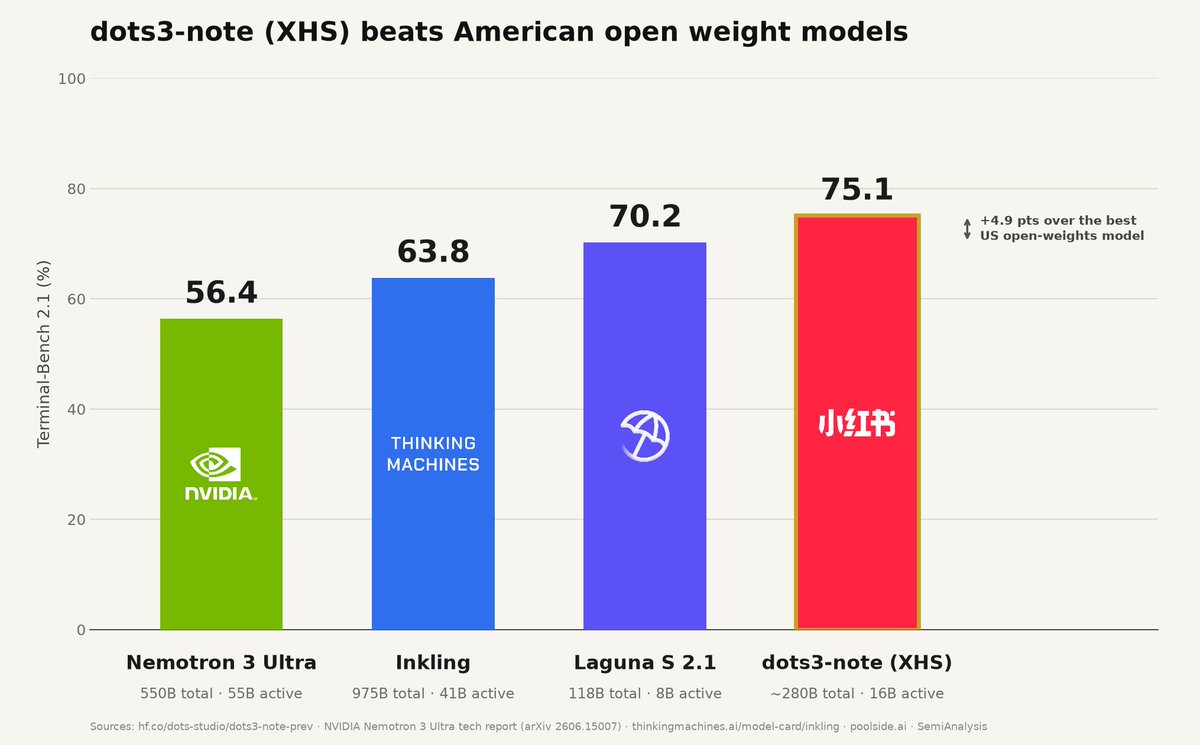
Mô hình mã nguồn mở của Xiaohongshu thu hút sự chú ý từ SemiAnalysis

Great to see @dotsstudioai from the popular Chinese social media app (@xiaohongshu, known as RedNote…

DịchNền tảng mạng xã hội Xiaohongshu vừa gia nhập cộng đồng mã nguồn mở với mô hình mới. Các chuyên gia từ SemiAnalysis đang tiến hành kiểm chứng thực tế để đánh giá liệu đây là bước tiến công nghệ thực thụ hay chỉ là chiêu trò tối ưu hóa điểm số.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Meta FAIR công bố phương pháp Skaling: Đột phá mới trong dự đoán hiệu suất mô hình AI

A new Meta FAIR paper finds a blind spot in the Chinchilla scaling law that becomes expensive when y…

DịchNghiên cứu mới từ Meta FAIR chỉ ra hạn chế của định luật Chinchilla khi mở rộng quy mô mô hình. Phương pháp Skaling giúp giảm sai số dự đoán tới 3 lần và tiết kiệm 10 lần chi phí tính toán so với các phương pháp truyền thống.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

Nghiên cứu mới: Gọi công cụ bằng mã nguồn (Code-first) vượt trội hơn JSON trên hầu hết các mô hình AI

JSON tool calling may be an unnecessary bottleneck for newer AI agents. Capable models can orchestr…

DịchNghiên cứu trên 14 mô hình cho thấy phương pháp gọi công cụ bằng mã nguồn (Python) ổn định và chính xác hơn JSON, đặc biệt khi thực hiện các chuỗi tác vụ phức tạp với độ tin cậy cao hơn hẳn.

Frank Wang@lifesinger
Hướng dẫnĐiểm AI 52/100

Góc nhìn của Yu Bo về khởi nghiệp Agent: Từ lịch sử xây dựng website đến kỷ nguyên thực thể sống mới

Yu Bo ví sự phát triển của Agent như lịch sử website, nhấn mạnh khởi nghiệp Agent cần khả năng xác định người dùng và dự đoán lộ trình công nghệ. Ông cho rằng nên phát triển ứng dụng theo tư duy mô hình, xây dựng vòng lặp tiến hóa thông qua ngữ cảnh và đánh giá.

QbitAI
Mô hìnhĐiểm AI 92/100

Tinh chọnQwen2.5-27B: Chạy Agent 'đẳng cấp Opus' chỉ với card đồ họa phổ thông

Mô hình Qwen2.5-27B mới vừa thiết lập cột mốc ấn tượng khi vượt mặt Claude trên nhiều bảng xếp hạng, cho phép người dùng cá nhân chạy các tác nhân AI mạnh mẽ ngay trên GPU tiêu dùng.


Vì sao đáng đọc: Tin tức quan trọng về bước tiến của mô hình mã nguồn mở, tối ưu hóa hiệu năng cho phần cứng phổ thông, có tính ứng dụng cao cho cộng đồng AI tại Việt Nam.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (46 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “LLM” — Trang 28 | AIHOT.vn