01/09

Thứ Ba · 32 tin
Francois Chollet@fchollet
Hướng dẫnĐiểm AI 24/100

François Chollet: Mở rộng thời điểm kiểm thử (Test-time Scaling) gồm hai chiều: Chiều sâu và Chiều rộng

Test-time scaling has two axes: running agents over longer timeframes (depth), and running a larger …

DịchFrançois Chollet cho rằng việc mở rộng thời điểm kiểm thử không chỉ nằm ở việc kéo dài thời gian xử lý (chiều sâu), mà còn cần tăng số lượng tác nhân hoạt động song song (chiều rộng) để giải quyết các bài toán phức tạp đòi hỏi tìm kiếm không gian rộng.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 37/100

GPU World treo giải 100.000 USD cho kịch bản tương lai: Khi AI đỉnh cao phổ cập toàn cầu vào năm 2040

GPU World tổ chức cuộc thi viết với tổng giải thưởng 100.000 USD, mời gọi cộng đồng hình dung viễn cảnh năm 2040 khi năng lực tính toán bùng nổ, cho phép mọi người tiếp cận các mô hình LLM tiên tiến nhất mọi lúc mọi nơi.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

DIEM: Tối ưu hóa chọn lọc dữ liệu động trong tinh chỉnh mô hình bằng học tăng cường

DIEM là khung làm việc tự động giúp tối ưu hóa việc chọn lọc dữ liệu trong quá trình tinh chỉnh mô hình bằng học tăng cường (RFT), bằng cách đánh giá đóng góp của từng mẫu dữ liệu theo thời gian thực để cải thiện hiệu suất học tập.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

CAST: Khung huấn luyện giám sát dựa trên phản biện giúp tác nhân AI sử dụng công cụ đáng tin cậy hơn

CAST chuyển đổi kết quả nhiệm vụ thành sự giám sát ở cấp độ hành động, giúp tối ưu hóa chiến lược thông qua việc phân tích lý do hiệu quả của các bước thực hiện. Phương pháp này giúp mô hình Qwen3 vượt trội hơn GPT-OSS-120B đáng kể trong các tác vụ thực tế và kịch bản mới.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 48/100

Nghiên cứu cơ chế chưng cất On-Policy và đề xuất phương pháp không giám sát OPSA

Nghiên cứu chỉ ra rằng hiệu quả của chưng cất On-Policy (OPD) chủ yếu đến từ việc ức chế các token có xác suất thấp thay vì phụ thuộc vào giáo viên. Từ đó, nhóm tác giả đề xuất OPSA, phương pháp không cần giám sát giúp tối ưu hóa mô hình hiệu quả hơn.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 64/100

Nghiên cứu mới: 'Harness' trong đánh giá AI có thể quan trọng hơn cả chính mô hình

For long-horizon agents, this paper argues the harness can matter more than the model, so benchmark …

DịchMột bài báo trên arXiv chỉ ra rằng trong các bài kiểm tra tác nhân AI dài hạn, công cụ đánh giá (harness) có ảnh hưởng đến kết quả lớn hơn cả bản thân mô hình, đòi hỏi sự minh bạch hơn khi công bố điểm số.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 60/100

Nghiên cứu mới: Thứ hạng LLM trên bảng xếp hạng phụ thuộc lớn vào cách thiết lập đánh giá

LLM rankings can be created by evaluation choices as much as model differences, so one setup should …

DịchMột nghiên cứu cho thấy chỉ cần thay đổi định dạng prompt hoặc cách chấm điểm, điểm số của cùng một mô hình (như Gemma-2-27b) có thể dao động từ 31% đến 89%, làm lung lay tính khách quan của các bảng xếp hạng LLM hiện nay.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 42/100

Cùng sự kiệnTencent ra mắt ContextPilot: Tối ưu hóa quản lý ngữ cảnh cho AI bằng học tăng cường

Interesting paper from Tencent. Tencent trains an agent to manage its own working context, and assi…

DịchTencent cùng các đối tác giới thiệu ContextPilot, một phương pháp giúp AI chủ động quản lý ngữ cảnh làm việc thông qua học tăng cường, cho phép hệ thống tự quyết định lưu trữ hoặc nén thông tin thay vì chỉ loại bỏ, giúp tối ưu hóa bộ nhớ dài hạn và khả năng lập kế hoạch.

Cùng sự kiện, bài đại diện «ContextPilot: Tối ưu hóa quản lý ngữ cảnh cho AI Agent thông qua học tăng cường chi tiết»
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 39/100

CREST: Phương pháp phân bổ tín dụng thông minh cho tác nhân AI đa vòng

This paper shows a better way to train multi-turn agents: score each turn separately, then use a s…

DịchNghiên cứu giới thiệu khung CREST giúp tối ưu hóa việc học cho các tác nhân LLM đa bước bằng cách phân bổ tín dụng phân tầng. Mô hình tự đóng vai trò giáo viên để điều chỉnh trọng số học tập dựa trên độ tin cậy của các quyết định, giúp cải thiện hiệu suất mà không làm thay đổi kết quả kiểm chứng.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 50/100

Google giới thiệu SKILL.state: Tối ưu hóa hiệu suất và độ chính xác cho AI Agent dài hạn

Good paper on long-horizon scalable agent skills.

DịchGoogle ra mắt SKILL.state, thay thế lịch sử hội thoại cồng kềnh bằng trạng thái thực thi có cấu trúc. Giải pháp này giúp AI Agent duy trì độ chính xác cao, giảm tiêu thụ token và loại bỏ tình trạng nhiễu ngữ cảnh trong các tác vụ kéo dài.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 48/100

Google giới thiệu SKILL.state: Tối ưu hóa bộ nhớ cho AI tác vụ dài

Great paper from Google and colleagues. It proposes an interesting approach to improve agents on lo…

DịchGoogle đề xuất SKILL.state, thay thế lịch sử hội thoại cồng kềnh bằng trạng thái thực thi rõ ràng, giúp AI xử lý tác vụ dài nhanh hơn, chính xác hơn và tiết kiệm token hơn.

Thêm 2 nguồn khác đưa tinX: Elvis Saravia (@omarsar0, DAIR.AI)X: Rohan Paul (@rohanpaul_ai)
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 45/100

Grok Bots: Biến dữ liệu trích dẫn từ LLM thành chiến lược tối ưu hóa thương hiệu

Grok Bots turned LLM citation data into an operating loop: find the pages ChatGPT, Grok, Gemini an…

DịchGrok Bots giúp doanh nghiệp theo dõi các trang web được AI (ChatGPT, Grok, Gemini) trích dẫn, từ đó chủ động tối ưu hóa nội dung để tăng khả năng hiển thị trong kết quả tìm kiếm AI.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 43/100

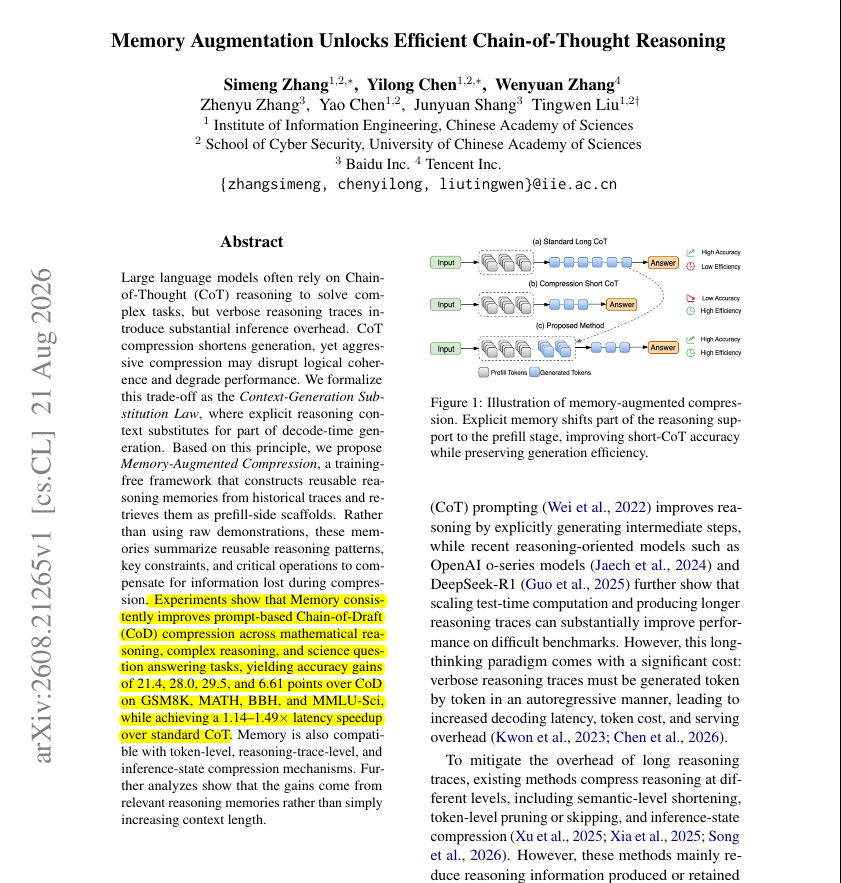
Nén tăng cường bộ nhớ: Tối ưu hóa chi phí suy luận chuỗi tư duy (CoT) bằng cách tái sử dụng suy luận

This paper shows a different way to make chain-of-thought cheaper: move reusable reasoning from gene…

DịchPhương pháp này chuyển đổi các bước suy luận từ giai đoạn tạo văn bản sang phần gợi ý (prompt), giúp giảm chi phí tính toán cho chuỗi tư duy mà không cần huấn luyện lại mô hình.

31/08

Thứ Hai · 25 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 46/100

Nghiên cứu mới từ ByteDance: Giữ lại lịch sử thử nghiệm hiệu quả hơn tóm tắt bộ nhớ

New ByteDance paper shows for test-time improvement, keeping the messy history of attempts can work …

DịchByteDance giới thiệu phương pháp Chain-of-Experience, ưu tiên lưu giữ toàn bộ quá trình thử nghiệm và phản hồi thay vì tóm tắt ngắn gọn. Cách tiếp cận này giúp cải thiện đáng kể độ chính xác trong các tác vụ toán học và lập trình so với phương pháp lặp lại truyền thống.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 45/100

Nghiên cứu từ Amazon: Tối ưu hóa KV Cache giúp mô hình AI không bị 'mất trí nhớ' khi xử lý văn bản dài

New Amazon paper shows KV-cache policy is not just an inference optimization; but it can change the …

DịchNghiên cứu mới của Amazon chỉ ra rằng việc đồng bộ hóa chiến lược KV Cache trong quá trình tinh chỉnh (fine-tuning) giúp mô hình tránh lỗi mất ngữ cảnh khi xử lý văn bản dài, thay vì chỉ tập trung vào tối ưu suy luận như trước đây.

X.PIN@thexpin
Mô hìnhĐiểm AI 52/100

ByteDance hoãn ra mắt Doubao 2.2 để nâng cấp khả năng của AI Agent

ByteDance has postponed Doubao 2.2's planned August launch, Baijing Lab reports, citing people close…

DịchByteDance đã dời lịch phát hành Doubao 2.2 để tập trung tối ưu hóa khả năng lập trình, sử dụng công cụ và hiệu suất của AI Agent, nhằm tạo ra bước nhảy vọt về năng lực cho phiên bản này.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

DART-SD: Tối ưu hóa tác nhân AI gọi công cụ đa bước qua cấu trúc đồ thị kim cương

DART-SD là khung làm việc mới giúp tác nhân AI học cách gọi công cụ hiệu quả hơn bằng cách thay thế việc bắt chước quỹ đạo tuyến tính bằng phương pháp hiệu chỉnh dựa trên cấu trúc đồ thị, giúp tăng tính linh hoạt và đa dạng trong giải quyết vấn đề.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnPuro-2B: Đột phá huấn luyện mô hình ngôn ngữ từ đầu với chi phí cực thấp trên RTX 5090

Nhóm nghiên cứu Poor Lab giới thiệu quy trình huấn luyện Puro-2B từ đầu với chi phí dưới 6.900 USD trên GPU RTX 5090, đạt hiệu suất tiệm cận Qwen2.5-1.5B, giúp dân chủ hóa việc huấn luyện AI cho cộng đồng.


Vì sao đáng đọc: Đây là bước tiến quan trọng giúp giảm rào cản chi phí huấn luyện AI, cho phép cá nhân và cộng đồng mã nguồn mở tự xây dựng mô hình mạnh mẽ mà không cần hạ tầng đắt đỏ.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 45/100

RAG bị tấn công đầu độc: Hiện tượng 'sụp đổ sự chú ý' và cách phòng chống

RAG poisoning can make a model more confident, which is exactly why confidence-based detectors can f…

DịchNghiên cứu chỉ ra rằng các tài liệu độc hại có thể thao túng mô hình RAG, khiến nó tập trung sai lệch vào dữ liệu xấu thay vì bằng chứng xác thực. Để phát hiện, cần giám sát sự phân bổ chú ý giữa các tài liệu thay vì chỉ dựa vào độ tin cậy của câu trả lời cuối cùng.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Người mù sờ voi: Giải mã sự hạn chế tri thức của LLM đối với các dữ liệu hiếm và gây tranh cãi

Nghiên cứu giới thiệu ElephantBench, bộ dữ liệu gồm 1.094 câu hỏi để kiểm tra khả năng của LLM trong việc ghi nhớ các quan điểm trái chiều về những sự kiện ít phổ biến. Kết quả cho thấy ngay cả các mô hình mạnh nhất cũng thường bỏ sót các luồng thông tin khác nhau, cho thấy lỗ hổng trong tri thức của AI.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ContextPilot: Tối ưu hóa quản lý ngữ cảnh cho AI Agent thông qua học tăng cường chi tiết

ContextPilot giải quyết vấn đề quá tải ngữ cảnh trong các tác vụ dài hạn bằng cách cho phép AI tự quản lý và tinh chỉnh bộ nhớ hiệu quả hơn thông qua học tăng cường (RL) phân cấp, thay vì chỉ tóm tắt hay xóa dữ liệu thô sơ.

Thêm 2 nguồn khác đưa tinX: Elvis Saravia (@omarsar0, DAIR.AI)X: Rohan Paul (@rohanpaul_ai)
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 57/100

Tối ưu hóa khung làm việc: Bí quyết giúp AI lập trình vượt qua giới hạn ngữ cảnh

Keep the model fixed, change the harness, and coding-agent results can move a lot when context gets …

DịchNghiên cứu cho thấy việc tinh chỉnh khung làm việc thay vì thay đổi mô hình giúp các AI lập trình (như Qwen, Devstral) cải thiện đáng kể hiệu suất khi xử lý ngữ cảnh dài, với tỷ lệ giải quyết tác vụ thực tế tăng vọt trên SWE-bench.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (44 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “LLM” — Trang 18 | AIHOT.vn